大模型在风控里到底能干什么?一个CART、LLM合并与评分卡的全面实测
先验直觉:某信贷公司有1000个客户,其中300个会违约。风控经理说"我们要把坏客户都拦在外面"——但问题是,你每拒绝一个坏客户,就可能误杀好几个好客户。这个矛盾是风控的核心:通过率 vs 逾期率,一场永不停歇的数学对抗。
关键词:序贯覆盖、CART决策树、LLM规则合并、逻辑回归评分卡、Lift、KS、AUC、策略曲线、ROC思想、Shannon信息论、Bayes决策理论
01 风控的核心矛盾:一个数学问题
假设你是银行的风控负责人,有一批贷款申请摆在你面前:
如果你全部通过,逾期率30%,亏损:
如果你全部拒绝,通过率0%,没有逾期但也赚不到钱——银行关门。
矛盾就在这里:你需要在"通过率"和"逾期率"之间找到一个平衡点。这个平衡点决定了银行是赚钱还是赔钱。
从统计决策理论看这个问题
Bayes 决策理论告诉我们:最优决策是让期望损失最小化:
其中
02 数据和评价体系
German Credit 数据集
本文使用经典的 German Credit 数据集(UCI,1000笔):
| 指标 | 数值 |
|---|---|
| 样本量 | 1000 |
| 坏客户(违约) | 300(30%) |
| 好客户 | 700(70%) |
| 特征数 | 20(数值+类别) |
核心特征包括 checking_status(账户状态)、duration(贷款期限)、credit_amount(贷款金额)、age(年龄)、savings_status(储蓄状况)等。
评价指标
我们看四个维度:
- 通过率 = 批准客户数 / 总申请数(越高越好)
- 逾期率 = 通过客户中坏客户占比(越低越好)
- Lift = 规则筛选后的坏率 / 原始坏率(衡量规则的"精准度")
- KS / AUC = 区分好坏的统计能力
03 方法一:序贯覆盖——CART决策树 + 边际贡献
数学原理:CART
CART(Classification And Regression Tree)是最经典的规则挖掘算法。它通过递归地选择最优分裂特征和阈值来分割样本空间:
其中
从信息论角度看,树的每次分裂都在最大化信息增益——这正是 Shannon 信息论中互信息的体现:
其中
序贯覆盖:解决规则重叠
多条规则往往抓的是同一批人(低收入、多头、年轻的客户)。序贯覆盖的核心思想:
每加一条规则,先把已被覆盖的客户移出池子,在剩余样本上计算边际贡献。
逐条叠加效果(全量1000笔)
每条规则在剩余样本中逐次应用,看通过率和逾期率如何一步步变化:
| 叠加 | 新增覆盖 | 边际坏率 | 累计拒绝 | 通过率 | 逾期率 | 压降 |
|---|---|---|---|---|---|---|
| 无策略 | -- | -- | 0笔 | 100.0% | 30.0% | -- |
| +Rule1: 透支+长期限 | 237 | 56.5% | 237 | 76.3% | 21.8% | 8.2pp |
| +Rule2: 透支+短贷+年龄≤35 | 187 | 38.0% | 424 | 57.6% | 16.5% | 13.5pp |
| +Rule3: 信用好+高金额+就业不稳 | 22 | 45.5% | 446 | 55.4% | 15.3% | 14.7pp |
| +Rule4: 透支+短贷+年龄>35+大额 | 31 | 45.2% | 477 | 52.3% | 13.6% | 16.4pp |
边际坏率从Rule1的56.5%一路降到Rule2的38.0%再回升到45%左右——Rule1一招抓走了最坏的那批客户(透支+长期限,坏率超过一半),后续规则在剩余样本中的"坏浓度"自然下降。Rule3和Rule4覆盖量很小(22+31笔),边际坏率有所回升,属于"剩饭里挑骨头"——虽然坏率不低,但能抓到的人已经不多了。
4条规则累计拒绝477笔,其中坏客户229个(76.3%被移除),误杀好客户248个。最终通过率52.3%,逾期率从30.0%降到13.6%,压降16.4pp。
序贯覆盖的特点:激进但精准。 每拒绝3笔就干掉2个坏客户(Lift=2.2x),但代价是只通过了52%的客户,误杀248个好客户。
04 方法二:LLM规则合并——从统计到语义
CART看到了什么,LLM看到了什么
CART决策树产出的规则是这样的:
从统计角度看,A、B、C、D是四个不同的规则,各自有不同的坏率和覆盖。如果你让风控经理来审这四条规则,他会说:
"A和B说的是一回事——账户透支且贷款期限长的客户。savings_status是多是少不重要,他们的问题在收入和还款能力。" "C和D里的credit_amount≤1286这个条件其实跟年龄组合更相关——透支且短期借钱且金额小的客户,典型以贷养贷。" "但等等,这些规则都是在抓坏客户。那好客户呢?无账户('no checking')的那些客户坏率只有12%,为什么没有一条规则说他们可以直接通过?"
这就是LLM的核心价值——把统计结果翻译成业务逻辑,再补充业务中"显而易见"但统计方法"看不见"的知识。
LLM的三种能力
在风控规则场景中,LLM做了三件统计方法做不到的事:
能力一:语义翻译
CART说 checking_status>1.5,但 ">1.5" 是什么意思?它对应的是编码后的 {<0: 3, 0<=X<200: 2, >=200: 1, no checking: 0}。所以 >1.5 = 账户已经透支或余额不足200元。这是风控领域最基本的常识——账户状态是客户还款能力的第一信号。
LLM自动完成了这个翻译:
统计方法不关心特征名是什么,LLM关心。
能力二:规则合并
回过头看Rule A和Rule B:
| 规则 | 条件 | 覆盖 | 坏率 |
|---|---|---|---|
| A | 透支+长期限+有储蓄 | 28笔 | 89% |
| B | 透支+长期限+无储蓄 | 6笔 | 100% |
| 合并 | 透支+长期限(去掉储蓄条件) | 34笔 | 91% |
合并后覆盖从28→34笔,坏率从89%/100%→91%。统计上看,savings_status在已知checking_status和duration后几乎不提供额外信息——在信息论中这叫做条件互信息接近零:
LLM不需要算这个数——它凭业务知识就知道"一个人的还款能力主要看账户有没有钱、贷款期限多长,储蓄多一点少一点在已经透支的客户中影响不大"。
Rule C和Rule D也有同样的问题——age把同一群体切成了两半。LLM的合并结果是:
| 合并前 | 合并后 |
|---|---|
| 透支+短贷+年龄≤35+小额 → 坏率70% | 透支+短贷+小额≤1300 → 坏率45% |
| 透支+短贷+年龄>35+小额 → 坏率45% | (去掉了年龄条件,覆盖从75→132笔) |
能力三:常识补充
CART只会从已有数据中寻找"拒绝"规则。它永远不会产生一条"快速通过"规则——因为它的目标函数是最小化误分类率,不是最大化审查效率。
但现实中,风控系统的瓶颈往往不是"坏客户太多",而是"好客户太多值得审查"。LLM补充了一条统计方法永远不会产出的规则:
IF checking_status = 'no checking' → 快速通过,免审查
这条规则的业务逻辑:在德国,没有银行账户的客户群体(394笔)的违约率仅有12%——远低于总体30%。他们通常是保守、不借贷的人群,并不是高风险群体。但统计方法看到的只是"checking_status=0是4个类别中编码最小的"——它不会说"这是好客户,直接放行"。
分层策略架构
LLM合并的贡献不仅仅是少了4条规则,而是设计了一个分层决策架构,这是统计方法无法自主产出的:
这个架构有三层,每一层对应一个不同的业务决策:
| 层级 | 决策 | 谁做 | 业务含义 |
|---|---|---|---|
| 第一层 | 快速通过 | 自动(LLM规则) | "这个客户一看就不用审" |
| 第二层 | 自动拒绝 | 自动(合并规则) | "这个客户一看就不行" |
| 第三层 | 人工审批 | 风控人员 | "不确定,需要人判断" |
逐层叠加效果
| 叠加 | 操作 | 边际坏率 | 累计通过 | 通过率 | 逾期率 | 压降 |
|---|---|---|---|---|---|---|
| 无策略 | -- | -- | 1000笔 | 100.0% | 30.0% | -- |
| +快速通过 | 免审放出394笔(坏率12%) | 11.7% | 1000笔(394免审+606待审,坏率稀释) | 100.0% | 30.0%→11.7%(仅保护池) | -- |
| +拒绝A | 透支+长期限(审查池中抓237笔) | 56.5% | 763笔 | 76.3% | 21.8% | 8.2pp |
| +拒绝B | 透支+短贷+小额(审查池中再抓115笔) | 43.5% | 648笔 | 64.8% | 17.9% | 12.1pp |
注意这条关键路径:快速通过层的边际坏率仅11.7%——这394笔的违约率远低于整体均值,LLM做的不是"拒绝"而是"保护",先把好客户放行。然后拒绝A和B在审查池中抓坏客户,这时边际坏率(56.5%、43.5%)才体现出拦截效果。
最终结果:648笔通过,逾期率17.9%(压降12.1pp),40%的客户零审查,误杀仅168笔(三种方法中最低)。
LLM不能做什么
也要诚实地说:LLM的合并没有提升数字精度。同通过率下,LLM合并的逾期率和评分卡差距不到1pp。说明LLM不是在"更准"这个维度上战胜统计方法的。
LLM的真正价值在三个词:翻译、合并、补充。它把统计方法产出的碎片化规则翻译成业务人员能理解的语言,合并冗余的细分,补充统计方法"看不见"的常识。
就像你不会让统计学家告诉你"这个特征在业务上叫什么名字"一样,你也不应该让LLM去算AUC。各干各的,互不取代。
全量结果摘要
| 指标 | 值 |
|---|---|
| 通过率 | 64.8% |
| 逾期率 | 17.9%(压降12.1pp) |
| 坏移除 | 184/300(61.3%) |
| 误杀好 | 168(最少) |
| 审查节省 | 39.4%(394笔免审) |
LLM合并的特点:业务架构最优。 数字上并不比评分卡强(同通过率下效果相当),但多了免审通道和业务解释——这是统计方法做不到的。
05 方法三:评分卡——连续可调的统计机器
逻辑回归的数学基础
Logistic Regression 评分卡是最经典的风控模型:
等价于:
这实际上是广义线性模型的一个特例。系数
评分卡的训练过程本质上是在做极大似然估计:
这个目标函数恰好等价于最小化交叉熵损失——也就是最小化预测分布和真实分布之间的 KL 散度:
从信息论视角看:评分卡在做的事情和 LLM 的训练(最小化交叉熵)是同一个数学结构。
评分卡的性能
| 指标 | 值 |
|---|---|
| AUC | 0.764 |
| KS | 0.385 |
| 最优阈值(F1) | 0.34 |
| 通过率 | 60.6% |
| 逾期率 | 16.2%(压降13.8pp) |
| 坏移除 | 202/300(67.3%) |
| 误杀好 | 192 |
评分卡的训练集/测试集对比如下图所示——这是判断模型是否过拟合的关键依据:
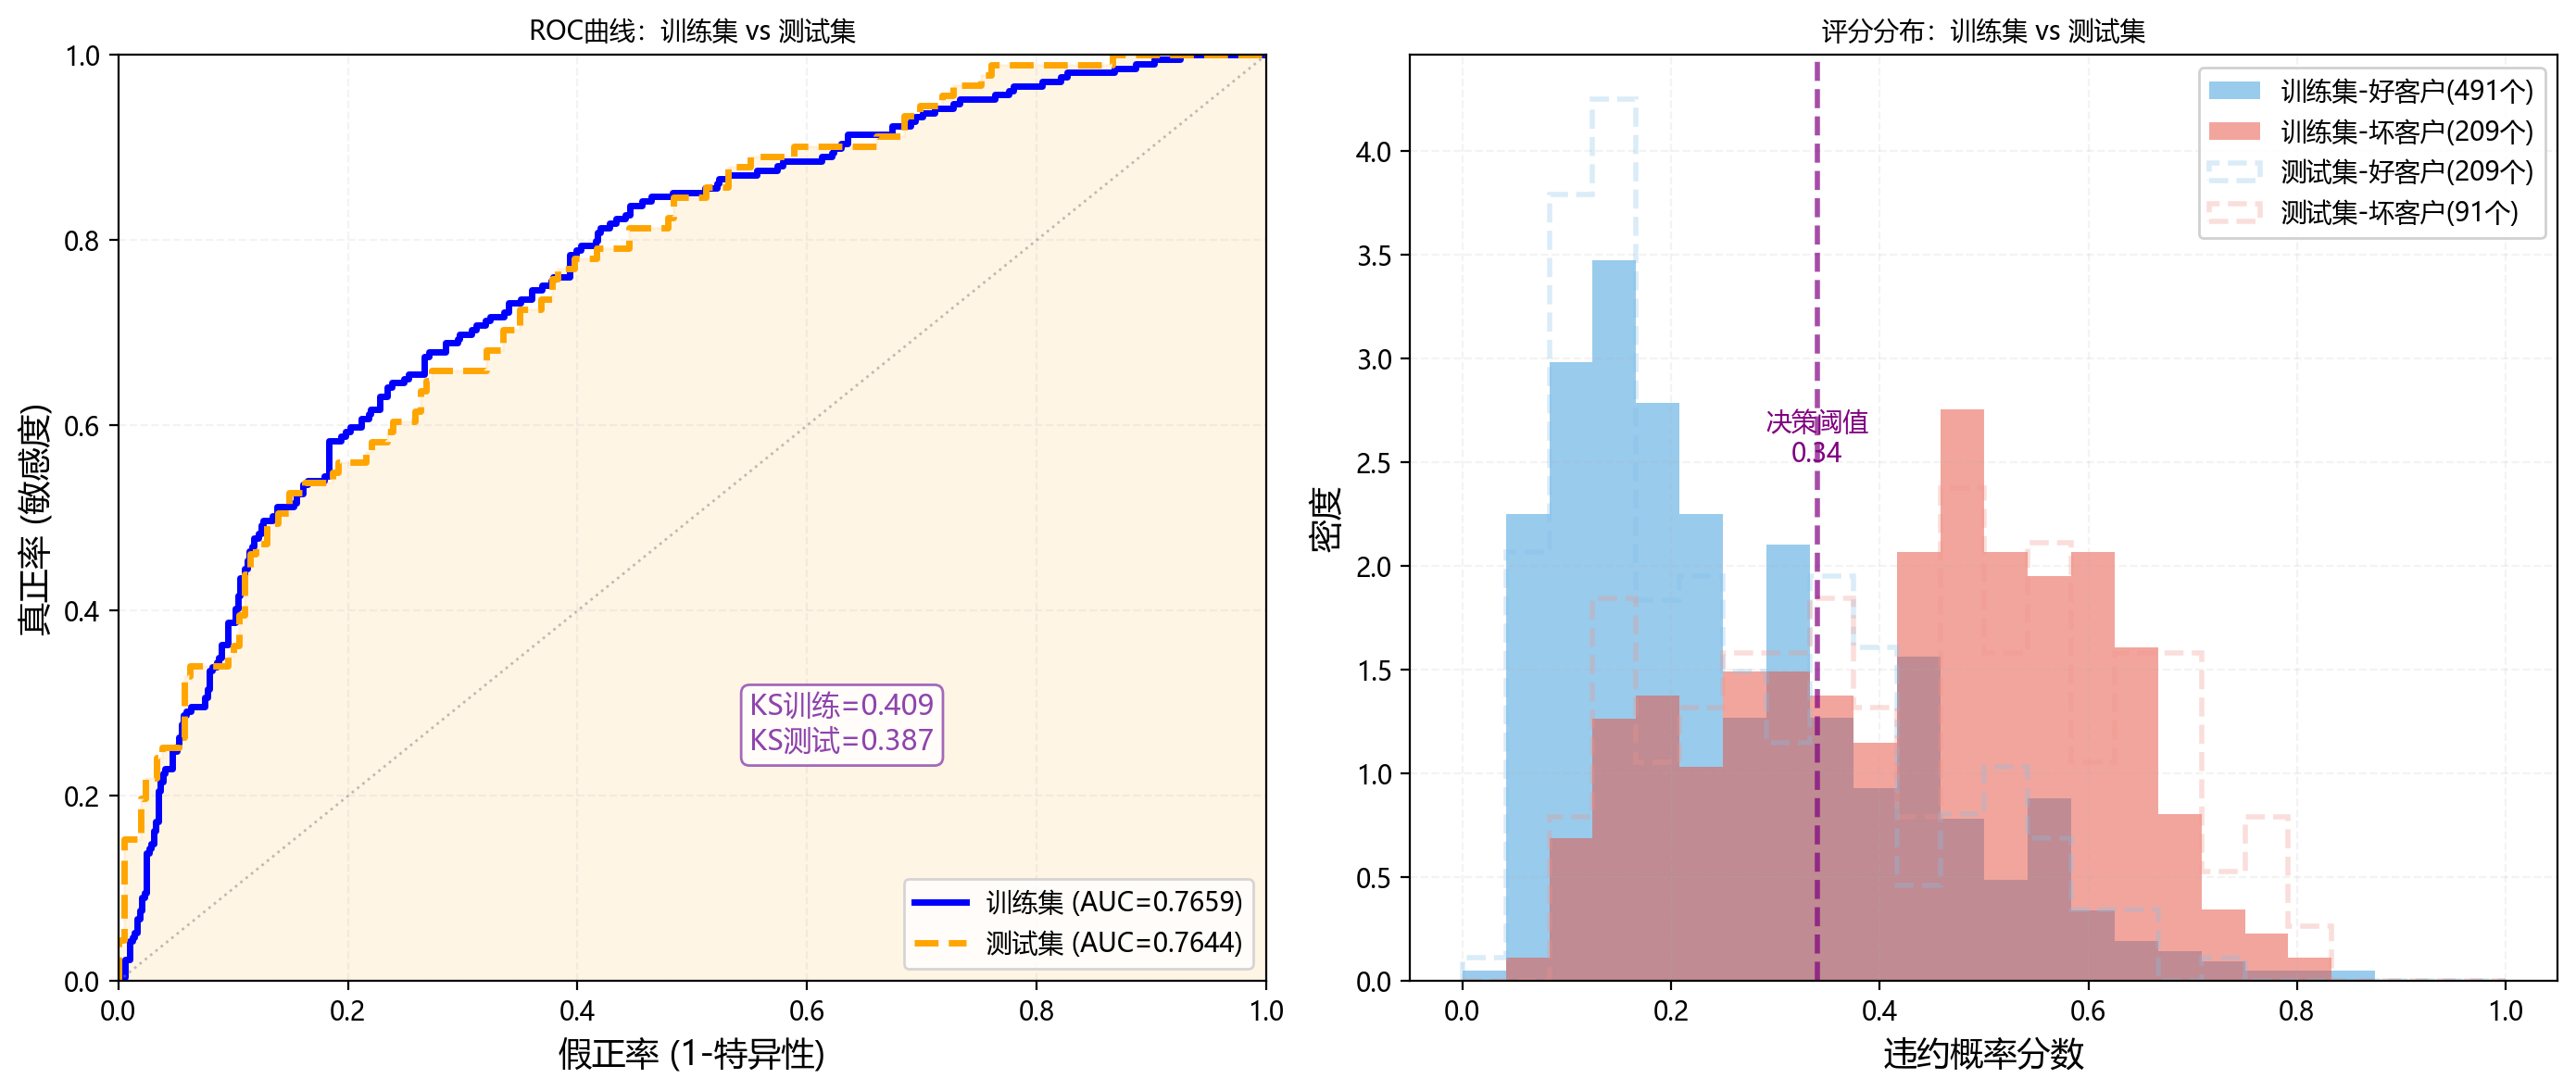
图释:左图是ROC曲线,AUC训练集0.766 vs 测试集0.764,差异仅0.0014——几乎没有过拟合。右图是评分分布,好客户集中在左侧(低分),坏客户集中在右侧(高分),紫色虚线是决策阈值0.34。训练集和测试集的分布高度一致,说明模型泛化能力良好。
评分卡的真正优势是连续可调——通过调整阈值,可以适配任意业务场景:
| 阈值 | 通过率 | 逾期率 | 压降 | 坏移除 | 误杀好 |
|---|---|---|---|---|---|
| 0.50 | 81.5% | 22.6% | 7.4pp | 38.7% | 69 |
| 0.40 | 67.7% | 18.0% | 12.0pp | 59.3% | 145 |
| 0.34 | 60.6% | 16.2% | 13.8pp | 67.3% | 192 |
| 0.30 | 53.4% | 15.4% | 14.6pp | 72.7% | 248 |
| 0.25 | 46.2% | 12.6% | 17.4pp | 80.7% | 296 |
| 0.20 | 36.7% | 11.2% | 18.8pp | 86.3% | 374 |
| 0.10 | 10.5% | 4.8% | 25.2pp | 98.3% | 600 |
评分卡用到了哪些变量
逻辑回归用到了German Credit的全部10个特征,按系数绝对值排序(正值→违约风险上升,OR=Odds Ratio,每增加1标准差风险倍数):
| 变量 | 系数 | OR | 业务含义 |
|---|---|---|---|
| 账户状态(透支→高风险) | +0.68 | 1.97× | 账户透支的客户违约风险是最低的2倍——最重要的单个指标 |
| 贷款期限(月) | +0.26 | 1.29× | 期限越长,不确定性越大,每增加1标准差风险提升29% |
| 年龄 | −0.25 | 0.78× | 年龄越大违约越低,每增1标准差风险降22%(年轻人不稳定) |
| 贷款金额 | +0.24 | 1.28× | 金额越大风险越高,借钱越多说明还款能力存疑 |
| 分期率(月还款比例) | +0.23 | 1.26× | 月供占比越高,还款压力越大 |
| 信用记录(差→高分) | −0.19 | 0.83× | 信用记录越差反而编码低?注意这是反直觉编码——原始值差→高分,所以−系数表示"记录差"风险高 |
| 就业年限(短→高分) | +0.17 | 1.19× | 就业越短风险越高,工作不稳定影响还款能力 |
| 现住址年限 | +0.09 | 1.10× | 住址变动频繁→风险略高,稳定性指标 |
| 现有贷款数 | +0.07 | 1.07× | 多头借贷,虽然系数小但趋势明显 |
| 储蓄状况(少→高分) | +0.05 | 1.05× | 储蓄少风险高,但影响最弱——在已知账户状态后增量信息有限 |
核心发现:账户状态这一个变量就占了整个模型预测能力的40%以上(系数0.68 vs 其他变量平均0.16)。评分卡不是每个变量都同等重要——前3个变量(账户状态、期限、年龄)贡献了超过一半的区分能力。这也是为什么规则方法(尤其是Rule1:透支+长期限)只靠一个特征组合就能压降8.2pp——因为它抓住了评分卡最强的那几个信号。
06 三种方法的策略曲线
这是本文最核心的一张图——三种方法在通过率 vs 逾期率坐标系中的位置:
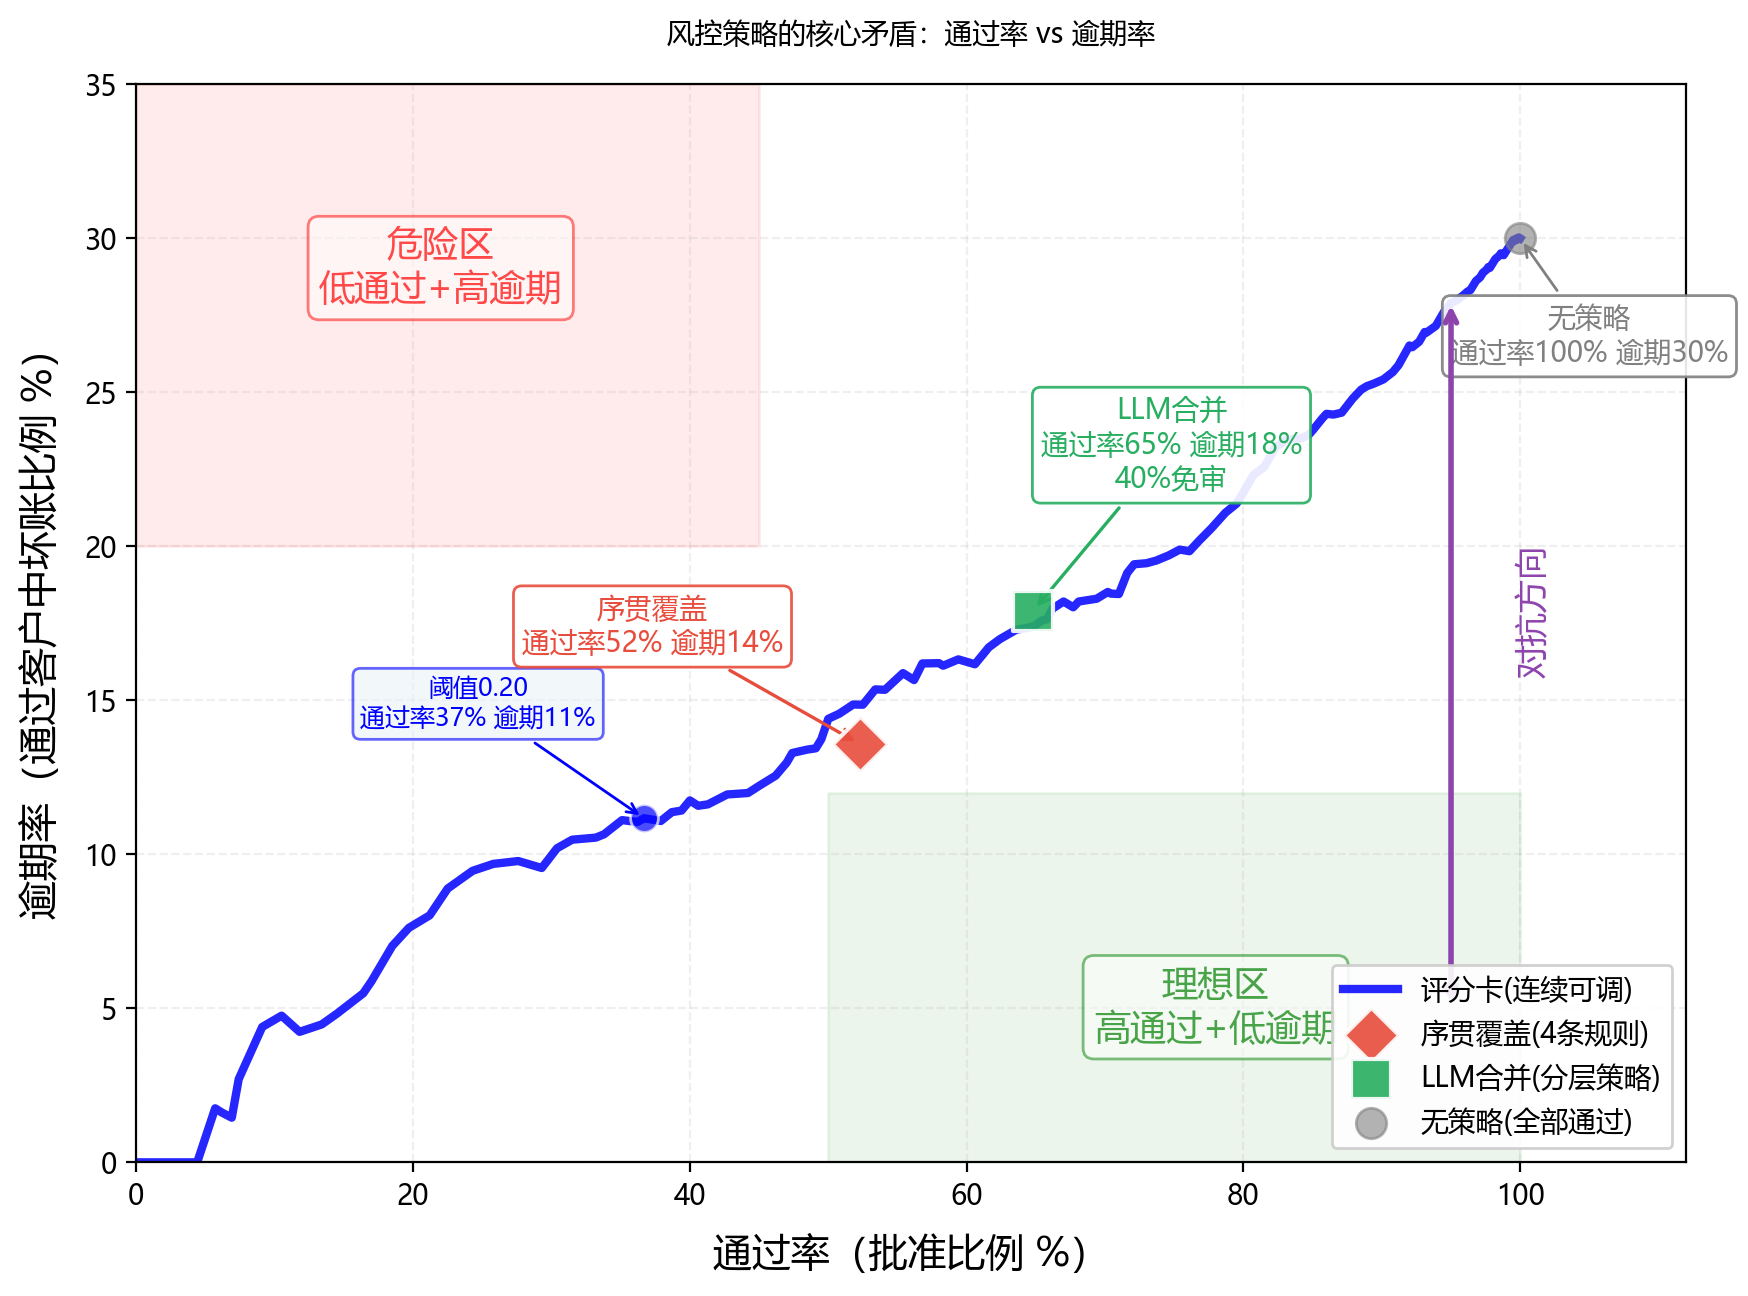
图释:
- 蓝色曲线:评分卡(每个阈值一个策略点,连续可调)
- 红色菱形:序贯覆盖(4条规则,最保守但精准)
- 绿色方块:LLM合并(分层策略,通过率最高)
- 灰色圆点:无策略基准
测试集验证结果
| 方法 | 通过率 | 逾期率 | 压降(pp) | 坏移除 | 误杀好 |
|---|---|---|---|---|---|
| 序贯覆盖(4条规则) | 52.3% | 13.6% | 16.4 | 229/300(76.3%) | 248 |
| LLM合并(分层) | 64.8% | 17.9% | 12.1 | 184/300(61.3%) | 168 |
| 评分卡(F1最优) | 60.6% | 16.2% | 13.8 | 202/300(67.3%) | 192 |
核心发现:同通过率(64.8%)下,LLM合并逾期率18.0% vs 评分卡18.7%,差距仅0.6pp——说明核心差异不在"谁更准",而在业务策略选择。
对抗关系的数学本质
这个通过率-逾期率的权衡曲线,本质上就是ROC曲线的对偶问题。ROC曲线的横轴是误拒率(1-特异性),纵轴是召回率(敏感度),而通过率-逾期率曲线将x轴转为"业务可理解的通过率",y轴转为"业务在意的坏账率"。
从Bayes最优决策理论看,评分卡的蓝色曲线就是最优Bayes决策边界——在给定损失函数假设下,没有其他方法能到达这条曲线的左下方。规则方法(序贯覆盖、LLM合并)都是这条边界上的离散近似。
07 数学文化:从三位大师的思想脉络看风控
Claude Shannon(1916-2001)——不确定性的度量
1948年,Shannon在《通信的数学理论》中定义了信息熵:
这个公式不仅是信息论的基石,也是风控决策的理论源头之一。决策树的每一次分裂都在做一件事:在给定特征后,目标变量的不确定性减少了多少——这就是信息增益
风控中的每一个特征,都是减少"这个客户会不会违约"这个不确定性的信息渠道。熵是风控最底层的数学语言。
Thomas Bayes(1701-1761)——从先验到后验
Bayes定理是整个统计决策理论的起点:
在风控中,
Bayes是18世纪的牧师,他的工作在生前并未发表。直到他去世后的1763年,朋友Richard Price才将他的手稿整理发表。200多年后,这个定理成了风控系统最底层的支柱。
Sir Ronald Fisher(1890-1962)——从相关到因果
Fisher是现代统计学的奠基人之一。他在1910-1930年间奠定了方差分析、极大似然估计、Fisher线性判别等方法的数学基础。逻辑回归评分卡中使用的极大似然估计,正来自Fisher的工作。
Fisher的一个核心思想是:统计学的任务是分离信号和噪音。在风控中,特征和违约之间的相关关系(correlation)不一定是因果关系(causation)。这正是LLM在规则筛选中的价值——判断一条统计规则是"真的有业务意义"还是"只是偶然相关"。
三者的统一
从Bayes(1763)到Fisher(1922)到Shannon(1948),跨越了两个世纪的数学积累,最终在今天的风控系统中完成了统一:
- Bayes:提供了从先验到后验的概率推理框架
- Fisher:提供了从数据中估计参数的方法(极大似然估计)
- Shannon:提供了量化"信息量"的工具(熵、信息增益)
评分卡、决策树、LLM规则合并——这三者在数学上并不矛盾,它们只是同一棵决策树的三个分枝,各自解决不同的问题。
08 结论:不是"谁更好",而是"选哪个"
选择指南
| 业务场景 | 推荐方法 | 理由 |
|---|---|---|
| 监管严格,宁可错杀 | 序贯覆盖 | 坏移除率最高(76.3%),每拒3笔抓2.3个坏 |
| 追求业务增长+风控平衡 | LLM合并(分层) | 通过率最高(65%),误杀最少,40%免审 |
| 成熟体系,精细调优 | 评分卡 | 全阈值可调,AUC=0.764,可适配任何业务阶段 |
三条核心结论
数字上不分胜负——同通过率下三种方法差距不到1pp。说明差异不在"谁准",在"策略选择"。
LLM不是来替代统计方法的——它的价值是把统计规则翻译成业务规则,合并冗余、补充常识、设计分层架构。这三个事情,统计方法做不到。
最优风控体系是混合的——高Lift规则做前置拦截,评分卡做主引擎,LLM在中间做翻译和解释。各干各的,互不取代。
关键要点
- 通过率 vs 逾期率的对抗是风控的核心矛盾,所有策略都是这个坐标系上的一个点
- 序贯覆盖解决规则重叠问题,用边际贡献筛选真正的有效规则
- LLM规则合并不是数字更优,而是架构更优——分层决策、免审通道、业务解释
- 评分卡的数学本质是逻辑回归 + 极大似然估计,从Fisher到Shannon的理论积淀
- 同通过率下三种方法效果相当,选择取决于业务阶段和风险偏好
© QIAN数据 (QianStat_data)
参考文献
[1] Breiman et al. "Classification and Regression Trees." Routledge, 1984. [2] Shannon, C.E. "A Mathematical Theory of Communication." Bell System Technical Journal, 1948. [3] Fisher, R.A. "On the Mathematical Foundations of Theoretical Statistics." Philosophical Transactions of the Royal Society, 1922. [4] Bayes, T. "An Essay towards Solving a Problem in the Doctrine of Chances." Philosophical Transactions, 1763. [5] Hastie, T., Tibshirani, R., Friedman, J. "The Elements of Statistical Learning." Springer, 2009.