AI Agent越来越多,但谁来给Agent的风险分类——一个实用治理框架
2026年8月8日 · 预计阅读 12 分钟 关键词:AI Agent、风险分类、治理框架、自主性等级、ARC
客服Agent、代码生成Agent、金融交易Agent、自主安全Agent,共同点是什么?都能自主行动——调用工具、读写数据、根据环境反馈决定下一步。而现有通用AI风险框架(NIST AI RMF、EU AI Act等)的评估重点大多放在"模型输出"这一环,对连续行动的Agent覆盖不足。这篇文章用"12维风险评分 → GPA聚合 → IAT分级 → 自主性分级 → 三级治理输出"的链路,把"Agent有多危险、该管到哪一级"变成一套可重复的评估流程。ARC(Agent Risk Classification)是本文为演示这套思路构建的示例框架,不是监管或行业标准。
01 现象:Agent在跑,治理没跟上
2023年以来,AI Agent从演示走向生产环境的速度明显加快。自主编程Agent(如Devin)、Multi-Agent协作系统、AutoGPT式的任务链分解、MCP(Model Context Protocol)协议驱动的工具调用网络,一批批进入企业流程。
能力先行的同时,治理动作明显滞后。不少团队的Agent已经能调用API、读写数据库、操作生产环境,风险评估还停留在"模型输出对不对"的阶段。评估流程跟不上部署速度,在金融、交易这类场景里不是小问题:一个能自主行动的Agent,它的错误不再是"答错一道题",而可能是实打实的资金损失。这不只是合规问题,还可能演变成运营事故。
02 为什么现有框架管不住Agent
多数通用AI风险框架(NIST AI RMF、ISO/IEC 42001、EU AI Act分类法)把评估重点放在"模型-输出"环节:输入问题、模型返回答案、评估答案的风险。
Agent AI打破了这条链路。它不只是回答问题,而是连续行动:决定做什么、调用什么工具、按什么顺序执行、根据环境反馈调整下一步。这个差异放大了四类风险:
2.1 自主决策权
Agent不是被动响应器,而是主动行动者。它决定是否执行行动、何时执行、以什么顺序执行。这个"决定权"本身就是传统框架没有覆盖的维度。
2.2 工具调用链
一个Agent在一个任务中可能调用5-15个不同工具——读写文件、执行Shell命令、调用外部API、操作数据库。每个工具调用都是风险暴露点,且风险不是简单相加:
其中
2.3 多步推理副作用
Agent的推理过程不一定是"线性正确"的。它可能在中间步骤产生不可逆的副作用——比如先删除了一个文件,在后续步骤中才"意识到"这是个错误决定。事后可追溯,不等于事前可预防。
2.4 环境反馈回路
Agent与环境交互后,环境状态改变,Agent继续基于新状态做决策。这个反馈闭环可能形成风险复合效应:
如果
四类放大器叠加,说明Agent的风险很难直接套用传统AI风险框架——它需要一套针对"连续行动"的评估方法。
03 ARC框架:给Agent配一张风险处方
ARC(Agent Risk Classification)是本文构建的示例框架,针对典型Agent AI系统设计结构化、可重复的风险评估流程。设计思路:不去预测所有失败模式,而是对Agent的固有风险维度系统化评分,再根据评分匹配合适的治理等级。
3.1 12维风险评分
ARC定义12个独立风险维度,每个维度按1-5分打分:
| 维度 | 说明 | 低风险(1) | 高风险(5) |
|---|---|---|---|
| 意图对齐 | Agent目标与人类意图的匹配度 | 固定目标 | 目标可自修改 |
| 工具滥用 | 工具调用的越界风险 | 无工具调用 | 无限制工具调用 |
| 数据泄露 | 敏感数据处理风险 | 无数据处理 | 处理PII/支付数据 |
| 推理失控 | 多步推理过程中的偏差累积 | 单步推理 | 10+步骤自主推理 |
| 环境破坏 | 对外部系统状态的修改能力 | 只读 | 可删除/修改 |
| 目标漂移 | 长期任务中目标的稳定性 | 单次任务 | 无限时任务 |
| 提示注入 | 对抗性提示攻击的脆弱性 | 无直接暴露 | 面向公众开放 |
| 权限溢出 | 权限提升的可能性 | 最小权限 | 最高权限(root/管理员) |
| 不可解释性 | 决策过程的可理解程度 | 完全可追踪 | 黑箱推理 |
| 错误传播 | 错误在链式调用中的扩散 | 单步可隔离 | 全链不可逆 |
| 社会操纵 | 对人类的欺骗或操纵能力 | 无社交交互 | 可模拟人类 |
| 部署扩散 | Agent副本/实例的扩散范围 | 单实例 | 多实例并发 |
综合风险评分(等权):
更精细的加权版本:
权重
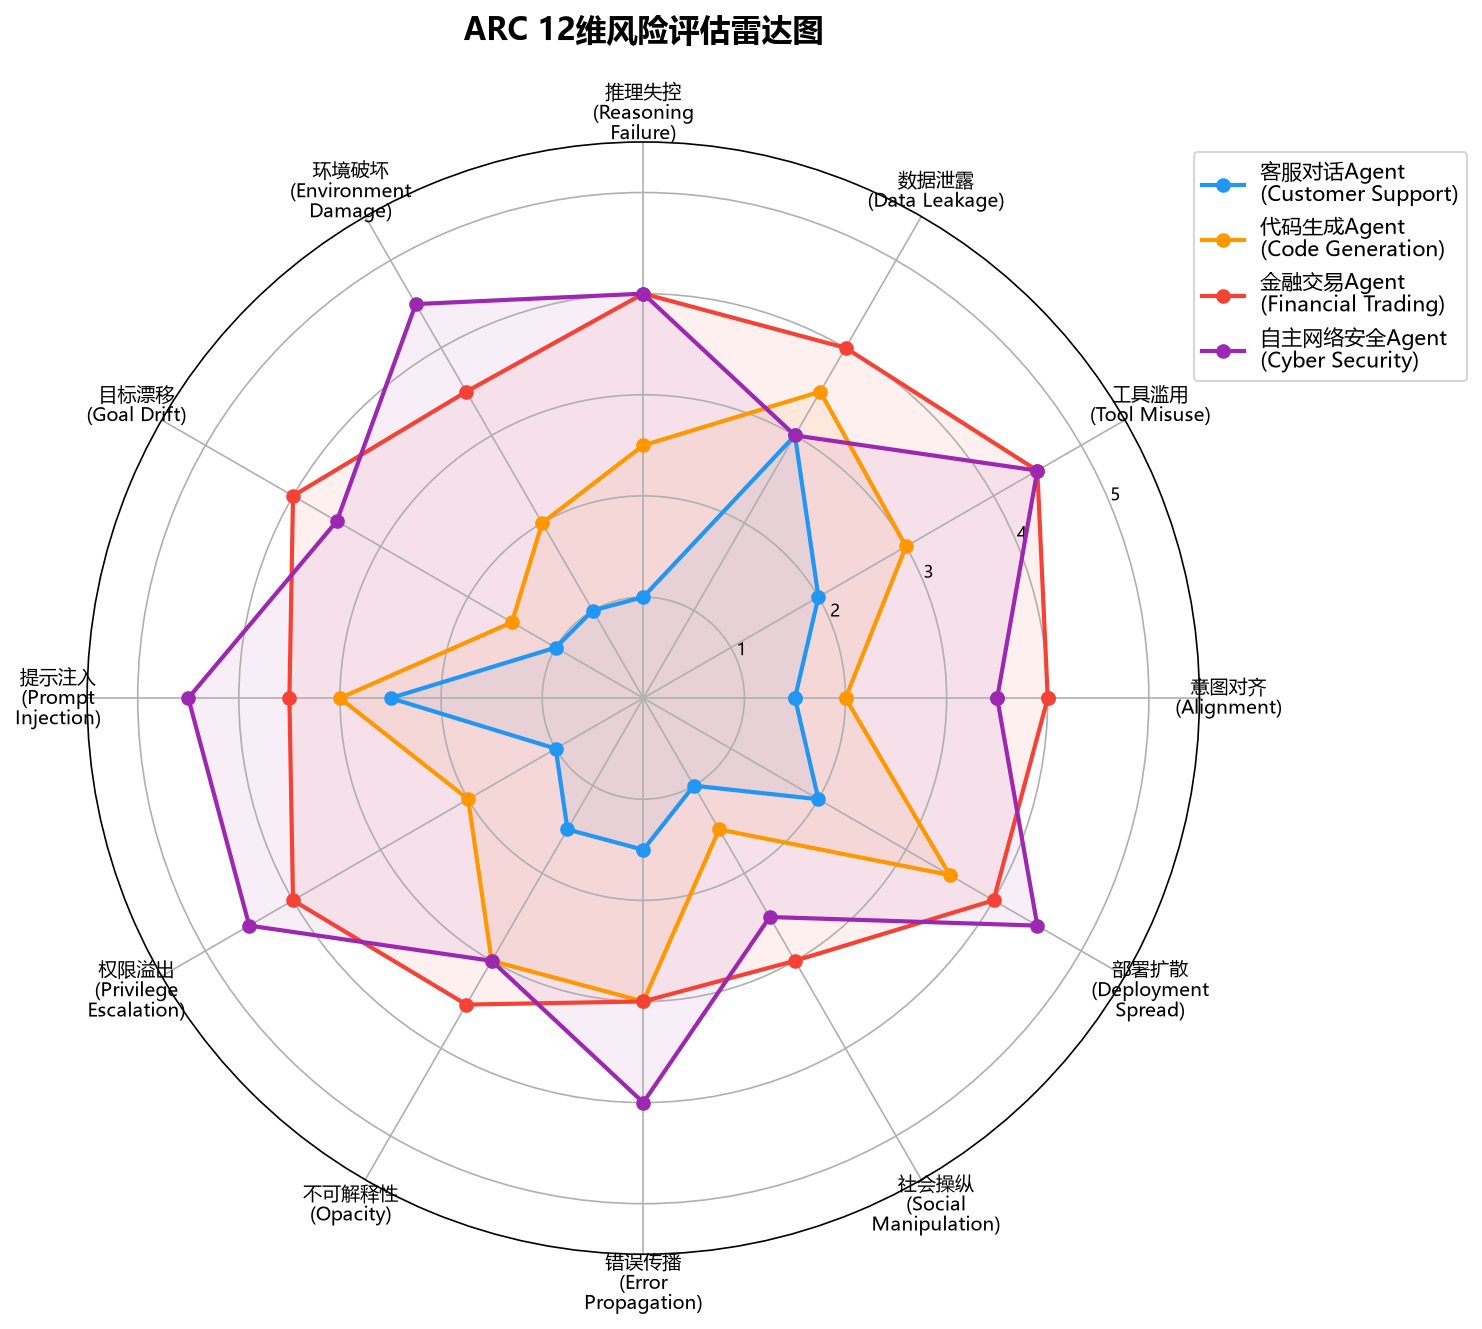
3.2 GPA聚合:把12个维度压成三个指标
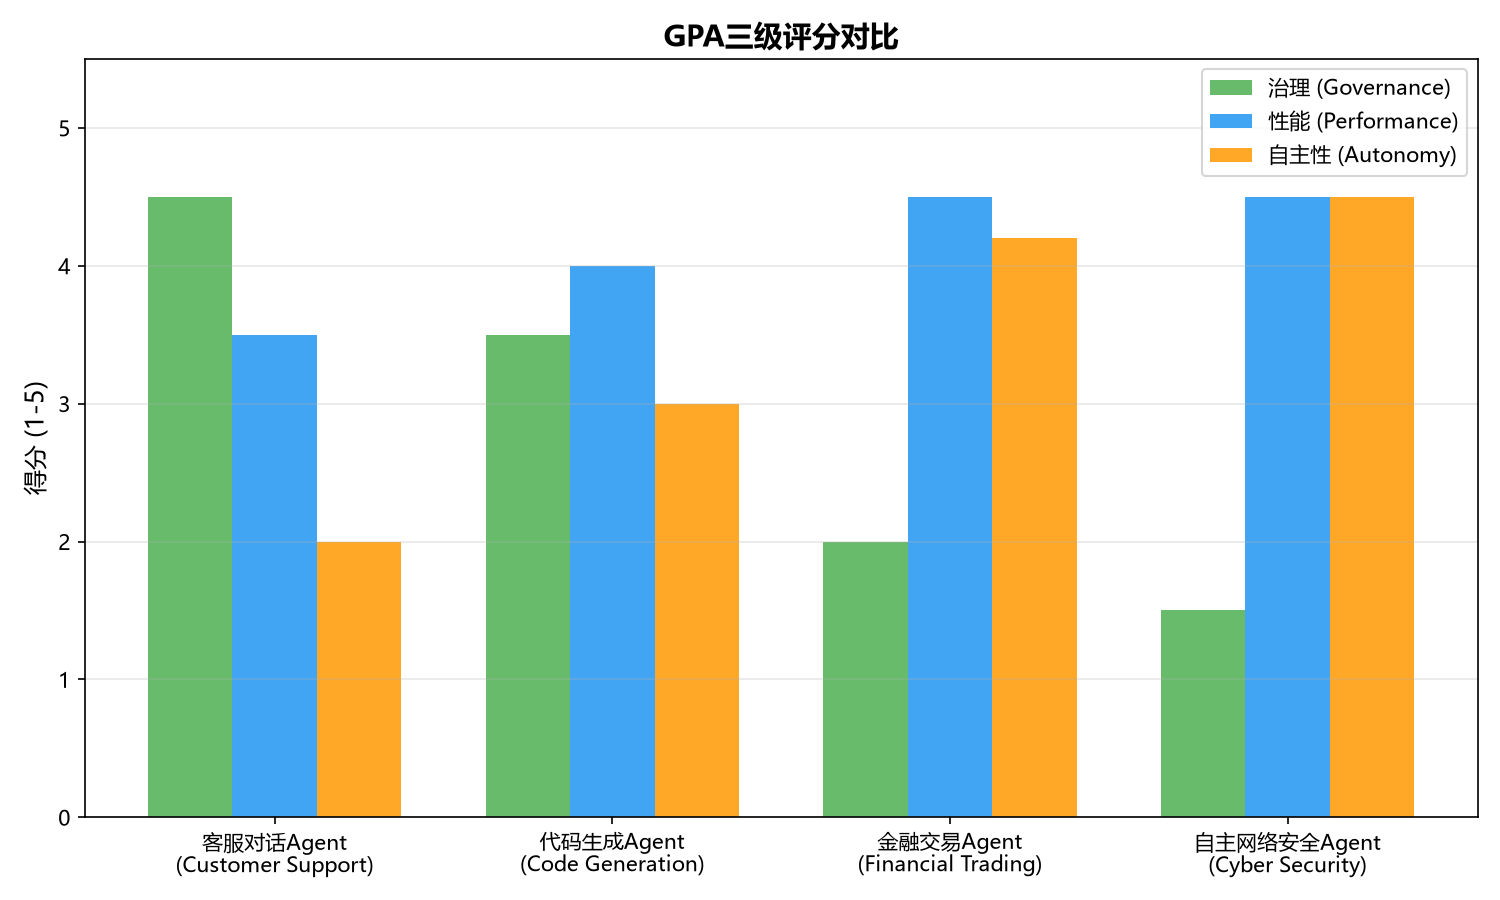
12维评分是精细画像,管理层面还需要一个可操作的总分。ARC把12维映射到三个高层指标:
- G - 治理完备性:组织对Agent的控制能力(监控、审计、访问控制、熔断机制)
- P - 性能可靠性:Agent完成任务的质量(准确率、鲁棒性、失败恢复)
- A - 自主性等级:Agent脱离人类干预独立行动的程度
综合风险评分(风险向,分数越高越危险):
其中
3.3 IAT五级分类
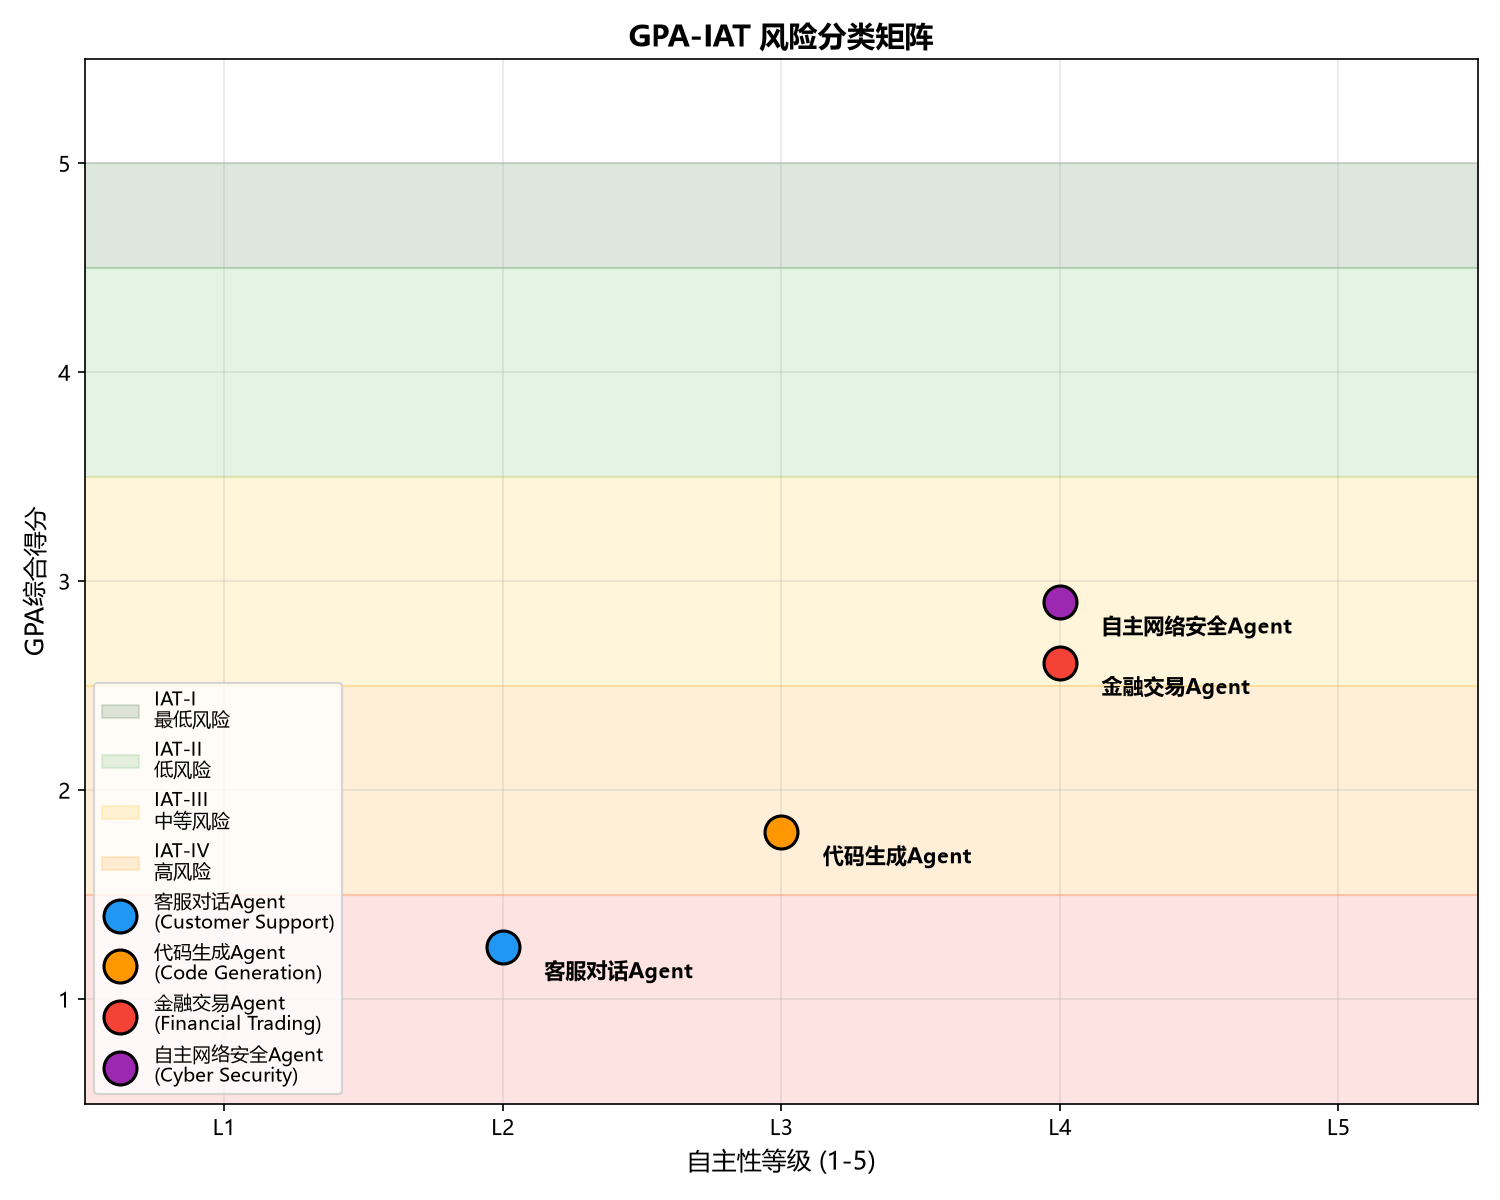
基于GPA风险分,ARC把Agent归入5个综合评估等级(区间左闭右开,与代码实现一致):
| IAT等级 | GPA风险分 | 含义 | 治理要求 |
|---|---|---|---|
| IAT-I | < 1.0 | 最低风险 | 标准监控 |
| IAT-II | [1.0, 1.8) | 低风险 | 增强日志 |
| IAT-III | [1.8, 2.6) | 中等风险 | 人工抽查 |
| IAT-IV | [2.6, 3.4) | 高风险 | 人工审批部署 |
| IAT-V | ≥ 3.4 | 极高风险 | 禁止部署 |
3.4 自主性五级框架
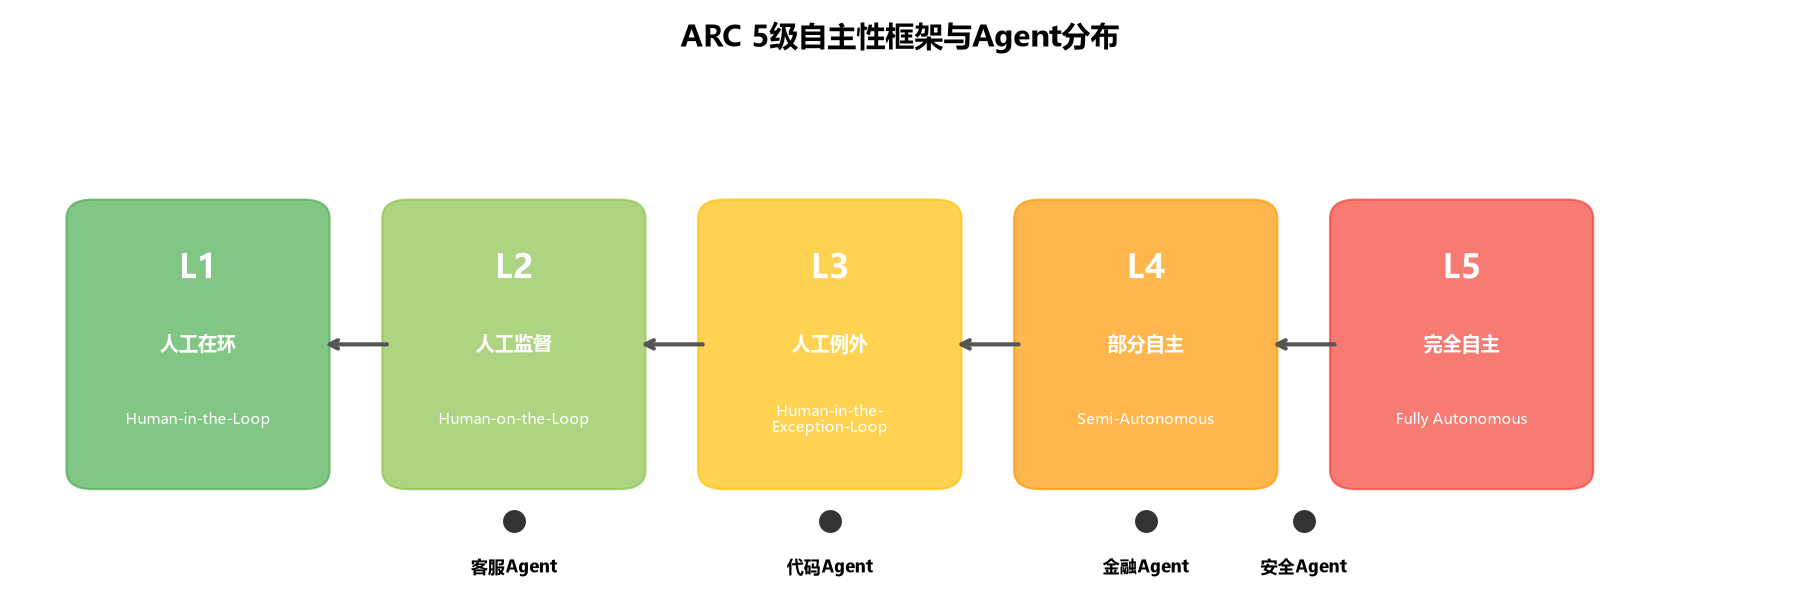
自主性是Agent风险的核心变量。ARC定义了独立于具体任务的自主性等级量表:
| 等级 | 名称 | 特征 |
|---|---|---|
| L1 | 人工在环(HITL) | 每步操作需人类确认 |
| L2 | 人工监督(HOTL) | 人类实时监控,可干预 |
| L3 | 人工例外(HITEL) | 人类只在异常时介入 |
| L4 | 部分自主 | 人类设定目标,Agent规划执行 |
| L5 | 完全自主 | 人类仅做战略委托 |
04 代码实现:给四个典型Agent打分
下面的代码用ARC框架对四个典型Agent做评估:客服对话Agent、代码生成Agent、金融交易Agent、自主网络安全Agent。要评估别的Agent,改三个字典(dims、G、P、A)就行:
运行输出:
风险排序符合直觉:客服Agent原始风险低(ARC 1.58)、治理完善(G=4.5)、自主性低(L2),综合风险最低(IAT-II);金融交易Agent和安全Agent原始风险高(ARC 3.75/3.83),加上治理完备性低(G=2.0/1.5)、自主性高(L4),综合风险升到IAT-IV,需要人工审批才能部署。
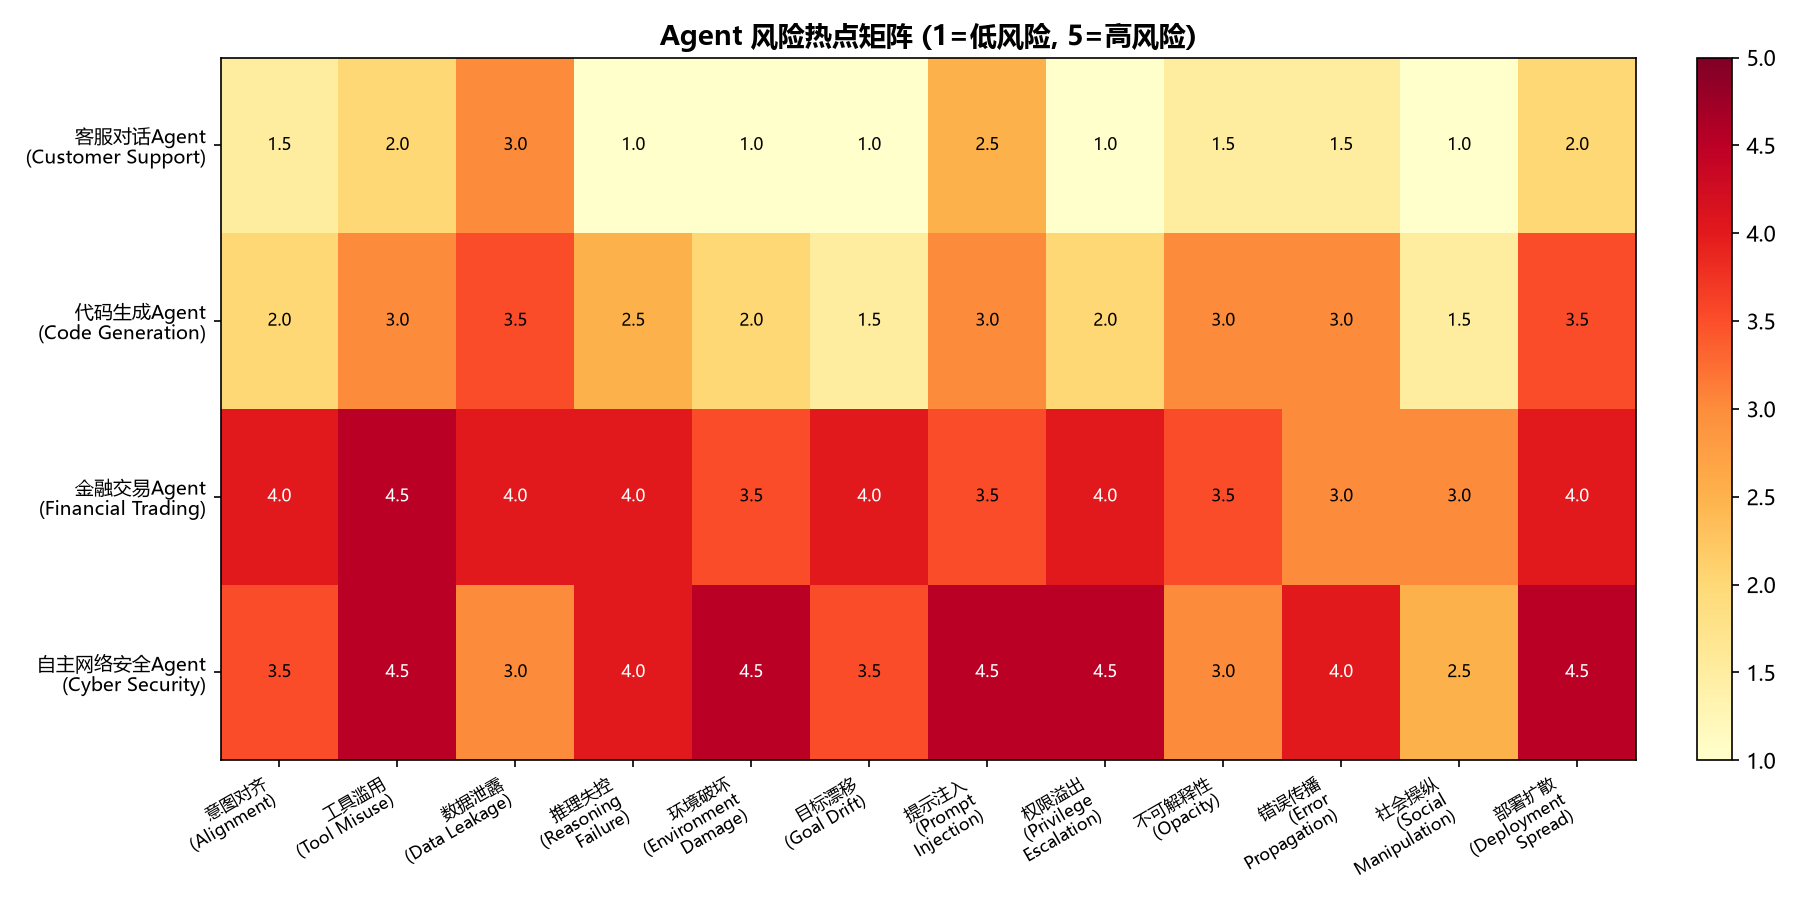
原始风险(12维评分)回答"有多危险",GPA综合风险回答"治理与自主性综合下的风险水平",IAT分类回答"该管到哪一级"。三者联动才是完整的治理决策。
05 三级治理输出:从评分到行动
ARC的最终产出不是一堆分数,而是三级治理输出:
第一级:Agent风险护照
每个Agent获得一份标准化护照,包含:
- ARC 12维雷达图(一目了然的风险画像)
- GPA得分与IAT分级
- 自主性等级
- 关键风险关注点(得分≥4的维度)
第二级:治理行动矩阵
基于IAT分级和自主性等级,生成差异化的治理要求:
| 治理措施 | L1 | L2 | L3 | L4 | L5 |
|---|---|---|---|---|---|
| 逐步审批 | ✅ | — | — | — | — |
| 实时监控 | ✅ | ✅ | ✅ | — | — |
| 异常熔断 | ✅ | ✅ | ✅ | ✅ | — |
| 行为日志审计 | ✅ | ✅ | ✅ | ✅ | ✅ |
| 权限沙箱 | — | ✅ | ✅ | ✅ | ✅ |
| 红队测试 | — | — | ✅ | ✅ | ✅ |
| 人机协商机制 | — | — | — | ✅ | ✅ |
| 战略委托协议 | — | — | — | — | ✅ |
第三级:持续监控看板
风险评估不是一次性体检。ARC要求:
- 动态重评:Agent升级、工具链变更、部署环境变化时触发重评
- 运行时异常检测:GPA分数漂移超过0.5时自动告警
- 事件记录:每次工具调用的风险日志写入不可篡改的审计链
06 数学文化:AI风险治理的三次范式跃迁
AI风险治理框架的演进,可以从数学结构上分成三个阶段。
第一次跃迁:Asilomar AI Principles(2017)——原则时代
2017年,Future of Life Institute在加州Asilomar会议发布23条AI发展原则,用定性原则框定底线:
这是AI治理的公理阶段——告诉世界"应该做什么",但不告诉"具体怎么做",类似欧几里得几何的五大公设:正确、优雅,但不足以解决所有问题。
第二次跃迁:EU AI Act(2021-2024)——分类时代
EU AI Act(Regulation (EU) 2024/1689)把AI系统按风险分为四类:不可接受风险、高风险、有限风险、最低风险:
这是AI治理的分类阶段——把AI系统"装进盒子里"。局限在于分类法面向应用场景,而非技术能力结构:一个客服Agent可能被评为"有限风险",但它可能拥有完全自主的数据库写入权限——场景分类无法捕获这类风险。
第三次跃迁:ARC(2025)——量化评分时代
ARC(本文示例框架)的思路是引入一个可计算的、多维的、动态的风险度量空间:
从12维特征空间到治理决策空间的可计算公式,而不是原则清单或场景分类。
三个时代的关键区别:
| 特征 | Asilomar原则 | EU AI Act | ARC框架 |
|---|---|---|---|
| 基础逻辑 | 道德准则 | 法律分类 | 量化度量 |
| 粒度 | 23条原则 | 4个风险类 | 12维×5级 |
| 可操作性 | 低 | 中 | 高 |
| 覆盖Agent风险 | 否 | 部分 | 是 |
| 可重复性 | 不适用 | 场景依赖 | 工具保证 |
| 动态更新 | 无 | 立法修订 | 实时重评 |
从数学结构看,三个范式对应不同工具:Asilomar是集合论(定义"好"AI的边界),EU AI Act是分类器(决策树式分类,但特征空间不足),ARC是度量空间加加权范数(在12维风险空间定义距离)。ARC本质是在学习一个从风险特征到治理策略的映射函数:
这个映射由GPA聚合、IAT分级、自主性等级、治理矩阵复合而成,好处是"先度量、再分类、最后行动"的递推结构——每一步的输入都是上一步可验证的输出。
07 结论:Agent治理的PDCA循环
ARC给AI治理从业者的启发,是风险管理闭环本身:
对于正在或计划部署Agent的企业,可以参考的行动路线:
短期(30天内)→ 建立Agent清单
- 盘点组织中所有Agent系统(包括PoC和实验项目)
- 用12维量表对每个Agent做初步评分
- 识别出IAT-IV和IAT-V级别的"高危Agent"
中期(90天内)→ 实施分级治理
- 根据IAT分级配置差异化的监控和审批流程
- 部署运行时异常检测(关注GPA漂移)
- 建立Agent风险护照制度
长期(180天+)→ 构建治理基础设施
- 建立Agent工具调用的审计追踪系统
- 把评估嵌入CI/CD管线(每次Agent更新自动触发重评)
- 培养Agent风险评估能力(每个Agent配备"风险守护者")
Agent的部署节奏不会因为这篇文章停下来,也不该停。风险分类能做的,是让部署从"先跑起来再说"变成"先知道边界在哪"。
常见问题
Q1:ARC框架是标准吗?能不能直接照搬?
ARC是本文构建的示例框架,用于演示"多维评分→聚合分级→治理行动"的完整思路,不是任何监管或行业标准。实际落地时,12个维度、权重和IAT阈值都应该根据你所在行业的监管要求(如EU AI Act、中国《生成式人工智能服务管理暂行办法》)和机构自身的风险偏好调整。
Q2:12维评分怎么打分?谁来打?
每维1-5分需要评估者结合Agent的设计文档、权限配置、部署环境给出判断。建议由模型治理团队牵头,联合安全、法务、业务三方打分,并对打分理由留档。评分的客观性取决于评估者是否掌握了Agent的实际能力边界——这正是"先盘点,再评估"的意义。
Q3:ARC评估多久做一次?
至少三个触发点:上线前必评;Agent升级、工具链变更、权限调整、部署环境变化时重评;定期(如季度)复评,结合运行监控数据(GPA风险分漂移、异常调用记录)动态调整。风险是动态的,评估不能是一次性的。
数据说明: 本文全部数字来自ARC框架模拟评估脚本 gen_figures.py(四个典型Agent的12维评分、GPA聚合与IAT分级,输出为脚本实际运行结果),图表由同一脚本生成,可复现。 代码环境: Python 3.12.3 / numpy 2.5.1 / matplotlib 3.11.0
**参考文献**
- Asilomar AI Principles. Future of Life Institute. 2017.
- European Union. EU AI Act (Regulation (EU) 2024/1689). 2024.
- NIST. AI Risk Management Framework (AI RMF 1.0). 2023.
- Russell, S. Human Compatible: AI and the Problem of Control. Viking, 2019.
ARC(Agent Risk Classification)为本文构建的示例框架,用于演示Agent风险分类的方法论,不声称来自任何外部机构标准。图表生成代码见同目录下的 gen_figures.py。