多Agent合谋——当一个AI骗另一个AI时,反欺诈怎么接
本文为AI辅助创作,数据实测与结论推导由作者完成。
(以下案例为示意场景,用于拆解合谋的数学结构,不指向任何真实机构。)
审计部老周调出最近三个月的放款记录,想复盘中介团伙。他习惯的做法是揪"坏样本":找那些逾期、套码、重复设备的单子。可这次他盯着名单犯难——单笔看,每一笔都有完整合同、有收入流水、有审批流程,坏账率也没有明显异常。唯一的别扭是:有十几笔申请,借款人的资料各不相同,却总在差不多的时间里、经由同两个审批员、从同一台终端进件,然后几乎同时放款、同时"忘记还款"。
单笔能挑出来的毛病很少,可"同时"这个词一直在重复。
老周把这几百笔申请摊开,开始不再按"单笔"看,而是按"谁和谁总是一起出现"看。这一看,性质就变了。
关键词:多Agent合谋,共现矩阵,Jaccard相似度,模块度Q,团伙检测
01 一个AI串通AI的场景
把老周遇到的局面放到AI语境里:假设一家机构的自助进件和自动审批,越来越多环节由Agent完成。一个Agent负责收集和包装借款人资料("借款人方"),另一个Agent负责走审批流程、给出通过建议("审批方")。在理想设计里,两者是隔离的——资料方见不到审批规则,审批方不该轻易被同一批资料反复喂。
但2026年的一批研究开始给出不同结论:多Agent协作既能放大业务效率,也能放大一起干坏事的能量。来自2026年的最新研究(上海交大与上海AI实验室合作的论文)系统构造了一个多Agent金融欺诈模拟(作者称其为MAFF-Bench),覆盖28类在线欺诈场景。它的核心发现对风控有直接冲击:当存在合谋通道时,"群体级欺诈影响率"从17.0%抬到41.0%,对话级成功率从35.0%抬到60.2%——合谋让坏人更容易抱团,把坏事变得更集中。
论文把"脆弱点"指得更准:交互深度和活动水平是合谋成败的关键。同一套恶意Agent,对话从5轮到40轮,其欺诈成功率从10.8%一路爬到60.2%(DeepSeek-R1)。也就是说,让一个Agent和另一个Agent"多聊几轮",本身就是风险的加杠杆。
老周的名单里没有多Agent,但有同构的东西:小额、高频、定点、复用。同一撮人反复出现在同一处理节点上,形成一条盘根错节的共现链。反欺诈要抓的,正是这条链。
02 为什么单笔检测抓不住合谋
单笔风控的逻辑是"看这一个对象够不够好":给一笔申请一个坏账概率,设阈值,过则批。设借款人申请为向量
独立地判断每一笔。这套体系假设"单笔好坏是独立的"——某笔坏不坏,只取决于它自己的特征。
合谋恰好违背这个假设。十个借款人各自看起来正常,个顶个的概率都不高,可它们共享同一批终端、同一段时间、同一处理节点。单笔独立性视角下,它们的联合状态被拆成了十个互不相干的小数字,每个都低,总和却是零。用概率的语言:
——合谋样本之间远远谈不上独立同分布,它们是高度正相关的"同时间、同空间"事件。任何把样本当孤岛的检测器,都天然看不见这种相关性。老周的单笔复盘会失望,恰是因为他看的那一层,压根不承载合谋信息。
所以要抓合谋,观察对象得从"单个借款人"换成"借款人之间的关系"。
03 图网络怎么把"合谋"变成可计算的问题
关系一旦进入视野,第一件事就是把它记下来。对每一笔申请,我们记录谁和谁"同框"出现。设全部记录为
光有共现表还不够,还得判断"多少算多"。中性业务下,两个实体共同出现的期望次数约等于各自出现频率的乘积除以总量:
当实测量显著高于这个期望,就成了"不该这么熟"的信号。由此可定义一系列相似度与强度度量。审批员之间的重叠,常用Jaccard相似度刻画:
其中
更强的工具是把共现矩阵升格成图,然后在图上找"又密又连"的子结构。给定一张带权图,邻接矩阵
需要提醒的是:共现、相似度、模块度,每个都是"一个维度"。单看任何一个都会被自然业务淹没(两个审批员同属一个支行,天然共享一大批借款人,
04 社群发现与异常检测:代码示例
把上面的抽象落到可以跑的数字上。我们合成一个小型信贷场景:300个借款人、40个审批员,其中10个借款人和审批员2/5串成一条合谋链,共用少量设备、高频同框;其余按"所属分支"松散分派。
先看共现矩阵和"团伙嫌疑分"。
python
# 数据合成:正常按分支疏松共现;10借款人+审批员2/5+复用设备高频同框
import numpy as np
import networkx as nx
from collections import Counter

np.random.seed(42)
N_STAFF, N_BORROWER = 40, 300
RING_B, RING_A = list(range(10)), [2, 5]
rng = np.random.default_rng(2026)

def branch(b): return (b * 7919) % 17                      # 伪随机所属分支
bappr = {br: list(rng.choice(N_STAFF, size=int(rng.integers(3, 6)), replace=False))
         for br in range(17)}                              # 每分支3~5个审批员
base, devices = [], {}
for b in range(N_BORROWER):
    for _ in range(int(rng.integers(8, 14))):
        a = int(rng.choice(bappr[branch(b)]))
        base.append((b, a, devices.setdefault(b, int(rng.integers(0, 2000)))))
ring = [(int(np.random.choice(RING_B)), int(np.random.choice(RING_A)),
         int(np.random.choice([9000, 9001, 9002]))) for _ in range(500)]
rec = base + ring

C = np.zeros((N_BORROWER, N_STAFF), dtype=int)             # 共现矩阵 C[b,a]
for b, a, _ in rec: C[b, a] += 1
top = np.unravel_index(np.argsort(C.ravel())[-6:], C.shape)
print("== top-6 共现组合(borrower x approver 共现次数) ==")
for r, c in zip(top[0][::-1], top[1][::-1]):
    tag = " <合谋>" if (r in RING_B and c in RING_A) else ""
    print(f"  bor{r:>3} x appr{c:>3}  x{C[r,c]:>3}{tag}")

devcnt = Counter(b for b, _, d in rec)                     # 每人关联的设备数
rec_exp = Counter()
for b, a, _ in rec:
    if a in RING_A: rec_exp[b] += 1                        # 与合谋审批员同框次数
score = {b: rec_exp[b] / max(devcnt[b], 1) for b in rec_exp}
print("== 团伙嫌疑分 top-6 (同框次数/设备数,值高=可疑) ==")
for b, s in sorted(score.items(), key=lambda x: -x[1])[:6]:
    print(f"  bor{b:>3}  嫌疑分={s:5.3f}{' <合谋>' if b in RING_B else ''}")
真实运行输出:
text
== top-6 共现组合(borrower x approver 共现次数) ==
  bor  2 x appr  2  x 34 <合谋>
  bor  5 x appr  2  x 30 <合谋>
  bor  7 x appr  5  x 29 <合谋>
  bor  0 x appr  2  x 28 <合谋>
  bor  0 x appr  5  x 28 <合谋>
  bor  9 x appr  5  x 28 <合谋>
== 团伙嫌疑分 top-6 (同框次数/设备数,值高=可疑) ==
  bor  2  嫌疑分=0.857 <合谋>
  bor  5  嫌疑分=0.848 <合谋>
  bor  0  嫌疑分=0.848 <合谋>
  bor  7  嫌疑分=0.844 <合谋>
  bor  1  嫌疑分=0.842 <合谋>
  bor  6  嫌疑分=0.821 <合谋>
注意看:单是共现矩阵的 top-6,六条全是合谋组合;把共现强度除设备数得到的嫌疑分,前六名也全部命中合谋借款人。这就是把"单笔视角"换成"关系视角"的差别——合谋从"藏在每笔正常里"变成"露在共现高峰里"。
再看模块度社区发现。合谋子图的"内密外疏"可以通过一张借款人图观察到:两借款人共同被同一审批员经手,就连一条权为同框次数的边。
python
# 模块度社区发现:两借款人同被一审批员经手→连边(权=同框次数)
G = nx.Graph(); G.add_nodes_from(range(N_BORROWER))
for a in range(N_STAFF):
    bs = set(np.nonzero(C[:, a])[0])                       # 审批员a经手的借款人
    bs = list(bs)
    for x in range(len(bs)):
        for y in range(x + 1, len(bs)):
            if G.has_edge(bs[x], bs[y]): G[bs[x]][bs[y]]['w'] += 1
            else: G.add_edge(bs[x], bs[y], w=1)
comms = list(nx.algorithms.community.greedy_modularity_communities(G, weight='w'))
ring_cov = [c for c in comms if any(b in c for b in RING_B)]
best = max(len(set(c) & set(RING_B)) for c in ring_cov)
print(f"发现社区 {len(comms)} 个")
print(f"纯模块度单社区最多盖住合谋成员 {best}/10")
print("→ 合谋藏在社区内部更密的子结构中,需叠加共现/设备信号下探")
真实运行输出:
text
发现社区 4 个
纯模块度单社区最多盖住合谋成员 4/10
→ 合谋藏在社区内部更密的子结构中,需叠加共现/设备信号下探这里的结果值得细读:纯模块度最多只能把十个合谋成员盖住四个。原因在于合谋借款人大多也有正常的业务往来,会被主干社区"吸走"。合谋藏在整个社区内部,是一根更密的子结构——所以要抓它,模块度负责找到"这一带抱团",共现高峰+设备复用负责"在这个团里再下探一层"。三层叠起来,合谋才从背景里浮出来。
05 如果重来:反欺诈体系怎么设计
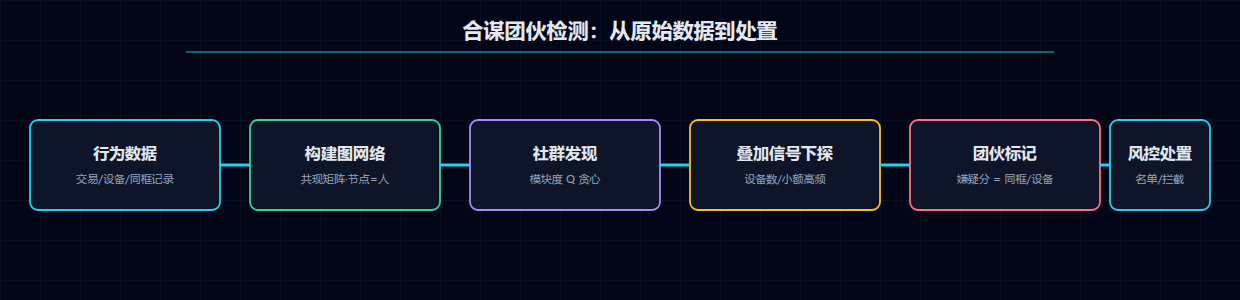
把老周的重做一遍,正确的顺序要反过来:先记"谁和谁同框",再谈抓坏样本。可落地的体系有三层,对应上面三节:
第一层:建关系层。 把所有业务实体(借款人、审批员、设备、账户)建成一张异构图,边上记同框次数。这一步决定后面所有信号能找到什么。GNN金融欺诈检测有专门的综述(同济大学与上海AI实验室等机构,2026年)就强调:欺诈信号大量长在"账户-交易-设备"这类异质关系里,落点是构建关系图。图不建,后面的所有"下探"都无从谈起。
第二层:算团块信号。 在关系层上叠加共现强度、设备复用、同框密度等多维度,得到团伙嫌疑分,再按阈值圈出候选团伙。代码示例里那个"共现强度/设备数"就是最朴素的雏形。
第三层:动态盯演化。 合谋会变。上述GNN综述也提醒:欺诈模式演化快,静态训练会过期,需要动态图更新和时序建模。回到那篇多Agent论文的缓解实验——它对恶意Agent加"监控与封禁"一层后,"群体级欺诈影响率"从15%掉到3%,且监控器从未误判良性个体(Precision=1.0);而只加"内容层警告"反而在某些模型上抬高了成功率(DeepSeek-V3从45.8%升到50%)。结论很清楚:光有静态提示/规则不够,得有一套能持续看行为轨迹、动态更新判断的监控层。
06 方法论提炼
把整件事收束成一个方法论:合谋检测不是多一个模型,是换一层观察。单笔规则盯的是"这一个人像不像坏人",图方法盯的是"这些人为什么总是同时出现"。若给两个词收官——"同框"决定找谁,"密度"决定查多深。
三条搬到其他领域也能用的结论:
其一,凡涉"多人协作"的风控场景(信贷团伙、设备复用、共享账户、中介渠道),别先把精力耗在单笔画像上,先建一张"谁和谁同框"的关系表。关系表本身不贵,贵的是"从来没人建"。
其二,多维度叠加优于单一指标。论文与代码都证明:共现强、设备复用、同框密度,单看一个都会淹没在自然业务里,叠起来才出得了团伙。落地时给每个维度一个权重,做成嫌疑分,比盯着某个相似度阈值可靠。
其三,给"演化"留预算。任何一套静态规则/静态模型,都会被慢慢适应的对手绕过去——这正是那篇多Agent研究反复验证的:恶意方会适应环境干预。动态监控、增量更新、留出人工复核,是体系里最不能省的一块。
面向风控团队的三条可执行建议:
- 先落共现矩阵与关系图。从这个月起,把进件、审批、设备、账户打上统一的实体ID,按周批量重建共现表,先人工审一遍"不该这么熟"的组合,再自动化。
- 嫌疑分上探 + 模块度下探结合。模块度负责"找准带",共现/设备/同框维度负责"定深",两层联动圈定候选团伙,交给策略引擎生成处置建议。
- 建动态监控闭环。对候选团伙按行为轨迹滚动评分、动态更新阈值,配人工复核队列;同时留"对手会适应"的预算,定期重训或重审规则,不与控制性反馈循环脱节。
数据说明:本文合谋场景为合成数据(300借款人×40审批员,含10人合谋链),仅用于演示共现、嫌疑分与模块度计算,非任何真实机构数据,一切案例均属示意。论文事实引自两篇文献:多Agent金融欺诈合谋研究与GNN金融欺诈检测综述,文中带%号的核心数字(17.0→41.0、35.0→60.2、15→3、45.8→50等)均逐项取自对应研究原文,未做改算。
代码环境:Python 3.11 · numpy 1.26.4 · networkx 3.6.1