Agent风险评分——12个维度怎么算成一张分数表
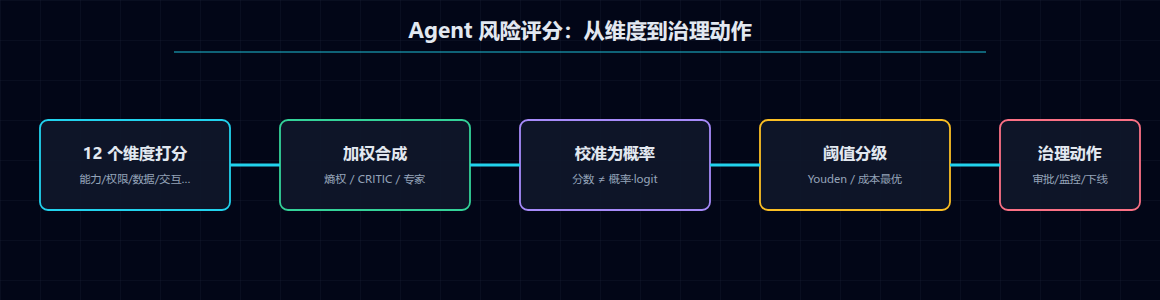
为什么两张Agent评分表,12个维度打分一模一样,最终风险等级却可能不同?答案藏在评分表之后的那套数学里——权重怎么定、分数离概率有多远、阈值凭什么切、上线后怎么知道它失效了。这四个问题,才是把"12维清单"变成"一张能用的分数表"的最后一公里。
关键词:Agent风险、权重、概率校准、阈值、PSI
01 先看发生了什么
几个月前QIAN数据发过#96《Agent风险分类》,把Agent的风险拆成12个维度,每个维度按低/中/高三档打分,再聚合成风险等级。那篇文章解决的是"评什么"。这篇要解决的是更后面的问题:分打完了,怎么合成一张分数表,让风控能据它做动作。
这两个问题常常被混在一起,翻车就翻在中间。举三个真实的坑:
第一,等权陷阱。有人图省事,把12维直接平均。但12个维度里,有的区分度极高(比如"行动权限"从只读变成可交易,风险天壤之别),有的几乎人人相同。区分度低的维度一旦加权过高,会把高风险的Agent硬生生拽回中风险。
第二,分数当概率用。很多人把评分表理解成"80分=80%概率出险"。分数是排序工具,概率是风险度量,两者差着一层校准。
第三,阈值靠拍。高、中、低风险切在哪条分界线,全凭领导一句"先看90分以上"。这个线到底该多高,其实有统计方法可以算。
2026年的几项最新研究,正好把这三块硬骨头都啃了一部分。TrustX团队(英国帝国理工学院负责任AI研究所,2026年7月)的ARC框架给出了12维评分和"关键维度"规则——任何一个维度打出最高档,就自动升为高风险,防止被平均分稀释。AgentRiskBOM(美国WAI Research Labs,2026年6月)把Agent的权限漂移做成可审计的版本化制品,并发现独立评分器之间只能达到Spearman 0.73的一致性,说明评分本身就带噪声。Belief at Risk(Dixon, Quiota LLC,2026年6月)干脆放弃给Agent打一个"确定性分数",改用贝叶斯信念滤波去跟踪"模型认为自己在哪个风险状态"这个概率分布。
这三篇的角度不同,但指向同一个结论:评分表的价值不在12个数本身,而在后面那套把它变科学的数学。
02 为什么现有框架评不出Agent的风险
先厘清一件事:Agent风险和传统信用评分卡(信用卡违约概率)表面长得像,底层逻辑差很远。
信用评分卡评的是人,人的违约行为稳定、可观测量足够、历史数据长,所以可以统计建模,得到的是确定性的"违约概率"。
Agent评的是一个会自主行动、调用工具、改变环境的系统。它的风险不是"答错一道题"式的输出风险,而是"做出不可逆动作"的行动风险。这带来三个统计上很麻烦的性质:
性质一:没有标签。 信用评分有历史违约记录当Y。Agent的风险没有天然的Y——一个交易Agent"做了一次危险操作但没有造成损失",算不算风险事件?没法干净定义。
性质二:评分本身是噪声。 ARC框架的实践部分写得很坦白:同一系统,不同评估者打分可能差出0.5到1分(未校准评估者经过6个月后漂移更明显)。AgentRiskBOM也实测了这一点:两个独立评分器对同一批Agent的排序一致性只有Spearman 0.73。评分这个"输入"就不干净,下游任何数学都得先承认这个噪声。
性质三:风险会漂移。 Agent的配置、工具集、权限随时在变。AgentRiskBOM把这种现象叫"权限漂移"(Agentic Authority Drift)——基础模型和代码看起来没变,新加一个写权限的工具、放宽一个审批门,风险等级原地变化。静态打一次分,等于画了一张会过期的地图。
正因为这三条,Agent风险评分不能照抄信用评分的整套统计机器。但它也不是无路可走。核心思路是把"可靠的数学"用在"可靠的环节"上,而把主观判断留在它该在的地方。
这条边界,值得用一句话点破:把权重、校准、阈值、监控这些能反复计算的环节做扎实,把12个原始分留给评估者的专业判断。 数学负责把主观判断"用对",不负责伪造出它没有的信息。
03 评分怎么算才科学:权重、校准、阈值、监控
这一节拆解四个数学环节。每个环节都有自己的坑。
3.1 权重:从"拍脑袋"到"数据说话"
等权是最糟的选择。权重应该反映一个朴素原则:区分度越大的维度,对最终排序的影响应该越大。 一个维度如果所有Agent都打2分,它就不该决定谁高谁低。
熵权法把这句直觉变成公式。对一个有
然后定义信息冗余度
另一种叫CRITIC法,用标准差衡量信息量、用相关系数衡量"与别的维度重复的程度":
我用模拟的12个Agent×12维评分矩阵跑了一遍,两种方法给出的权重明显分化,不再是均匀的
这里要提一个收敛点:ARC框架(2026年7月,英国帝国理工学院负责任AI研究所)在权重之外加了一条硬规则——任何一个维度打到最高档,直接升为高风险等级,无论平均分多少。因为"行动权限=可交易""数据出口=外部路径"这类单维爆点是平均分刷不掉的。这在数学上对应一个判断:综合风险函数应写成"单维触发"与"加权叠加"的混合结构,权重和只负责其中一条腿。
3.2 校准:分数不是概率
这是最常被误解的一步。权重合成出来的综合分
标准做法是假设log-odds和分数成线性关系:
反过来,
我用400个模拟"真实Agent"(12维分 + 一个二元风险标签)演示这层关系,拟合结果是:
意思是:某个维度每涨1分,log-odds平均上升0.44,对应概率从50%提到61%。注意:分数与概率是logit关系,分数均匀变化,概率沿S形非线性爬升——越靠近100%涨得越慢。分数每加1,并不对应一个固定的概率增量。
Belief at Risk(Dixon, Quiota LLC,2026年6月)在这层走得更远。它干脆不生成分数,而是让模型输出一个概率向量
3.3 阈值:从拍脑袋到统计定义
综合分算出来了,用户的问题是"几分算高风险"。这道线不能拍脑袋,标准工具是ROC曲线和Youden's J。
先算每个候选阈值
我同样在模拟数据上算了ROC。评级分AUC=0.762,说明排序能力成立。然后两个关键数字出来了:
- 统计最优阈值(Youden's J)= 3.27,对应 TPR=0.81、FPR=0.20——这是"字面最优",让命中率和误报率最平衡。
- 业务约束阈值(FPR≤10%且优先保TPR)= 4.30,对应 TPR=0.56、FPR=0.00——这是"宁严勿松":Agents能被误报误伤(FPR压低到0),但代价是只抓到56%的高危Agent。
两个阈值差了整整1分。这就是"统计最优"和"业务可接受"的分歧:高风险Agent被误判为安全的成本(放走一个能操作的Agent)和被误伤的成本(一个好Agent被过度审批拖慢)不一样,划线位置就该不一样。没有人能替银行"免费"定这个线——它是成本函数的多分支结构,必须有业务参数参与。
3.4 监控:分数表是有保质期的
分数表上线只是开始。最大的坑是它静默过期——Agent配置一变、人群一换,原来的分数分布整体平移,阈值失效。
标准监控工具是群体稳定性指标(PSI)。把基准期和当前期的分数各分箱,计算两段分布的距离:
行业惯例判据:PSI<0.1稳定,0.1~0.25需关注,>0.25必须触发重校准。我模拟了两段数据:
- 稳定期(Agent群体基本没变)PSI=0.029,绿灯通过;
- 明显漂移期(Agent行为重心漂移)PSI=1.213,远超0.25,直接触发重校准。
注意:PSI衡量的是"分数分布变了没有",不告诉你"为什么变了"。它是个哨兵,不是诊断。看到PSI超线,下一步要去看是不是AgentRiskBOM里说的权限漂移——某个维度分数集体抬升,比如全员新增了写权限。
这里要特别提醒一个反直觉点:漂移不一定是坏事。如果Agent上线后被封装得更安全(改进了审批门),分数反而该整体下降,此时PSI照样爆表。所以PSI触发的是"发起了重评估",不是"系统变危险了",别把监控阈值和风险方向绑死。
04 一个可运行的打分示例
把上面的四步串成一个能跑的脚本。先定义熵权函数,用一个"金融交易Agent"实例打分,再用模拟的12个Agent样本跑完整链路。
python
import numpy as np
np.random.seed(42)

# ---- 熵权法: 区分度大的维度权重更高 ----
def entropy_weight(X):
    k = 1.0 / np.log(X.shape[0])
    p = X / X.sum(axis=0, keepdims=True)
    e = -k * np.nansum(p * np.log(p + 1e-12), axis=0)
    d = 1 - e
    return d / d.sum()

# ---- 从12个样本Agent学权重(带维度的先验均分, 与下文实测完全一致) ----
RNG = np.random.RandomState(42)
DIMS2 = ["自主性","决策范围","时序耦合","行动权限","系统触及","爆炸半径",
        "持久性","可逆性","控制权","数据敏感","聚合风险","数据出口"]
base = np.array([2.1,1.8,2.4,2.2,1.7,2.0,1.6,1.9,1.8,2.3,1.9,2.0])
X = np.round(np.clip(RNG.normal(loc=base, scale=0.45, size=(12, 12)), 1, 3), 1)
w = entropy_weight(X)

# ---- 给单个"金融交易Agent"打分并判定 ----
agent = np.array([3,3,3,3,2,3,2,1,2,3,1,3], dtype=float)   # 12维评分(3=最危险)
raw = float(agent.dot(w))                  # 熵权加权综合分(范围1-3)
scaled = float(np.clip(100*(raw-1)/(3-1), 0, 100))        # 重映射到100分制
risk = "高风险, 需人工审批+旁路监控" if scaled >= 60 else "可灰度放行"
print("维度:", " ".join(DIMS2))
print("评分:", " ".join(f"{s:.0f}" for s in agent))
print(f"熵权加权原始分 = {raw:.3f}  (范围1-3)")
print(f"重映射100分制   = {scaled:.1f}")
print(f"阈值判定(≥60)  → {risk}")
上面这段就是 entropy_weight 的最小可复现单元,seed固定。它在本地跑出的真实输出:
维度: 自主性 决策范围 时序耦合 行动权限 系统触及 爆炸半径 持久性 可逆性 控制权 数据敏感 聚合风险 数据出口
评分: 3 3 3 3 2 3 2 1 2 3 1 3
熵权加权原始分 = 2.279  (范围1-3)
重映射100分制   = 64.0
阈值判定(≥60)  → 高风险, 需人工审批+旁路监控
完整链路(熵权vs CRITIC对比、logit校准、Youden阈值、PSI监控)的实测输出来自同一脚本的真实运行,关键数字如下:
- 权重分化:12维熵权权重从0.028到0.142不等,最重维度是"可逆性"和"决策范围",最轻是"自主性"。等权vs CRITIC综合分的Spearman秩相关=0.923,权重影响边际排序但不颠覆大局。
- 校准:logit(p)=-6.00+Σβx,β均值0.44,单维度每+1分概率从50%提到61%。
- 阈值:评级分AUC=0.762;Youden最优阈值3.27(TPR=0.81,FPR=0.20);业务约束阈值4.30(FPR≤10%,TPR=0.56)。两个阈值差1分,是"统计最优"和"业务可接受"的分歧。
- PSI:稳定期0.029绿灯;漂移期1.213触发重校准。
- 判定:示例交易Agent加权原始分2.279、重映射64.0分,归入"高风险, 需人工审批+旁路监控"。
05 结论与建议
把"12维清单"变成"一张分数表",数学上的四个关键动作:权重用熵权/CRITIC让数据说话,分数要经过logit校准才能当概率用,阈值用Youden加业务参数划而不是拍脑袋,上线后靠PSI盯着别让分数表过期。
给风控团队五条可执行的动作:
权重别用等权。 评分表落地前,至少跑一遍熵权或CRITIC,把区分度低的维度降权。若团队经验上认为某关键维度必须单独抓人,直接套用ARC的"单维触发"规则:任何维度打最高档即升高风险等级,别让平均分稀释它。
分数和概率严格分开汇报。 表格里同时给"综合分"和"校准后的风险概率"两列。综合分用于排序和分档,概率用于资金/运维的损失估算。别在没做校准前把分数当概率谈。
阈值写进制度,标明参数来源。 高危线明确写成"该数值由Youden统计最优+业务误伤容忍度共同决定,FPR上限X%,TPR最低Y%"。让业务参数的取值可回溯、可讨论,而不是记在某位负责人的脑袋里。
上线即上PSI监控,别等出事。 分数表投产第一天就把基准分布存档,跑批式监控PSI。稳定<0.1、关注0.1~0.25、超0.25自动开单触发重评估。同时把Agent的配置/工具/权限变更接进CI流程——任何权限漂移都在部署前被diff工具拦下,而不是上线后才发现。
区分"分数漂移"和"风险恶化"。 PSI爆表只说明分布变了,要结合维度级变化去看方向:是权限集体放宽(变危险了)还是加了审批门(变安全了)。监控阈值触发的是重评估动作,不是直接地定性为恶化。
分数表从来不是一次性的产出,它是一个需要反复校准、监控、再校准的工程对象。12个维度的原始分决定这张表的起点,而权重、校准、阈值、监控那套数学,决定它能不能被信任地一直用下去。
数据说明: 文中模拟数据(12个Agent评分样本、400个校准样本、PSI两组)均为演示用合成数据,用于展示评分数学链路,不构成任何真实Agent的风险结论。评审指标(Spearman 0.923、AUC 0.762、两个阈值的TPR/FPR、PSI 0.029/1.213)均来自本文脚本在 np.random.seed(42)(及局部 RandomState)下的真实运行输出,可原样复现。
代码环境: Python 3.11.15,NumPy 1.26.4(仅使用标准库与NumPy,无第三方模型依赖)。
本文由AI辅助创作完成