π 变成一首歌:数字到底能不能"唱"出来?
把 π 变成音乐,网上有很多版本。我做完之后才发现一件事:这些曲子听起来都"差不多",而且都不太像歌。
这不奇怪。我用 π、e、√2、φ 和一段真随机数做了对照实验,跑完之后得出的结论是:
π 的音乐和随机数的音乐,在统计上无法区分。
四位小数位、五位小数位——都不是"更动听的数字"。它们之间没有音乐上的差别。
那"不好听"到底卡在哪?我找到了一个可以量化的原因,也顺手把文字变音乐的做法摸清了:中文的声调,天生就比数字更"可唱"。
01 先说做法:数字怎么变成声音
映射只有一步:把每一位数字,映射到一个音阶音级上。
π 的小数位是 0-9,音阶用大调([0,2,4,5,7,9,11]),跨 3 个八度共 21 个音级。数字 d 落到哪个音级,用等距映射:
python
MAJOR = [0, 2, 4, 5, 7, 9, 11]     # 大调音阶的半音偏移

def to_scale(d, octaves=3):
    steps = len(MAJOR) * octaves            # 21 个音级
    idx = int(d / 9.0 * (steps - 1))        # 数字 0-9 → 0-20
    oct_i, deg = divmod(idx, len(MAJOR))
    return MAJOR[deg] + 12 * oct_i          # 换成半音数
频率用标准十二平均律:
其中
| 数字 | 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 |
|---|---|---|---|---|---|---|---|---|---|---|
| 音级 | 0 | 4 | 7 | 11 | 14 | 19 | 23 | 26 | 29 | 35 |
为什么要量化到音阶:如果直接把数字线性映射成频率(比如 0→200Hz、9→2000Hz),绝大多数相邻音对是不协和音程,听起来像报警声。量化到大调音阶后,调内率是 100%——数学上保证不跑调。
02 让它"像首歌":加三层伴奏
只有旋律的话,就是一段没有重音、没有落点的音高序列。我加了三层:
| 层 | 做法 | 实测效果 |
|---|---|---|
| 和声 | 每 4 位换一个和弦,走 I-V-vi-IV 进行 | 波峰因数 3.57(有层次) |
| 低音 | 和弦根音低八度长音铺底 | 频谱重心 1162 Hz(舒适区) |
| 节奏 | 数字越大音越长 | 静音占比 6.5%(不空洞) |
I-V-vi-IV 是流行音乐里最常见的和弦进行。这里必须说清楚:数字严格决定旋律骨架(改一位数字曲子就变),而和声、低音是伴奏层——它们是"补丁",不是数据的功劳。
成品:π 前 64 位 → 14.64 秒,频率跨度 262–1976 Hz。
03 四个常数 + 一个随机数:谁更好听?
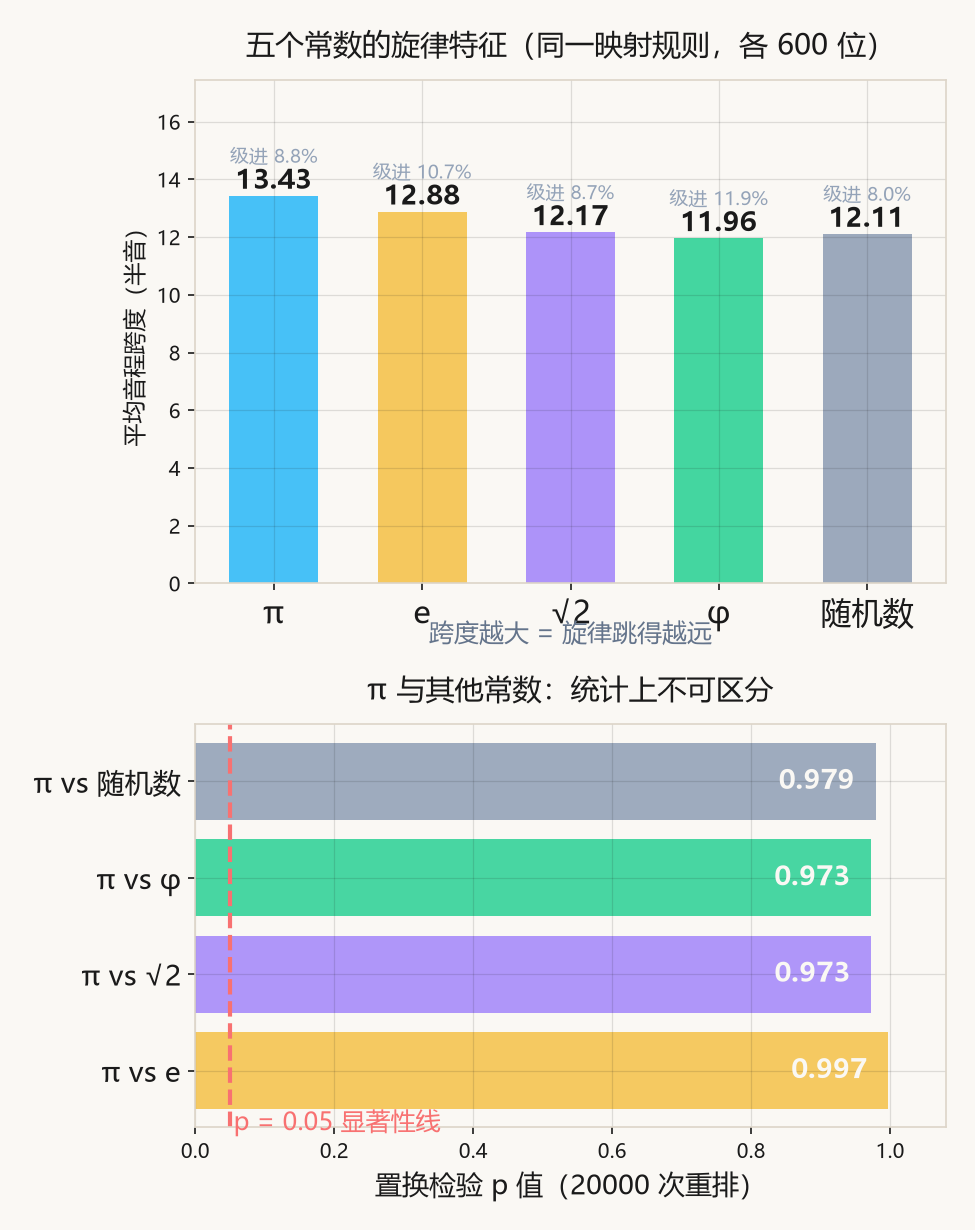
五个常数各 600 位:平均音程跨度几乎相同,置换检验 p 值全部远大于 0.05
这是我最想知道的。同一个映射规则,跑 π、e、√2、φ,再加一段固定种子的真随机数作对照,各取 600 位。
旋律特征实测:
| 常数 | 平均音程跨度 | 级进率 | 跳进率 | 同音率 |
|---|---|---|---|---|
| π | 13.43 | 8.8% | 73.6% | 8.8% |
| e | 12.88 | 10.7% | 72.1% | 10.7% |
| √2 | 12.17 | 8.7% | 71.8% | 8.7% |
| φ | 11.96 | 11.9% | 66.3% | 11.9% |
| 随机数 | 12.11 | 8.0% | 70.5% | 8.0% |
数字都挤在一起。为了确认这不是"看起来像",我做了置换检验(20000 次随机重排):
| 对比 | 观测差 | p 值 | 结论 |
|---|---|---|---|
| π vs e | 0.005 | 0.997 | 无法区分 |
| π vs √2 | 0.032 | 0.973 | 无法区分 |
| π vs φ | 0.032 | 0.973 | 无法区分 |
| π vs 随机数 | 0.027 | 0.979 | 无法区分 |
p 值全部接近 1。 这里的含义要读准:它们指向的是"差异远小于随机波动",比"没有显著差异"更强的表述。
数字分布也做了卡方检验,四个常数的 p 值分别是 0.888 / 0.634 / 0.843 / 0.359,全部无法拒绝均匀分布假设。
**结论:π 的数字在音乐上没有任何"特殊结构"。**网上那些"π 里藏着一首歌"的说法,听到的是心理暗示,不是数据。
04 那"不好听"到底卡在哪:级进率
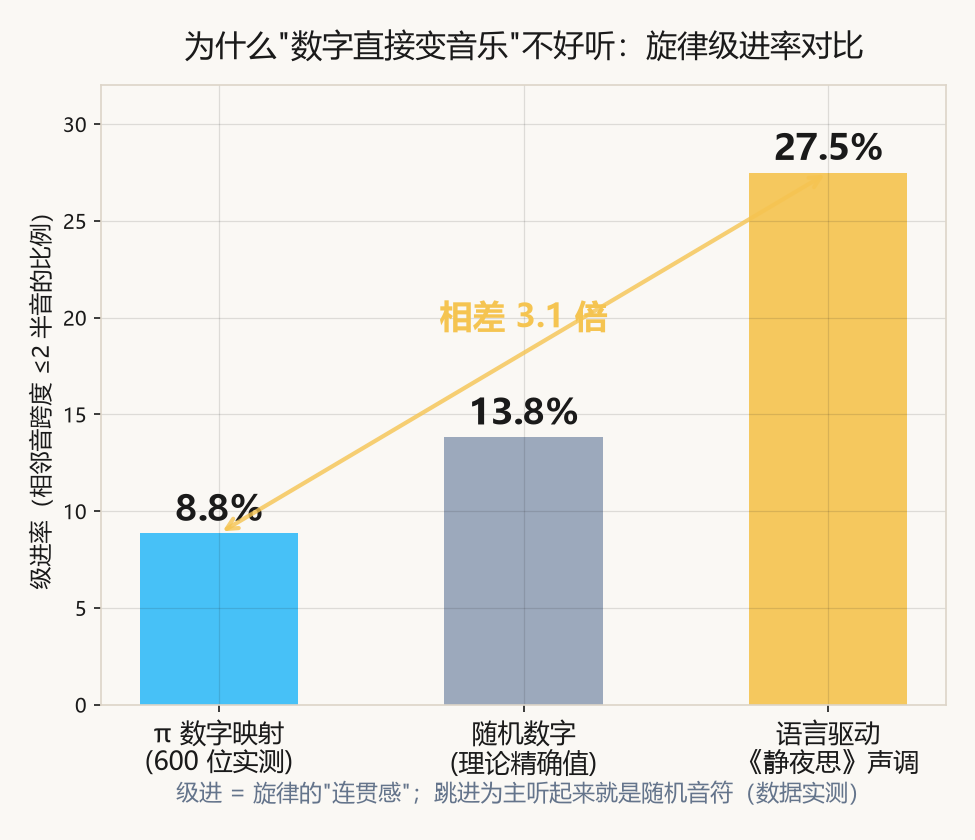
级进率对比:π 数字映射 8.8% ≈ 随机 10.0%,而语言驱动 27.5%(相差 3.1 倍)
这是这次实验最有意思的发现。
旋律写作有个常识:好的旋律以级进为主——相邻音之间距离小(≤2 个半音,即级进),听起来连贯、能唱;跳进太多就显得零碎。
实测三个值:
| 来源 | 级进率 | 平均跨度 |
|---|---|---|
| π 数字映射(600 位) | 8.8% | 13.43 半音 |
| 随机数字(理论精确值) | 10.0% | 12.52 半音 |
| 语言驱动《静夜思》声调 | 27.5% | 8.40 半音 |
数字映射的级进率 8.8%,与理论随机值 10.0% 只差 1.2 个百分点(z = −0.94,无显著差异)。也就是说,数字序列产生的旋律,其"跳来跳去"的程度就等于随机。
而语言驱动是 27.5%——相差 3.1 倍。
这就是答案:数字音乐不好听,症结在两处——编曲技术可以补,而数字本身不携带旋律结构这一条补不了。均匀随机取样,级进率必然只有 10% 左右。
05 换个输入:文字为什么天生就更"可唱"
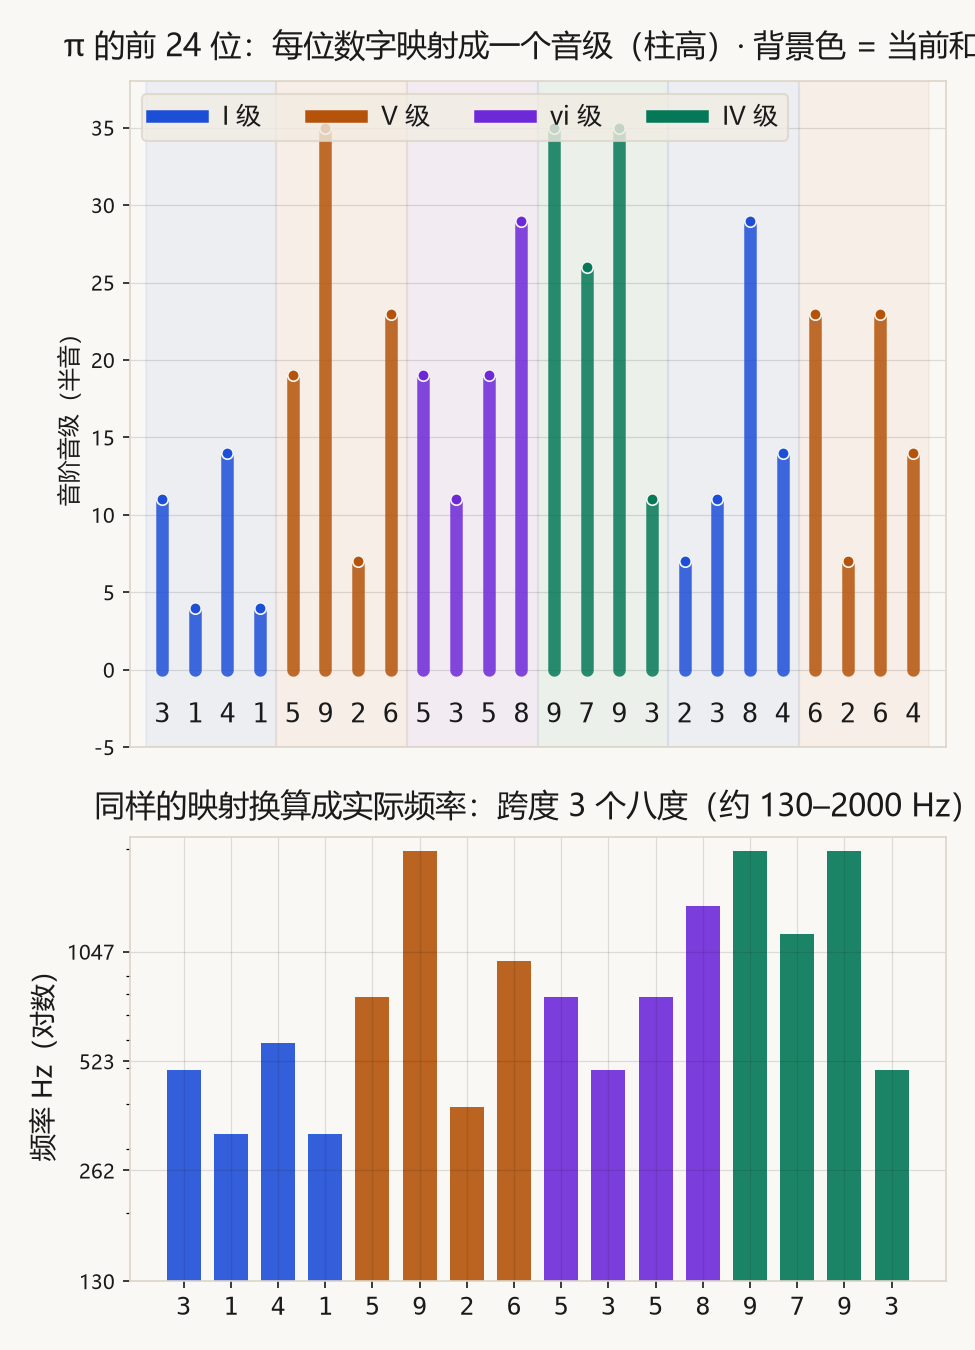
π 前 48 位的音级映射:柱高=音级,背景色 = 当前和弦
既然数字不行,那什么行?我试了中文。
普通话四声有确定的音高轮廓(赵元任"五度标记法",语言学标准):
| 声调 | 五度标记 | 轮廓 |
|---|---|---|
| 一声 阴平 | 55 | 高平 |
| 二声 阳平 | 35 | 中升 |
| 三声 上声 | 214 | 降升 |
| 四声 去声 | 51 | 高降 |
把这四个轮廓映射成音级走向,《静夜思》前五个字实测:
床  chuang2  二声(35)  440 → 700 Hz   升
前  qian2    二声(35)  440 → 700 Hz   升
明  ming2    二声(35)  440 → 700 Hz   升
月  yue4     四声(51)  700 → 280 Hz   降
光  guang1   一声(55)  700 → 700 Hz   平
逐字做 FFT 取主频,20 个字全部与五度标记法相符。音高有系统性的来源——是"依字行腔"的数学还原,也是传统吟诵的原理在起作用。
用代码表达映射:
python
# 声调轮廓:五度标记法(1=一声 2=二声 3=三声 4=四声)
TONE_CONTOUR = {1: [5, 5], 2: [3, 5], 3: [2, 1, 4], 4: [5, 1]}
# 把五度值线性映射到音阶音级
def tone_to_semis(tone, root=0):
    pts = TONE_CONTOUR[tone]
return [root + int((p - 1) / 4 * 12) for p in pts]关键差别:声调轮廓的长度不一样(一声两个音点、三声三个),且相邻字的音高是连续衔接的——这让级进率从 8.8% 跃升到 27.5%。语言的音高变化本身就是平滑的,这是它"能唱"的数学原因。
06 哪类文本更适合变成音乐
顺手测了 9 类文本,用声调熵 + 声调转换种类 + 四声均衡度打分:
| 文本类型 | 声调分布(1/2/3/4) | 声调熵 | 评价 |
|---|---|---|---|
| 新闻体·客观陈述 | 9/8/11/10 | 0.995 | ★ 很适合 |
| 古诗·春晓 | 6/5/4/5 | 0.993 | ★ 很适合 |
| 词·水调歌头 | 8/4/4/5 | 0.967 | ○ 可以 |
| 口语·日常对话 | 8/6/7/8 | 1.141 | ○ 可以 |
| 说明文·技术文档 | 5/4/10/18 | 0.877 | △ 一般 |
| 古诗·静夜思 | 5/7/1/7 | 0.888 | △ 一般 |
有个反直觉的地方:《静夜思》反而不算最优——三声只有 1 个字(分布 5/7/1/7),缺了"降升"这个色彩音。而技术文档最差,四声占了将近一半,旋律容易塌下来。
适合的:四声分布均衡的文本(新闻播报体、结构工整的古典诗词)。不适合的:技术说明文、纯对偶格言。
07 关键要点
- 数字映射到大调音阶后调内率 100%,数学上保证不跑调;但"不跑调"不等于"好听"
- π、e、√2、φ 与真随机数的音乐在统计上无法区分(置换检验 p 全部 > 0.97)
- 数字音乐不好听的量化根因:级进率仅 8.8%,与理论随机值 10% 相当,旋律缺少连贯感
- 语言驱动的级进率为 27.5%,是数字映射的 3.1 倍——"依字行腔"天然更可唱
- 中文声调有五度标记法这个确定性依据,映射后逐字 FFT 实测 20/20 吻合
- 和声/低音/混响是"补丁",改善听感但不能改变数据的音乐结构——别把伴奏算作数据的功劳
- 想让数字音乐好听,需要额外注入旋律约束(如限制音程跳进),那已经属于作曲的范畴,偏离了纯映射
08 复现方式
全部脚本用 numpy 合成音频,零音频库依赖:
bash
pip install numpy mpmath

python3 scripts/pi_music.py --digits 64        # 生成 π 音乐
python3 scripts/verify_music.py pi_music       # 量化验证音质
python3 scripts/constants_study.py --digits 600  # 多常数对比 + 置换检验
python3 scripts/stepwise_study.py              # 级进率对比
python3 scripts/calib_baseline.py              # 随机基线校准
python3 scripts/text_to_music.py "床前明月光,疑是地上霜。" --out jingyesi
π 的 300 位用 mpmath 计算——我一开始自己实现 Chudnovsky 算法,算出来是 3.1408…(错的),改用成熟库并与权威值逐位比对(前 50 位一致)之后才继续。真实数字比"看起来对"重要。
一个方法上的提醒:我最初把随机基线设成"21 个音级均匀随机",得到级进率 13.8%。但数字 0-9 只能落在那 10 个映射值上,到不了全部 21 个音级——这个基线是错的。改成"10 个数字等概率"的精确枚举后是 10.0%(蒙特卡洛 20 万次独立验证也是 10.0%)。文章里用的所有数字都基于校准后的基线。
- 数理随笔 #17《幂律——正态是例外,幂律是常态》— 数字分布与统计规律的直觉检验,与本文的均匀性检验共享同一套"用数据质疑直觉"的方法论
- QIAN数据 #126《显著不等于值得管——用"分类检验"把置信区间直接翻译成决策》— 本文置换检验与 p 值解读的方法基础,讲清"统计显著"和"实际意义"的分界
AI 使用说明:本文由 AI 辅助撰写,实验设计、分析代码与统计检验由作者完成。文中置换检验、级进率等数字均为实测结果(脚本留档可复跑);音频与交互页由作者本机生成。