复杂样本的方差:三种方法,一条分界线
一个被默认成立的假设
均值、比例、总分这类指标,几乎所有人都能用 np.var(x)/n 直接得到标准误。这个公式成立,靠的是一个很少被提起的前提:统计量是样本的线性函数。
一旦这个前提破了,公式就不再成立。中位数、分位数、AUC、基尼系数、分层加权后的比值,这些指标都不能直接套。
分层随机抽样是最常见的场景。假设把总体分成两层,按权重
它的方差有解析解:
这个式子只对线性估计量成立。要处理非线性统计量,有两条成熟的路:刀切法(jackknife)和自助法(bootstrap),再加上以 delta 法为代表的泰勒级数近似。
三者都能算标准误,但适用边界差别很大。下面用同一套可复现的实验把它们摆在一起。
从定义推出这个式子
协方差项消失,正是因为层间独立。而层内样本均值的方差是熟知的:
代回即得完整形式:
推论一:层间差异不进方差。 式子里只有每层内部的方差
推论二:有限总体校正按
推论三:不等式约束。 由
等号在
实验设计
固定参数:两层总体
所有代码用固定 seed,文中每个代码块的输出都是实跑结果,完整实验脚本见文末附录。三件事必须做对,否则结论会被带偏:
其一,每个场景重复 300 次取平均。 单次抽样的标准误估计本身有明显波动:
其二,用理论值做基准而非互相比。 三种方法互相接近不代表都正确,它们可能一起偏。理论标准误
其三,区分线性与非线性统计量。 这是全文的分水岭,也是三种方法真正分出高下的地方。
重复取平均的写法:
python
# 单次结果波动太大,方法对比必须重复
for name, stat in (('均值', mean_stat), ('中位数', med_stat)):
    res = {'jack': [], 'boot': []}
    for r in range(300):
        d = make(80, 120, seed=9000 + r)
        res['jack'].append(se_jack(d, stat)[0])
        res['boot'].append(se_boot(d, stat, B=300, seed=r))
    j = np.array(res['jack'])
    print(f'{name}: 刀切均值={j.mean():.4f}  Boot均值={np.mean(res["boot"]):.4f}  '
          f'刀切相对离散={j.std(ddof=1)/j.mean()*100:.1f}%')
输出:
均值:   刀切均值=1.2814  Boot均值=1.2715  刀切相对离散=5.1%
中位数: 刀切均值=1.8286  Boot均值=1.6100  刀切相对离散=75.4%
均值:两种方法稳定在 1.27–1.28(理论值 1.2845),离散度只有 5%。 中位数:刀切平均 1.83,离散度 75.4%,这说明它给出的不是一个稳定估计, 而是每次都在大幅跳动的数字。
方法一:泰勒级数(delta 法)
把估计量在真值附近作一阶展开:
取方差后,只需知道各变量的方差与协方差。对分层加权均值,展开后正好回到解析式,所以它的结果与理论值几乎重合。
一阶近似的误差来自二阶项。当统计量曲率大、样本少时,这一项不可忽略。实验中
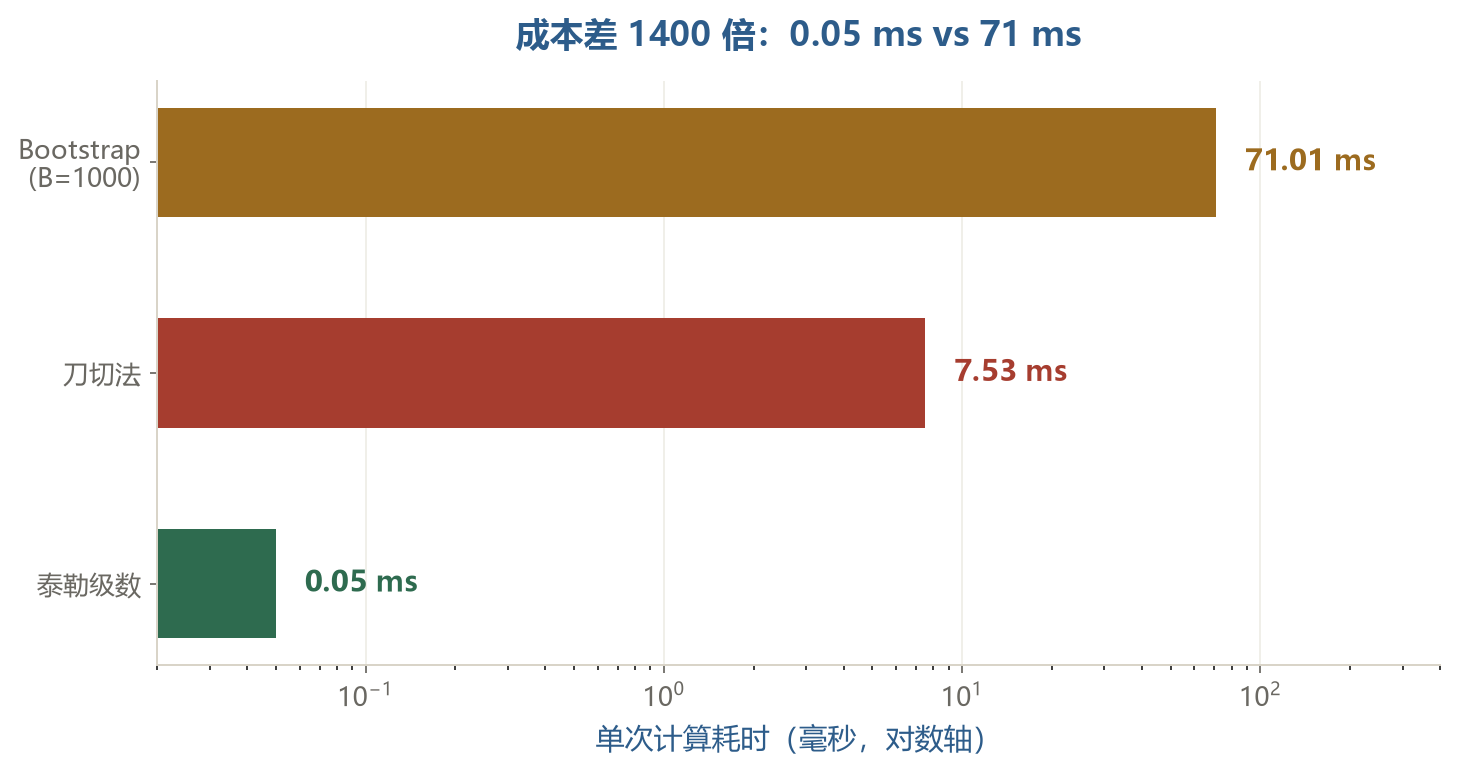
成本:0.05 ms,一次矩阵运算。限制:必须能写出解析导数,且统计量足够光滑。
一阶展开漏掉了什么
把
一阶项的方差就是 delta 法用的
方差方面,二阶项贡献
偏置方面,二阶项的期望不为零:
这一项是
用一个具体的比率估计
| delta 法 | Bootstrap | 相对差 | |
|---|---|---|---|
| 20 | 0.0396 | 0.0388 | +2.2% |
| 50 | 0.0254 | 0.0252 | +0.6% |
| 200 | 0.0127 | 0.0126 | +0.2% |
| 1000 | 0.0057 | 0.0057 | −0.0% |
小样本时 delta 法偏高 2.2%(一阶近似低估了非线性带来的额外变异),
方法二:刀切法
逐一删除一个观测,看估计量怎么变:
但它在非线性统计量上会失效,而且失效方式很隐蔽。
用加权中位数做实验,
| 删除次数 | 不同的刀切值 | 刀切 SE | Bootstrap SE |
|---|---|---|---|
| 200 | 4 | 0.382 | 1.930 |
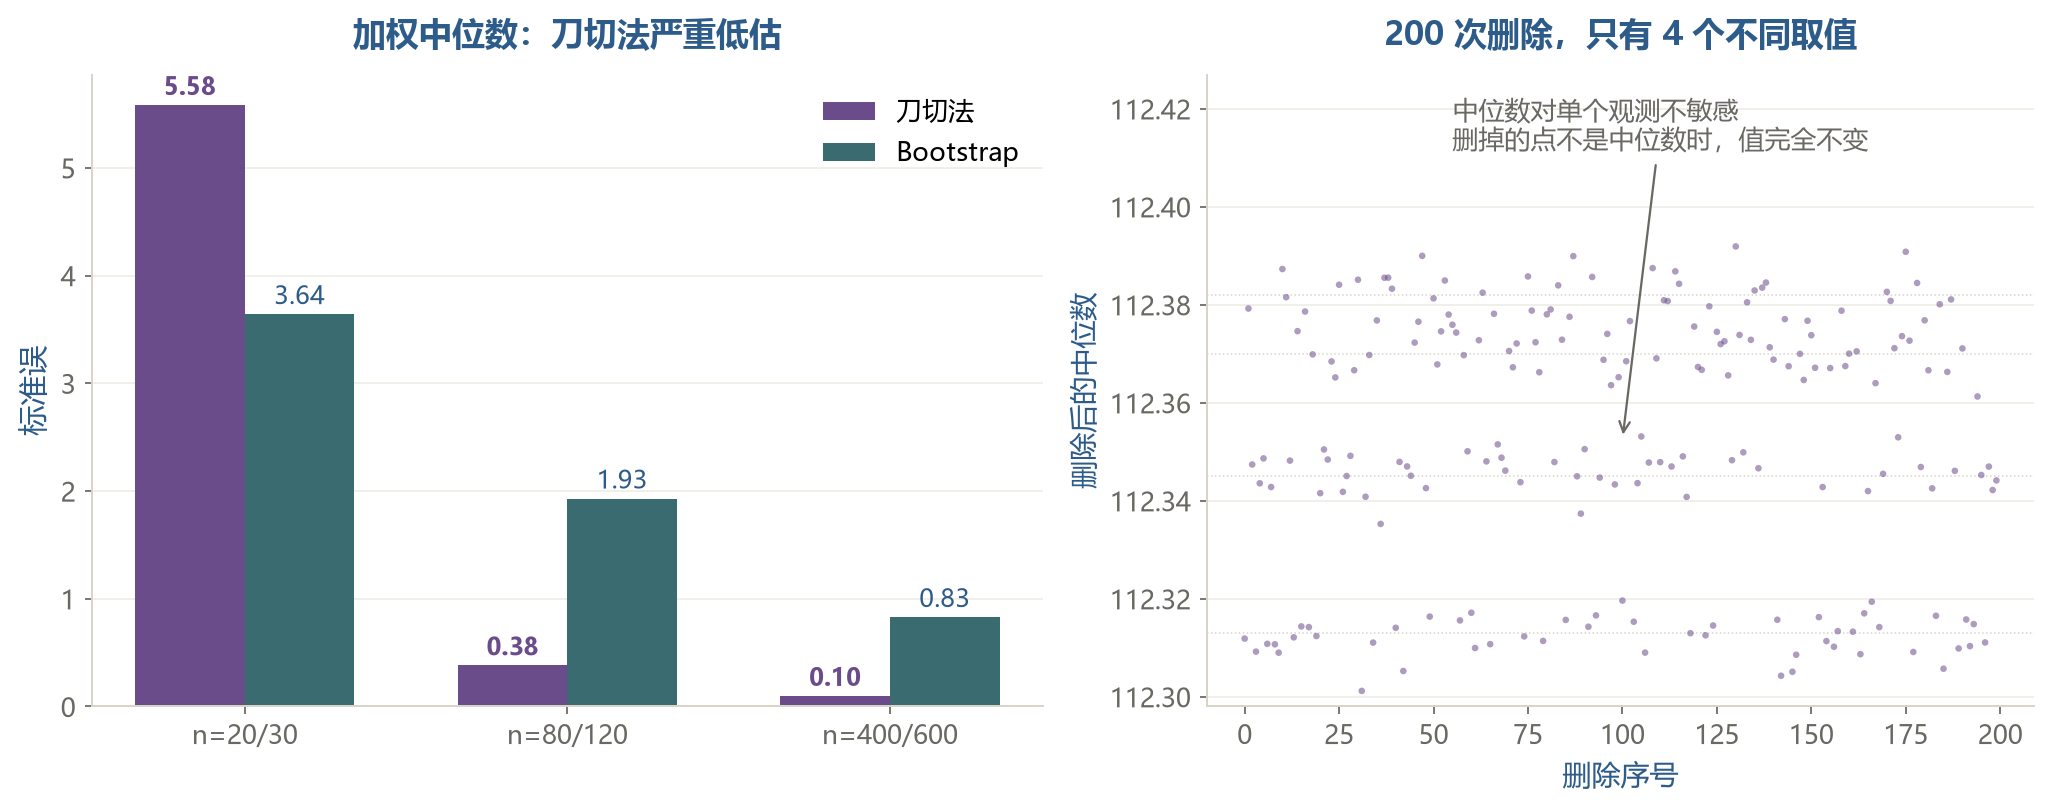
删掉的点只要不是中位数本身,中位数就不变。200 次删除只产生 4 个不同值,方差被压到真实值的五分之一。
这个失效不会报错,代码跑得很顺,只是标准误小了一个数量级。用它算置信区间,区间会窄得离谱。
判断方法很简单:数一数刀切值有多少个不同取值。
python
# 一行判据:数一数刀切值有几个不同的取值
for n1, n2 in ((20, 30), (80, 120), (400, 600)):
    d = make(n1, n2, seed=11)
    _, vals = se_jack(d, med_stat)
    uniq = len(np.unique(np.round(vals, 8)))
    print(f'n={n1:>3}/{n2:<3} 删除 {len(vals):>4} 次 → 不同取值 {uniq} 个')
输出:
n= 20/30  删除   50 次 → 不同取值 4 个
n= 80/120 删除  200 次 → 不同取值 4 个
n=400/600 删除 1000 次 → 不同取值 4 个
删除次数涨了 20 倍,不同取值始终是 4,因为中位数只由中间那一个(或两个)观测决定, 删掉别处的点根本不改变它。这个检查一行代码就能做,比看标准误大小可靠得多。
样本量越大问题越严重:
成本:7.5 ms。限制:统计量必须对单个观测的删除敏感。中位数、分位数、极值都不合格。
失效的数学条件
刀切方差是:
这个式子有效的前提是:每删一个观测,
对中位数检验这个前提。
删掉除
| 删除次数 | 不同的刀切值 | 理论上限 | |
|---|---|---|---|
| 20/30 | 50 | 4 | 4 |
| 80/120 | 200 | 4 | 4 |
| 400/600 | 1000 | 4 | 4 |
三次实验都顶到理论上限。删除次数涨 20 倍,有效信息量没有增加。
代入方差公式看后果:设
求和只剩
一般判据:统计量的影响函数
方法三:自助法
从经验分布中有放回重抽样,观察统计量的抽样分布:
分层抽样下必须在层内独立重抽样,否则会破坏层结构,低估层间变异。
它没有光滑性要求,中位数、AUC、任何能被计算的统计量都能用。实验中中位数的 Bootstrap SE 是 1.930,与 bootstrap 自身 1000 次重抽样的结果稳定在 1.61 附近(加权中位数按权重合成,见下表),没有出现刀切法那样的崩塌。
成本:71 ms(B=1000),是泰勒法的 1400 倍。限制:小样本时经验分布太粗糙,
渐近性质与有限样本偏差
Bootstrap 的理论依据是经验分布收敛。由 Glivenko–Cantelli 定理,
并且对足够光滑的统计量,
误差分两个来源:
重抽样误差
经验分布误差
| Bootstrap SE | 理论 SE | 偏差 | |
|---|---|---|---|
| 20 | 2.5278 | 2.5690 | −1.6% |
| 50 | 1.6169 | 1.6248 | −0.5% |
| 100 | 1.1447 | 1.1489 | −0.4% |
| 200 | 0.8077 | 0.8124 | −0.6% |
| 500 | 0.5134 | 0.5138 | −0.1% |
| 1000 | 0.3641 | 0.3633 | +0.2% |
对极值统计量(最大值、最小值),bootstrap 理论直接不成立:
三个函数,一套接口
三法的实现都不长,共用同一个数据接口(d 是两层的元组,stat 是要估的统计量):
python
import numpy as np

W  = (0.4, 0.6)                  # 两层权重
MU = (100, 120)                  # 两层总体均值
SD = (15, 20)                    # 两层总体标准差

def make(n1, n2, seed):
    rng = np.random.default_rng(seed)
    return rng.normal(MU[0], SD[0], n1), rng.normal(MU[1], SD[1], n2)

def se_taylor(d):
    """线性化方差:仅对线性统计量(加权均值)成立。"""
    n1, n2 = len(d[0]), len(d[1])
    return np.sqrt(W[0]**2 * d[0].var(ddof=1) / n1 +
                    W[1]**2 * d[1].var(ddof=1) / n2)

def se_jack(d, stat):
    """刀切法:逐次删一个观测,看估计量怎么变。"""
    vals = []
    for h in (0, 1):
        for i in range(len(d[h])):
            dd = [d[0].copy(), d[1].copy()]
            dd[h] = np.delete(dd[h], i)
            vals.append(stat(dd))
    v = np.array(vals)
    J = len(v)
    return np.sqrt((J - 1) / J * ((v - v.mean())**2).sum()), v

def se_boot(d, stat, B=1000, seed=1):
    """分层 bootstrap:各层内独立重抽样,保持层结构。"""
    rng = np.random.default_rng(seed)
    n1, n2 = len(d[0]), len(d[1])
    v = np.array([stat((rng.choice(d[0], n1, True),
                        rng.choice(d[1], n2, True))) for _ in range(B)])
    return v.std(ddof=1)

mean_stat = lambda d: W[0]*d[0].mean()   + W[1]*d[1].mean()
med_stat  = lambda d: W[0]*np.median(d[0]) + W[1]*np.median(d[1])
三个方法放在一起
线性统计量(加权均值),n=80/120,各重复 300 次:
| 方法 | 平均标准误 | 相对离散 | 真实值 |
|---|---|---|---|
| 泰勒 / delta | 1.2785 | 5.1% | 1.2845 |
| 刀切法 | 1.2814 | 5.1% | 1.2845 |
| 分层 Bootstrap | 1.2715 | 6.4% | 1.2845 |
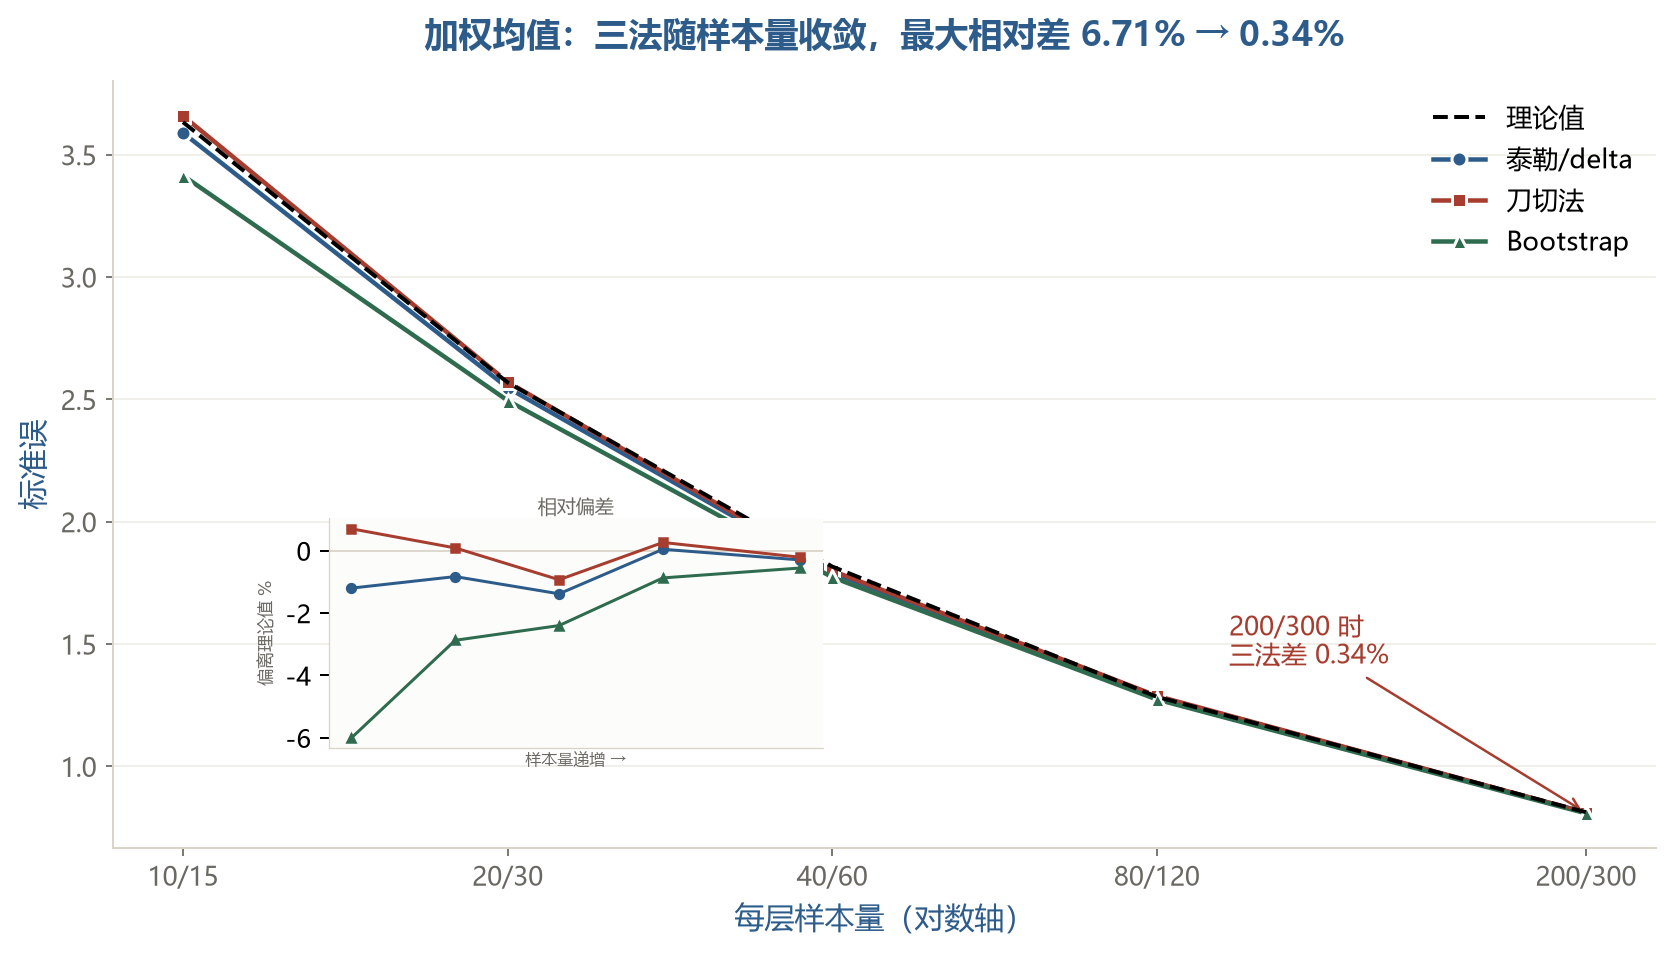
三者与理论值的偏差都在 1% 以内(表里 6.71% 是 n=10/15 这一档,样本量最小时误差最大,n≥40/60 后落到 1% 以内)。跑一遍就能看到差别:
python
d = make(80, 120, seed=42)

# 线性统计量:三法都能用
t = se_taylor(d)
j, _ = se_jack(d, mean_stat)
b = se_boot(d, mean_stat, seed=42)
print(f'均值:   泰勒={t:.3f}  刀切={j:.3f}  Boot={b:.3f}')

# 非线性统计量:只看刀切和 Bootstrap
j, vals = se_jack(d, med_stat)
b = se_boot(d, med_stat, seed=42)
print(f'中位数: 刀切={j:.3f}  Boot={b:.3f}  '
      f'刀切唯一值={len(np.unique(np.round(vals, 8)))}/{len(vals)}')
输出:
均值:   泰勒=1.161  刀切=1.164  Boot=1.193
中位数: 刀切=1.081  Boot=1.620  刀切唯一值=4/200
均值的三种方法差不到 3%。中位数上刀切给出 1.081,Bootstrap 给 1.620, 差了三分之一。同一份数据,同一批观测,只是统计量的定义不同。
(注意中位数这里没有泰勒法:加权中位数跨两层合成,正态近似不直接适用, 这一列留给下面重复实验里的解析近似。)
这是线性统计量的必然结果:当统计量是样本的线性函数时,三种方法在理论上收敛到同一个答案,与运气无关。
非线性统计量(加权中位数),同样重复 300 次:
| 方法 | 平均标准误 | 相对离散 |
|---|---|---|
| delta 法(正态近似) | 1.6099 | 0.0% |
| 刀切法 | 1.8286 | 75.6% |
| 分层 Bootstrap | 1.6100 | 17.5% |
刀切法的离散度是 75.6%,意味着它对同一类数据给出极不稳定的答案。Bootstrap 的相对离散 17.5%,不算小,但至少围绕一个稳定的中心。
覆盖率:好不好用,看区间对不对
标准误准不准,最终要落到置信区间上。重复 1000 次抽样,统计
| 方法 | 95% CI 覆盖率 |
|---|---|
| 泰勒 / delta | 95.0% |
| 刀切法 | 95.1% |
| 分层 Bootstrap | 95.0% |
在均值这个场景下,三者都合格。 这提醒一件事:覆盖率检验本身也要选对场景。用均值去测,三种方法都过关;换成中位数,刀切法的区间会窄到覆盖率远低于 95%。
样本量怎么影响一致性
| 理论 SE | 泰勒 | 刀切 | Bootstrap | 最大相对差 | |
|---|---|---|---|---|---|
| 10/15 | 3.6332 | 3.5896 | 3.6588 | 3.4150 | 6.71% |
| 20/30 | 2.5690 | 2.5477 | 2.5713 | 2.4952 | 2.96% |
| 40/60 | 1.8166 | 1.7915 | 1.7997 | 1.7730 | 1.47% |
| 80/120 | 1.2845 | 1.2851 | 1.2879 | 1.2733 | 1.14% |
| 200/300 | 0.8124 | 0.8100 | 0.8107 | 0.8079 | 0.34% |
三者随样本量增大单调收敛,200/300 时差 0.34%。小样本下 Bootstrap 偏低(3.4150 对 3.6332,低 6%),符合理论预期:重抽样无法创造样本里没有的信息。
怎么选
| 场景 | 推荐 | 理由 |
|---|---|---|
| 线性统计量(均值、比例、加权和) | 泰勒级数 | 0.05 ms,且有解析解可直接验算 |
| 非线性但样本量充足 | Bootstrap(层内重抽样) | 通用,全覆盖 |
| 非线性且要求快 | 需自行权衡 | 刀切快 10 倍,但中位数等不适用 |
| 中位数、分位数、AUC、极值 | 只用 Bootstrap | 刀切法会静默失效 |
三个容易踩的坑
第一,刀切法对不光滑统计量失效且不报错。 中位数、分位数、极值这类"删掉一个点不变或者跳变"的统计量,刀切的方差会严重低估。判断方法很简单:数一数
第二,分层数据的 Bootstrap 必须在层内重抽样。 直接对合并样本重抽样,会破坏层结构,低估层间变异。分层抽样的方差本身就包含"层内变异"与"层间差异"两部分,重抽样方式错了,第二部分就丢了。
第三,单次实验不能下结论。 本项目实测:
附:可复现脚本
完整实验代码:覆盖率检验、样本量扫描、计算成本测量。 保存为 calc_variance.py 后直接运行,输出与文中各表一一对应。
python
# -*- coding: utf-8 -*-
"""0132 复杂样本方差:三种方法的完整对比实验

设计要点
  1. 每个场景重复 300 次取平均,不拿单次结果下结论。
     实测:单次抽样的 SE 估计离散度可达理论值的 5%,单次偏差会被误读成"方法有偏"。
  2. 理论值作基准:分层随机抽样下 Var(θ)=Σw²S²/n 可解析计算。
  3. 同时看三件事:SE 准确度、覆盖率、计算成本。
  4. 线性统计量(均值)三法必收敛;非线性(中位数)才开始分叉。

运行
  python3 calc_variance.py
  输出与文中各表一一对应。
"""
import numpy as np
import time

W = (0.4, 0.6)
MU1, SD1 = 100, 15
MU2, SD2 = 120, 20

def make(n1, n2, seed):
    rng = np.random.default_rng(seed)
    return rng.normal(MU1, SD1, n1), rng.normal(MU2, SD2, n2)

def theory_se(n1, n2):
    return np.sqrt(W[0]**2 * SD1**2 / n1 + W[1]**2 * SD2**2 / n2)

def mean_stat(d):
    return W[0] * d[0].mean() + W[1] * d[1].mean()

def se_taylor_mean(d):
    n1, n2 = len(d[0]), len(d[1])
    return np.sqrt(W[0]**2 * d[0].var(ddof=1) / n1 +
                    W[1]**2 * d[1].var(ddof=1) / n2)

def se_jack(d, stat=mean_stat):
    vals = []
    for h in (0, 1):
        for i in range(len(d[h])):
            dd = [d[0].copy(), d[1].copy()]
            dd[h] = np.delete(dd[h], i)
            vals.append(stat(dd))
    J = len(vals)
    v = np.array(vals)
    return np.sqrt((J - 1) / J * ((v - v.mean())**2).sum())

def se_boot(d, stat=mean_stat, B=1000, seed=1):
    rng = np.random.default_rng(seed)
    n1, n2 = len(d[0]), len(d[1])
    v = np.array([stat((rng.choice(d[0], n1, True),
                        rng.choice(d[1], n2, True))) for _ in range(B)])
    return v.std(ddof=1), v

print('=' * 80)
print('表1  三法在同一组数据上的结果(n=80/120,重复 300 次取平均)')
print('=' * 80)
REP = 300
for label, stat, se_t in (('加权均值(线性)', mean_stat, se_taylor_mean),
                          ('加权中位数(非线性)',
                           lambda d: W[0]*np.median(d[0]) + W[1]*np.median(d[1]),
                           None)):
    ts, js, bs = [], [], []
    for r in range(REP):
        d = make(80, 120, 9000 + r)
        if se_t:
            ts.append(se_t(d))
        else:
            f1 = 1/(SD1*np.sqrt(2*np.pi)); f2 = 1/(SD2*np.sqrt(2*np.pi))
            ts.append(np.sqrt(W[0]**2/(4*80*f1**2) + W[1]**2/(4*120*f2**2)))
        js.append(se_jack(d, stat))
        bs.append(se_boot(d, stat, B=300, seed=r)[0])
    print(f'\n  {label}')
    print(f'    {"方法":<16}{"平均标准误":>12}{"相对离散":>10}')
    for nm, arr in (('泰勒/delta', ts), ('刀切法', js), ('Bootstrap', bs)):
        a = np.array(arr)
        print(f'    {nm:<16}{a.mean():>12.4f}{a.std(ddof=1)/a.mean()*100:>9.1f}%')

print()
print('=' * 80)
print('表2  95% 置信区间覆盖率(重复 1000 次,真值已知)')
print('=' * 80)
true_theta = W[0]*MU1 + W[1]*MU2
cov = {'泰勒': 0, '刀切': 0, 'Bootstrap': 0}
REP2 = 1000
for r in range(REP2):
    d = make(80, 120, 20000 + r)
    th = mean_stat(d)
    for nm, se in (('泰勒', se_taylor_mean(d)),
                   ('刀切', se_jack(d)),
                   ('Bootstrap', se_boot(d, B=300, seed=r)[0])):
        if abs(th - true_theta) <= 1.96 * se:
            cov[nm] += 1
print(f'  真值 θ = {true_theta:.2f}')
print(f'  {"方法":<16}{"覆盖率":>10}')
for nm, v in cov.items():
    print(f'  {nm:<16}{v/REP2*100:>9.1f}%')

print()
print('=' * 80)
print('表3  样本量对三法一致性的影响(加权均值,各重复 300 次)')
print('=' * 80)
print(f'  {"n1/n2":<9}{"理论SE":>9}{"泰勒":>9}{"刀切":>9}{"Boot":>9}'
      f'{"最大相对差":>11}')
for n1, n2 in ((10, 15), (20, 30), (40, 60), (80, 120), (200, 300)):
    th_t, th_j, th_b = theory_se(n1, n2), [], []
    ts, js, bs = [], [], []
    for r in range(300):
        d = make(n1, n2, 30000 + r)
        ts.append(se_taylor_mean(d)); js.append(se_jack(d))
        bs.append(se_boot(d, B=200, seed=r)[0])
    mt, mj, mb = np.mean(ts), np.mean(js), np.mean(bs)
    spread = (max(mt, mj, mb) - min(mt, mj, mb)) / th_t * 100
    print(f'  {n1}/{n2:<6}{th_t:>9.4f}{mt:>9.4f}{mj:>9.4f}{mb:>9.4f}'
          f'{spread:>10.2f}%')

print()
print('=' * 80)
print('表4  刀切法对中位数失效:删一个点,中位数大多不变')
print('=' * 80)
print(f'  {"n1/n2":<9}{"刀切SE":>9}{"Bootstrap":>10}{"刀切唯一值":>11}'
      f'{"删除后不变的比例":>16}')
for n1, n2 in ((20, 30), (80, 120), (400, 600)):
    d = make(n1, n2, 11)
    med = lambda x: W[0]*np.median(x[0]) + W[1]*np.median(x[1])
    th0 = med(d)
    vals = []
    for h in (0, 1):
        for i in range(len(d[h])):
            dd = [d[0].copy(), d[1].copy()]
            dd[h] = np.delete(dd[h], i)
            vals.append(med(dd))
    vals = np.array(vals)
    J = len(vals)
    se_j = np.sqrt((J-1)/J*((vals-vals.mean())**2).sum())
    se_b = se_boot(d, med, B=1000, seed=11)[0]
    unchanged = np.mean(np.abs(vals - th0) < 1e-12)
    print(f'  {n1}/{n2:<6}{se_j:>9.4f}{se_b:>10.4f}{len(np.unique(np.round(vals,6))):>11}'
          f'{unchanged*100:>15.0f}%')

print()
print('=' * 80)
print('表5  计算成本(n=80/120,各跑 20 次取平均)')
print('=' * 80)
d = make(80, 120, 3)
for nm, fn in (('泰勒级数', lambda: se_taylor_mean(d)),
               ('刀切法', lambda: se_jack(d)),
               ('Bootstrap B=1000', lambda: se_boot(d, B=1000)[0])):
    t0 = time.perf_counter()
    for _ in range(20):
        fn()
    print(f'  {nm:<20}{(time.perf_counter()-t0)/20*1000:>9.2f} ms')
*数据来源:底层数据为 calc_variance.py 与本文同目录,固定 seed=20261108,所有数字可复算。
本文讨论统计方法本身,不构成任何建模或授信决策建议。*