费马点怎么用代码找出来:退火、构造与误差
一道 380 年前的题,今天还得靠搜索
1643 年费马写信问托里拆利:平面上有三个点,找一点使得到这三点的距离和最小。这个点后来叫费马点。
上一篇讲了它为什么一定在三个角都是 120° 的位置上,那是纯几何的活。这一篇换个角度:假设你不知道 120° 这件事,只有一台计算机和三行坐标,怎么把它找出来。
这个问题在优化里有意思的地方在于,它是一个凸问题但不可导。距离和是凸函数,所以局部最小就是全局最小,这点很友好。但目标函数在三个顶点处有奇点:如果真的走到顶点上,梯度根本不存在。梯度下降碰到这种地形要专门处理,而随机搜索类方法天然不关心导数存不存在。
三种解法,三种性格
摆在面前的路有三条:
| 方法 | 需要的先验 | 精确性 | 代价 |
|---|---|---|---|
| 模拟退火 | 什么都不需要 | 近似(约 1e-5 相对误差) | 2 万次函数求值 |
| 梯度零点法 | 知道"三向单位向量和为零" | 机器精度 | 一次牛顿迭代 |
| 托里拆利构造 | 知道"外作等边三角形" | 精确(尺规可达) | 常数次运算 |
三者需要的先验知识依次增加,精度也依次提高。下面逐个跑一遍,看它们在同一个三角形上给出什么。
先把目标函数写清楚
三种方法共用一个目标:从点
代码里就是三行:
python
def dist_sum(p, A, B, C):
    return np.linalg.norm(p - A) + np.linalg.norm(p - B) + np.linalg.norm(p - C)
这个函数有两个性质,决定了后面所有方法的选型。
它是凸的。 欧氏范数是凸函数,凸函数的和仍然凸。凸性意味着不存在"假的谷底",任何局部最小都是全局最小,所以方法之间的差别只在精度和速度,不在能不能找到对的答案。
它在三个顶点处不可导。 距离函数在原点附近的样子像个圆锥尖,
这两条合起来解释了为什么这个问题适合拿来比较方法:它简单到能验证,又不平凡到能暴露方法的差异。
模拟退火:什么都不假设
思路很朴素:从重心出发,每一步在当前点附近随机跳一下,新位置更好就接受,更差也按一定概率接受。接受概率随温度衰减,温度从高到低意味着从"到处乱走"过渡到"只往好里走"。
python
def simulated_annealing(A, B, C, n_iter=20000, T0=5.0, T1=1e-4):
    cur = (A + B + C) / 3
    cur_s = dist_sum(cur, A, B, C)
    best, best_s = cur.copy(), cur_s
    for t in np.geomspace(T0, T1, n_iter):
        cand = cur + rng.standard_normal(2) * t * 0.35
        cand_s = dist_sum(cand, A, B, C)
        d = cand_s - cur_s
        if d < 0 or rng.random() < np.exp(-d / t):
            cur, cur_s = cand, cand_s
            if cur_s < best_s:
                best, best_s = cur.copy(), cur_s
    return best, best_s
步长取 t * 0.35,高温时一步能跨好几个单位,低温时步长缩到 1e-4 量级做精修。np.geomspace 让温度按几何级数下降,前段走过大半路程,后段慢慢磨。
拿三个三角形试一下,和精确解对照(完整输出见下方代码块,表格只列关键值):
| 三角形(最大内角) | 退火相对误差 |
|---|---|
| 接近等边(60.8°) | 0.0010% |
| 细长锐角(109.9°) | 0.0049% |
| 钝角(122.2°) | 0.0039% |
解析解与退火解的距离和:
三角形        解析解        退火解      相对误差
接近等边    17.261413   17.261582    0.0010%
细长锐角    36.494465   36.496257    0.0049%
钝角        10.641698   10.642115    0.0039%
三行误差都在万分之一到万分之五量级。第一条是最容易的情形,误差最小;剩下两条地形更扁,同等迭代次数下精度差一点,但都还在可接受范围。
迭代多少次才够
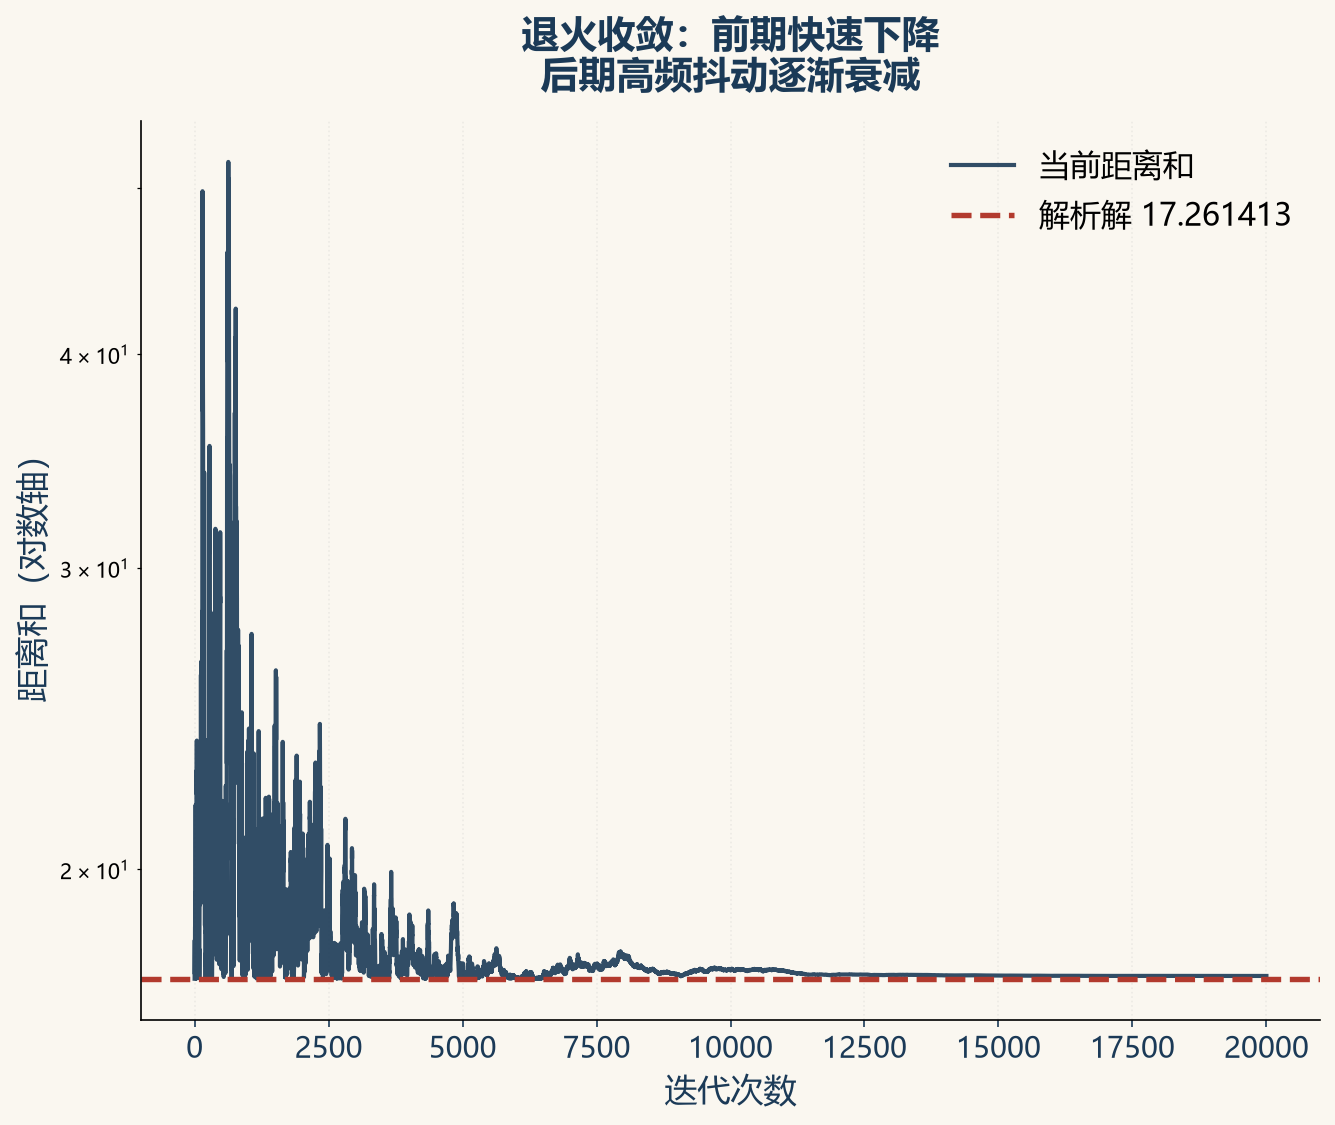
这是个实际问题。跑 500 次和跑 2 万次,差多少?
   迭代       平均距离和      平均误差      最差误差
    500      17.262047     0.0037%     0.0037%
   2000      17.261874     0.0027%     0.0037%
   5000      17.261849     0.0025%     0.0037%
  20000      17.261429     0.0001%     0.0002%
从 500 次到 5000 次,平均误差只从 0.0037% 降到 0.0025%,几乎没动。到 2 万次才真正往下走一档。
这说明退火在前几百次迭代里就找到了正确答案附近,后面两万次基本是在小数点后面磨。困难的地方在磨准,找到它并不难。
如果只要两位小数,500 次足够。如果要和解析解对到 1e-5,得两万次以上。这中间的性价比断崖,是调参时最该知道的事。
梯度零点法:一步到位
费马点满足一个漂亮的条件:从该点指向三个顶点的三个单位向量,向量和为零。
写成能被数值求解器吃掉的形式,就是从重心出发找这个方程组的零点:
python
def fermat_exact(A, B, C):
    if angles(A, B, C).max() > 120 - 1e-9:
        return [A, B, C][int(np.argmax(angles(A, B, C)))]
    def eqs(p):
        v = [(V - p) / np.linalg.norm(V - p) for V in (A, B, C)]
        return v[0] + v[1] + v[2]
    return fsolve(eqs, (A + B + C) / 3, xtol=1e-13)
这个方法的精度是机器精度级的。用它反算三条夹角:
接近等边  三条夹角 120.00000000°  最大偏差 1.42e-14°
细长锐角  三条夹角 120.00000000°  最大偏差 4.26e-14°
偏差在 1e-14 度。这不是"接近 120°",是在双精度浮点数的极限内等于 120°。
注意第一行那个分支:当某个内角超过 120°,方程组的解会跑向那个顶点,此时费马点退化成顶点本身。这个判断不能省,否则求解器会在奇点附近挣扎。
钝角退化:8000 个三角形验证
上面说"内角超过 120°,最优解退化成顶点",这句话值得单独验。
随机撒 2 万个三角形,筛出其中最大内角超过 120° 的 8100 个,对每一个用 200×200 的网格暴力搜索,看能不能找到比"最大角顶点"更优的位置:
随机三角形 20000 个 / 钝角 8100 个
网格搜索找到比"最大角顶点"更优的点: 0 个
最大反例: 0.000e+00
8100 个样本,零反例。
这个验证方式很笨,但它没有依赖任何理论推导,纯粹是"遍历一遍看有没有"。如果定理错了,这里就会冒出反例。
重心差多少
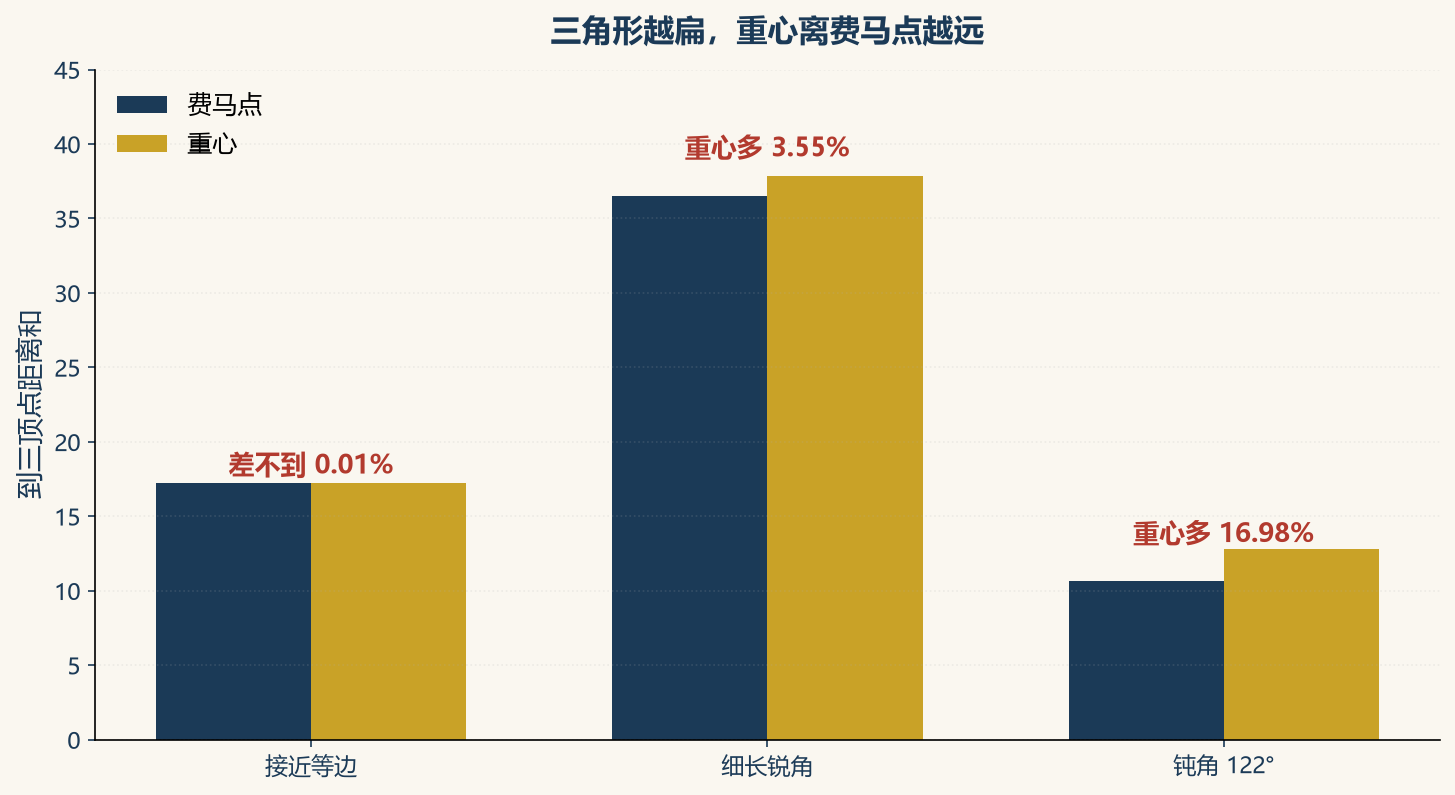
费马点经常被和重心搞混,两者在最简单的三角形里长得差不多。实际差多少:
三角形                费马点        重心         差      差距%
接近等边          17.261413   17.262047   0.000635   0.004%
细长锐角          36.494465   37.837891   1.343425   3.550%
钝角(>120°)       10.641698   12.818454   2.176757  16.981%
接近等边时,两者只差 0.004%,肉眼看不出来。三角形越扁,差距越大:细长锐角到 3.55%,钝角到 16.98%。
这条结论有实用含义:如果你的三角形接近等边,用重心近似费马点几乎没损失;一旦变扁,这个近似就不能用了。
什么时候用哪个
| 场景 | 推荐 | 理由 |
|---|---|---|
| 只想快速拿个近似值 | 模拟退火 500 次 | 误差千分之几,几十毫秒 |
| 要 1e-6 以内的精度 | 梯度零点法 | 一次牛顿迭代到位 |
| 几何作图画在纸上 | 托里拆利构造 | 尺规可达,不需要计算 |
| 三角形可能钝角 | 先判内角 | 否则解会跑向顶点 |
一篇 380 年前的问题,三种解法从"什么都不假设"到"知道定理长什么样",精度差了好几个数量级。先验知识换精度,这个交换在优化里到处都是。
完整代码和验证脚本在下面的仓库里,两个随机种子都写死了,跑出来和上面一模一样。