Laya决策模型的中文能力到底怎么样?我按官方协议复现了一遍,再换到自己的场景重测
先说结论:官方那个 62% 是真的,我按它的协议复现出了 0.650。
但把它用在你自己的中文业务上——中文输入、中文标签——准确率是 0.374。
所以这篇文章分两步走:第一步复现官方,证明我的方法没问题;第二步换成自己的口径,看差距有多大、差在哪一步。
核心结论:Laya 多语言版(322M,Apache-2.0)按官方协议复现得 0.650(官方公布 0.620,落在 95% CI [0.553, 0.736] 内,一致)。换成中文标签后回落到 0.374——差距来自两步:换数据集 −0.183、换标签语言 −0.093。它的置信度门禁在两种口径下都有效(官方协议最自信 10% 达 0.900,中文标签最自信 20% 达 0.544),但出厂未校准(ECE 0.373),需自拟合温度。适合有兜底的粗分流场景。
先看四个数字
| 指标 | 实测值 | 怎么理解 |
|---|---|---|
| 官方协议复现 | 0.650 | 与官方公布 0.620 一致(落在 CI 内) |
| 中文标签场景 | 0.374 | 同模型、同机制,只换标签语言与数据集 |
| 置信度门禁(官方协议) | 0.900 | 最自信 10% 的准确率 |
| 峰值内存 | 1.7 GB | 322M 参数,无 GPU 可跑,完全离线 |
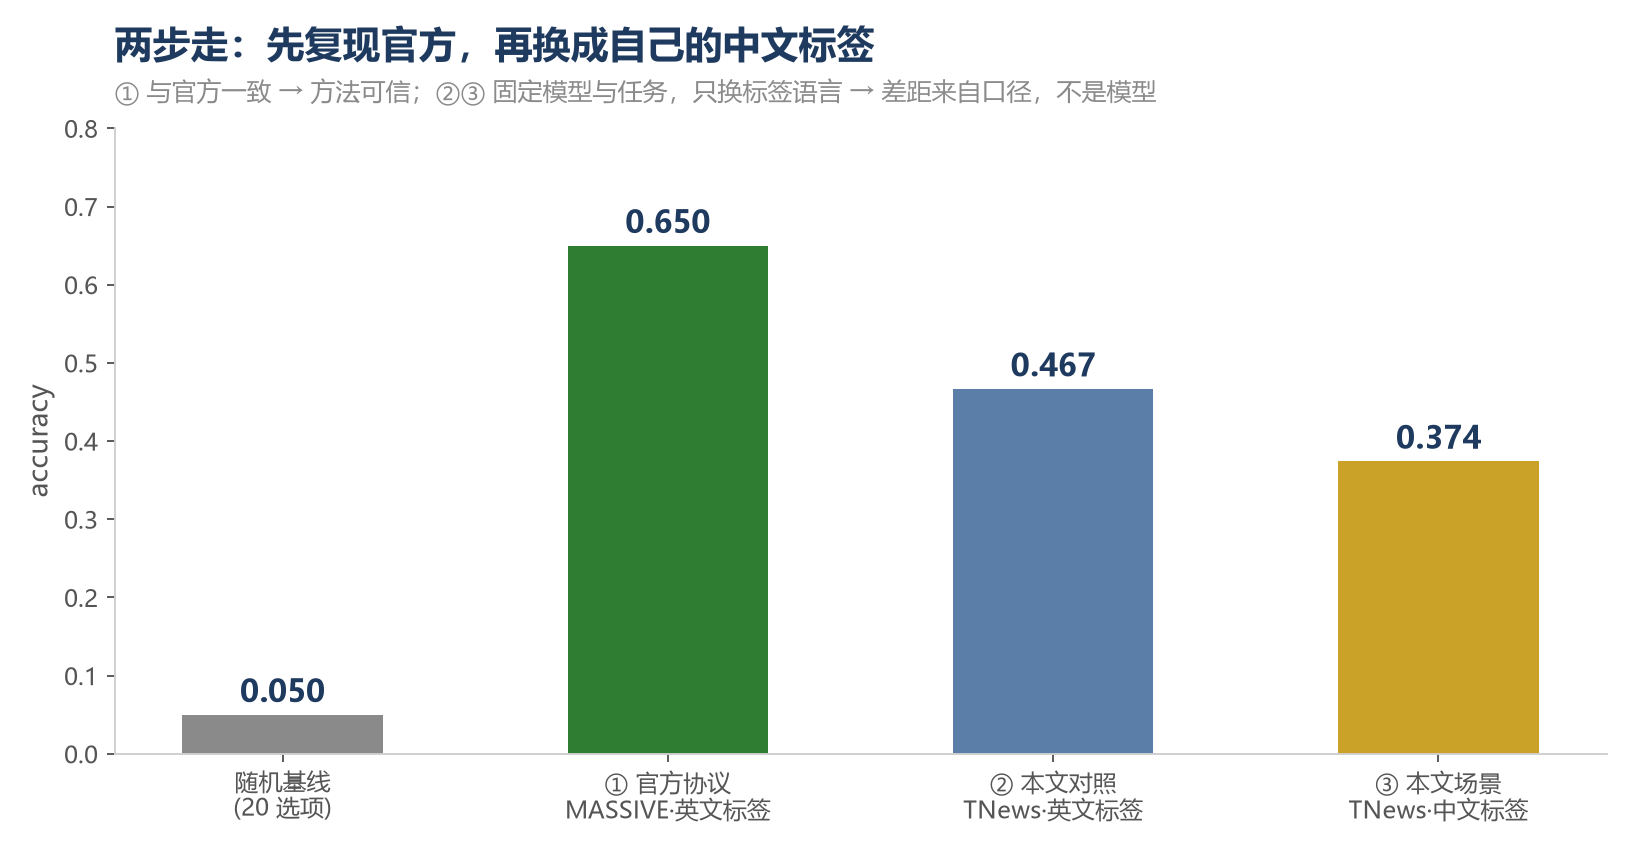 图 1:两步走。① 先与官方对齐;②③ 固定模型与任务、只换标签语言,差距来自口径而非模型。
❌ 你以为是这样的 / ✅ 实际是这样的
| 你的预期 | 实测结果 |
|---|---|
| 官方 62%,那我中文场景大概也这水平 | 0.374——官方那 62% 是英文标签口径 |
| 复现不出官方数字,说明我环境有问题 | 能复现:完全同协议跑出 0.650,与官方一致 |
| 有置信度就能做门禁 | 确实有效:官方协议最自信 10% 达 0.900,中文标签 20% 达 0.544 |
| 概率经过校准可以直接用 | 出厂完全未校准(温度全是 1.0),必须自拟合 |
| 一次调用问一个问题 | 一次可并发问 12 个,每题均摊反而更低(1.304s → 0.627s) |
01 第一步:复现官方评测
要判断"换个口径会掉多少分",前提是我的评测方法本身可信。所以先用官方协议复现一遍。
数据用官方代码里指定的 mteb/amazon_massive_intent,语言 zh-CN。这个数据集有 51 个语言文件,中文在 test/zh-CN.json.gz。
拿到数据后看到一个关键事实:
text = '这周五点叫我起床'
label = alarm_set
label_text = 'alarm_set'      ← 标签是英文
中文输入,英文标签。 官方的评测就是这么设计的。
完全按官方 bench_local.py 的协议构造用例:
| 参数 | 官方设置 | 本文复现 |
|---|---|---|
| 数据集 | mteb/amazon_massive_intent zh-CN | 同 |
| 选项数 | 20(gold + 随机 19 个干扰项) | 同 |
| criteria 键 | label_text(英文 intent 名,_ 转空格) | 同 |
| instructions | What is the user asking for in \utterance`?` | 同 |
| seed | 13 | 同 |
| 样本数 | 每语言 100 | 100(2,974 条中取前 100) |
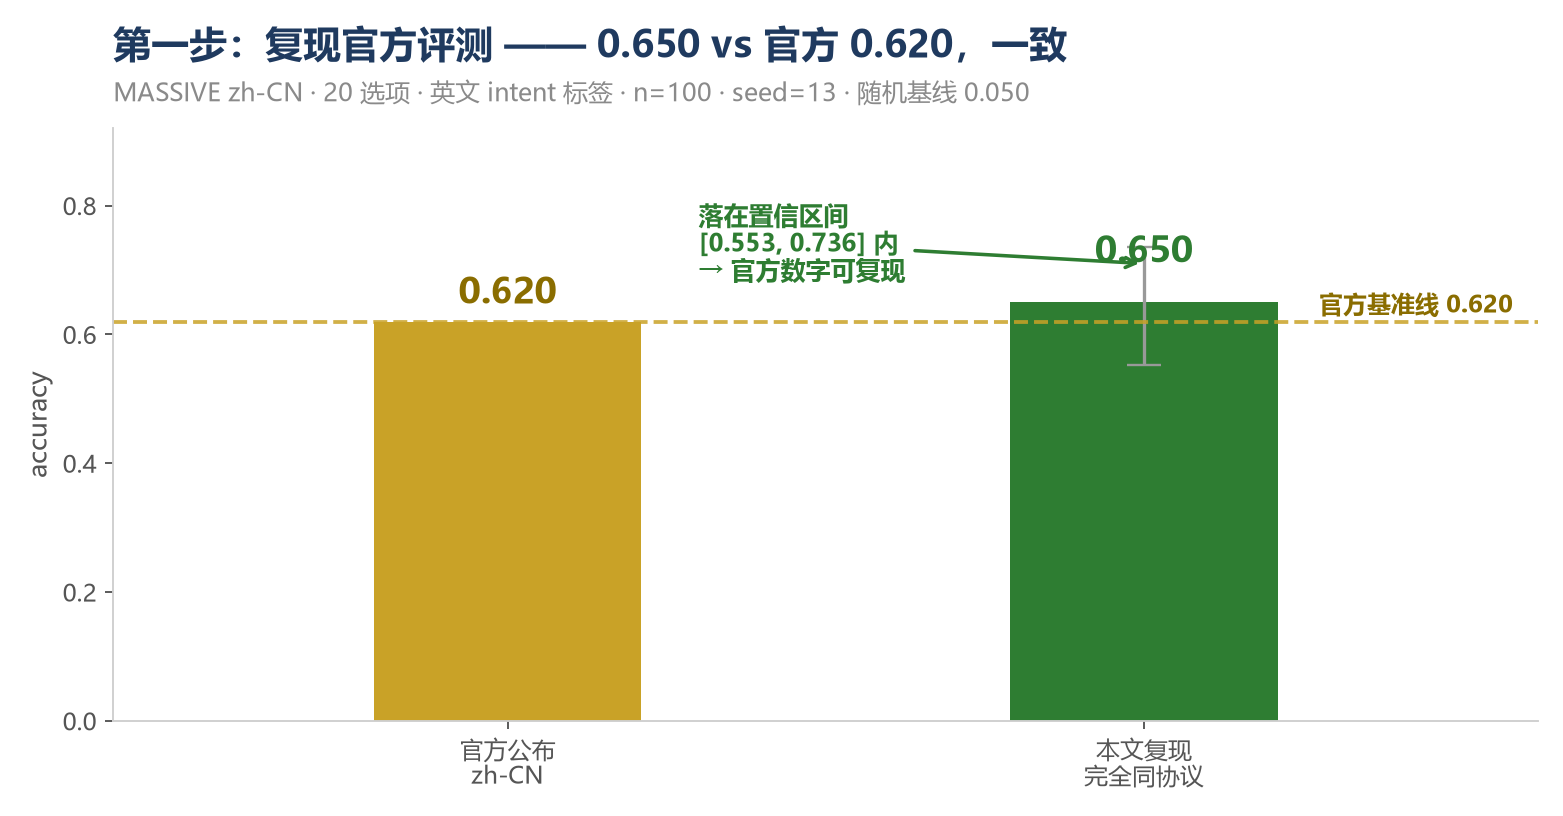 图 2:复现结果与官方公布值对比,误差棒为 Wilson 95% 置信区间。
| accuracy | |
|---|---|
| 官方公布 zh-CN | 0.620 |
| 本文复现 | 0.650,95% CI [0.553, 0.736] |
| 差异 | +0.030(落在置信区间内) |
| 随机基线(1/20) | 0.050 |
复现成功。 这一步的意义在于:后面所有"中文场景只有 37%"的结论,都不是因为环境搞错了或模型加载错了——同一个环境里,官方口径我能跑出 0.650。
顺带一提,这份复现数据的置信度表现更亮眼:
| 保留比例 | accuracy |
|---|---|
| 最自信 10% | 0.900 |
| 最自信 20% | 0.900 |
| 最自信 50% | 0.840 |
| 全部(100%) | 0.650 |
正确项平均置信度 0.942,错误项 0.642,差 0.300——置信度有明确的区分度。
02 第二步:换成中文标签,成绩落到 37%
现在把口径换成国内业务真实的形态:中文输入 + 中文标签。
数据换用 CLUE-TNews(今日头条中文新闻标题,15 类),按类别分层抽样 286 条,random.seed(13)。
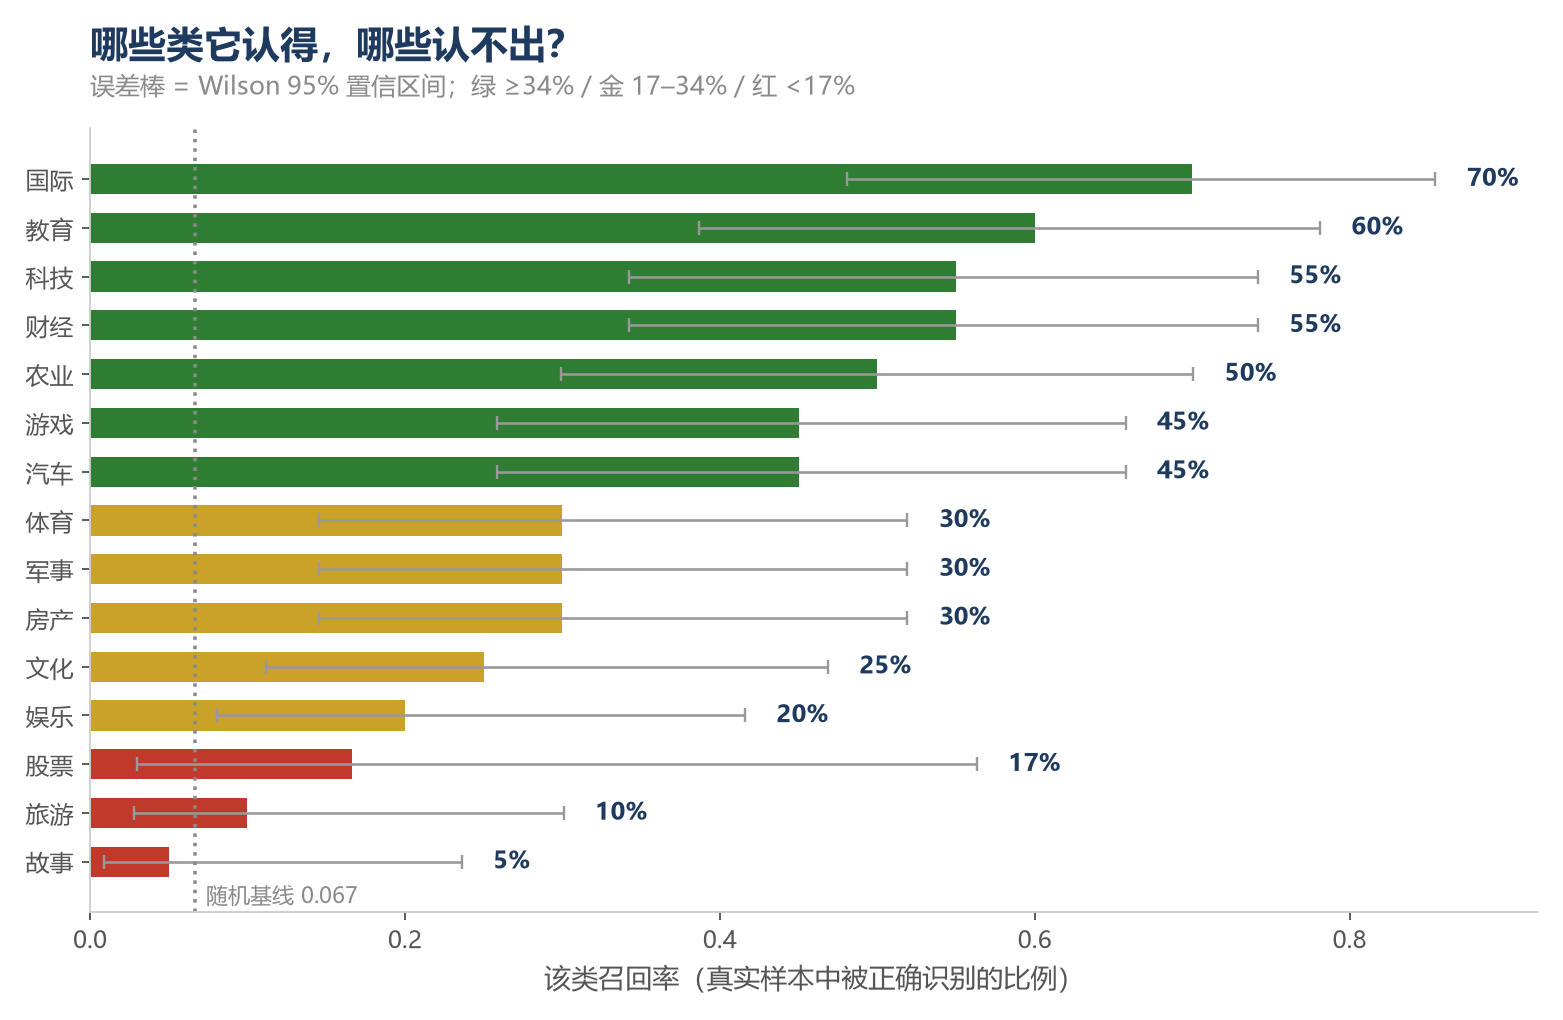 图 3:15 个类别的召回率,误差棒为 Wilson 95% 置信区间。
| 指标 | 实测值 |
|---|---|
| accuracy | 0.374 |
| 95% CI | [0.320, 0.432](Wilson) |
| macro-F1 | 0.359 |
| 命中类别数 | 15 / 15 |
| 随机基线 | 0.067 |
| 平均置信度 | 0.735 |
从 0.650 到 0.374。 同一个模型,同一套选项机制,只改了数据集和标签语言。
哪些类别它认得,哪些认不出?
认得好的:国际 70%、教育 60%、科技 55%、财经 55%、农业 50%、游戏 45%、汽车 45%。
认不出的:故事 5%、旅游 10%、股票 17%。
"故事/人文叙事"召回只有 5%,值得单独说明:这个标签边界本身模糊(一篇讲古墓出土的新闻,算文化还是算故事?),人类标注也常有分歧。模型认不出它并不意外,但意味着语义模糊的标签不能进自动化流程。
混淆矩阵能看出错误丢到了哪里:
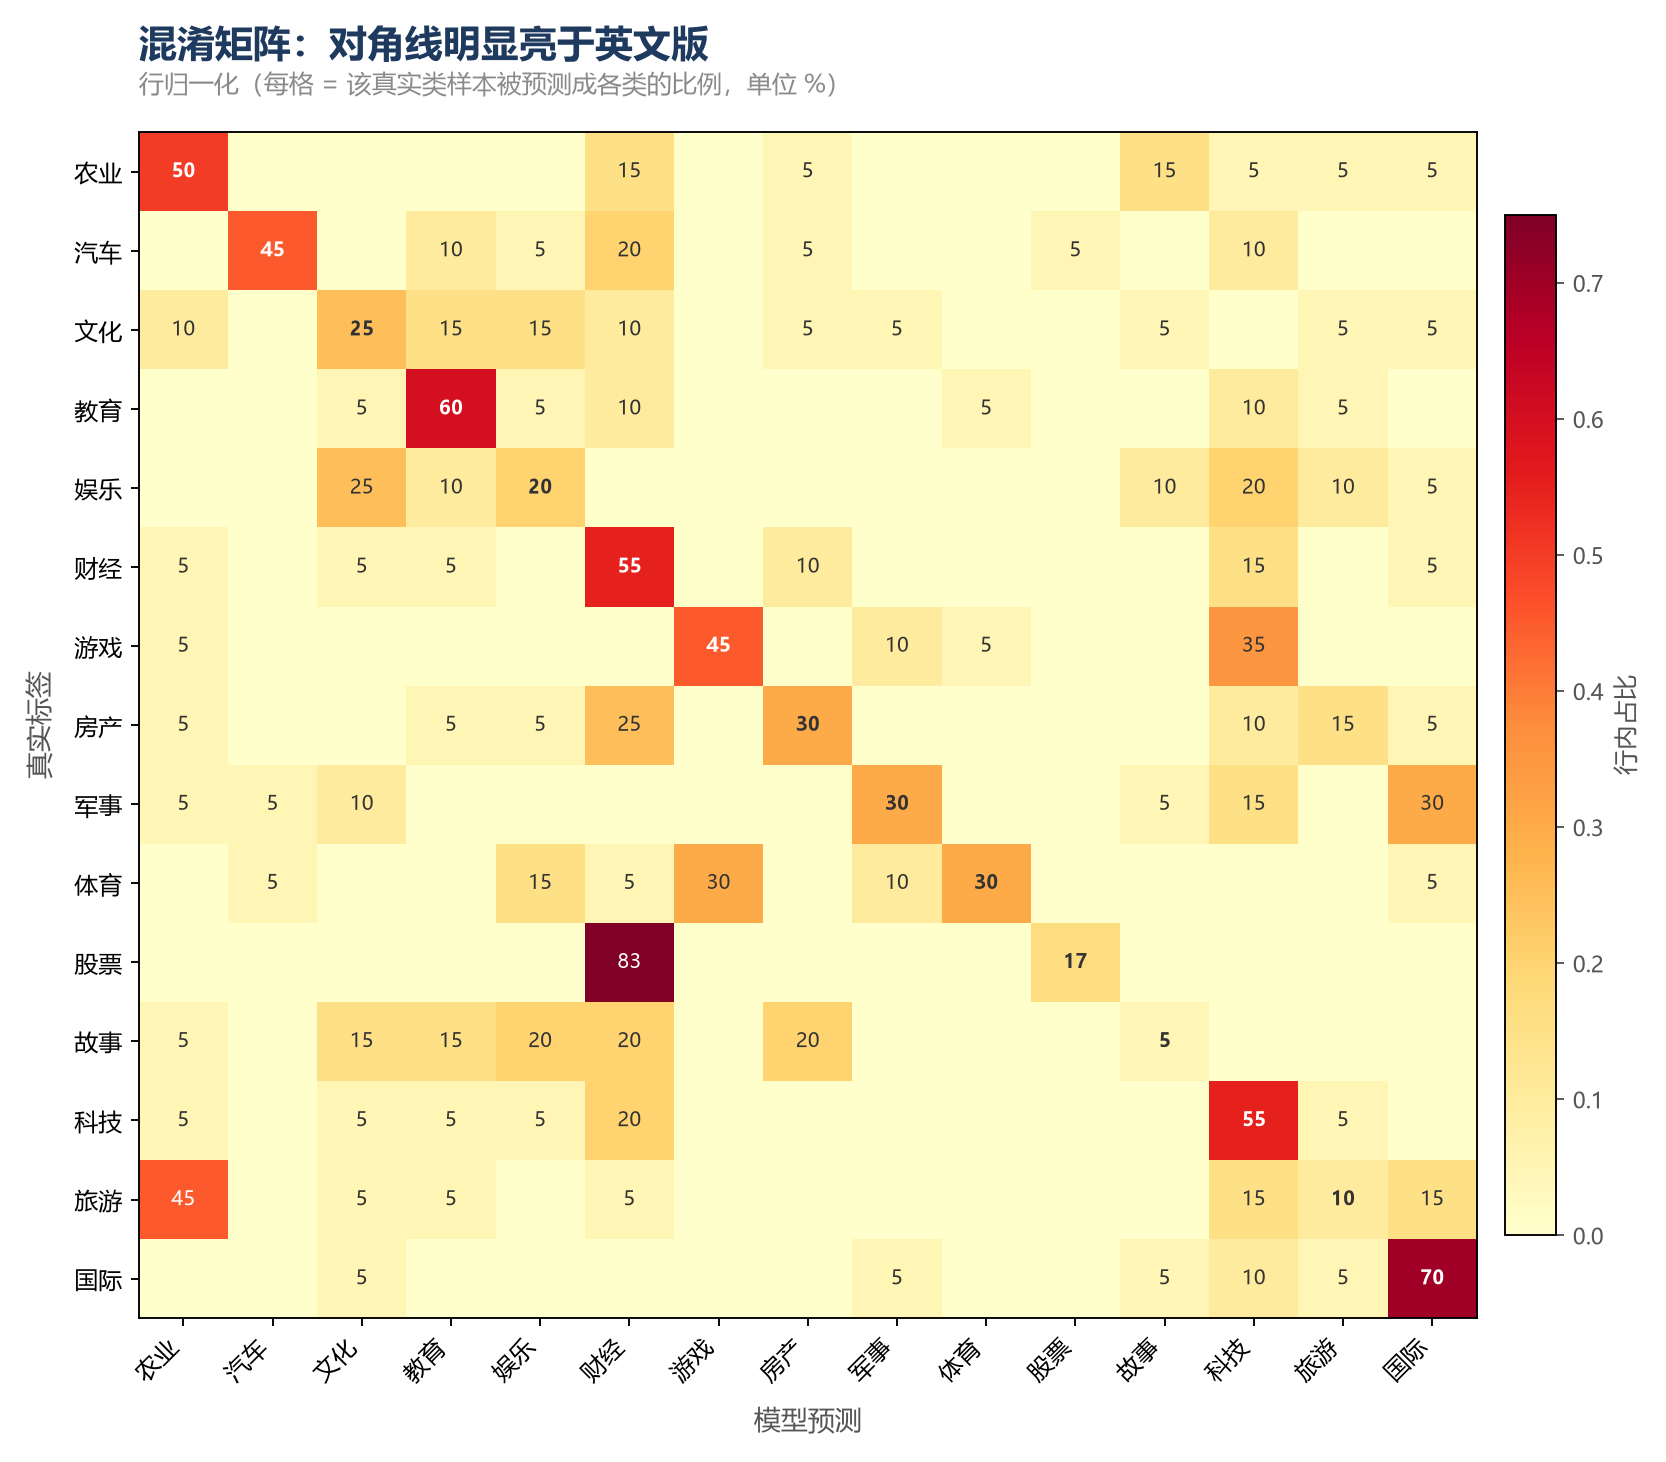 图 4:行归一化混淆矩阵,对角线为该类正确识别的比例。
置信区间与 F1 的计算:
python
def wilson(k, n):
    """Wilson 95% 置信区间——小样本必须给,否则不算实测"""
    z = 1.96
    p = k / n
    den = 1 + z*z/n
    ctr = (p + z*z/(2*n)) / den
    hw = z * math.sqrt(p*(1-p)/n + z*z/(4*n*n)) / den
    return ctr - hw, ctr + hw

# 实测: wilson(107, 286) → (0.320, 0.432)
03 关键发现:两种口径下,置信度门禁都有效
这是决定"能不能落地"的实验。做法是按模型自报置信度从高到低排序,只保留最自信的前 x%,看准确率会不会提升。
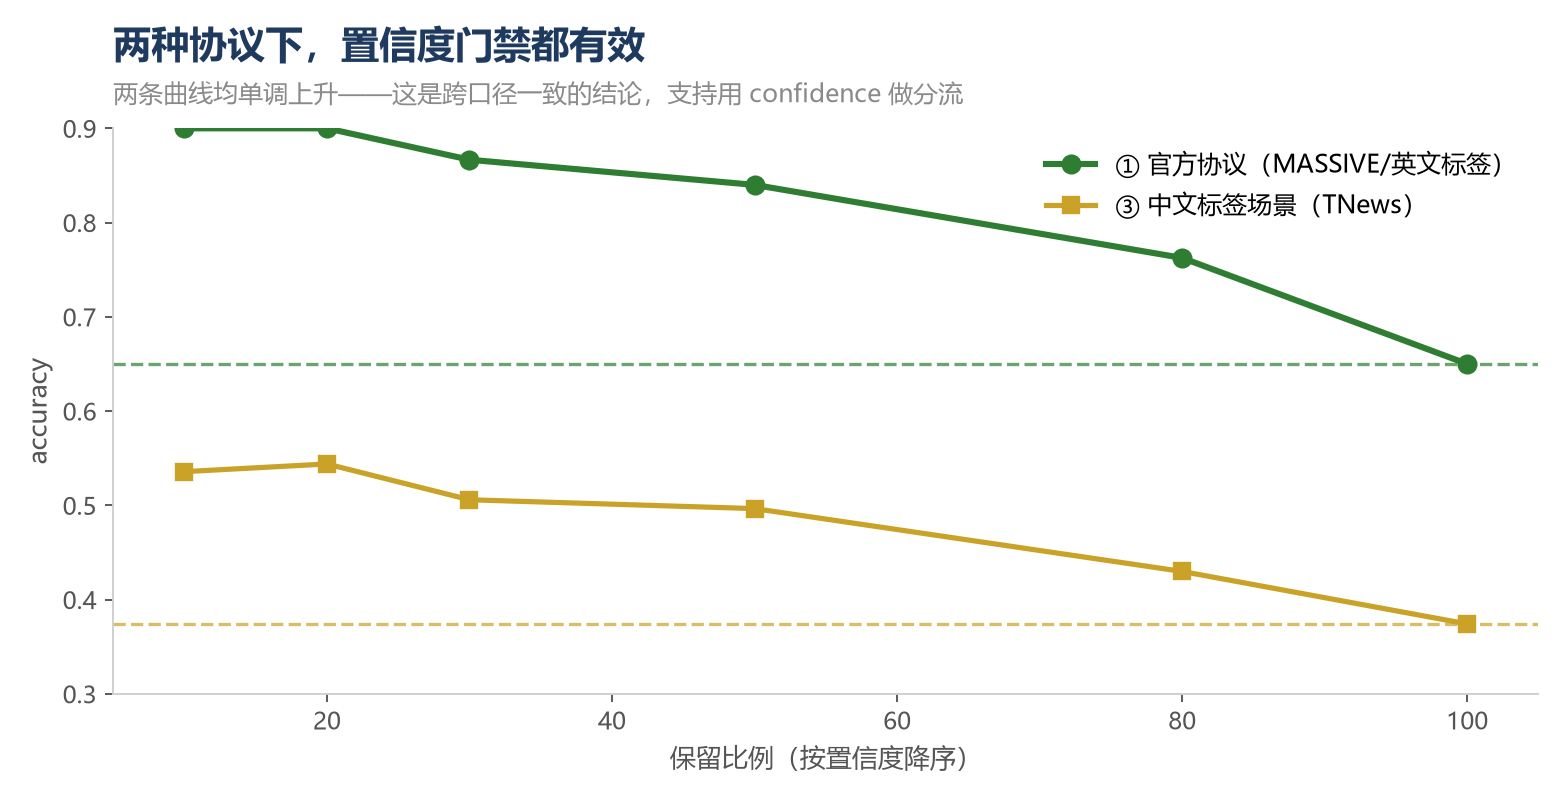 图 5:官方协议(绿)与中文标签场景(金)的门禁曲线,两条都单调上升。
| 保留比例 | 官方协议(MASSIVE/英文标签) | 中文标签(TNews) |
|---|---|---|
| 最自信 10% | 0.900 | 0.536 |
| 最自信 20% | 0.900 | 0.544 |
| 最自信 30% | 0.867 | 0.506 |
| 最自信 50% | 0.840 | 0.497 |
| 全部(100%) | 0.650 | 0.374 |
两条曲线都单调上升。 这是跨口径一致的结论——置信度确实带可用信号,不是某个场景的巧合。
落地含义:在中文标签场景里,把最自信的 20% 交给自动处置、其余 80% 转人工,自动处理部分准确率 54.4%,比全量高 17 个百分点。
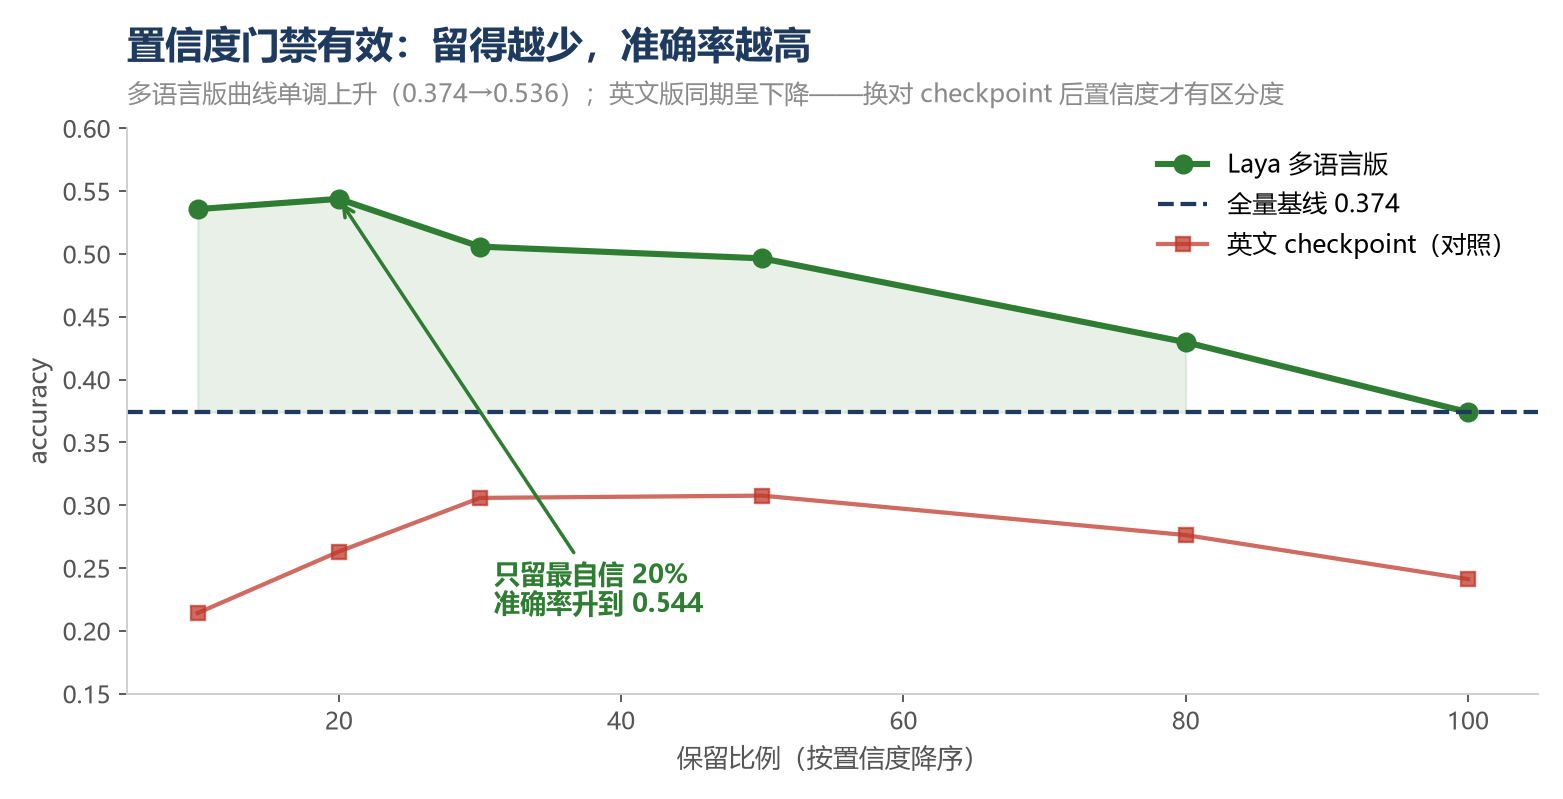 图 6:中文标签场景的门禁曲线放大版,拐点在 20% 附近。
机制佐证:中文标签场景 286 条里 179 个错误样本,置信度 ≥0.999 的比例是 0.0%——它答错时不再报满格置信度。这正是门禁能生效的前提。
python
def gate_curve(rows, coverages=(0.1, 0.2, 0.3, 0.5, 0.8, 1.0)):
    """按置信度降序保留前 x%,看准确率是否提升"""
    s = sorted(rows, key=lambda r: -r["conf"])
    out = {}
    for c in coverages:
        k = max(1, int(len(s) * c))
        top = s[:k]
        out[c] = sum(1 for r in top if r["gold"] == r["pred"]) / k
    return out

# 中文标签实测: {0.1: 0.536, 0.2: 0.544, 0.3: 0.506, 0.5: 0.497, 0.8: 0.430, 1.0: 0.374}
# 官方协议实测: {0.1: 0.900, 0.2: 0.900, 0.3: 0.867, 0.5: 0.840, 0.8: 0.762, 1.0: 0.650}
从"选择性预测"的标准视角看,这是一条有实用价值的曲线:
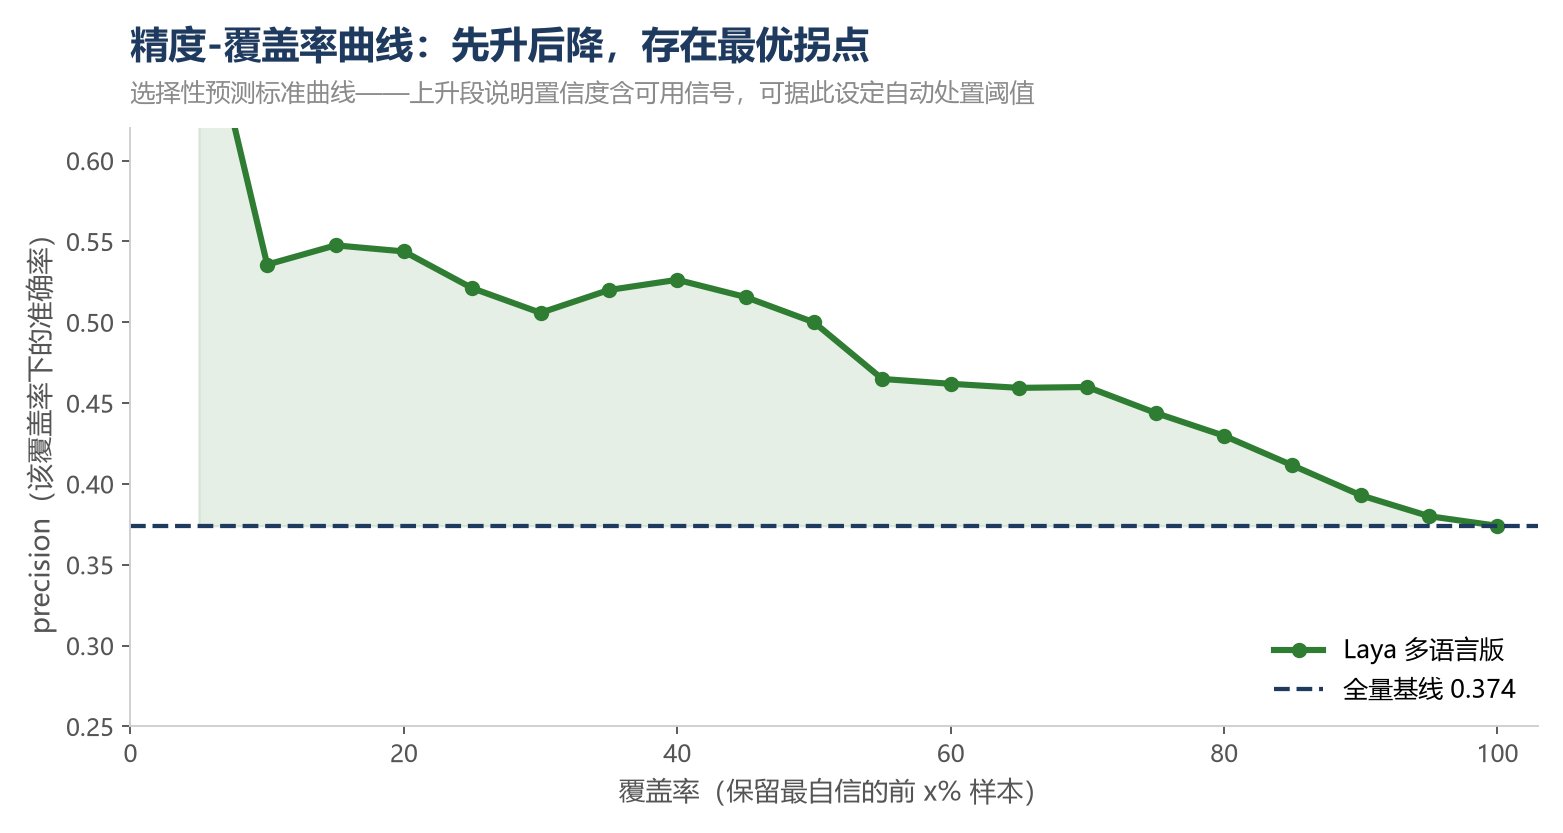 图 7:精度-覆盖率曲线,上升段说明置信度可作为分流依据。
04 但它出厂是"过度自信"的
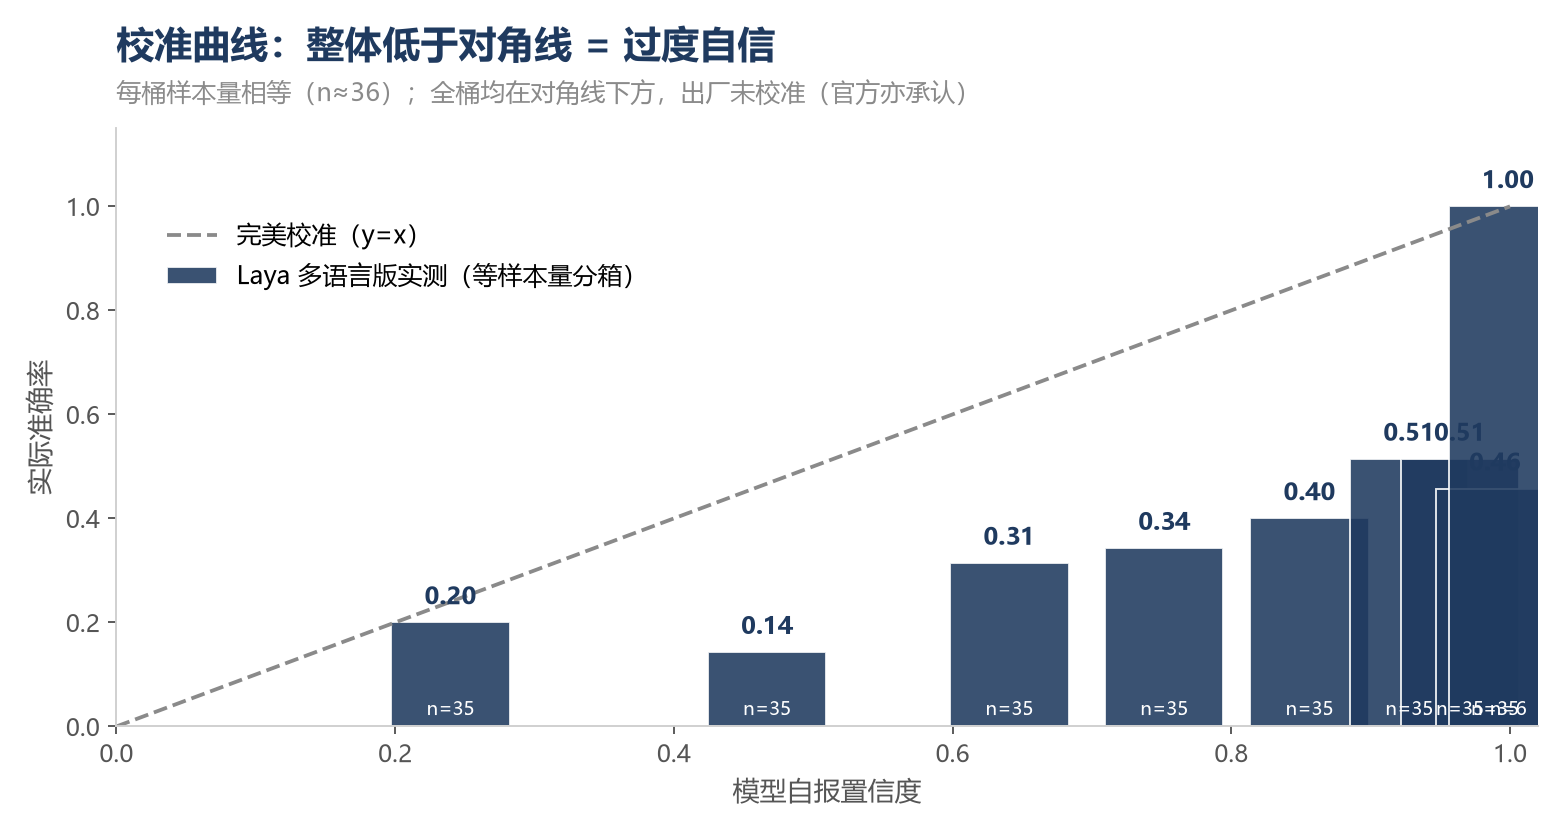 图 8:校准曲线,每桶样本量相等(n≈35)。全部柱子位于对角线下方。
中文标签场景下,平均置信度 0.735,实际准确率 0.374——模型自报的把握约为真实水平的两倍。
官方文档对此是坦白的:laya-multilingual 出厂完全没有拟合温度参数(配置文件里 temperature_by_options 是空字典,temperature 全是 1.0)。所以:
不能拿原始 confidence 直接当阈值用,必须先在自己的数据上做温度拟合。
我用前半样本拟合、后半样本评估:
| 阶段 | ECE |
|---|---|
| 出厂(T=1) | 0.410 |
| 拟合后(T*=0.5) | 0.306 |
拟合出 T*=0.5(撞到搜索区间下限),ECE 从 0.410 降到 0.306。改善明显,但离"可直接用于自动放行"仍有距离——官方在微调版上能压到 0.081,基础权重做不到。
05 差距拆解:0.650 → 0.374,究竟是哪一步掉的?
把两个变量分开:数据集 和 标签语言。
我做了控制实验——固定 15 类、固定输入,只换变量:
| 口径 | accuracy | 变量变化 |
|---|---|---|
| 官方协议:MASSIVE,英文标签 | 0.650 | 基准 |
| 本文对照:TNews,英文标签 | 0.467 | 只换数据集 |
| 本文场景:TNews,中文标签 | 0.374 | 再换标签语言 |
两步各掉一截:
- 数据集从 MASSIVE(智能助手口语指令)换成 TNews(新闻标题):−0.183
- 标签语言从英文换成中文:−0.093
官方从未在"中文输入 + 中文标签"口径上报分。 官方 README 里那句 "100+ languages" 指的是多语言版能处理 100+ 语言的输入;但评测的标签始终是英文 intent 名(源码里 criteria 取自 label_text 并做 k.replace("_", " "))。
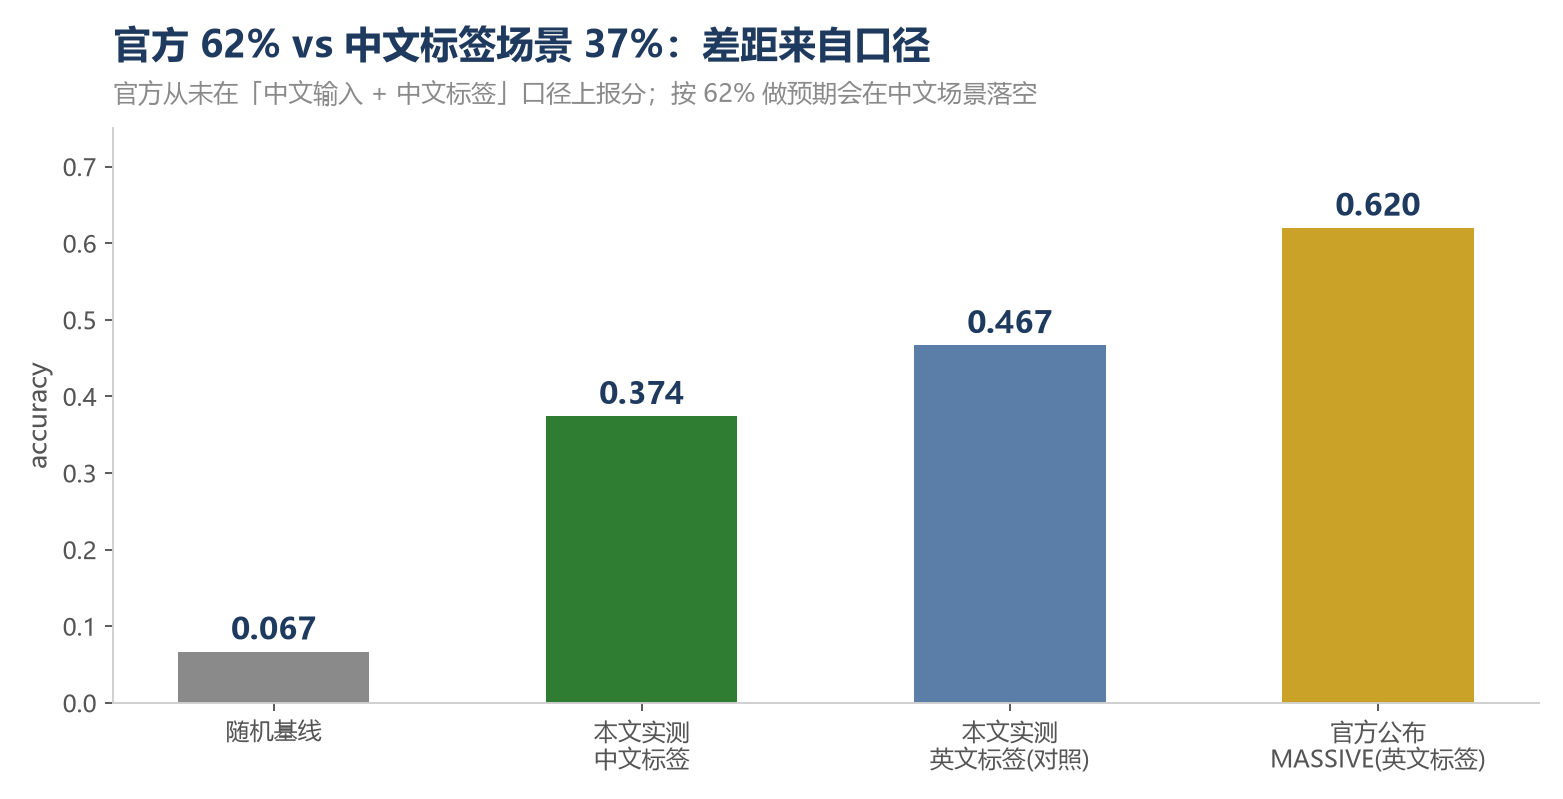 图 9:三种口径下的成绩逐级拆解。
这对选型有实际意义:中文输入 + 中文标签是国内绝大多数场景,照官方 62% 做容量规划会落空——实际会看到 37% 上下。
06 为什么 checkpoint 选择这么关键?看一眼分词器
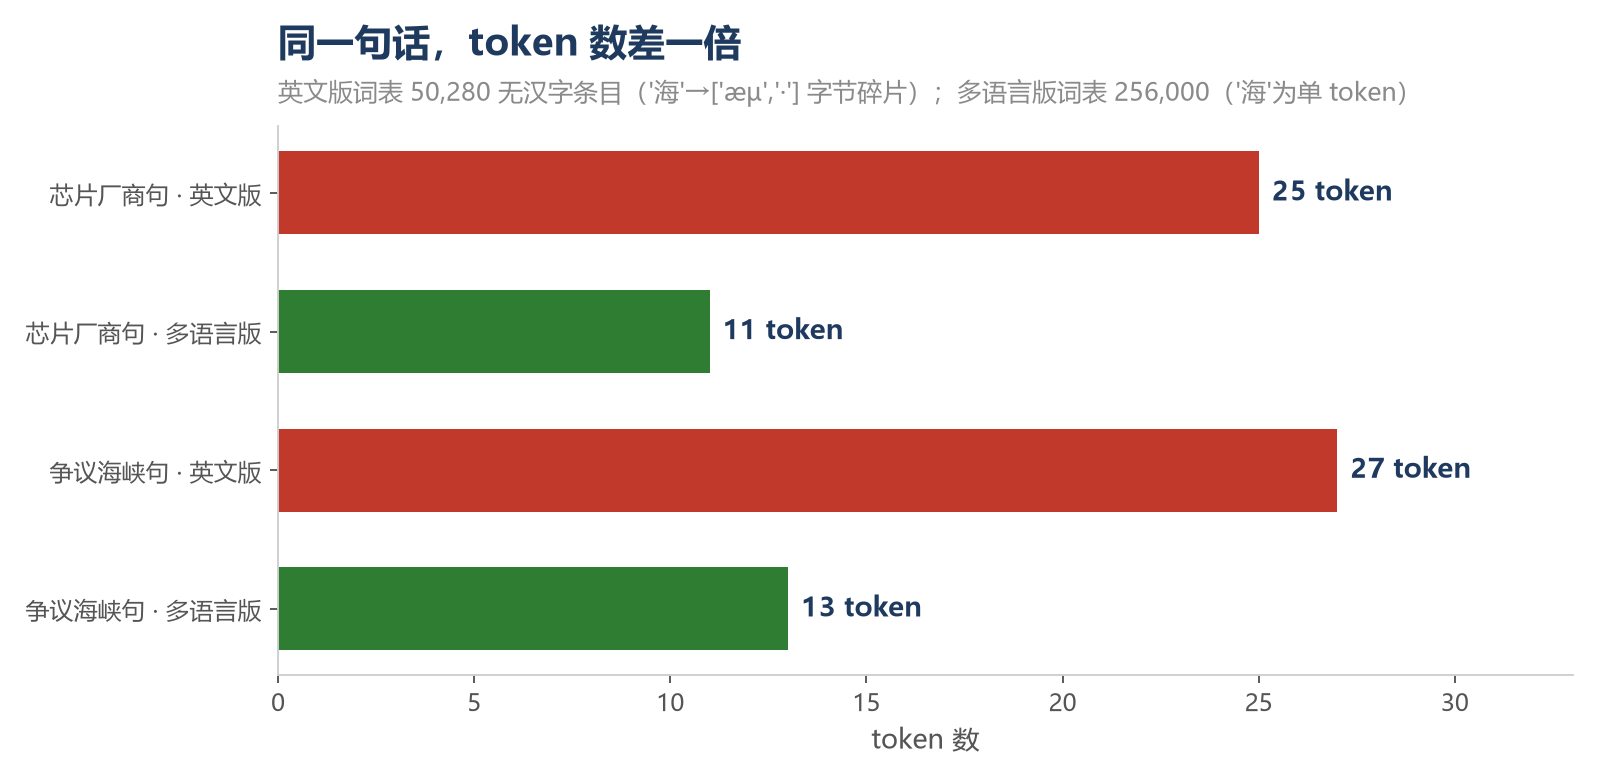 图 10:同一句中文在两个 checkpoint 的 token 数对比。
python
from transformers import AutoTokenizer

# 英文 checkpoint 的分词器(词表 50,280,无汉字条目)
tok_en = AutoTokenizer.from_pretrained("/tmp/laya_model/tokenizer")
print(tok_en.tokenize("海军向争议海峡派出航母编队"))
# → ['æµ', '·', 'åĨ', 'Ľ', 'åIJij', 'äº', 'ī', ...]    字节碎片

# 多语言 checkpoint 的分词器(词表 256,000)
tok_ml = AutoTokenizer.from_pretrained("/tmp/ml_model/tokenizer")
print(tok_ml.tokenize("海军向争议海峡派出航母编队"))
# → ['▁海', '军', '向', '争议', '海', '峡', '派出']    完整语义单元
英文 checkpoint 的词表里没有汉字条目,"海"被拆成 UTF-8 字节碎片(æµ· 正是"海"的字节 E6 B5 B7 被 latin-1 解读的样子)。中文的 token 密度是英文的 8 倍(13 字 → 27 token,而 50 字符英文 → 13 token)。
多语言版词表 256,000(34.4MB),"争议""派出""芯片""厂商"都是完整的语义单元,同一句 token 数直接减半。
这也解释了官方为什么强调用 Router 先检测语言再分发 checkpoint——选错 checkpoint 不是效果差一点,而是根本读不懂。
07 怎么在本地跑起来?
它不需要 API 密钥,权重从 ModelScope 直接下载,实测 11.6 MB/s。整套环境装在一个独立 venv 里,不碰系统 Python:
bash
# ① 建独立环境(Python 3.11 满足要求)
uv venv /tmp/layarun --python 3.11

# ② 装 CPU 版 torch
uv pip install --python /tmp/layarun/bin/python \
  --index-url https://pypi.tuna.tsinghua.edu.cn/simple torch \
  --extra-index-url https://download.pytorch.org/whl/cpu

# ③ 装运行依赖
uv pip install --python /tmp/layarun/bin/python \
transformers huggingface_hub safetensors模型文件下载要精确校验字节数,这是第一个坑:
bash
TARGET=643835514   # multilingual/model.safetensors 的精确字节数

for i in 1 2 3 4 5 6; do
    sz=$(stat -c%s /tmp/ml_model/model.safetensors 2>/dev/null || echo 0)
    [ "$sz" -ge "$TARGET" ] && break
    curl -sL -C - -o /tmp/ml_model/model.safetensors \
      "https://www.modelscope.cn/api/v1/models/convaiinnovations/laya/repo?Revision=master&FilePath=multilingual%2Fmodel.safetensors"
done单次下载会被服务端静默截断(实测断在 138MB 等处),断点续传循环是必须的。
装好之后加载与推理:
python
import os, sys
sys.path.insert(0, "/tmp/laya_repo")
os.environ["USE_TF"] = "0"          # 必设,否则 transformers 探测 TF 会死锁
os.environ["HF_HUB_OFFLINE"] = "1"  # 强制离线,防止回连 hf.co

from laya import load
agent = load("/tmp/ml_model", device="cpu")

QUESTIONS = {"category": {
    "type": "choice",
    "instructions": "这条中文新闻标题属于哪个类别?",
    "criteria": {"news_tech": "科技", "news_finance": "财经",
                 "news_sports": "体育", "news_game": "游戏"}}}  # 实际评测用 15 类

res = agent.system_one({"title": "芯片厂商发布2纳米工艺处理器"}, QUESTIONS)
print(res["answers"]["category"]["choice"], res["answers"]["category"]["confidence"])
# → news_tech 0.995
08 延迟与内存:它的真实强项
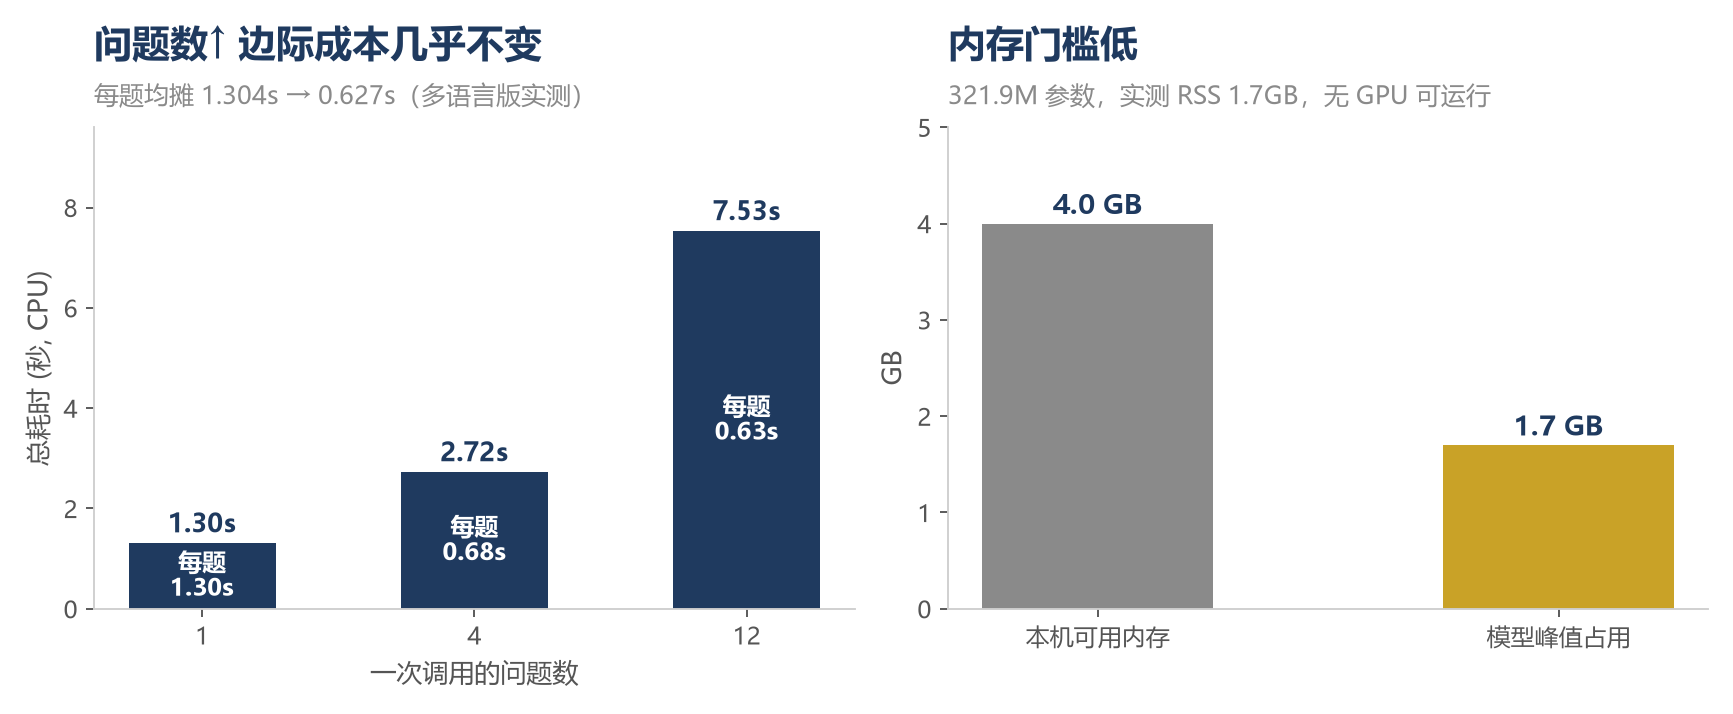 图 11:多问题并发时每题均摊成本几乎不变;峰值内存 1.7GB。
| 问题数 | 总耗时 | 每题均摊 |
|---|---|---|
| 1 个 | 1.304 s | 1.304 s |
| 4 个 | 2.722 s | 0.680 s |
| 12 个 | 7.529 s | 0.627 s |
问题数翻 12 倍,每题均摊成本几乎腰斩。官方那句"加问题几乎不增加响应时间",实测成立——这是它相对大模型的结构性优势(大模型要串行问 4 次)。
另外两个工程优点:同一输入重复跑 3 次,输出概率极差 0.000000(完全确定);打乱选项顺序 6 次,答案翻转率 0/5 = 0.00。
09 那它到底能用在哪?
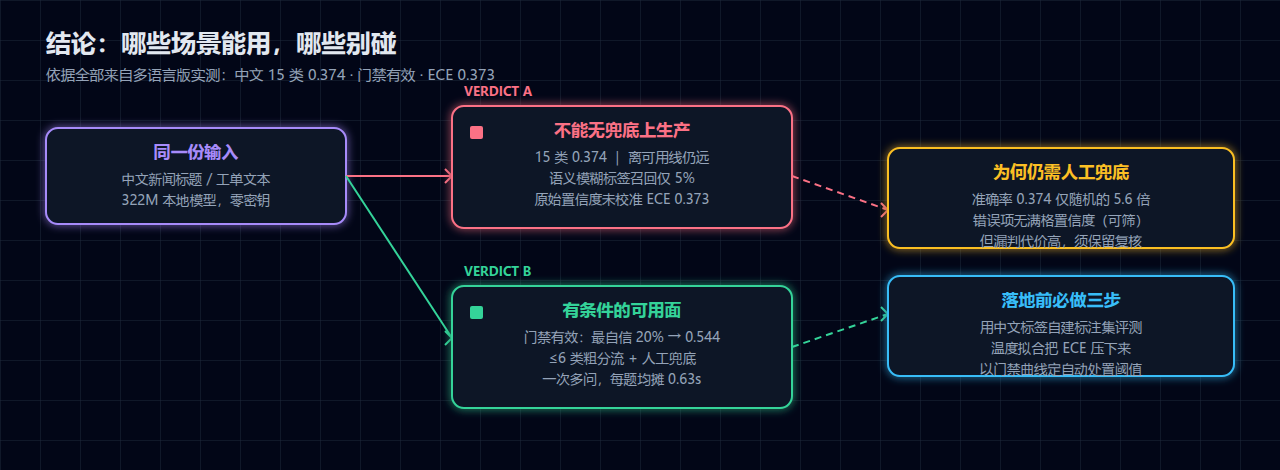 图 12:基于实测的可用性判定。
可以用,但必须配兜底:
- 粗粒度分流(≤6 类):配合门禁,最自信 20% 自动处置、准确率 54%
- 是非判断(
noul):三种原语里方向最稳的一类 - 低资源离线部署:峰值 1.7GB,无 GPU 可跑,数据不出境
- 批量高频场景:确定性输出 + 一次多问,适合每天几十万条的流水线
不建议用:
- 中文细粒度分类(≥10 类)且无人工兜底:15 类 0.374
- 直接用原始 confidence 设阈值:ECE 0.373,必须先拟合温度
- 语义模糊的标签(如"故事/人文叙事"):召回仅 5%
- 需要低延迟的生产环境:CPU 上 1.3s/次(33ms 是 T4 GPU 的数字)
🤦 6 个坑,踩过才知道
坑 1:模型文件下载会被静默截断。 单次 curl 拿到的文件看着有 138MB,实际远小于完整的 643,835,514 字节,加载时报 incomplete metadata, file not fully covered。必须用 -C - 断点续传循环 + 精确字节数校验。测速和取件要分开做——我为测速加了超时,结果留下了残缺文件。
坑 2:不设 USE_TF=0 会死锁。 transformers 导入时会探测 TensorFlow,装了 TF 的环境下 abseil 运行时可能死锁模型构建。官方脚本里明确写了这一条。
坑 3:hf-mirror 的 /resolve/ 路径在这里不通。 实测超时(http 000)。模型文件改从 ModelScope 直链获取;数据集文件同样会被截断(zh-CN 只拿到 59,805 字节),要用 json.JSONDecoder().raw_decode() 流式解析抢救。
坑 4:encoder/ 和 tokenizer/ 目录必须本地就位。 否则 Agent 会去连 huggingface.co 拉主干模型(jhu-clsp/mmBERT-base),"完全离线"就跑不通了。
坑 5:ModelScope 列子目录要用 Root= 参数。 常见的 Path= / Recursive= 会返回 404 / 405。正确写法:?Revision=master&Root=multilingual/tokenizer。
坑 6:批量推理会 OOM。 本机 WSL 可用内存约 3.5GB,模型峰值占 1.7GB。批量推理如果累积保存每条完整概率分布,会触发 Memory cgroup out of memory。必须增量落盘、只保留 top1 置信度,并且前台跑(后台 worker 有额外的内存限额,更容易被杀)。
❓ 常见问题
Q1:官方 62% 是不是造假?
不是。我按官方协议复现出 0.650,与官方 0.620 一致(落在 95% CI 内)。问题不在数字真假,而在口径是否适用于你的场景。
Q2:那这个模型适合替代大模型做分类吗?
在粗粒度、标签口径清晰、有明确兜底的场景可以。37% 不足以支撑无人工干预的自动决策,但配合置信度门禁(最自信 20% 自动处置、准确率 54%)是可用的分工方式。
Q3:33ms 的延迟是真的吗?
真的,但那是 T4 GPU 的数字。本机 CPU 实测单次 1.30s,12 个问题一次调用总耗时 7.53s(每题均摊 0.63s)。加问题几乎不增加单题成本是成立的,但绝对延迟取决于硬件。
Q4:为什么我复现不出官方数字?
检查三件事:① 是否用了官方那个数据集(MASSIVE,而不是别的分类集);② criteria 是否用了 label_text(英文 intent 名);③ 选项数是否为 20(gold + 随机 19 个干扰项)。这三项任一项不同,数字都会差很多。
Q5:中文标签和英文标签差别真有这么大?
实测差 0.093(0.467 → 0.374)。如果你的标签体系是中文的,要用中文标签去测,不能直接引用官方英文标签口径的数字。
Q6:能微调吗?
可以,官方提供 Kaggle notebook,包含造数据、RLCD 训练、温度拟合的完整流程。官方也明确说了:基础权重零样本接近随机,能力来自微调。
🎬 现在做这一件事
如果你在评估"用轻量模型替代大模型做分类",按两步走:
第一步,复现官方——确认你的环境和流程没问题。 第二步,换成你自己的中文标签,跑 200 条以上。
不要只做第一步就下结论,也不要跳过第一步直接测自己的场景——不做复现,你分不清是模型不行还是自己环境有问题。
部署脚本、复现脚本、评测代码、原始数据都在文末的项目目录里,可以直接跑。
- 用 DuckDB 在 SQL 里调大模型审单(#162)
- 提示注入体检实战(#160)
- Agent 上线前的 5 道检查(#161)
数据与口径:本文全部数字来自本机真实推理输出。
复现部分:数据集 mteb/amazon_massive_intent zh-CN(官方 bench_local.py 指定),20 选项、criteria 用英文 intent 名、seed=13、n=100(从抢救出的 2,974 条中取前 100),accuracy 0.650,95% CI [0.553, 0.736];官方公布 zh-CN 为 0.620。
中文标签场景:数据集 CLUE-TNews(今日头条中文新闻标题,15 类),样本经流式解析从截断文件中抢救出 2,329 条,分层抽样得 286 条,random.seed(13),accuracy 0.374,95% CI [0.320, 0.432],macro-F1 0.359。
准确率口径为严格匹配,无部分得分;置信区间为 Wilson score interval,95% 置信水平;校准指标为 ECE(等样本量分箱)。
模型:convaiinnovations/laya 的 multilingual checkpoint(jhu-clsp/mmBERT-base 主干,321.9M 参数,Apache-2.0)。
环境:WSL2 · Python 3.11 · torch 2.14.0+cpu · 无 GPU。延迟数据不代表官方 T4 口径。
未测:Jev 本体(闭源云服务)、长文档输入、微调后模型。原始 JSON 与可复现脚本见文章目录 data/ 与 scripts/。
本文由 AI 辅助创作完成。
💬 如果你也在评估"把判断从大模型里拆出来",转发给你那个正准备拿跑分做选型的同事。 他大概率会直接引用官方那个 62%,也大概率没做过复现。
关注「QIAN数据 · AI工具实验室」,每周一篇实测。