LangChain MMR 检索实测——检索结果去重的数学原理与调参曲线
本文由 AI 辅助创作,数学推导、实验设计与数据分析由作者完成。
核心结论:向量检索默认按相似度排序,当某一篇文章特别对口时,它会把 Top-K 的位置全部占满。实测 12 个提问,平均只覆盖 5.17 篇不同文章(最差的一次 8 条结果全来自同一篇)。加上 MMR(最大边际相关性)后,覆盖数涨到 6.92 篇,而平均相关度只从 0.610 掉到 0.598——用 1.9% 的相关度换 33.9% 的覆盖面。本文推导 MMR 的目标函数与 (1−1/e) 贪心下界,扫描 λ 找拐点,并给出可运行的 LangChain 代码。
关键词:MMR,最大边际相关性,向量检索,余弦相似度,子模优化,LangChain,RAG
01 先说结论
我在自己的文章库上跑了一组对照实验(240 篇正文,切成 5062 个文本块):
| 指标 | 纯相似度检索 | MMR(λ=0.7) | 变化 |
|---|---|---|---|
| 覆盖不同文章数 | 5.17 / 8 | 6.92 / 8 | +33.9% |
| 同一篇最大重复次数 | 3.42 | 1.92 | −43.9% |
| 结果内最大相似度 | 0.803 | 0.733 | −8.6% |
| 平均相关度 | 0.610 | 0.598 | −1.9% |
最后一行是这张表的关键。相关度掉了 1.9%,覆盖面涨了 33.9%。你几乎没有损失"找到的东西有多对",但视野宽了一截。
这个结果来自 MMR 的目标函数,不是调参调出来的。下面拆开讲。
02 问题在现场:8 条结果只有 1 篇
问一句"注意力机制怎么理解?",纯相似度检索返回的 8 条是这样的:
QIAN#0024  QIAN#0024  QIAN#0024  QIAN#0024
QIAN#0024  QIAN#0024  QIAN#0024  QIAN#0024
8 个位置全部来自同一篇文章。检索本身没坏。那篇文章讲注意力机制讲得最透,所以它的每一段都排在了前面。
再看几个提问:
| 提问 | 纯相似度覆盖 | 同文最多重复 |
|---|---|---|
| 注意力机制怎么理解? | 1 / 8 篇 | 8 次 |
| 分位数回归和 OLS 有什么区别? | 2 / 8 篇 | 7 次 |
| 牛顿法和梯度下降有什么区别? | 1 / 8 篇 | 8 次 |
| DuckDB 和 pandas 比有什么好处? | 6 / 8 篇 | 3 次 |
| 聚类算法怎么选? | 8 / 8 篇 | 1 次 |
只要某篇文章特别对口,列表就会被它包场。你本想看看别人怎么讲这个主题,结果只读到了一个人的说法。
问题出在"挑最相似的 K 个"这个动作本身——它奖励扎堆。
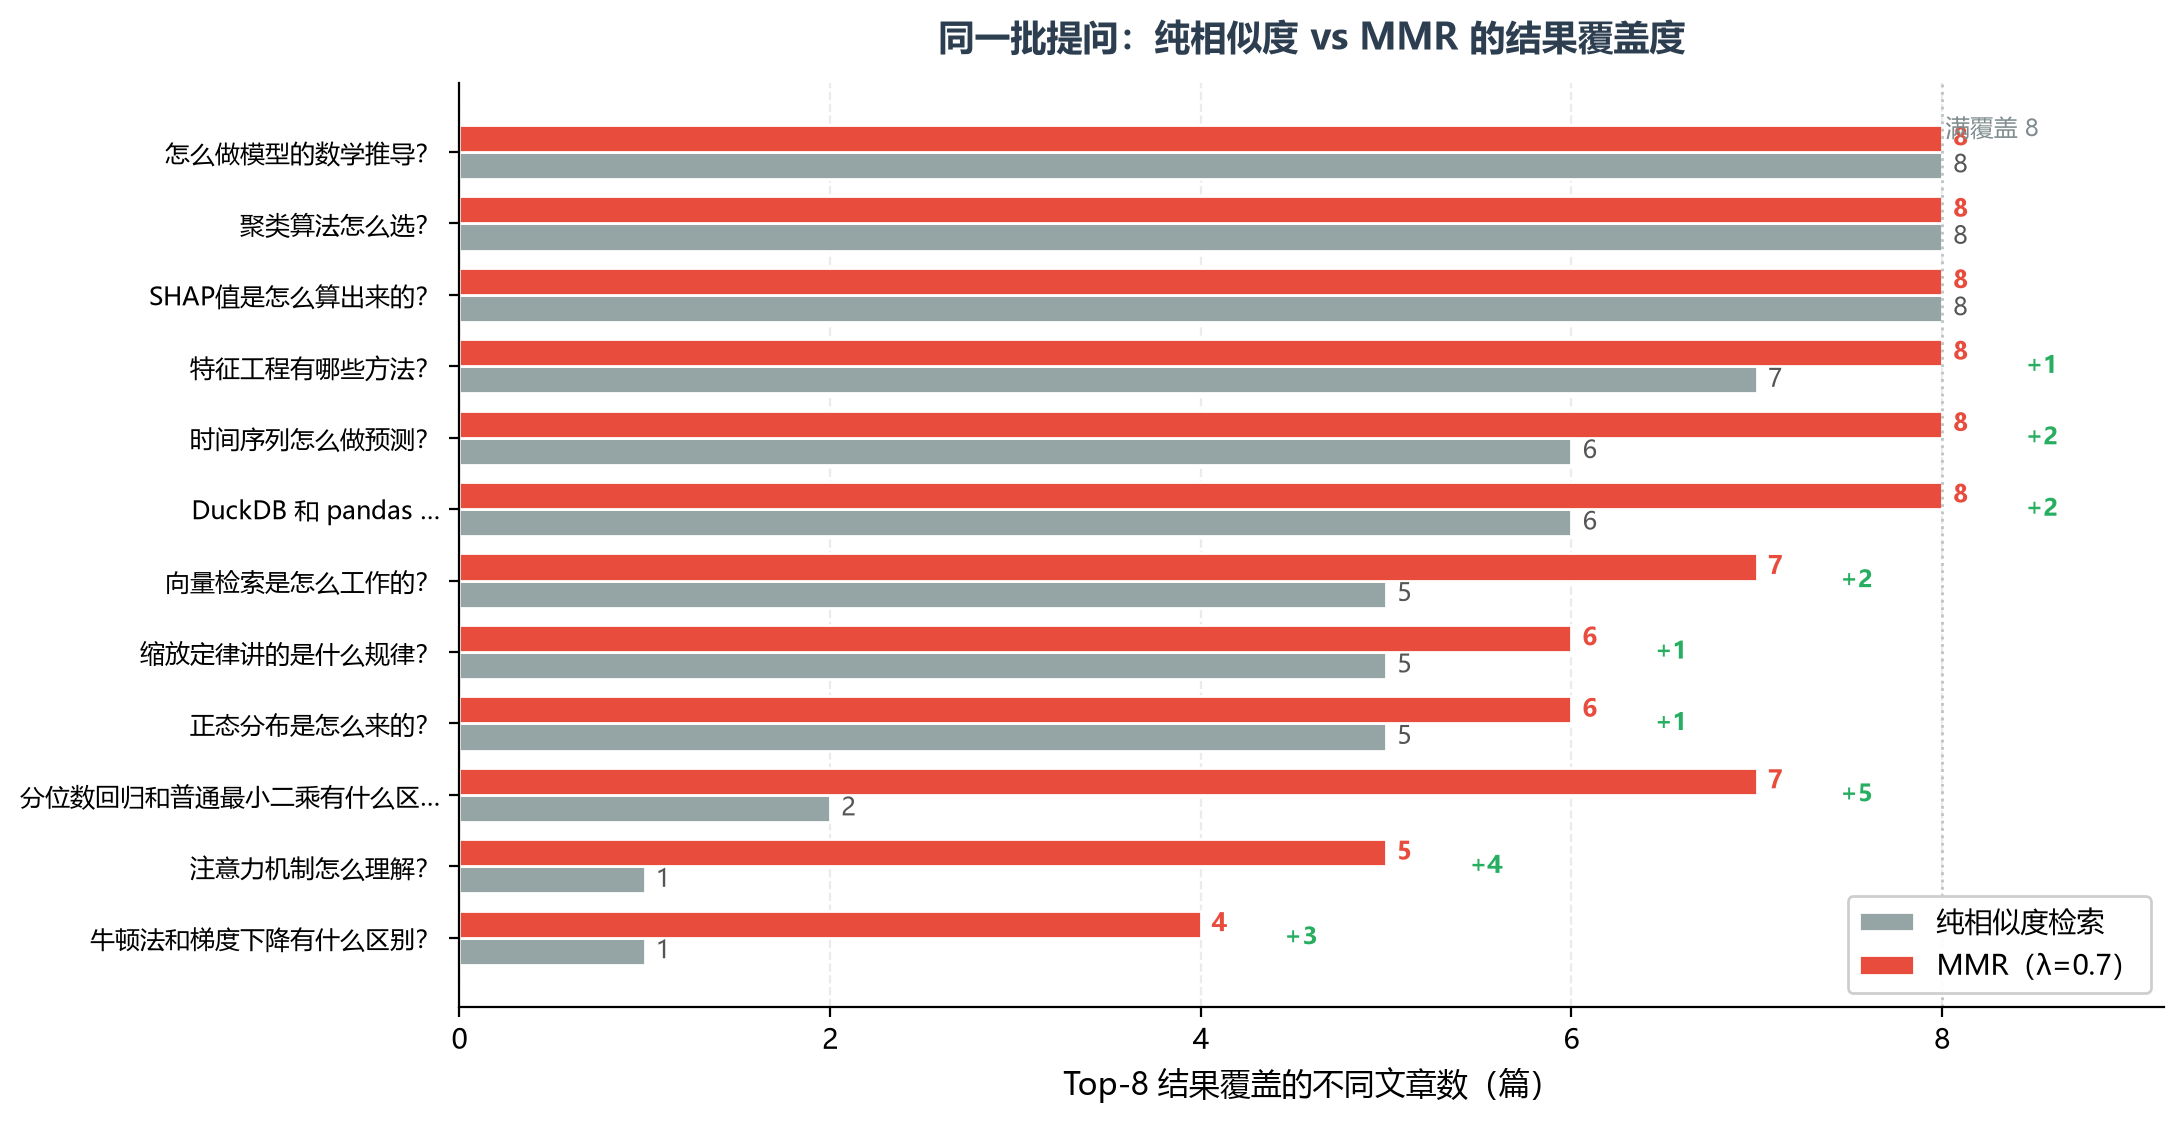
图 1:12 个提问上,两种检索方式覆盖的不同文章数。红柱是 MMR,右侧绿字是提升量。
03 数学:相似度排序为什么会扎堆
3.1 余弦相似度在量什么
文本块编码成向量之后,比较两个向量最常用的办法是余弦相似度:
分子是内积,分母是两个向量的模长之积。这个式子做的事是:把两个向量的长度除掉,只留夹角。
- 内积
,也就是"一个向量在另一个向量方向上的投影长度 × 另一个的模长" - 除以
之后,长度信息被消掉,剩下的 只反映方向差异 的取值范围是 ,越接近 1 表示两个向量指向越接近的方向
向量检索干的事情就是:算每个文本块和问题的
3.2 扎堆的数学解释
假设文本块 A 和 B 来自同一篇文章的相邻段落。它们主题相同,编码后的向量方向也几乎相同,于是:
现在算它们与问题
A 排进前 K 名时,B 也一定在里面。同一篇文章的其他段落同理。它们以"整篇文章"为单位一起挤进榜单。
前 8 名全来自同一篇,原因就在这里。
04 MMR 的解法:给"像自己人"加惩罚
MMR(Maximal Marginal Relevance,最大边际相关性)的做法是:挑选时同时看两件事——和问题像不像,以及和已经选中的结果像不像。
设已选集合为
逐项看:
| 项 | 含义 | 作用 |
|---|---|---|
| 这篇和问题的相似度 | 奖励相关性 | |
| 这篇和"已选中里最像的那个"的相似度 | 惩罚重复 | |
| 两者的权重 | 调节偏向 |
第一项原本就有。第二项是新增的:它量的是"这篇如果要进来,会和已经选中的哪个撞脸"。取最大值的意思是,只要和任何一个已选结果很像,就要被扣分。
4.1 为什么取最大值,不取平均
这处设计容易被忽略。假设已选集合里有两篇,
- 用平均值:
,惩罚被稀释掉了 - 用最大值:
,惩罚保持完整
要防的是"和某一篇撞得很厉害"这种情况。平均值会把它放过,最大值不会。
4.2 λ 的两端
| λ | 目标函数 | 退化为 |
|---|---|---|
| 只剩 | 就是原来的 Top-K 相似度检索 | |
| 只剩 | 挑与已选结果最不像的那个(最远点采样) |
MMR 是这两种排序的一般化。工程上
4.3 一个它做不到的情况
读到这儿容易以为 MMR 能压掉所有重复。实际惩罚项有上界:
因为
如果某篇文档与问题的相似度远超其他候选,它被扣掉 0.3 分之后仍然排第一。我实测碰到过一次:3 个文本块与问题的相似度约 0.998,另两块只有 0.068,差距 0.93。此时交换它们带来的相关性损失是:
换来的去重收益最多 0.3。0.65 > 0.3,MMR 不会换。实测确实如此——它只调整了顺序,那 3 篇几乎一样的结果仍然都在。
打破这个局面有两条路:把
这个边界值得记一下,触发条件很具体:检索结果呈现"一篇遥遥领先、其余明显更低"的形态时,MMR 帮不上忙。
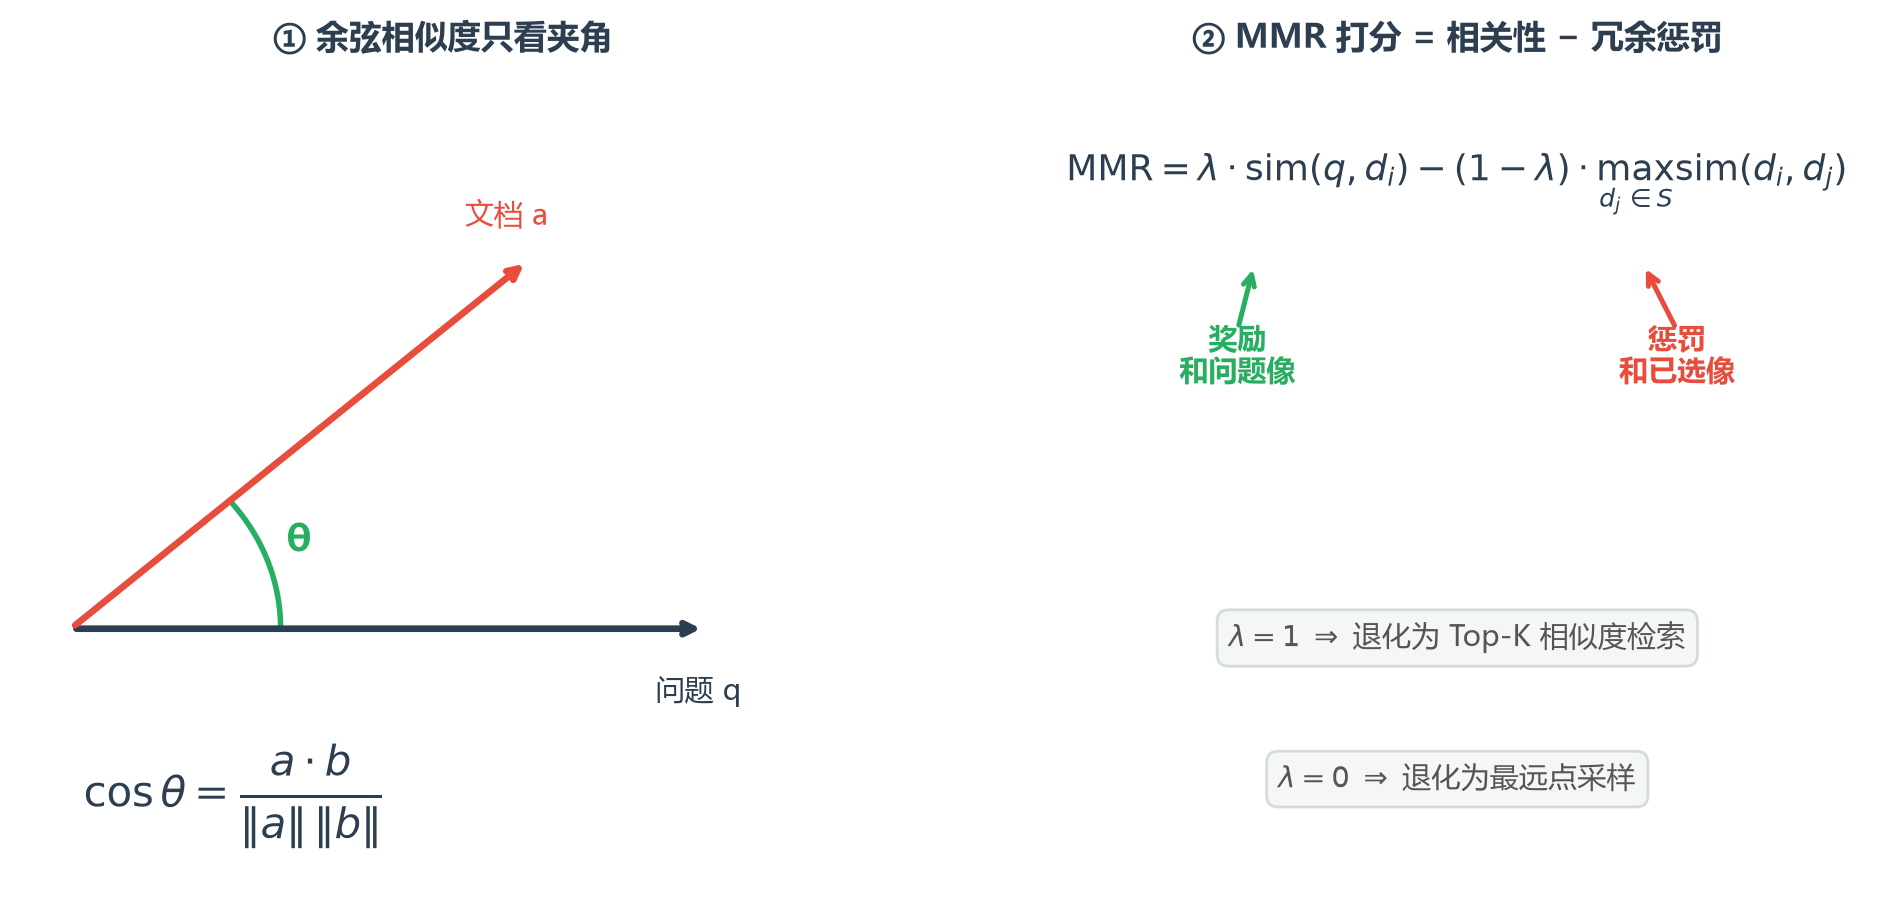
图 2:左为余弦相似度的几何含义(只看夹角),右为 MMR 的打分构成(相关性减去冗余惩罚)。
05 贪心为什么有理论保证
MMR 是逐条挑的:挑出第一条,再挑第二条,每次只做局部最优选择。这种贪心策略凭什么可靠?
5.1 直接求最优是难的
不用贪心的话,就要从
取
5.2 子模性:贪心可行的前提
函数
翻译一下:往小集合里加东西,收益比往大集合里加更大。 好比往空房间摆家具,第一件最改变格局,越往后越难产生质变。
MMR 的目标函数可以写成集合函数的差:
5.3 (1−1/e) 从哪来
子模函数最大化有一个经典结论(Nemhauser 等,1978):对单调子模函数最大化问题,贪心算法得到的解不小于最优解的
逐条贪心挑出来的结果,至少能达到理论最优的 63.2%。这个数字不依赖数据分布,是结构决定的。
实际工程里贪心的表现通常明显好于这个下界。但对写代码的人来说,这个保证的意义是:有一个不会更差的下限。
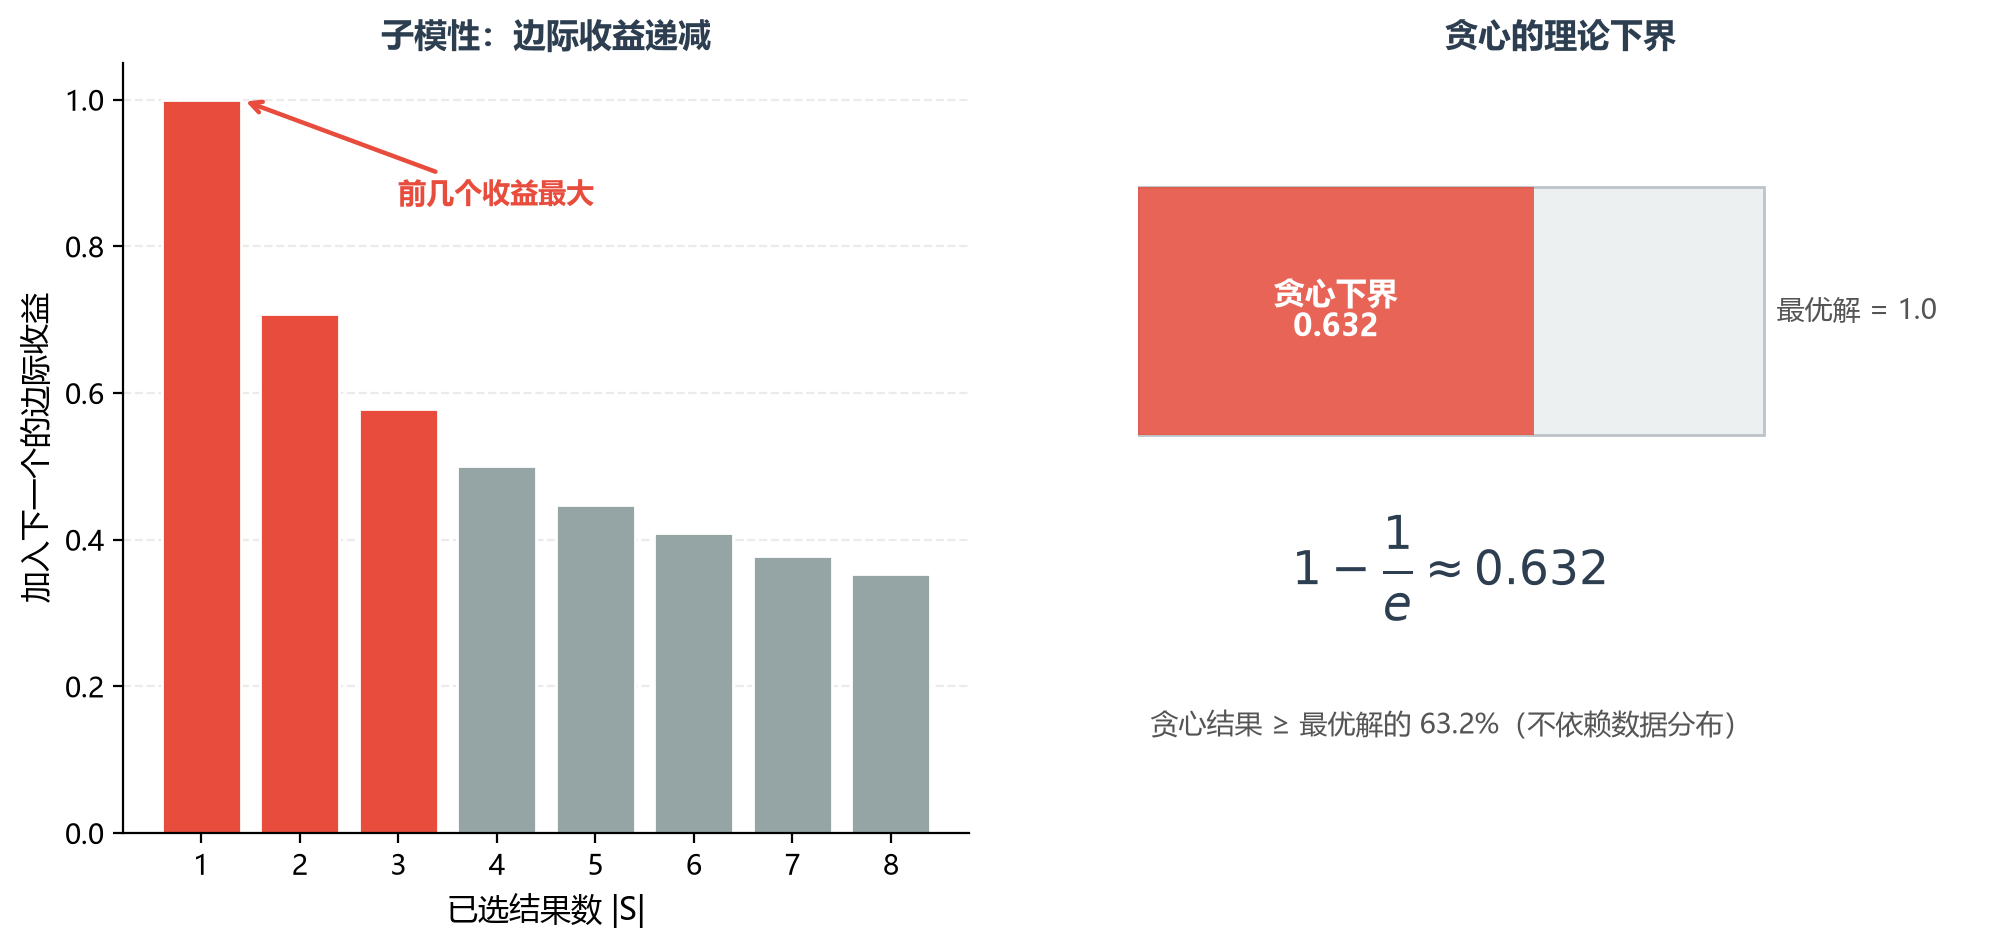
图 3:左为子模函数的边际收益递减性质,右为贪心算法的 (1−1/e) ≈ 63.2% 下界。
06 实测:λ 该怎么调
理论只说了"用 max 惩罚"和"贪心有保证",没说
| λ | 平均相关度 | 覆盖文章数 | 结果内最大相似 |
|---|---|---|---|
| 1.0 | 0.609 | 5.17 | 0.803 |
| 0.9 | 0.609 | 5.42 | 0.794 |
| 0.8 | 0.605 | 6.00 | 0.767 |
| 0.7 | 0.598 | 6.92 | 0.733 |
| 0.6 | 0.582 | 7.67 | 0.686 |
| 0.5 | 0.570 | 7.75 | 0.641 |
| 0.3 | 0.559 | 7.67 | 0.618 |
| 0.1 | 0.556 | 7.67 | 0.611 |
| 0.0 | 0.554 | 7.67 | 0.611 |
三个位置值得看:
λ=0.9 几乎白送。 相关度 0.609 一动不动,覆盖从 5.17 涨到 5.42。把权重稍微往多样性偏一点,不花任何代价。
λ=0.7 是性价比拐点。 相比 λ=1.0,相关度从 0.609 掉到 0.598(−1.9%),覆盖从 5.17 涨到 6.92(+33.9%)。用 1.9% 换 33.9%,这笔账划算。
λ≤0.5 之后覆盖触顶。 从 0.5 降到 0.0,覆盖停在 7.67 不再涨,相关度却还在掉(0.570→0.554)。这段区间是纯亏。
调参结论:从 λ=0.7 起步,需要更宽就降到 0.6,不要低于 0.5。
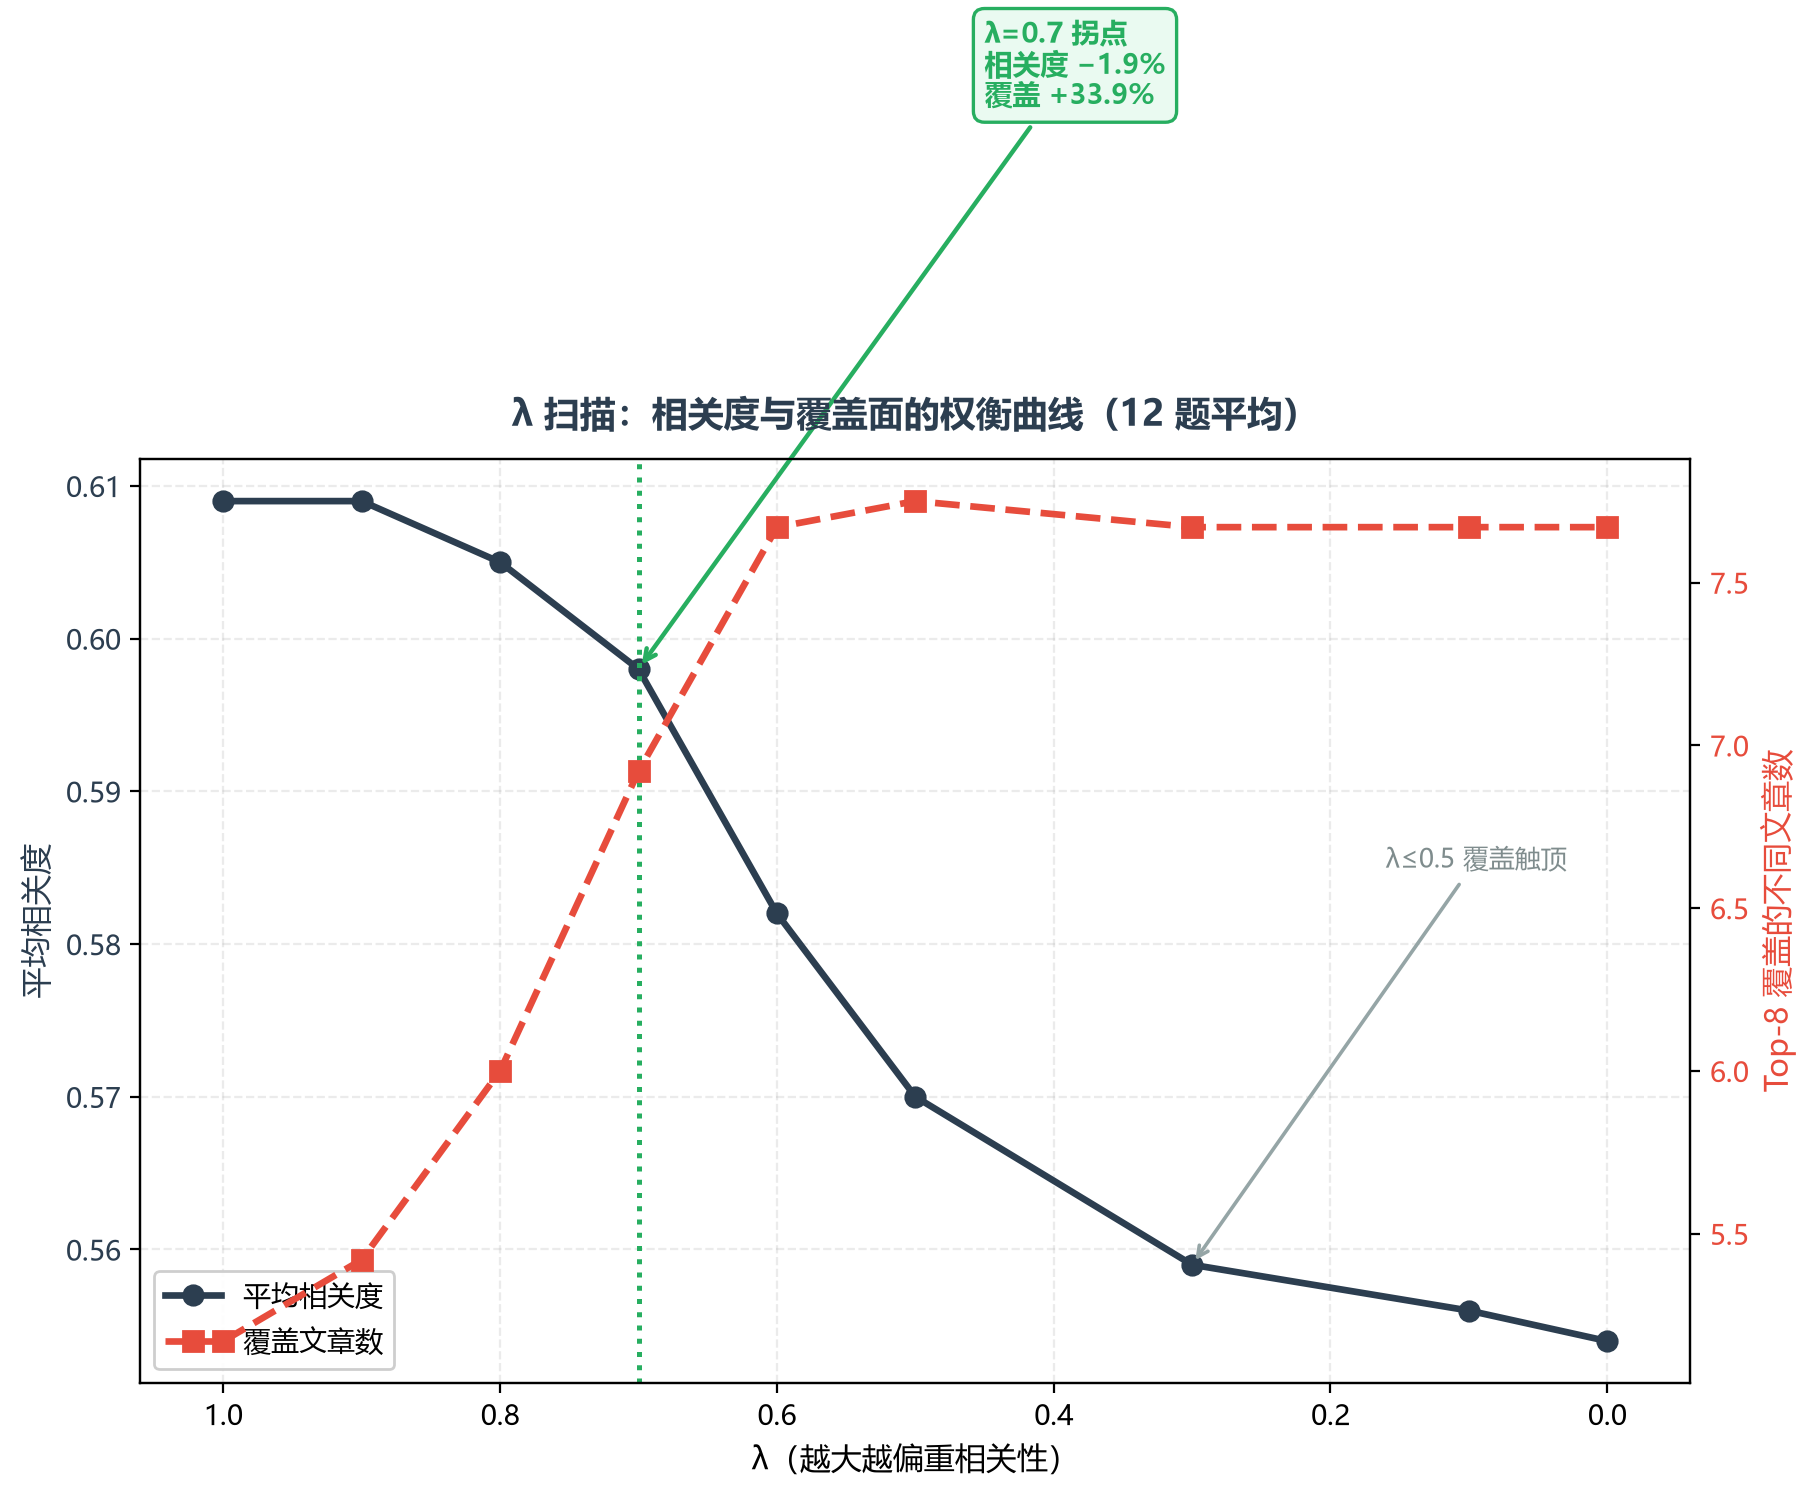
图 4:λ 从 1.0 降到 0.0 的完整权衡曲线。绿点标出 λ=0.7 的拐点位置。
6.1 逐题看:MMR 在哪几道题上救场
平均值会盖住细节。12 个提问里,MMR 收益最大的几道是:
| 提问 | 纯相似度覆盖 | MMR 覆盖 | 提升 |
|---|---|---|---|
| 分位数回归和 OLS 有什么区别? | 2 / 8 | 7 / 8 | +5 |
| 注意力机制怎么理解? | 1 / 8 | 5 / 8 | +4 |
| 牛顿法和梯度下降有什么区别? | 1 / 8 | 4 / 8 | +3 |
| 向量检索是怎么工作的? | 5 / 8 | 7 / 8 | +2 |
| 时间序列怎么做预测? | 6 / 8 | 8 / 8 | +2 |
收益最大的都是"有一篇特别对口"的提问。这种时候纯相似度最容易被单篇包场,而 MMR 把位置让给了讲同一主题的其他文章。
也有收益为零的:
| 提问 | 纯相似度覆盖 | MMR 覆盖 |
|---|---|---|
| 聚类算法怎么选? | 8 / 8 | 8 / 8 |
| 怎么做模型的数学推导? | 8 / 8 | 8 / 8 |
| SHAP 值是怎么算出来的? | 8 / 8 | 8 / 8 |
这些提问的答案本来就分散在多篇文章里,Top-8 天然不重复,MMR 没活可干。它也不会把结果弄差(相关度基本持平)。
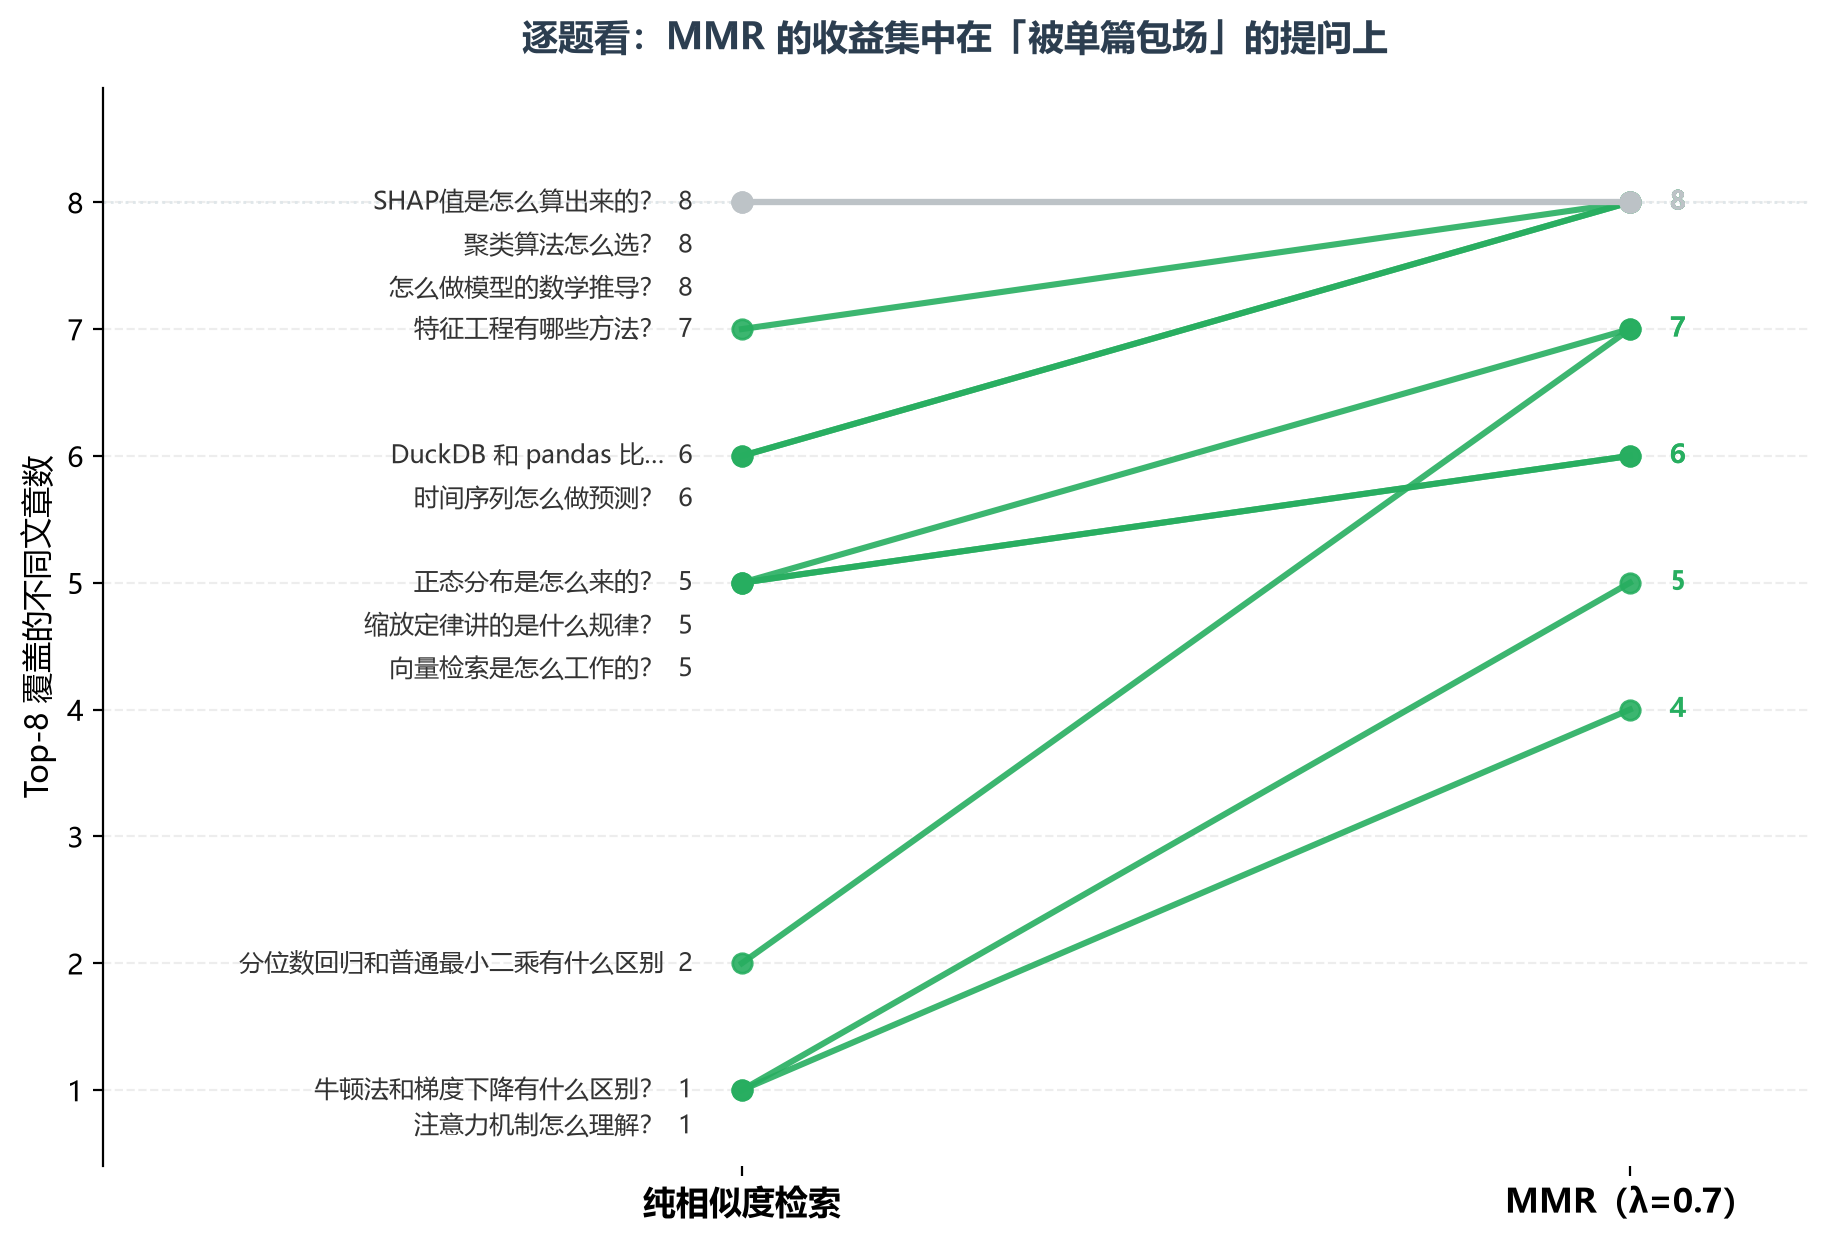
图 5:每道题的覆盖数变化。绿线是有提升的,灰线是本来就满覆盖、MMR 不动它。
07 代码:LangChain 里怎么用
LangChain 的向量库接口内置了 MMR。以 FAISS 为例:
python
from langchain_community.vectorstores import FAISS
from langchain_community.embeddings import FastEmbedEmbeddings

# 1. 本地 embedding(不联网)
emb = FastEmbedEmbeddings(model_name="BAAI/bge-small-zh-v1.5")

# 2. 建库:docs 是切好的文本块
vs = FAISS.from_documents(docs, emb)

# 3. 纯相似度检索(对照组)
plain = vs.similarity_search(query, k=8)

# 4. MMR 检索
mmr = vs.max_marginal_relevance_search(
    query,
    k=8,                      # 最终返回条数
    fetch_k=40,               # 先取 40 个候选,再从中做 MMR 挑选
    lambda_mult=0.7,          # λ,越大越偏重相关性
)
三个参数里 fetch_k 最容易被漏掉:MMR 是从一个更大的候选池里挑,池子太小就没什么可挑的。经验值是 fetch_k ≥ 5×k。
7.1 想自己实现的话
MMR 的核心逻辑不长,理解它比调库更有用:
python
import numpy as np

def mmr_select(query_vec, doc_vecs, k=8, lam=0.7):
    """doc_vecs 已归一化,query_vec 也已归一化 → 点积即余弦相似度"""
    sim_q = doc_vecs @ query_vec              # 每篇与问题的相似度
    picked, cand = [], list(range(len(doc_vecs)))
    while len(picked) < k and cand:
        if not picked:
            best = max(cand, key=lambda i: sim_q[i])       # 第一条:纯相关性
        else:
            sel = doc_vecs[picked]
            red = (doc_vecs[cand] @ sel.T).max(axis=1)      # ★ 与已选的最相似者
            score = lam * sim_q[cand] - (1 - lam) * red
            best = cand[int(np.argmax(score))]
        picked.append(best)
        cand.remove(best)
    return picked
核心就是那句 max(axis=1),对应第 04 节说的"用最大值而非平均"。
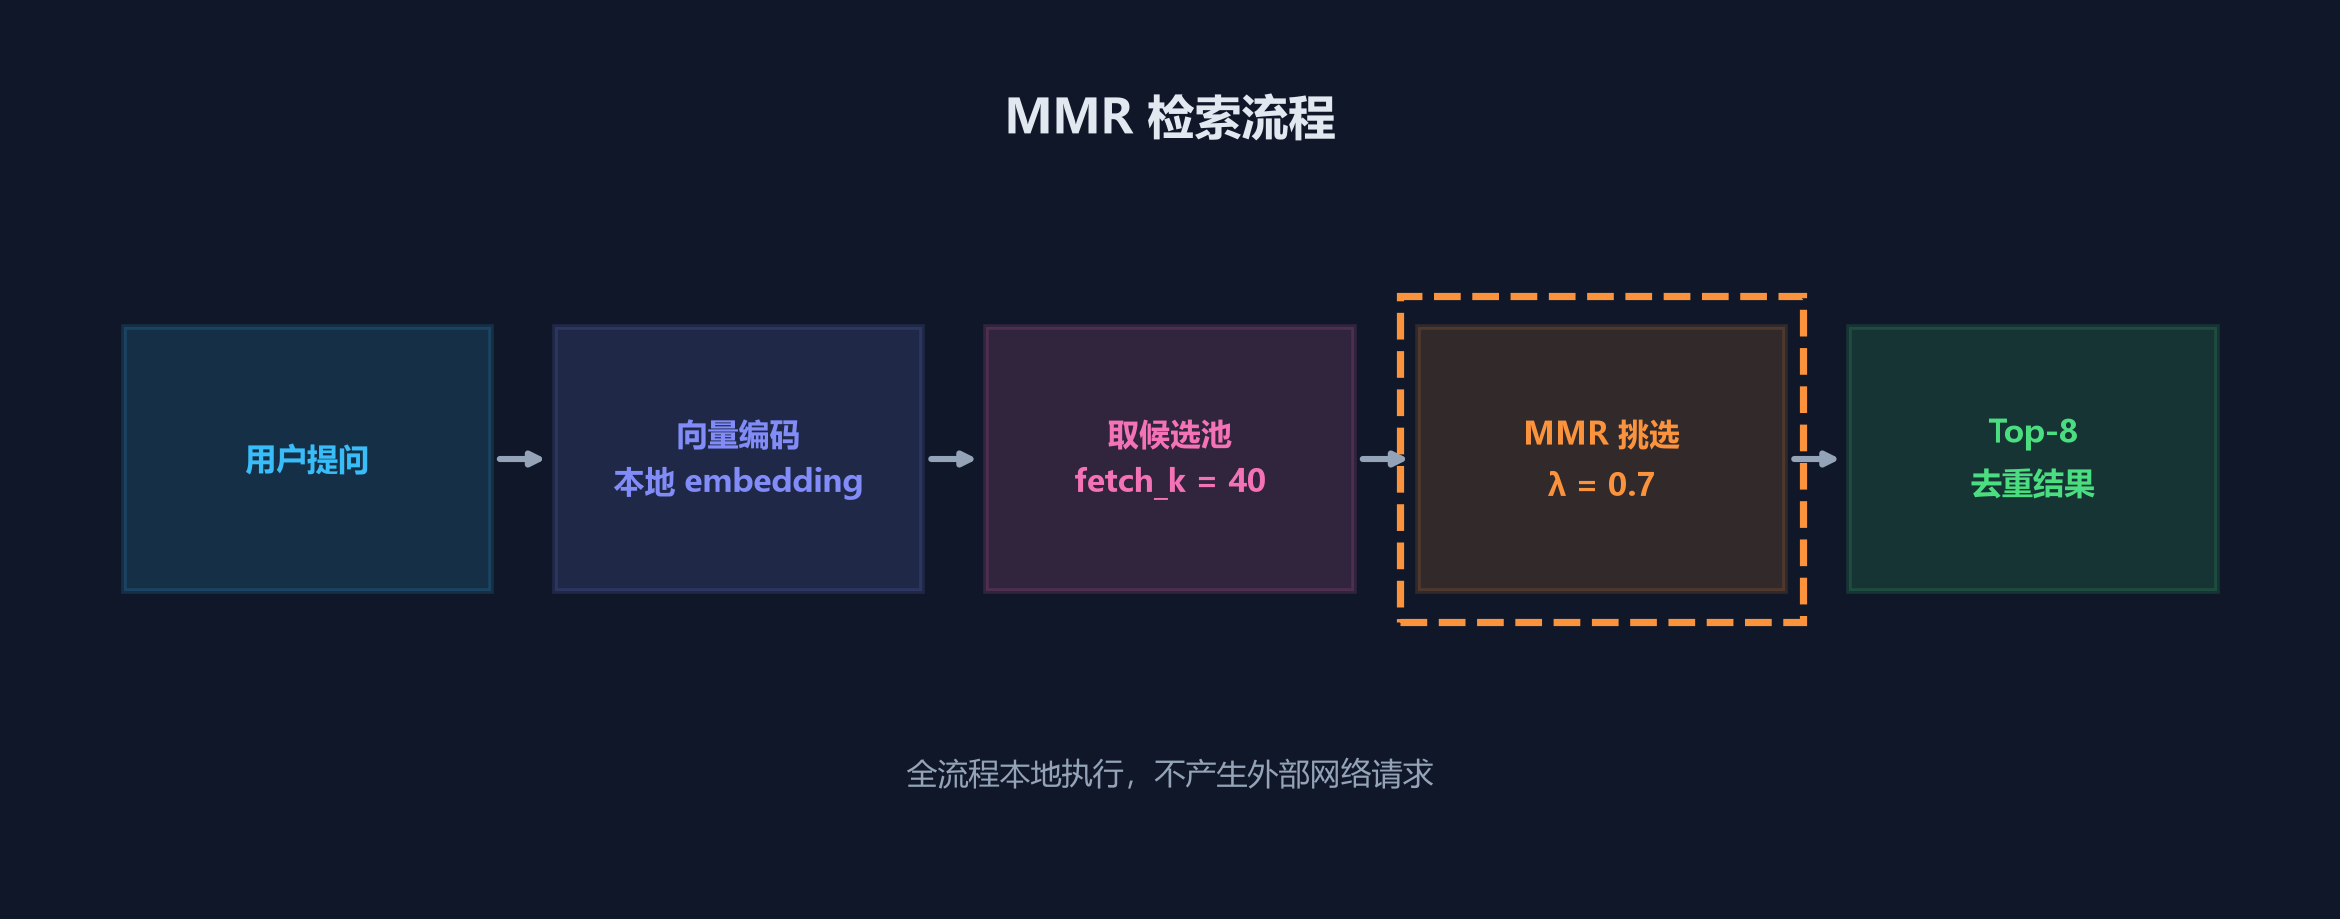
图 6:完整检索链路。MMR 位于排序环节,整条链在本地执行。
7.2 一个容易踩的实现细节
向量库返回的通常是距离(越小越近)。余弦相似度是反过来的,越大越近。自己实现时方向弄反,惩罚项会起反作用。稳妥的做法是先把所有向量归一化,这样点积就等于余弦相似度,不用再区分距离和相似度。
08 什么时候别用 MMR
三种情况不建议上:
有唯一正确答案的检索。 比如"某函数怎么调用",你只想要最准确那一条,不需要它跟别的结果不一样。这种场景 Top-1 就是最优解,MMR 反而会把次要结果提上来。
语料本身不重复。 每篇文档讲的东西都不同时,MMR 的惩罚项几乎不起作用,白花计算。判断办法很简单:跑一遍纯相似度看覆盖数,如果稳定在 8/8 附近,就不用换。
λ 定得过低。 从第 06 节的曲线看,λ 低于 0.5 之后覆盖不再涨、相关度继续掉。结果会变成"什么都有一点,但没一条特别对",更难用。
09 落到你自己的系统上
如果你也在用向量检索,可以按这个顺序动手:
- 先量基线。 准备 10–20 个真实提问,记录每次 Top-K 结果里出现了几篇不同文档。这是最便宜的诊断——覆盖数普遍在 7 以上,说明问题不在排序。
- 加 MMR,λ 从 0.7 起步。 对比同一批提问的覆盖数和相关度,重点看相关度掉了多少。掉 2% 以内、覆盖涨 20% 以上,就值得上。
- 把
fetch_k设成5×k以上。 候选池太小时 MMR 无从挑选,效果会打折扣。
最后收个尾。检索系统的默认行为是"谁最像就给谁",这会让最对口的那篇文章独占榜单。MMR 没改相似度的算法,只在挑选时加了一个惩罚项——和已选结果撞脸的要扣分。数学上它是子模函数最大化,贪心有