4120 万行数据,DuckDB 用 1.2 秒,pandas 为什么连 4.8GB 内存都装不下
我拿到一份纽约市官方公开数据:2024 年全年黄色出租车行程记录,12 个 parquet 文件,4120 万行、19 列、硬盘上 661MB。
这份数据有个好处——它足够大,大到能让一台 4.8GB 内存的机器把不同跑法的差距暴露出来;又足够公开,任何人都能下载复现。
我想做的实验很简单:同一份数据、同一个聚合口径,换不同的读法,看时间和内存差多少。
口径统一成一句话:算出行数、平均载客里程、以及刷卡支付(payment_type=1)的占比。三个数字,四个跑法都要算出来。
先说结论:四个跑法给出同一个答案
这是做对照实验的前提,所以我把它放在第一步——如果四个跑法算出的数不一样,后面的性能比较就没有意义。
结果是:
(41169720, 4.9761, 73.9674)四个能跑完的跑法,输出一字不差。4120 万行、平均 4.9761 英里、刷卡占 73.9674%。数据没错、口径没错,接下来比时间才有意义。
四个跑法,四条代码
我把每条跑法的核心代码原样贴出来,你可以直接对照。
A 跑法:DuckDB 直接对 parquet 聚合
python
import duckdb

duckdb.sql("""
    select count(*) n,
           round(avg(trip_distance), 4) avg_dist,
           round(100.0 * sum(case when payment_type = 1 then 1 else 0 end)
                 / count(*), 4) card_pct
    from read_parquet('/data/nyc-taxi/yellow_tripdata_2024-*.parquet')
""").fetchall()[0]注意这里没有"读进来"这个动作。read_parquet 是个表函数,DuckDB 在扫描文件的同时做聚合,只在内存里保留聚合中间状态。
B 跑法:pandas 只读 2 列
python
import pandas as pd, glob

df = pd.read_parquet(
    glob.glob('/data/nyc-taxi/yellow_tripdata_2024-*.parquet'),
    columns=['trip_distance', 'payment_type'])

n = len(df)
print((n, round(df.trip_distance.mean(), 4),
       round(100.0 * (df.payment_type == 1).sum() / n, 4)))
columns= 这个参数是关键——它只取需要的两列,其余 17 列不读。这也是最常见的"我只要两列"写法。
C 跑法:pandas 一次读全表
python
import pandas as pd, glob

df = pd.read_parquet(glob.glob('/data/nyc-taxi/yellow_tripdata_2024-*.parquet'))
print(df.shape)
不传 columns,19 列全要。这是最省事的写法,也是我这台机器跑不完的那个。
D 跑法:pandas 一次读一个月,循环 12 次
python
import pandas as pd, glob

tot, s, card = 0, 0.0, 0
for f in sorted(glob.glob('/data/nyc-taxi/yellow_tripdata_2024-*.parquet')):
    df = pd.read_parquet(f)          # 注意:这里没有 columns=
    tot  += len(df)
    s    += df.trip_distance.sum()
    card += int((df.payment_type == 1).sum())
    del df                            # 关键:这一批用完就放掉
print((tot, round(s / tot, 4), round(100.0 * card / tot, 4)))
D 跑法和 C 跑法唯一的区别是:D 每次只拿一个月,算完就 del 掉。列数一样(都是全 19 列)、数据一样、总量一样。
实测数字
每跑法重复 3 次取中位数,内存取 /usr/bin/time -v 的 Maximum resident set size:
| 跑法 | 耗时 | 峰值内存 | 结果 |
|---|---|---|---|
| A · DuckDB 直接聚合 | 1.20 s | 71 MB | ✅ 一致 |
| B · pandas 只读 2 列 | 2.83 s | 1678 MB | ✅ 一致 |
| C · pandas 一次读全表 | 跑不完 | — | ❌ 被内核杀掉 |
| D · pandas 分 12 批读 | 14.83 s | 1496 MB | ✅ 一致 |
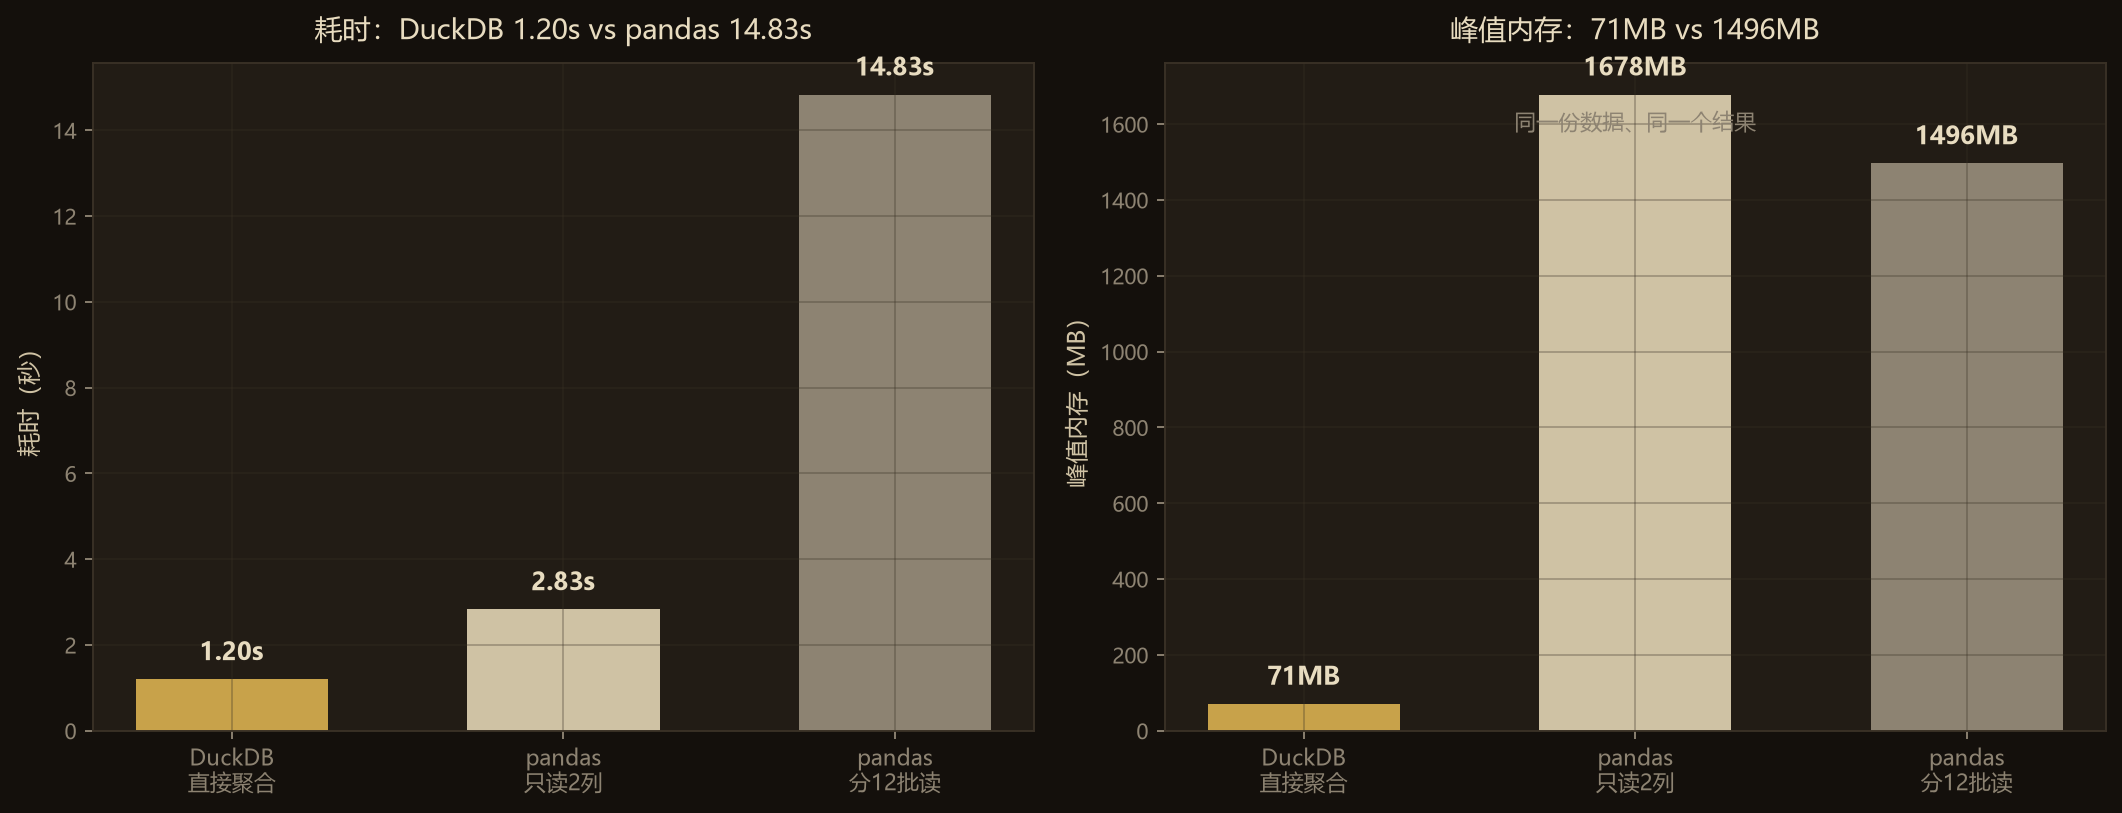
:::num 1.20s|DuckDB 扫描 4120 万行并聚合,峰值内存仅 71MB
:::num 3次|C 跑法连续三次都被系统杀掉,从未产出结果
C 跑法:它根本没跑完
这一栏我没填数字,因为它没有数字可填。三次尝试全部被系统杀掉,rc=-15(SIGTERM)。
内核日志是这么写的:
oom-kill:constraint=CONSTRAINT_MEMCG
Memory cgroup out of memory: Killed process 191955 (python)
CONSTRAINT_MEMCG 这个标记值得留意——它区别于"内存不够用导致交换",指向的是进程所属的内存组撞到了硬上限,内核按规则把它清理掉。python 进程被杀时,匿名内存已经用到 1.46GB,还在往上涨。
这里有个容易搞混的地方:"我的机器有 4.8GB,19 列数据总共 661MB,怎么会装不下?"
因为 parquet 是压缩列式存储,661MB 只是磁盘上的样子。读进内存要变成未压缩的列对象——字符串列要变成 Python 对象、时间戳要变成 64 位整数。膨胀倍数通常在 10 倍以上。
内存到底被什么决定
上面只有四个点,看不出规律。所以我补了一组扫描:固定一个月的数据(296 万行),分别读 1、2、4、8、12、19 列,测峰值内存。
| 列数 | 耗时 | 峰值内存 |
|---|---|---|
| 1 | 1.48 s | 158 MB |
| 2 | 1.52 s | 226 MB |
| 4 | 1.67 s | 340 MB |
| 8 | 2.01 s | 526 MB |
| 12 | 2.10 s | 714 MB |
| 19 | 2.34 s | 1059 MB |
这六个点几乎落在一条直线上。做最小二乘拟合:
RSS = 126.2 MB + 49.27 MB × 列数 (R² = 0.9989)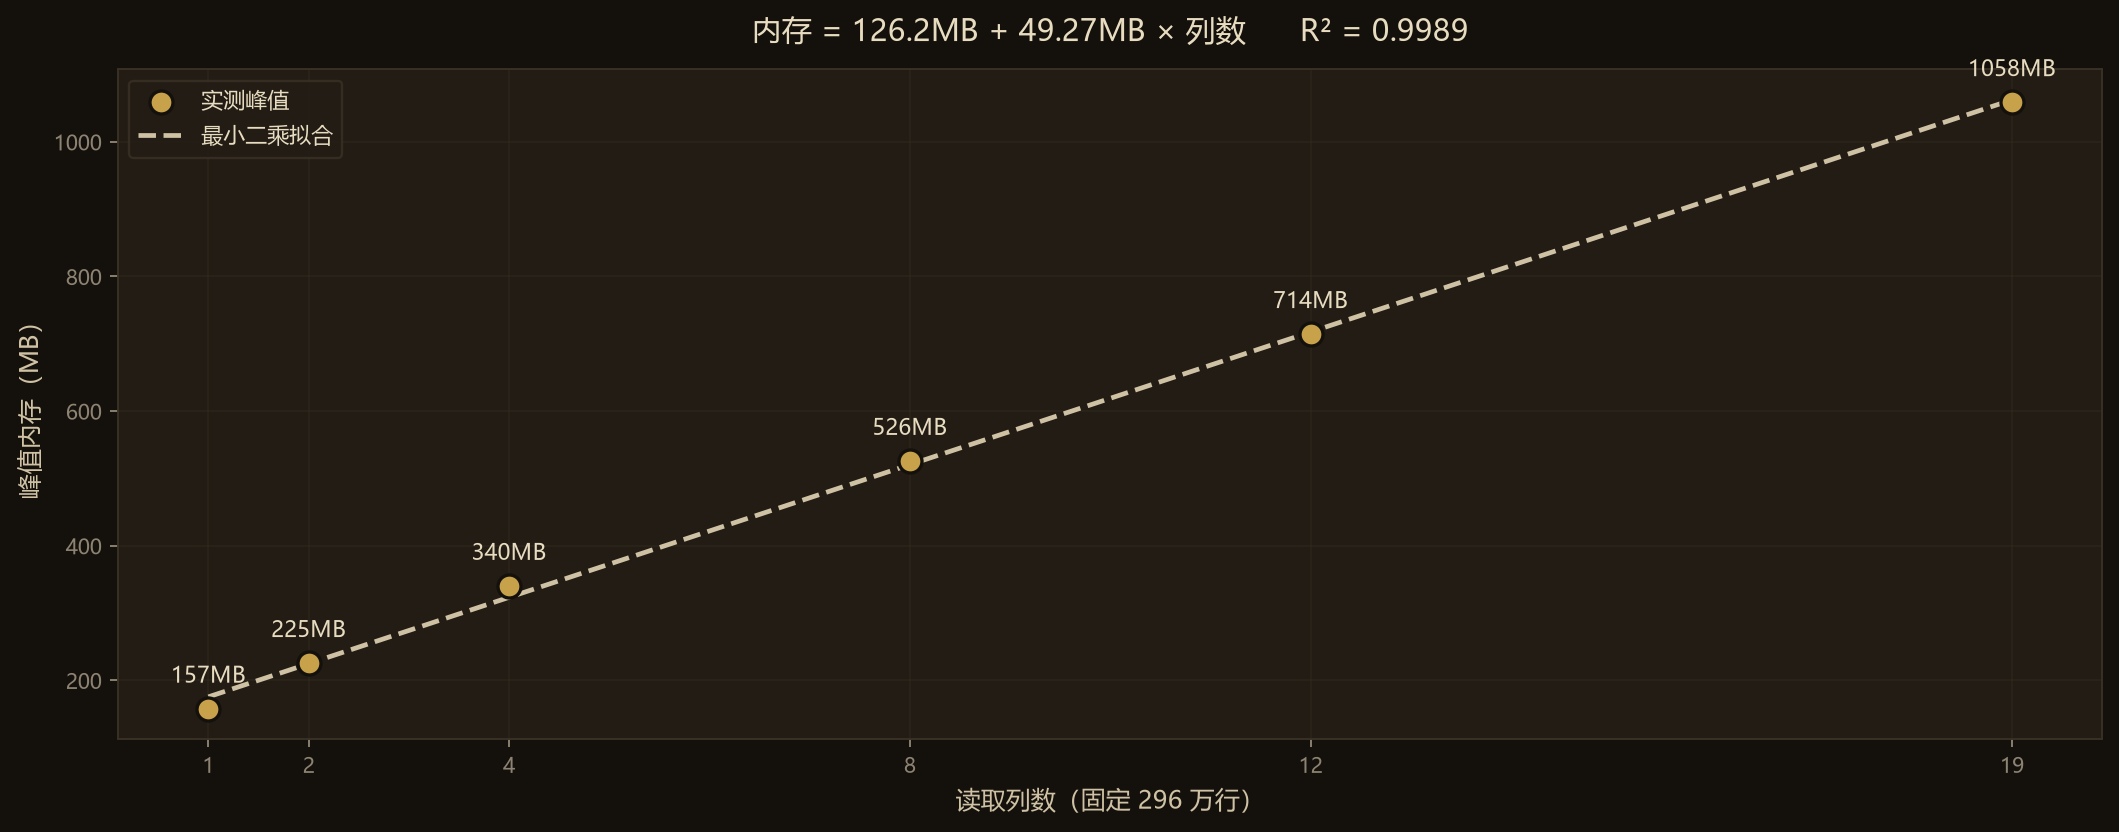
R² = 0.9989 说明这条线解释得很好。它给出两个可用的结论:
- 起步价 126MB —— 光启动 pandas、加载 parquet 引擎、建立基础结构的固定开销
- 每加一列 49.27MB —— 在这个行数级(296 万行)下,每多要一列的边际成本
顺着这条线往下推:单月 19 列已经要 1059MB,而全年是 13.9 倍的行数(4120 ÷ 296)。如果内存随行数近似线性增长,一次装下全年 19 列大约需要 14.4GB。
这解释了 C 跑法为什么必然失败——4.8GB 的机器不可能装下它,差的不是一点半点。
那"分 12 批"为什么就装得下
这是这篇文章真正的重点。
D 跑法和 C 跑法读的是同样多的数据(都是 4120 万行 × 19 列),唯一的差别是内存里同时存在多少:
- C 要同时装下 12 个月 = 撑爆
- D 每次只装 1 个月,算完
del掉再读下一个 = 峰值永远只有 1 个月的量
所以 14.83 秒换来的是内存需求从 14.4GB 降到 1.5GB,降了大约 9.6 倍。
代价是时间——D 比 C 慢(如果能测的话),也比 A 慢得多。但 C 根本跑不完,所以真正的选择是在 A 和 D 之间。
A 是最优解:1.20 秒、71MB,因为 DuckDB 压根不需要把数据装进内存。D 是通用兜底:你手上的工具就是 pandas、换不了,那分批读就是让它在有限内存里跑完全量数据的办法。
最小可用内存:实测出来是多少
上面用的是峰值内存。但更实用的问题是:我得给这台机器留多少内存,它才跑得完?
这就得用内存上限去压。我用 cgroup(MemoryMax=)逐档往下压,记录"还能跑通的最小档"和"第一个失败的档":
| 跑法 | 最小可用上限 | 该档峰值 | 第一个失败档 |
|---|---|---|---|
| A · DuckDB | 150 MB | 70.8 MB | 未失败 |
| B · pandas 2 列 | 1800 MB | 1671.5 MB | 1600 MB |
| D · pandas 分 12 批 | 1500 MB | 1464.5 MB | 1200 MB |
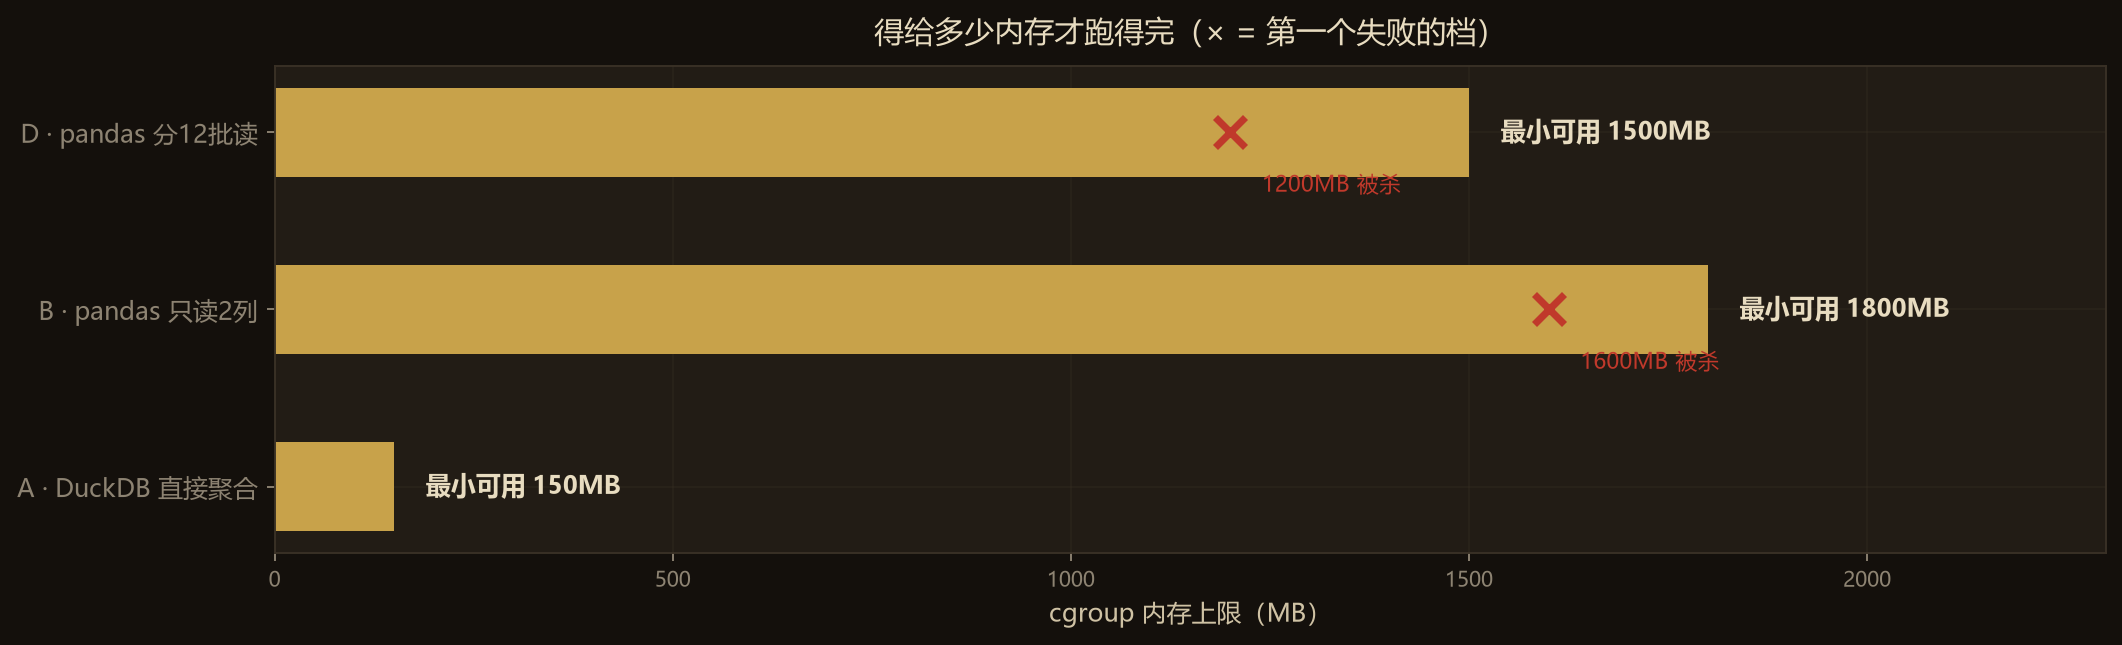
A 跑法最夸张:150MB 上限就够它扫完 4120 万行(还能再往下压,只是我没继续试)。这是因为它压根不落地。
这里有个反直觉的点值得说清:B 跑法的峰值内存是 1671.5MB,但它需要 1800MB 的上限才跑得通。 差了约 130MB。
原因是 cgroup 统计的 memory.current 包含可以被回收的 page cache(读 parquet 时落在缓存里的文件页),而 /usr/bin/time -v 报的 RSS 不含这部分。所以压内存时,实际要留的安全余量比峰值 RSS 更大——这也是我把最小可用上限单独测一遍、不直接拿峰值当阈值的原因。
回到你自己的数据
这份公开数据可以换成人家的任何表,结论是一致的。但有几个可操作的点:
第一,先看列。 上面的每列 49.27 MB 是这台机器上这个行数级测出来的,你自己的数据不一定一样,但列数是你可以直接控制的变量——columns= 只取需要的列,往往是最大的一笔节省。B 跑法只读 2 列(1678MB)和单月全 19 列(1059MB)看着接近,但换到全年量级就是 14.4GB 和 1.5GB 的差别。
第二,一次别拿太多。 如果必须用 pandas 读全量,按文件、按月份、按 ID 区间分批,算完就 del。这算不上"优化技巧",实质是把"内存需求"从「全量」降到「一批」。
第三,压内存时要留余量。 别拿峰值 RSS 当阈值,按实测经验多留 10%~15%。
第四,能交给数据库就别搬进内存。 A 跑法用 150MB 完成的事,pandas 要 1.8GB —— 差 12 倍。这里的关键不在 pandas 好不好,而在它的设计就是"把数据装进内存",而聚合这件事本身不需要装。
复现方式
数据是纽约市 TLC 官方公开数据,下载页一行命令:
bash
for m in 01 02 03 04 05 06 07 08 09 10 11 12; do
  curl -O "https://d37ci6vzurychx.cloudfront.net/trip-data/yellow_tripdata_2024-$m.parquet"
done
本机是 4.8GB 内存的 WSL 环境,Python 3.11 + duckdb 1.5.5 + pandas 2.3.3。所有数字来自脚本实测、3 次重复取中位数;C 跑法的失败有内核 oom-kill 日志为证。原始测量记录连同脚本一起留档,可复跑。
AI 使用说明:本文由 AI 辅助撰写,实验设计、脚本编写与数据核对由作者完成。文中所有性能数字均为本机实测(脚本留档可复跑),未使用任何模拟数据。