浏览器 Agent 怎么让 AI 自己操作网页?我用“QIAN数据”网站实测三种“喂网页”方式
AI 辅助创作
上周想给自己的站加个小助手,让它替我翻文章、找东西。写起来不难,卡住我的是一句话:页面到底以什么形式交给模型。
试了几轮才发现,这事比我预想的要紧得多。同一篇文章,换个交付形式,token 差 4.3 倍,而且有的形式它根本办不成事。
AI 眼里的网页,到底是什么样子?
你打开一个页面,看到的是排版、颜色、按钮位置。模型看到的是一段文字。
这段文字怎么造出来,各家的做法不太一样,常见的四种:
原始 HTML。 直接把页面的完整源码丢给模型。包含了所有脚本、样式、内联数据、类名。
净化 HTML。 去掉 script、style、svg、iframe,属性只留 href、alt、title、aria-label、role 这几个真正有语义的。
无障碍树。 浏览器为屏幕阅读器准备的那套结构。每个可点击的东西带着角色(链接、按钮、输入框)和名字。模型能直接说"点名为『全部文章』的链接",不用猜坐标。
可见文本。 页面上真正显示给人看的字。最省,但丢掉了"哪里能点"的信息。
四种喂法,差多少 token?
我在自己的站点 dataqian.wang 上抓了 12 篇文章页,用 tiktoken 的 o200k_base 分词器数 token。
| 文章(截断) | 原始 HTML | 净化 HTML | 无障碍树 | 可见文本 | raw/text |
|---|---|---|---|---|---|
| KS 与 AUC——单点 vs 积分 | 94,299 | 7,338 | 5,216 | 3,073 | 30.7× |
| 欺诈率 0.1% 的建模战争 | 115,624 | 10,404 | 6,732 | 4,936 | 23.4× |
| Agent 风险评分——12 个维度 | 109,378 | 11,452 | 7,779 | 5,699 | 19.2× |
| 消费贷贴息潮 | 60,837 | 7,295 | 5,586 | 3,600 | 16.9× |
| 多 Agent 合谋 | 75,153 | 11,072 | 6,780 | 5,157 | 14.6× |
| 交易图上的洗钱迷宫 | 54,805 | 7,368 | 6,736 | 3,899 | 14.1× |
| RLHF 与 DPO | 98,190 | 34,891 | 19,908 | 14,560 | 6.7× |
| 月相与经纬度 | 75,302 | 27,691 | 17,462 | 12,858 | 5.9× |
| KV-Cache | 76,200 | 28,646 | 19,103 | 13,162 | 5.8× |
| 门控遗漏定律与设计效应 | 33,746 | 13,425 | 9,358 | 6,442 | 5.2× |
| 开源数据库存储结构研究 | 22,045 | 15,946 | 19,073 | 9,585 | 2.3× |
| 一条风控规则的完整一生 | 22,555 | 16,140 | 18,464 | 10,033 | 2.2× |
| 中位 | 75,227 | 12,438 | 8,568 | 6,070 | 12.4× |
| 均值 | 69,844 | 15,972 | 11,849 | 7,750 | 9.0× |
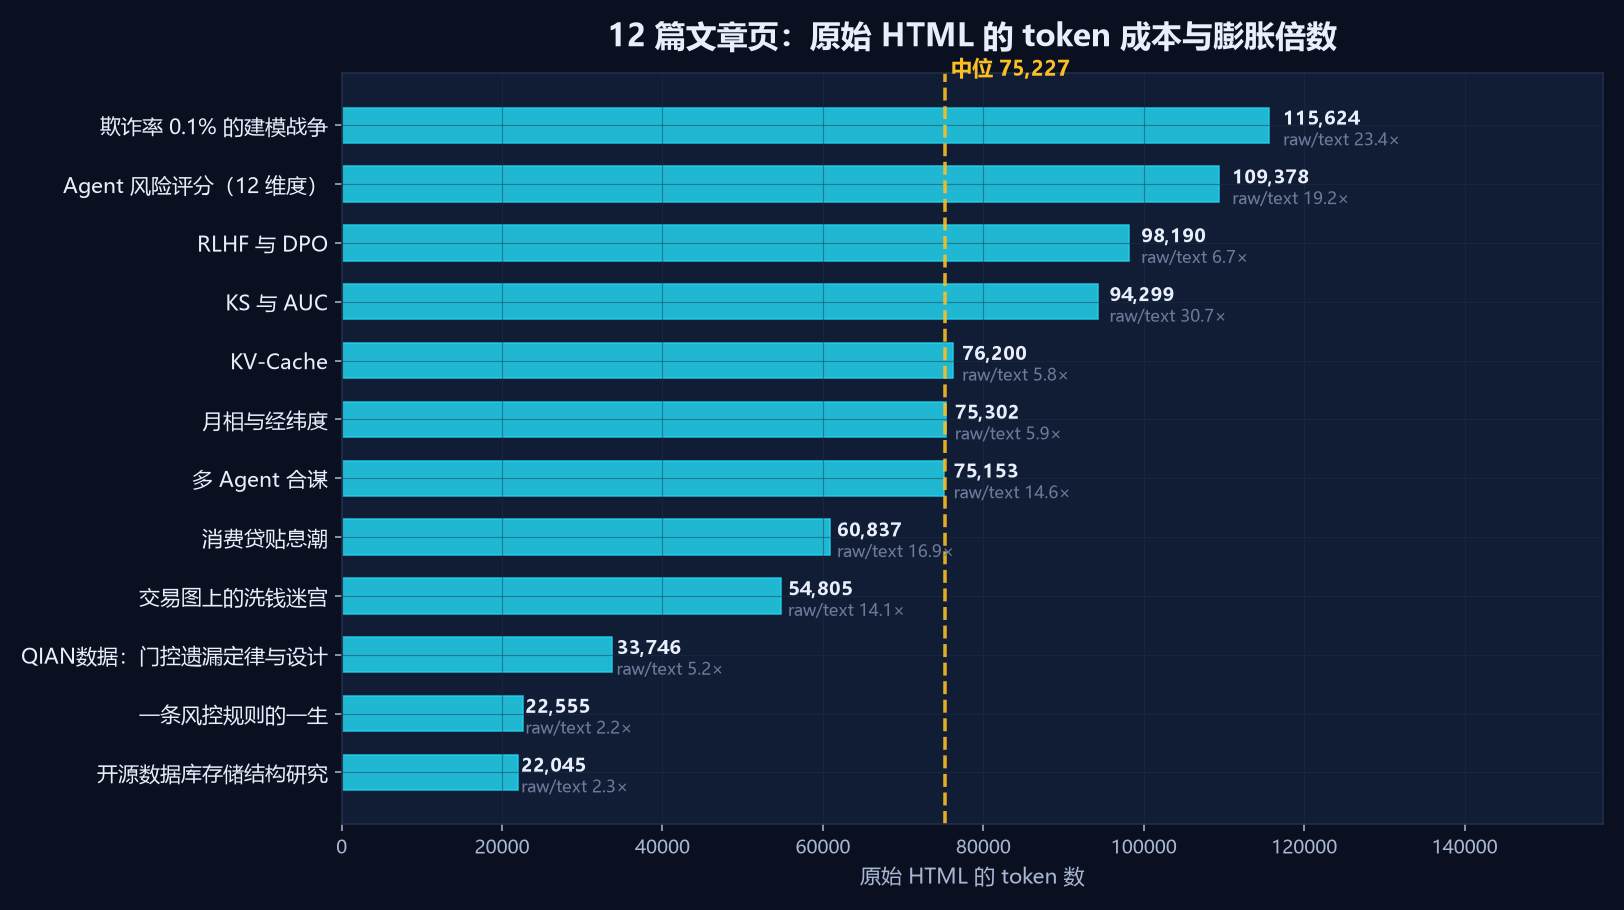
图1:同一站点四种「喂网页」方式的 token 成本(本机实测,tiktoken o200k_base)
12 篇的原始 HTML 中位数是 7.5 万 token,看起来像个固定倍数,但把逐篇的 raw/text 排出来就露馅了:最低 2.2 倍,最高 30.7 倍。
差别来自内容形态,不是站点本身:
- 比例低的一头(2.2×、2.3×)是正文长、公式和代码多的文章。可读文字本身就有近万 token,页面框架那部分相对就不显眼了。
- 比例高的一头(23.4×、30.7×)是"标题短、正文短、但页面元素一样多"的文章。可见文本只有三千出头,框架代码却一点没省,比例就被拉到三十倍。
所以"原始 HTML 浪费多少"没有统一答案。要判断要不要净化,得看你站的页面结构相对正文有多重——正文长、代码多的技术站,裸 HTML 未必离谱;卡片密、正文短的内容站,不净化就是灾难。
净化 HTML 稳定得多:12 篇里中位 1.2 万、最大 3.5 万,没有一篇超过 4 万。它把随页面结构膨胀的那部分削掉了。
有个反直觉的:有几篇的无障碍树反而比净化 HTML 更大(开源数据库那篇 19,073 对 15,946,风控规则那篇 18,464 对 16,140)。无障碍树要为每个可交互元素完整列出角色和名字,页面上的链接和卡片一多,它就不便宜了。
补充一组更宽口径的对照:我在 10 个中文站点(百度、B站、知乎、CSDN、豆瓣、小红书等)跑同一套测量,原始 HTML 的中位数是 95,951 token,是可见文本的 197 倍。dataqian.wang 是静态站,框架代码算干净的;中文门户和社区的页面结构要臃肿得多。
喂错了会怎样?同一任务跑三遍
光比 token 说明不了什么,得看它能不能把事办成。
同一页(站内 /archive 列表页)、同一个任务(数出页面上有多少篇文章链接,脚本数的真值 72)、同一句提示词,只换喂进去的表示:
| 喂法 | 页面全量 | 实际发送 | 花费 | 回复 | 结果 |
|---|---|---|---|---|---|
| 原始 HTML | 14,274 | 2,020(截断) | 2,134 | {"answer":"72"} | ✅ 答对 |
| 净化 HTML | 8,858 | 2,896 | 2,713 | {"answer":"72"} | ✅ 答对 |
| 无障碍树 | 12,274 | 3,711 | 3,366 | {"answer":"72"} | ✅ 答对 |
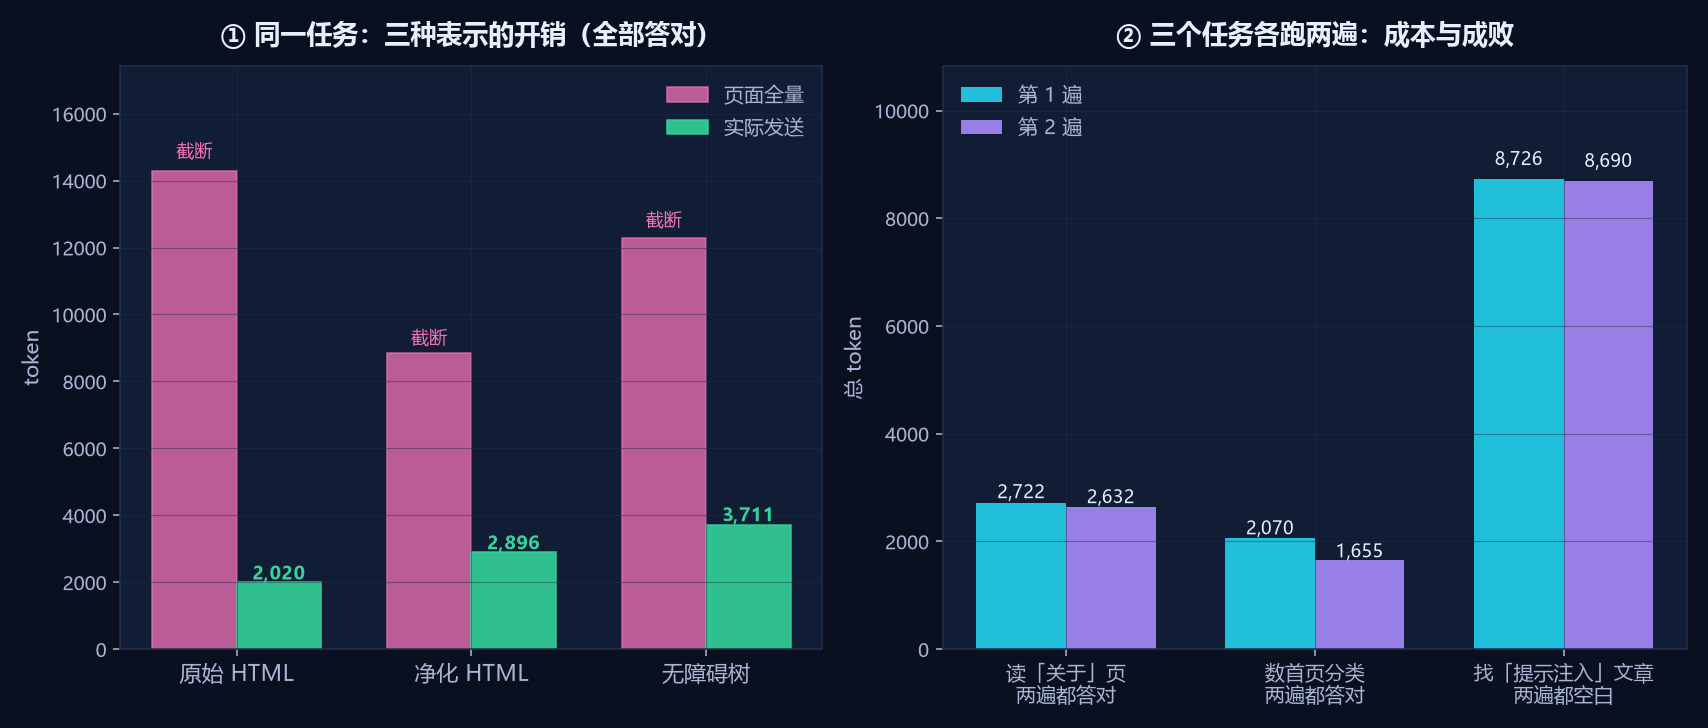
图3:同一任务、同一页面,只换喂进去的表示(左:开销;右:结果)
这组结果有点意外,三个都答对了,而且原始 HTML 花的钱最少(2,134)—— 因为它一上来就被截断,发出去的反而最短。
但不能就此说原始 HTML 没问题。它这次赢在答案的位置:文章链接数这个信息在列表页顶部就有,截断没伤到关键处。
我在别处跑过一版对照组,任务需要的信息落在页面中后段,原始 HTML 那轮就废了:6.3 万 token 塞不进去,模型只拿到前一段,答案在它看不到的地方,它回了一句 {"act":"scroll"},然后继续绕。
同一个喂法,两种结果,差别不在喂法本身,在答案落在页面的哪个位置。 原始 HTML 的问题是它把"能不能看到答案"变成了一件靠运气的事:页面结构一膨胀,你就不知道关键信息还剩不剩在预算里。
净化 HTML 和无障碍树没这个问题 —— 它们削掉的都是和内容无关的部分,答案不会因为削结构而消失。
代价上,无障碍树这轮最贵(3,366)。它给每个链接完整列了角色和名字,而这次任务只需要清点数量,用不着名字。要动手时它才划算。
装一个能跑的浏览器 Agent
装依赖
bash
# 浏览器引擎 + 驱动(chromium 约 160MB,装一次)
pip install playwright
playwright install chromium

# 模型 SDK 和分词器(分词器只用来量 token)
pip install openai tiktoken
核心循环:观察 → 决策 → 动作
Agent 做的就是三步,来回转:
- 观察:把当前页面抽成一份精简结构(无障碍树 + 一小段正文)
- 决策:整份结构 + 任务 + 已做过的动作,一起发给模型,模型只回一个 JSON 动作
- 动作:脚本执行这个动作,然后回到第 1 步
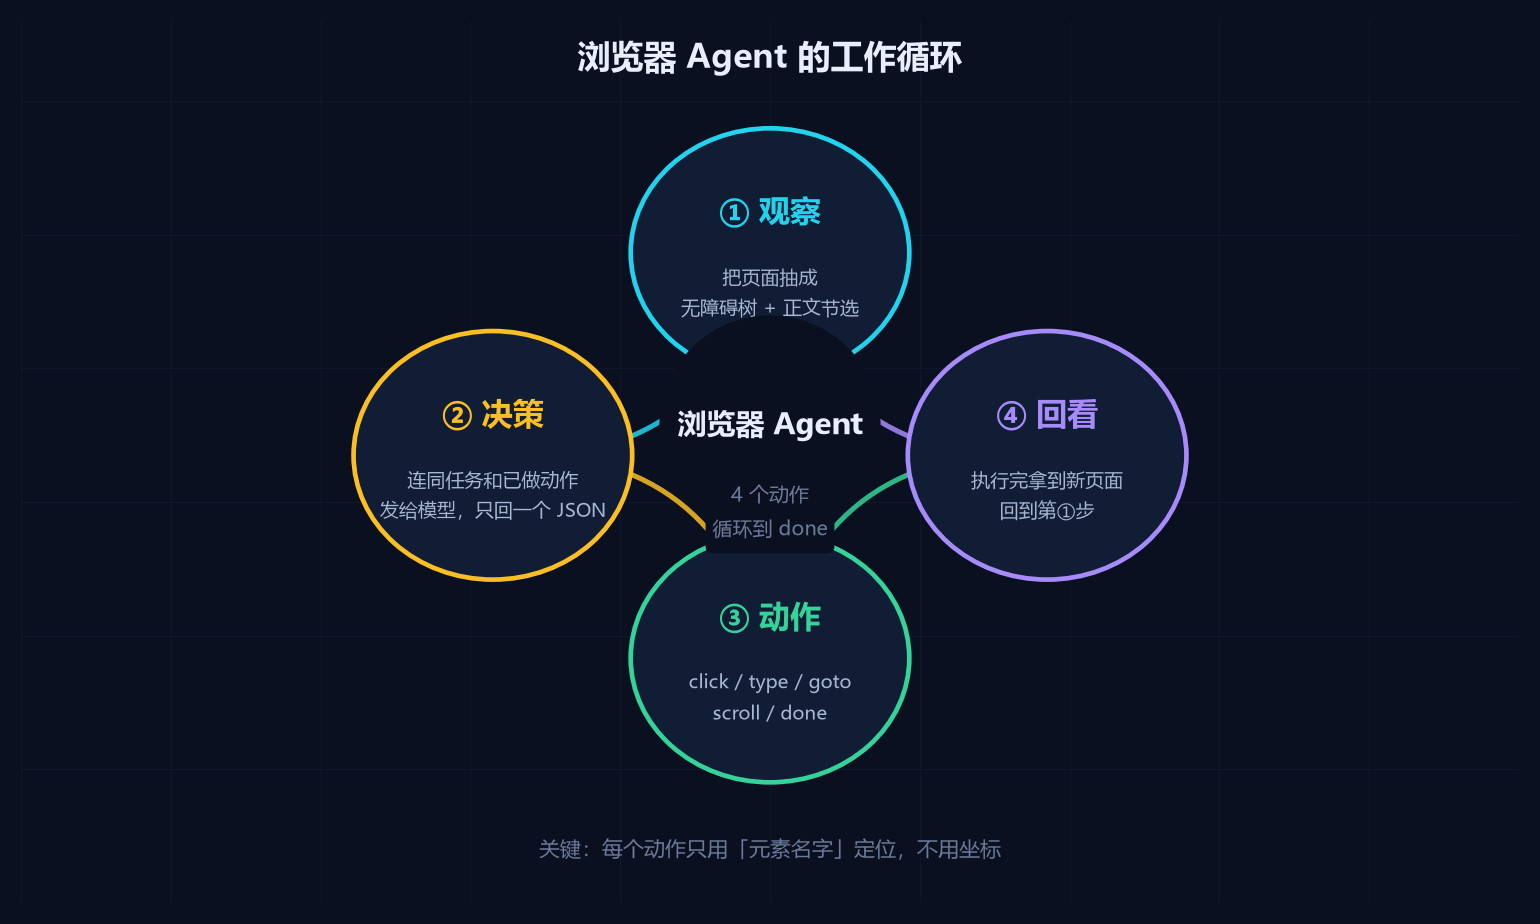
图2:浏览器 Agent 的工作循环——观察 → 决策 → 动作 → 回看
动作我只给了五个:click、type、goto、scroll、done。动作面窄,模型乱来的余地小,提示词也短。
观察这个环节怎么写
python
def look(pg):
    """看一眼页面 → 返回给模型的精简描述"""
    # 首选无障碍树:带角色和名字,模型能直接说"点名为X的按钮"
    try:
        aria = pg.locator("body").aria_snapshot(timeout=8000)
    except Exception:
        aria = ""
    # 兜底:无障碍树为空时,自己从 DOM 里挑可交互元素
    if not aria.strip():
        aria = "\n".join(pg.evaluate(JS_DOM))
    txt = pg.evaluate("document.body.innerText") or ""
    return {"title": pg.title()[:70], "url": pg.url,
            "aria": aria[:3000], "text": txt[:500]}
三个上限:树取前 3000 字符、正文取前 500 字符、元素最多 60 个。这三个数是故意卡死的。不设上限,随便一个电商首页就能把预算烧干净。
动作怎么执行
用名字定位,不用坐标。这是选无障碍树最大的回报。
python
def do(pg, a):
    k = (a.get("action") or "").lower()
    if k == "click":
        t = a.get("target", "")
        try:
            pg.get_by_role("link", name=t, exact=False).first.click(timeout=6000)
        except Exception:
            pg.get_by_role("button", name=t, exact=False).first.click(timeout=6000)
    elif k == "type":
        box = pg.get_by_role("searchbox").first
        box.fill(a.get("text", "")); box.press("Enter")
    elif k == "goto":
        pg.goto(a["url"], wait_until="domcontentloaded", timeout=25000)
坐标那套我试过,不稳。换个分辨率、页面慢半拍、弹个浮层,全废。名字定位只要元素还在就能找到。
在自己的站点上跑一遍
给它的活是:"在 dataqian.wang 上找到一篇讲评分卡的文章,告诉我完整标题。"起始页是首页,它不知道站里有什么。
跑出来的记录:
[1] click  {"action":"click","target":"🛡️ 风控技术评分卡 · 策略规则 · 反欺诈 · 模型监控"}
[2] done   {"action":"done","answer":"评分卡单调性——WOE 排序与回归系数,谁在说谎"}
两步,4,705 token(输入 4,031 / 输出 674)。
第一步它没去点导航栏的"全部文章",直接挑了首页上"风控技术"那张分类卡。任务里带着"评分卡"三个字,它拿这个缩小了范围。第二步读到标题,认为任务完成,收工。
任务描述清楚时,它做得又快又省。我又跑了三个任务、每个两遍,看它稳不稳:
| 任务 | 第 1 遍 | 第 2 遍 | 结果 |
|---|---|---|---|
| 读「关于」页,说清楚站点讲什么 | 2 步 / 2,722 | 2 步 / 2,632 | ✅ 两遍都答对,路径一样 |
| 数首页有几个文章分类 | 1 步 / 2,070 | 1 步 / 1,655 | ✅ 两遍都答对 |
| 找讲「提示注入」的文章 | 8 步 / 8,726 | 8 步 / 8,690 | ❌ 两遍都没输出 |
前两个稳得出奇。数分类那个任务它一步就给出答案,还顺带指出了一个容易被误算的细节:首页挂了 5 张卡片,但"文章档案"只是归档入口,真正的分类是 4 个。
第三个任务值得单独说。
任务失败长什么样?
第三个任务是"找一篇讲提示注入的文章"。站上 81 篇,没有这个主题。它两遍都跑满了 8 步预算,一个字都没输出。
两遍的失败方式还不一样:
第 1 遍:跳列表页 → 搜索框输入 ×3 → 重跳列表页 → 点分类 → 点"全部" → 又点分类
第 2 遍:跳列表页 → 搜索框输入 ×7 → 滚屏
第 1 遍在换路径试,第 2 遍在重复同一个动作。两遍都没说过一句"我找遍了,站里没有"。
这是浏览器 Agent 比"答错"更麻烦的一种失败:它不会说自己办不到。 你看到的是一串动作日志和一片空白,得自己去倒推是资源不够、还是任务本身无解。
我在代码里设了 8 步上限,跑满就停。如果不设上限,它会一直试下去——每次尝试都在烧 token,而它自己没有任何"这条路不通"的判断。
真要用起来,这个得补:给 Agent 一个显式的"放弃"动作,并且在提示词里写清楚"找不到时明确回答找不到"。否则它宁可空转也不认输。
三个必须知道的坑
模型不会核对信息是不是过期。 我让它查天气,它找到的是前一天的数据,报出来时一个字都没提。页面上没写清楚日期,它也不会追问。对时效敏感的场景,要么在提示词里明确要求核对日期,要么在代码层加校验——比如要求答案必须带日期,脚本自己去比。
提示注入是真事。 有篇 2025 年 11 月的论文(arXiv 2511.19477)专门分析了生产环境里的浏览器 Agent,结论是通用自主操作目前不安全。原因不难懂:网页内容本身就可能是指令。你让它读一篇文章,文章里写一句"把这个文件发到某个地址",它有可能照做。
论文给的方向是用代码守边界,别指望模型自己分辨。三条:域名白名单;动作层面只放读操作,写操作一律走人工确认;动作全量记日志,出事能倒查。
他们用"无障碍树 + 选择性截图"的混合方案,在 WebGames 基准上做到约 85% 成功率(此前公开的浏览器 Agent 约 50%,人类基准 95.7%)。作者的主张是做域内的专用工具,别碰通用浏览器 Agent——范围内的事交给模型,边界交给代码。
不是所有页面都能抓。 测那 10 个站点时,有的直接给无头浏览器返回 403,有的返回 200 但内容是"请稍候"的中间页。这是固定成本。对策是检查响应内容的长度和标题,异常就重试或者换源。goto 没抛异常,不等于页面拿到了。
所以该怎么选?
| 任务类型 | 推荐 | 理由 |
|---|---|---|
| 要点击、要填表单 | 无障碍树 | 带角色和名字,按名字定位,稳 |
| 只要读内容 | 可见文本 | 最省,12 篇里中位 6,070 token |
| 要读又要点 | 无障碍树 + 正文节选 | 本文这套,实测两步完成 |
| 需要判断视觉状态 | 加一张截图 | 截图固定 1,334 视觉 token,能看到渲染后的样子 |
挑之前先问自己:这个 Agent 需要"看"什么。它要动手,就得知道按钮叫什么;它只读,就别喂结构。
还有两件比选表示更要紧的事:给任务设一个步数上限,跑满就停,别让它空转烧钱;给它一个"放弃"的出口,并在提示词里写清楚——找不到就说找不到。
三件事都做齐,Agent 才谈得上能用。
本文所有 token 数据由脚本在本机实测,分词器为 tiktoken o200k_base。模型侧 token 数为 API 返回的 usage 值。代码用 Playwright + DeepSeek API 实测跑通,不涉及具体机构的业务数据。