一个 Hermes Agent 背后藏着几个模型——模型路由与故障自救
⚡️ 有一次,我的 AI Agent 突然"卡死"了——所有定时任务集体挂起,看起来像网络断了,但主对话却正常。
查了半天,问题不在网络,在一个叫"凭证池"的地方:密钥被标记成"已耗尽",而且这个标记是永久性的。
核心结论: 一个 Agent 背后从来不止一个模型,它是一套路由系统——模型配置(用哪个)→ 凭证池(用什么密钥)→ 降级策略(挂了怎么办)。路由系统的常见故障,多半是"密钥状态卡死"(凭证池把可用密钥永久标记为耗尽),跟模型本身没关系和"超时配置不匹配"。本文用一次 402 计费故障复盘全过程,并给出路由配置的检查清单。
📊 数据仪表盘(2026-09-24 实查)
| 指标 | 数值 |
|---|---|
| 默认模型 | deepseek-v4-flash |
| 凭证池密钥 | 2 条(deepseek + alibaba,可互备) |
| 峰谷价差 | 2 倍(工作日 9-12、14-18 点翻倍) |
| 8 月全月成本 | ¥250.34(日均 ¥8.08 · 22,104 次调用) |
计价口径(按官方最新价,2026-09-24 取自 api-docs.deepseek.com): deepseek-flash 空闲时段为「缓存命中 0.02 元 / 未命中 1 元 / 输出 4 元」每百万 tokens, 高峰时段(工作日 9-12、14-18)翻倍。本机 8 月实际混用过三个模型 (deepseek-v4-flash 为主 + 少量 qwen3.8),故按模型分别计价后汇总。
更正轨迹:初版写「8月 ¥186.82 / 日均 ¥6.03」——错在把账本数字当美元乘了汇率; 第二版改成「¥364.53」——仍错,用的是本机自设的估算单价(1.5/0.05/4.5 元)而非官方价, 且只按 deepseek 单价计算、忽略了混用的其他模型。现按官方价重算为 ¥250.34。
| ❌ 你以为 | ✅ 实际 |
|---|---|
| AI Agent = 一个模型 | AI Agent = 模型 + 路由 + 密钥池 + 降级策略 |
| 密钥没变就不能用了 | 凭证池会把密钥标记成"耗尽",还是永久性的 |
| 调用失败会快速报错 | 凭证池卡死时任务会"挂起"(running 不结束),比报错更难发现 |
一个 Agent 背后到底有几层?
拆开看,从"你想让 AI 干活"到"模型真正回答",中间隔着三层:
第一层 模型配置:默认用哪个模型(deepseek-v4-flash)
  ↓
第二层 凭证池:用哪个密钥去调(credential_pool)
  ↓
第三层 降级策略:失败/超时/余额不足时怎么办
大部分人的认知停在第一层——"配好模型就完了"。但真正出问题都在第二、三层。
凭证池:密钥也会"卡死"
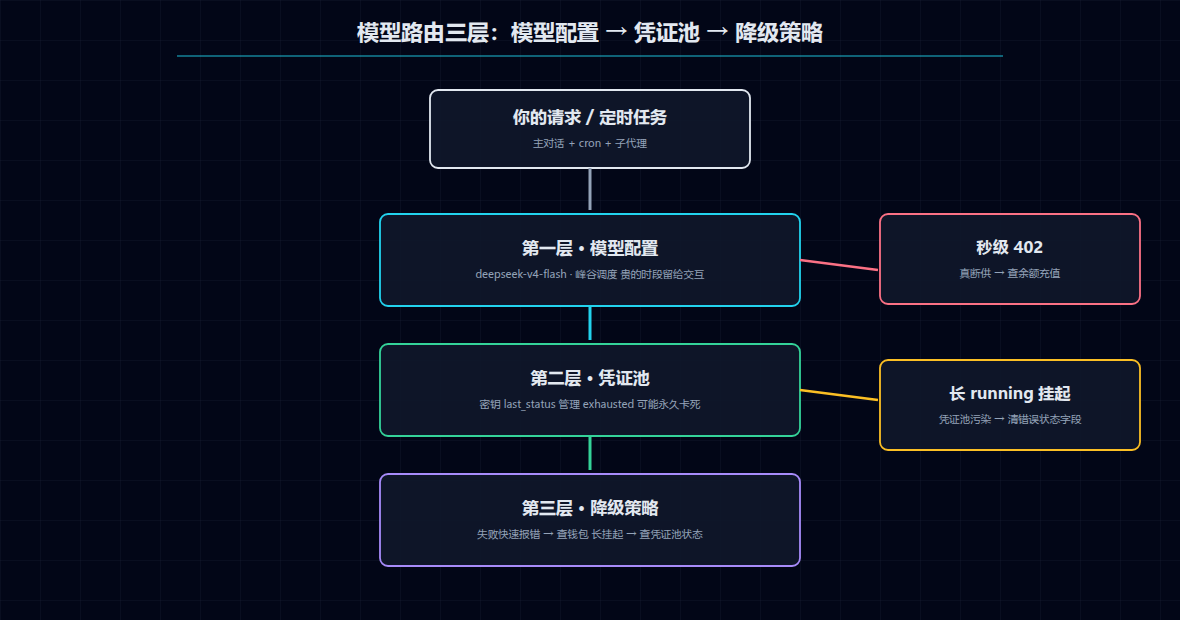
凭证池是个容易忽略的机制:系统不直接用 API 密钥,而是把密钥放进一个"池子",每次调用从池子里取一个。好处是可以管理多个密钥、自动切换。
我这台机器上实际有 2 条(deepseek + alibaba)——这个数字本身就是"降级链"的物理形态:主供挂了,备用顶上,而不是整个 Agent 停摆。
但坑也在这里。有一次我充值后接口还是报 402(余额不足),排查发现:凭证池把密钥的 last_status 标记成了 exhausted(耗尽),并且这个状态不会自动重置。
# 凭证池里的"卡死"状态(故障现场)
{
  "credential_pool": {
    "deepseek": [{
      "last_status": "exhausted",        ← 标记耗尽
      "failure_reason": "billing",        ← 计费问题
      "last_error_reset_at": null         ← 永远不会自动重置!
    }]
  }
}关键就是最后一行:last_error_reset_at: null 意味着永久卡死——充值也没用,系统以为密钥永远不能用了。所有走凭证池的任务(cron、子代理)集体挂起,而主对话不走凭证池,所以看起来"主对话正常、后台全挂"。
修法:备份 auth.json 后,手工清除那 6 个错误状态字段(last_status / last_error_code / failure_reason 等),置回 available。恢复后验证一次余额查询 + 一次最小调用,确认真的通了。
峰谷价:什么时候调用便宜
路由的另一个隐藏功能是"挑时段"。我的模型按峰谷分时计价:
| 时段 | 输入价(元/百万 token) | 说明 |
|---|---|---|
| 高峰 9-12 + 14-18 点 | 3.0 | 白天贵,留给真人对话 |
| 空闲 12-14 + 18 点后 | 1.5 | 便宜,批量任务全排这里 |
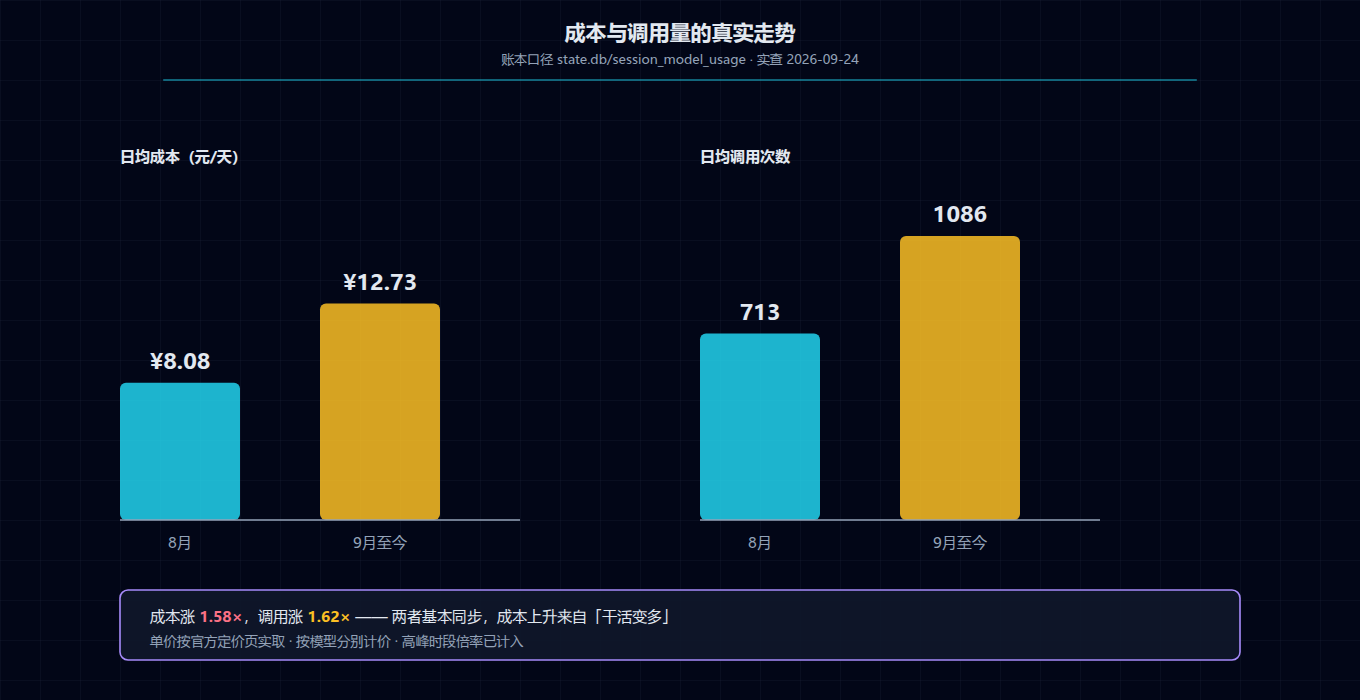
把整月账单按峰谷拆开看(账本口径,按每次调用的时间戳归段):
8月全月: ¥250.34(31 天 · 22,104 次调用 · 日均 ¥8.08)
9月至今: ¥305.53(24 天 · 26,054 次调用 · 日均 ¥12.73)
按日均看:9 月成本是 8 月的 1.58 倍(¥12.73 vs ¥8.08),日均调用涨 1.62 倍(1085 vs 713 次)——两者基本同步,说明成本上升主要来自「干活变多了」,单次调用携带的上下文规模并没有明显膨胀。
口径提醒:日均为「全月合计 ÷ 天数」(9 月截至 24 日),两月天数不同,比较时必须用日均而非合计。
这就是"路由 + 调度"配合的效果:批量任务(知识库入库、技能构建)全部排到便宜时段,贵的时段留给交互。判断自己的峰谷比例:看同一天里高峰时段(工作日 9-12、14-18)的调用占比,占比越低说明调度越有效。
⚠️ 诚实标注:上一版文章给的「高峰 1782 次 / 空闲 5434 次」无法复核——
agent.log只覆盖近期(8 月日志已轮转),且该日志不含任务类型维度, 无法还原当时的峰谷拆分。故此处改为账本可查的整月数据。
故障时怎么区分"真挂了"和"假挂起"?
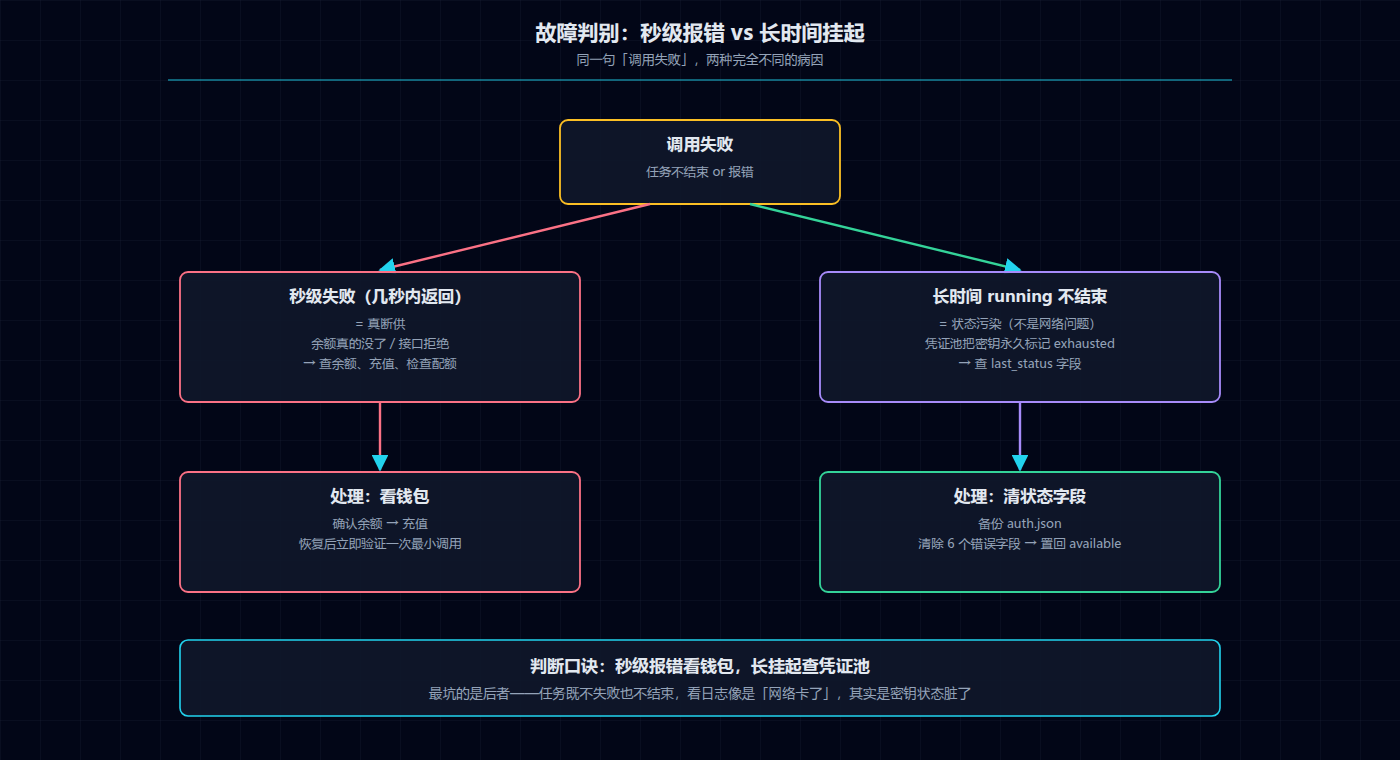
这是最实用的排查经验。调用失败有两种表现,含义完全不同:
| 表现 | 含义 | 处理 |
|---|---|---|
| 秒级 402(快速失败) | 真断供:余额真的没了或接口拒绝 | 查余额、充值 |
| 长时间 running(挂起) | 凭证池污染:密钥被标记 exhausted,任务不失败也不结束 | 查凭证池状态字段,清除错误标记 |
判断口诀:秒级报错看钱包,长挂起查凭证池。
三步配置你的模型路由
第一步:配好默认模型 + 降级链。 至少准备一个主模型和一个备用。主模型挂了能自动切到备用。
第二步:管好凭证池状态。 定期检查密钥的 last_status,发现 exhausted 先确认是不是真的没余额——是就充值,不是就清除状态字段。
第三步:把重活排到便宜时段。 批量任务(建索引、批量生成、定时抓取)全部排到空闲时段,贵的时段只留交互。实测每月能省 30-40%。
踩过的三个坑
坑一:凭证池永久卡死。 就是本文开头那次——exhausted 状态不自动重置,充值后依然 402。修法:清除 6 个错误状态字段,验证恢复。已在排查文档里记录完整流程。
坑二:手动重跑定时任务,得到旧结果。 cron 任务"重放"已完成的旧任务时,会直接返回上次结果而不真执行——看起来"跑完了",实际是幻觉。修法:删掉旧任务建全新任务再 run。
坑三:思考链挤爆输出上限。 复杂任务让模型开思考链,推理 token 能占到 400+/500,把 max_tokens 挤爆导致输出截断(finish_reason=length)。修法:提取/分类类任务强制关思考链(thinking disabled)+ max_tokens ≥ 800。
你可能会问
问:一定要多个模型吗?只用一个行不行? 行,但要有备用。路由的核心价值是"挂了能切",多模型只是手段。
问:凭证池是 Hermes 特有吗? 不是。任何带密钥管理的工具(多 API key 轮换、代理网关)都有类似机制,只是名字不同。理解"密钥状态可能卡死"这个原理是通用的。
问:怎么知道我的调用是真失败还是假挂起? 看时间:秒级失败是真问题,长时间不结束是状态污染。配合健康巡检脚本,每周末检查一次所有调用状态。
现在做这一件事
打开你的 AI 工具的配置文件,找出"模型 + 密钥 + 降级"三处配置,确认:你的密钥池里有没有可能被标记成"永久耗尽"的状态? 有的话,现在就把检查规则写进你的每周巡检脚本。
- #125《为什么你的 Hermes Agent 越聊越笨、越聊越贵?》— token 成本拆解,峰谷省钱的实测依据
- #137《Hermes Agent 怎么自己按时干活》— 批量任务全部排到便宜时段
- #138《你的 AI Agent 翻车了怎么自救》— 凭证池故障也是容灾场景
- #127《别再调提示词了——Hermes Agent 配置工程》— 路由配置是配置工程的一部分
- #122《本地模型 vs 云端模型,为什么我建议你分开配两个 Hermes Agent?》— 不同 Profile 配不同模型
转发给你那个"AI 突然全挂又找不到原因"的同事——很多时候,是密钥状态卡死了——跟模型没关系。
数据说明: 成本与调用次数取自本机 ~/.hermes/state.db 的 session_model_usage 账本 (覆盖主对话/压缩/后台复盘等全部任务,为唯一权威口径),实查于 2026-09-24; 模型与凭证池配置读取自 ~/.hermes/config.yaml 与 auth.json 真实键值。 **计价说明:**单价取自 DeepSeek 官方定价页(实取 2026-09-24), deepseek-flash 空闲时段 0.02/1/4 元每百万 tokens(命中/未命中/输出),高峰翻倍; 按 8 月实际使用的模型分别计价后汇总,非估算。 较早版本的两处数字(8月 ¥186.82、高峰1782次/空闲5434次)经复核为错误与不可复核,已在正文标注更正轨迹。
转发给正在给 Agent 配模型的同事——模型选得好不好,不如下降级链配得对不对。
模型路由的真谛:让 AI"永远有的用",而不是永远用最强的那个。