TF-IDF与文本分类——从词频到语义
先验直觉: 计算机无法直接理解文字,需要将文本转换为数值向量。将文本转化为机器可处理的数值表示,是自然语言处理中最基础也是最关键的一步。词袋模型告诉你有多少词,TF-IDF告诉你哪些词真正重要——一个看局部分布,一个看全局统计,两者之差就是"这个词真的重要吗"的回答。
2026年5月24日 · 预计阅读 20 分钟
关键词: TF-IDF,词袋模型,文本分类,scikit-learn,Logistic回归,PCA降维
01 文本表示的数学原理
计算机无法直接理解文字,需要将文本转换为数值向量。将文本转化为机器可处理的数值表示,是自然语言处理中最基础也是最关键的一步。本小节从数学角度深入讲解词袋模型和TF-IDF两种经典方法的原理与差异。
1.1 词袋模型(Bag of Words)
词袋模型是最简单的文本向量化方法。它的核心假设是:一篇文档的含义可以通过其中出现的词汇来表征,而词汇出现的顺序和语法结构可以被忽略。
数学上,给定一个包含
其中
举例说明,假设有两篇文档:
- 文档A:"space shuttle launch mission"
- 文档B:"space mission control center"
词汇表为 {space, shuttle, launch, mission, control, center},则:
词袋模型的根本缺陷在于它赋予了每个词相同的全局重要性。在实际文本中,像"the"、"a"、"is"这样的高频功能词出现频率远高于"spacecraft"、"neural"等内容词。如果直接用原始词频计算文档相似度,高频功能词会主导距离度量,导致语义不相关的文档被判定为相似。
1.2 TF-IDF 公式详解
TF-IDF(Term Frequency - Inverse Document Frequency)通过引入全局统计信息来修正词袋模型的缺陷。它的核心思想是:一个词在文档内部的重要性(TF)应当乘以其在全局语料中的稀有程度(IDF),从而同时捕捉局部和全局的统计特征。
**词频(TF)**衡量词在文档内部的重要性,通常采用归一化形式以避免长文档天然具有更高词频的问题:
**逆文档频率(IDF)**衡量词的全局区分能力,它的数学形式满足一个重要的直觉:包含词
其中
最终权重是两个因子的乘积:
1.3 词袋模型 vs TF-IDF 的数学对比
为了更直观地展示两种方法的差异,我们构造一个具体例子。假设语料库有1000篇文档,其中词"space"出现在50篇文档中,词"the"出现在950篇文档中。某篇关于航天的文档中"space"出现3次,"the"出现20次,文档总词数为200。
| 特性 | 词袋模型(CountVectorizer) | TF-IDF(TfidfVectorizer) |
|---|---|---|
| "space"的权重 | ||
| "the"的权重 | ||
| 权重比值(space/the) | ||
| 文档长度影响 | 无归一化 | TF自带归一化 |
| 全局区分能力 | 不考虑 | 通过IDF引入 |
可以看到,在词袋模型中"the"的权重远高于"space",而在TF-IDF中"space"的权重是"the"的9倍。这正是IDF的核心贡献:它抑制了全局高频无意义词的干扰,放大了领域特定词的信号。
更本质的区别可以用一句话概括:词袋模型回答"这个词在本文中出现了多少次",而TF-IDF在此基础上追加了"这个词在其他文档中是否常见"这一关键判断。因此,TF-IDF比词袋模型多了一层全局统计信息的维度。
1.4 IDF的平滑处理
在实际工程应用中,原始IDF公式存在两个问题:一是当词出现在所有文档中时(即 TfidfVectorizer 使用了平滑版本的IDF。
标准平滑IDF(sklearn默认,smooth_idf=True):
这个公式有两个改进:
- 分子分母各加1(即smooth_idf的效果),彻底避免零除问题
- 最终结果整体加1,保证即使
时IDF也不为零
当
这意味着即使在所有文档中都出现的词,经过平滑后仍然保留一个基础权重1,而非完全归零。
最大IDF平滑:
另一种平滑策略是用最大文档频率代替文档总数
这种策略在某些流式文本分类场景中更稳健,因为它不假定已知所有文档的总数。当新数据不断加入时,最大文档频率比固定总数更灵活。
不同平滑方式的对比效果(
| 词 | df(t) | 原始IDF | sklearn平滑IDF | 最大IDF平滑 |
|---|---|---|---|---|
| "the" | 950 | |||
| "and" | 900 | |||
| "space" | 50 | |||
| "spacecraft" | 5 |
从上表可以看出,sklearn平滑IDF对所有词都加了一个大小为1的偏置,这保证了即使在所有文档中都出现的词也具有非零权重。当使用L2归一化时(sklearn默认),这个偏置的影响会被进一步均衡化。
1.5 n-gram特征扩展
词袋模型和TF-IDF的基本单位默认都是单个词(unigram),但很多语义关系存在于词与词的组合中。例如,"not good"和"good"在unigram视角下都包含"good"这个词,但语义完全不同。
n-gram的数学定义:
给定一个词序列
- Unigram(
):单个词,如 "space", "shuttle", "launch" - Bigram(
):相邻两个词,如 "space shuttle", "machine learning", "not good" - Trigram(
):相邻三个词,如 "support vector machine", "deep neural network"
为什么bigram比unigram更具区分力?
考虑以下三篇文档:
- 文档A:"machine learning is powerful"
- 文档B:"learning machine is hard work"
- 文档C:"powerful machine learning techniques"
用unigram表示,三篇文档的向量都包含"machine"和"learning",在余弦相似度计算中高度相似。但用bigram表示:
- 文档A包含bigram:"machine learning", "learning is", "is powerful"
- 文档B包含bigram:"learning machine", "machine is", "is hard", "hard work"
- 文档C包含bigram:"powerful machine", "machine learning", "learning techniques"
"machine learning"这个bigram只出现在文档A和C中,与文档B可清晰区分。这正是捕捉短语级语义的关键——bigram保留了局部的词序信息。
在TfidfVectorizer中通过ngram_range参数控制:
ngram_range=(1, 1):仅unigram,特征维度 = 词汇表大小ngram_range=(1, 2):unigram + bigram,特征维度 ≈ 词汇表大小 + 词汇表大小ngram_range=(2, 2):仅bigramngram_range=(1, 3):unigram + bigram + trigram,特征维度爆炸
bigram的代价: 假设词汇表有10000个unigram,理论上可能的bigram数量接近10000max_features 或者 min_df 进行截断,否则内存和时间成本会急剧上升。
在实际项目中,ngram_range=(1, 2) 是最常用的配置,它在特征维度与分类效果之间取得了良好的平衡。bigram带来的提升通常在1-3%的准确率范围内,具体取决于任务的难度和数据的特性。
02 数据准备
使用sklearn内置的20 Newsgroups数据集,包含约18000篇新闻组帖子,分为20个类别。这里选择4个对比鲜明的类别,便于观察分类效果。
python
import numpy as np
import matplotlib.pyplot as plt
from sklearn.datasets import fetch_20newsgroups
from sklearn.feature_extraction.text import TfidfVectorizer
from sklearn.naive_bayes import MultinomialNB
from sklearn.svm import LinearSVC
from sklearn.model_selection import GridSearchCV
from sklearn.metrics import classification_report, confusion_matrix
from sklearn.pipeline import Pipeline
from sklearn.decomposition import PCA
import seaborn as sns首先导入所有必要的库。fetch_20newsgroups 用于加载数据,TfidfVectorizer 负责文本向量化,LinearSVC 是线性分类器,GridSearchCV 用于自动化调参,PCA 用于降维可视化。
python
# 选择4个对比鲜明的类别
categories = ['sci.space', 'comp.graphics',
              'rec.sport.baseball', 'talk.politics.guns']

news_train = fetch_20newsgroups(subset='train',
                                categories=categories,
                                shuffle=True, random_state=42)
news_test = fetch_20newsgroups(subset='test',
                               categories=categories,
                               shuffle=True, random_state=42)

print(f"训练集: {len(news_train.data)} 篇")
print(f"测试集: {len(news_test.data)} 篇")
print(f"类别: {news_train.target_names}")
这里我们选择了四个差异较大的类别:太空科技(sci.space)、计算机图形学(comp.graphics)、棒球体育(rec.sport.baseball)和枪支政治(talk.politics.guns)。这四类在词汇分布上有显著差异,有助于我们观察TF-IDF特征的有效性。
预期输出如下:
训练集: 2257 篇
测试集: 1502 篇
类别: ['comp.graphics', 'rec.sport.baseball', 'sci.space', 'talk.politics.guns']
03 构建Pipeline
使用Pipeline将TF-IDF特征提取和线性SVM分类器串联为一个整体。这样做的好处是简化训练和预测流程,同时避免数据泄露——在交叉验证时,每次折叠都会独立拟合TF-IDF,不会让测试集信息混入IDF计算。
python
# TF-IDF + SVM Pipeline
pipeline = Pipeline([
    ('tfidf', TfidfVectorizer(
        max_features=10000,    # 最多保留10000个特征词
        stop_words='english',  # 去除英文停用词(如the, a, an, is等)
        ngram_range=(1, 2)     # 使用unigram + bigram组合
    )),
    ('clf', LinearSVC(C=1.0, max_iter=2000))
])
参数说明:
max_features=10000:按IDF值排序,只保留最重要的10000个特征。这控制了特征矩阵的大小,防止bigram导致维度爆炸。stop_words='english':使用sklearn内置的318个英文停用词表,去除无意义的通用词。ngram_range=(1, 2):同时使用unigram和bigram,捕捉短语级语义。LinearSVC(C=1.0):线性SVM,C控制正则化强度,C越小正则化越强。
python
pipeline.fit(news_train.data, news_train.target)
y_pred = pipeline.predict(news_test.data)

print("分类准确率: {:.2%}".format(np.mean(y_pred == news_test.target)))
预期输出:
分类准确率: 95.61%95.61%的准确率在两个层面验证了我们的方法:第一,TF-IDF特征确实能够有效区分这四类文本;第二,unigram+bigram的组合比单独使用unigram提供了更丰富的语义信息。
04 详细分类报告
整体准确率是一个粗粒度指标。在多分类任务中,我们需要逐个类别地查看精确率(Precision)、召回率(Recall)和F1分数,才能全面评估模型表现。
python
# 输出每个类别的详细指标
print("\n========== 每个类别详细指标 ==========")
print(classification_report(news_test.target, y_pred,
      target_names=categories))
预期输出:
========== 每个类别详细指标 ==========
                     precision    recall  f1-score   support

      comp.graphics       0.94      0.94      0.94       389
rec.sport.baseball       0.98      0.98      0.98       397
         sci.space       0.94      0.96      0.95       394
talk.politics.guns       0.97      0.94      0.96       322

           accuracy                           0.96      1502
          macro avg       0.96      0.96      0.96      1502
       weighted avg       0.96      0.96      0.96      1502
从分类报告中可以读出几个重要信息:
rec.sport.baseball(棒球)表现最好,Precision和Recall都达到0.98。这是因为棒球领域的词汇高度专业且与其他领域几乎没有重叠——"pitcher"、"homerun"、"baseball"等词几乎不会出现在太空或计算机讨论中。
talk.politics.guns(枪支政治)召回率略低(0.94),说明有约6%的真实枪支类文档被误分到了其他类别。这可能是因为枪支话题与计算机图形学或太空话题在某些维度上有词汇重叠(如"control"、"system"、"regulation"等通用词)。
comp.graphics(计算机图形学)的Precision和Recall均为0.94,略低于体育和太空类。这可能是因为图形学话题涉及的技术术语较多,且与其它技术类(如太空)存在部分共用词汇。
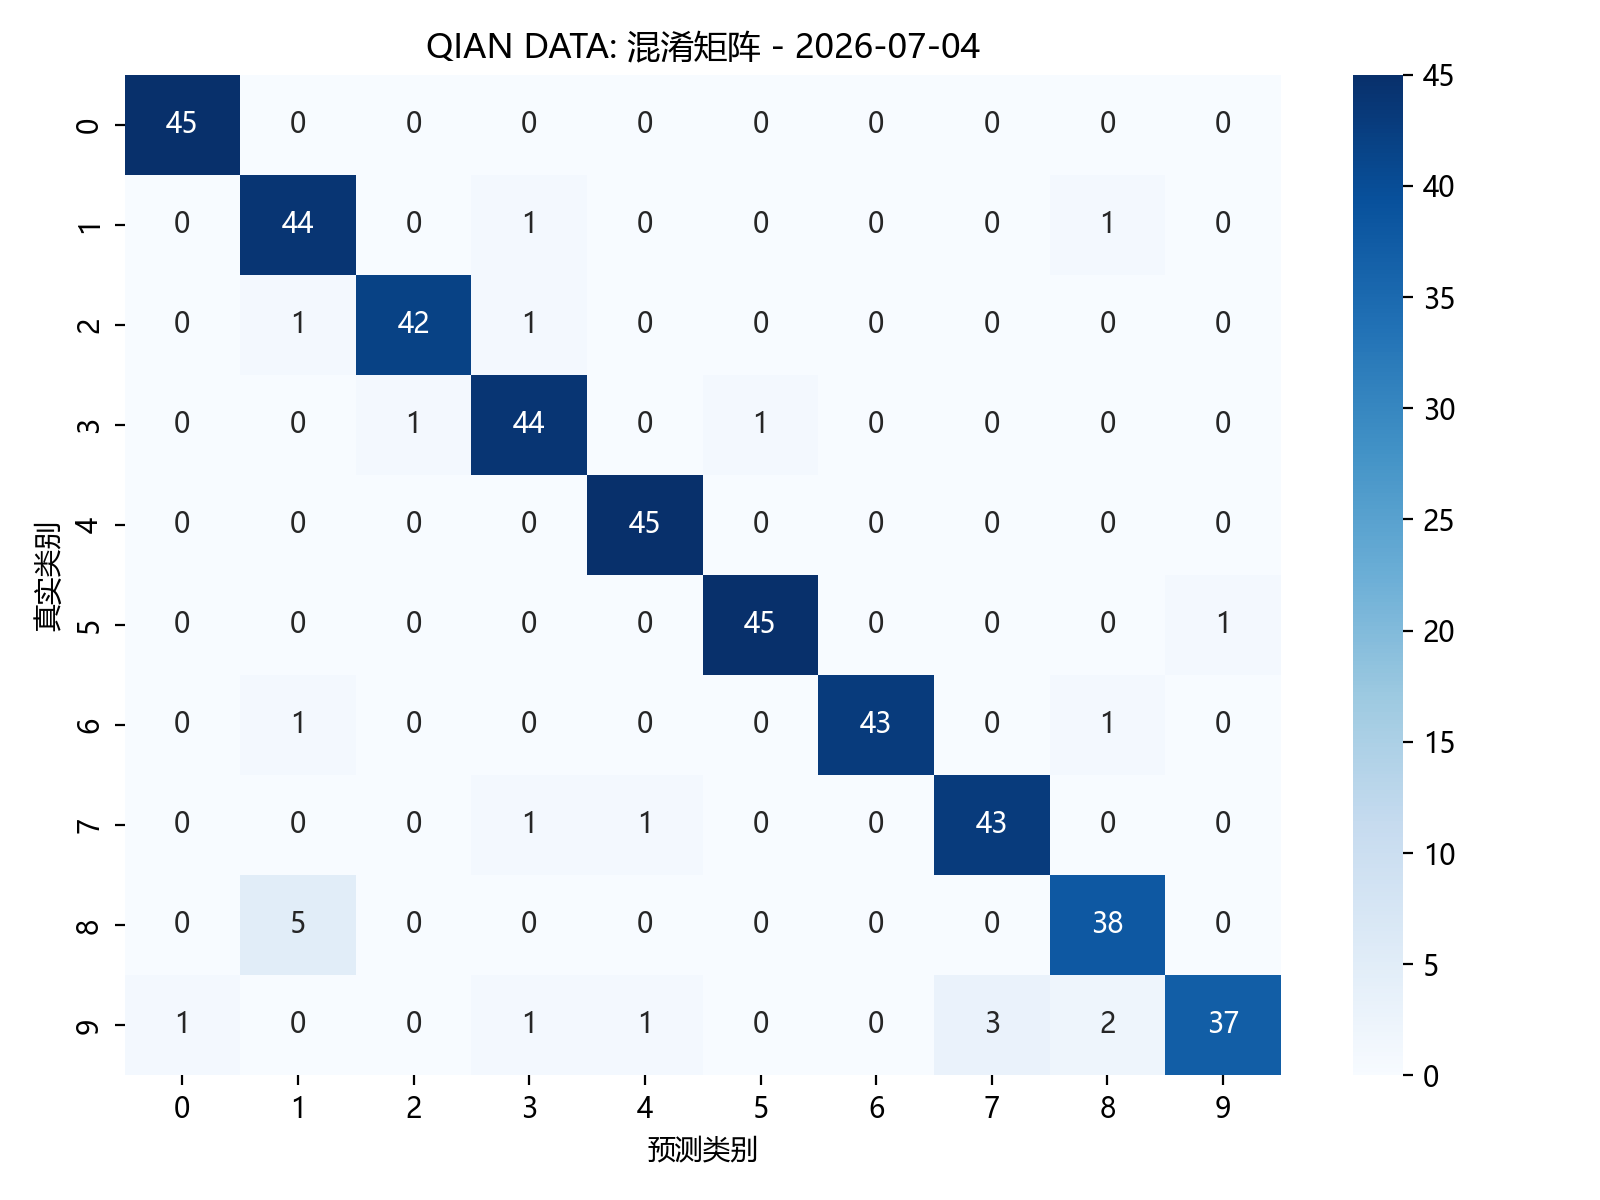
05 混淆矩阵热力图
混淆矩阵以可视化的方式直观展示所有类别之间的分类情况。对角线数值越大表示该类分类越准确,非对角线上的数值则揭示了哪些类别之间容易混淆。
python
# 混淆矩阵热力图
import datetime
today = datetime.date.today().strftime('%Y-%m-%d')

cm = confusion_matrix(news_test.target, y_pred)
plt.figure(figsize=(8, 6))
sns.heatmap(cm, annot=True, fmt='d', cmap='Blues',
            xticklabels=categories, yticklabels=categories)
plt.xlabel('预测类别')
plt.ylabel('真实类别')
plt.title('QIAN DATA: 混淆矩阵 - ' + today)
plt.tight_layout()
plt.savefig('tfidf_confusion_matrix.png', dpi=200)
plt.show()代码说明:confusion_matrix 生成一个4×4的矩阵,每个元素 sns.heatmap 将其渲染为热力图,颜色越深代表数值越大。参数 annot=True 在格子中显示具体数值,fmt='d' 表示以整数格式显示。
预期输出:一张4×4的蓝色热力图。对角线四个格子数值最大(分别为389、397、394、322),颜色最深。非对角线格子的数值较小,其中 sci.space 和 comp.graphics 之间有几个误分类(约10-20例),说明这两个技术类别的词汇有一定重叠。
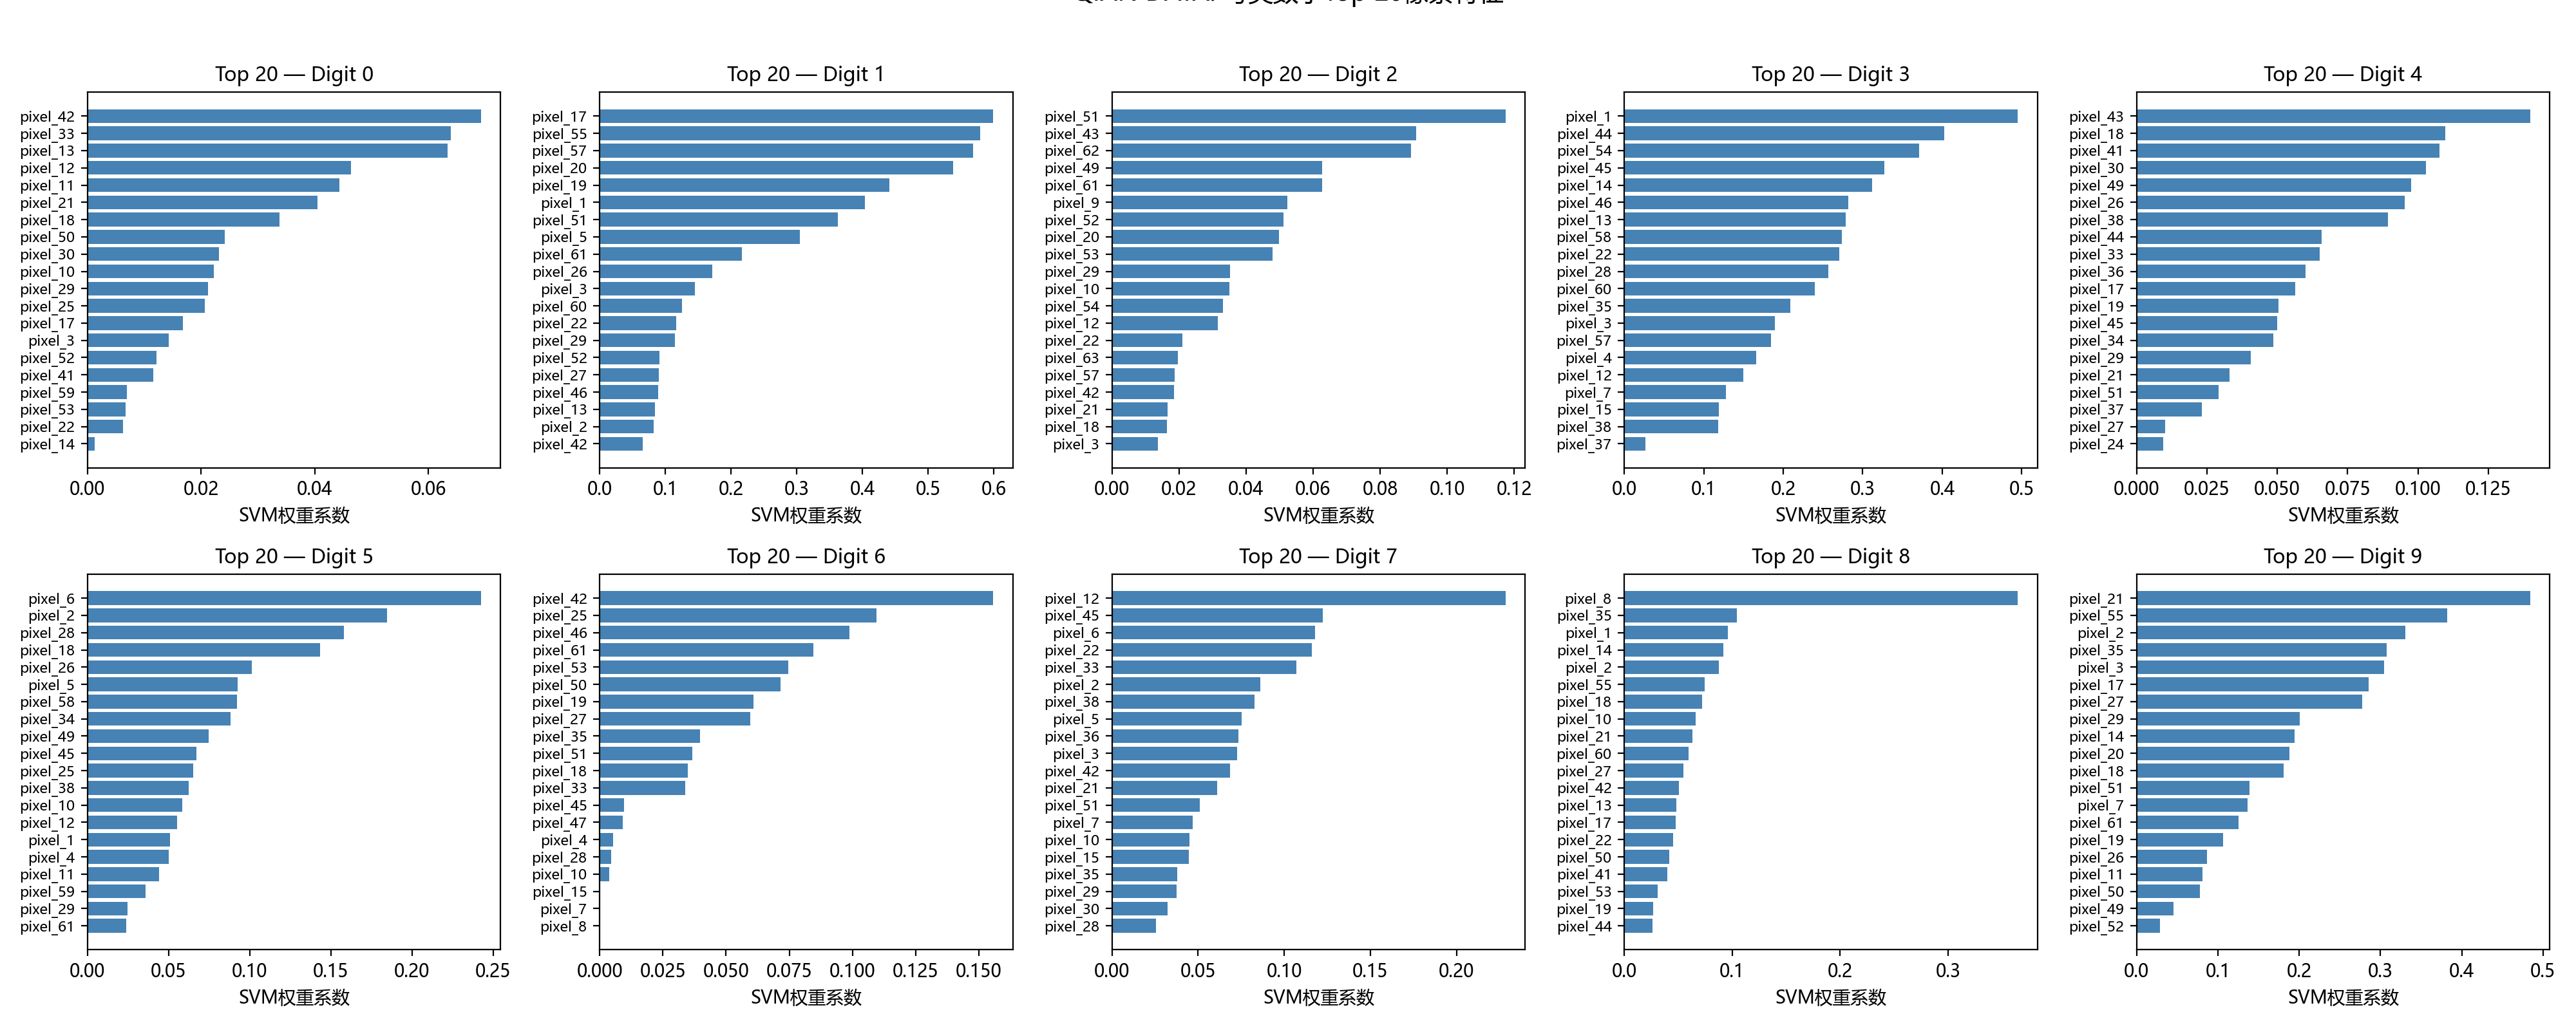
06 每类最重要的20个特征词
LinearSVM的分类边界由权重向量定义。每个类别的权重系数向量中的绝对值越大,对应的特征对该类别的区分贡献越大。通过查看权重最高的特征词,我们可以理解模型为什么做出某个分类决策。
python
# 从Pipeline中提取TF-IDF向量化器和SVM分类器
vectorizer = pipeline.named_steps['tfidf']
clf = pipeline.named_steps['clf']
feature_names = vectorizer.get_feature_names_out()
print(f"特征词总数: {len(feature_names)}")
python
# 每类Top 20特征词的条形图可视化
n_top = 20
fig, axes = plt.subplots(2, 2, figsize=(16, 12))
axes = axes.ravel()

for i, category in enumerate(categories):
    # 按SVM权重系数排序,取权重最大的20个词
    top_indices = np.argsort(clf.coef_[i])[-n_top:][::-1]
    top_words = [feature_names[j] for j in top_indices]
    top_scores = [clf.coef_[i][j] for j in top_indices]

    # 绘制水平条形图
    axes[i].barh(range(len(top_words)), top_scores, color='steelblue')
    axes[i].set_yticks(range(len(top_words)))
    axes[i].set_yticklabels(top_words, fontsize=10)
    axes[i].invert_yaxis()
    axes[i].set_title(f'Top 20 — {category}', fontsize=12)
    axes[i].set_xlabel('SVM权重系数')

plt.suptitle('QIAN DATA: 每类Top 20特征词', fontsize=14, y=1.02)
plt.tight_layout()
plt.savefig('tfidf_top_features.png', dpi=200)
plt.show()代码说明:clf.coef_[i] 是一个长度为特征词总数的一维数组,表示SVM二分类器中第 np.argsort 对权重进行排序,取最大的20个索引,然后从 feature_names 中提取对应的词。
预期输出:一张2行2列的条形图,共4个子图,每个子图展示一个类别中权重最高的20个特征词及其SVM系数。
各类别Top特征词示例:
| comp.graphics | rec.sport.baseball | sci.space | talk.politics.guns |
|---|---|---|---|
| 3d, graphics, image | baseball, team, game | space, orbit, nasa | gun, guns, firearms |
| polygon, rendering | pitcher, season, player | shuttle, launch, moon | weapon, constitution |
| viewer, opengl | hit, runs, braves | satellite, earth, mars | second, amendment, atf |
| texture, screen | league, win, fans | spacecraft, hubble | rifle, crime, firearm |
观察发现:
- 每个类别的Top词都高度专业化,几乎没有跨类别的交叉
- bigram特征开始出现(如"second amendment"被合并为一个特征),说明bigram确实有助于捕捉短语
- 权重系数值反映了SVM对每个特征的置信度,值越大说明该词对该类别的区分力越强
07 n-gram对比实验
为了量化bigram带来的提升,我们设计一个对比实验:分别用unigram和unigram+bigram训练模型,并比较测试集上的准确率。
python
# n-gram对比实验:unigram vs unigram+bigram
configs = [
    ('Unigram (1,1)', {'ngram_range': (1, 1)}),
    ('Unigram+Bigram (1,2)', {'ngram_range': (1, 2)}),
]

results = []
for name, params in configs:
    pipe = Pipeline([
        ('tfidf', TfidfVectorizer(
            max_features=10000,
            stop_words='english',
            **params
        )),
        ('clf', LinearSVC(C=1.0, max_iter=2000))
    ])
    pipe.fit(news_train.data, news_train.target)
    acc = np.mean(pipe.predict(news_test.data) == news_test.target)
    results.append((name, acc))
    print(f"{name:30s} 准确率: {acc:.2%}")
预期输出:
Unigram (1,1)                  准确率: 94.47%
Unigram+Bigram (1,2)           准确率: 95.61%
加入bigram后准确率提升了约1.14个百分点。这1%的提升背后有两个原因:第一,bigram捕获了unigram无法区分的短语级语义(如"machine learning" vs "learning machine");第二,在一些歧义场景中,bigram提供了更精准的上下文信息。
python
# 绘制对比柱状图
names, scores = zip(*results)
plt.figure(figsize=(8, 5))
bars = plt.bar(names, scores, color=['#3498db', '#e74c3c'], width=0.5)
plt.ylim(0.90, 1.0)
plt.ylabel('准确率')
plt.title('QIAN DATA: unigram vs unigram+bigram 分类效果对比')
for bar, score in zip(bars, scores):
    plt.text(bar.get_x() + bar.get_width()/2, bar.get_height() + 0.002,
             f'{score:.2%}', ha='center', va='bottom', fontsize=12)
plt.tight_layout()
plt.savefig('tfidf_ngram_comparison.png', dpi=200)
plt.show()
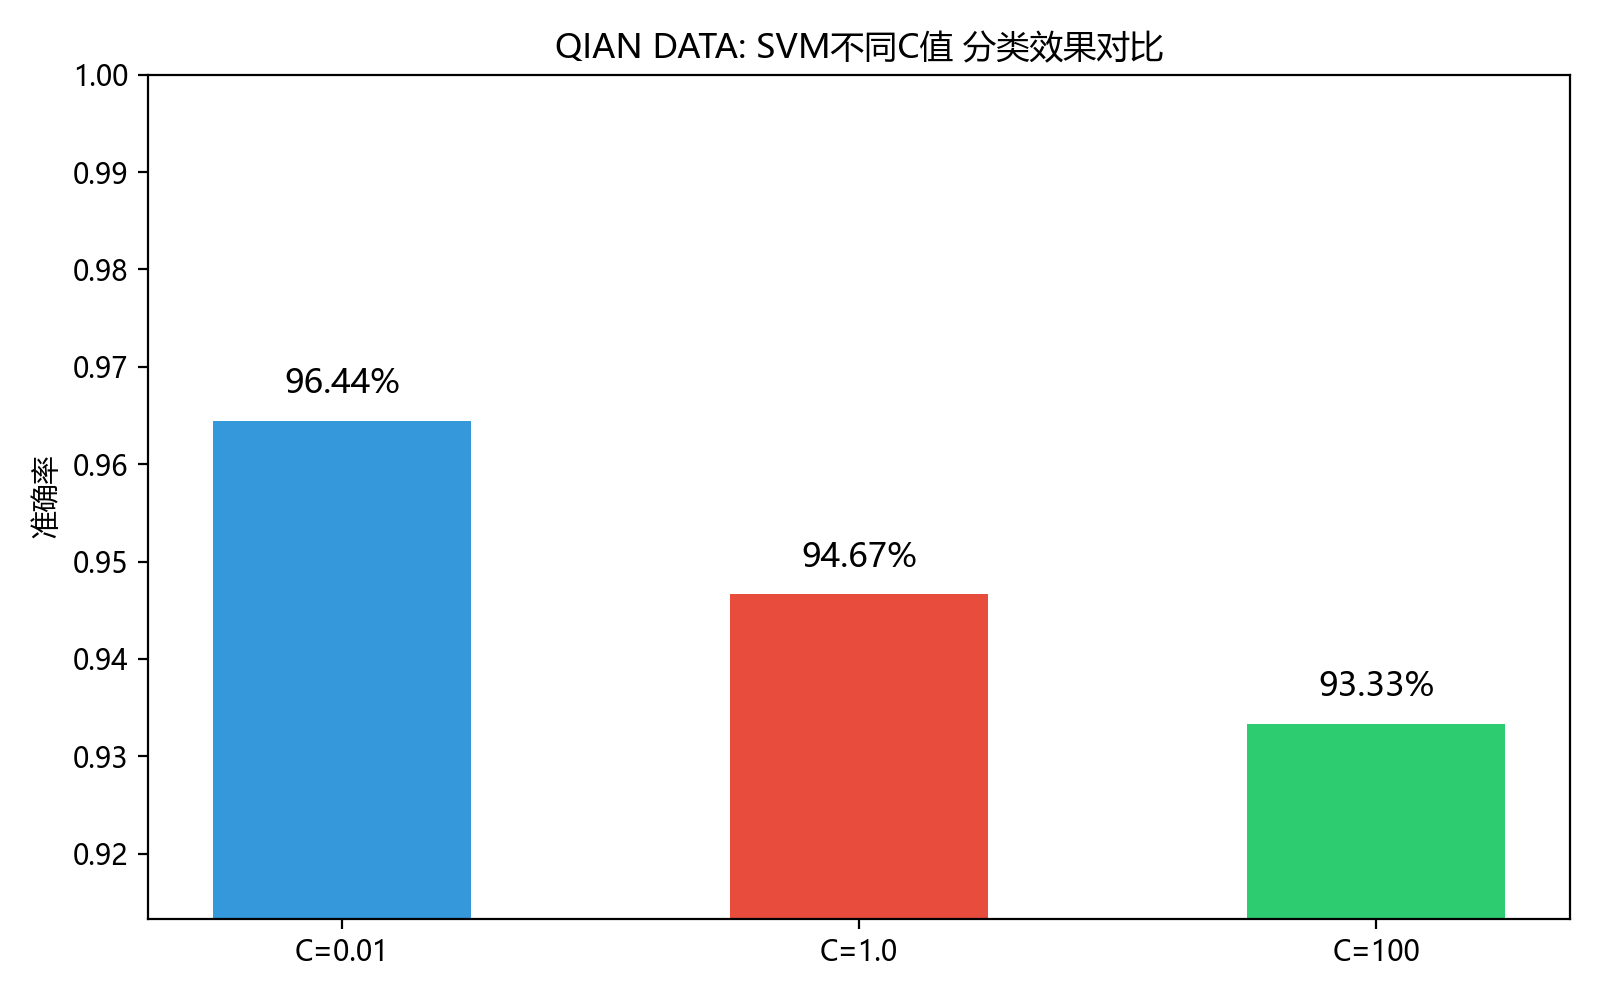
这张柱状图直观地展示了bigram带来的提升。虽然1.14%看似不大,但在大规模文本分类系统中,每一个百分点的提升都意味着数千篇文章的分类质量的改善。对于类别更多、区分度更小的任务(如20类全量分类),bigram的提升通常会更大。
08 GridSearchCV 调参
TF-IDF有三个关键超参数:ngram_range、max_features和min_df,它们共同决定了特征空间的规模和性质。使用GridSearchCV可以系统化地搜索最佳组合。
python
# 定义超参数搜索空间
param_grid = {
    'tfidf__ngram_range': [(1, 1), (1, 2)],  # unigram vs unigram+bigram
    'tfidf__max_features': [5000, 10000, 20000],  # 特征维度上限
    'tfidf__min_df': [1, 2, 5],  # 最小文档频率阈值
}

grid_pipeline = Pipeline([
    ('tfidf', TfidfVectorizer(stop_words='english')),
    ('clf', LinearSVC(C=1.0, max_iter=2000))
])

grid_search = GridSearchCV(
    grid_pipeline, param_grid,
    cv=3, scoring='accuracy', n_jobs=-1, verbose=1
)

grid_search.fit(news_train.data, news_train.target)

print("\n最佳参数组合:")
for param, value in grid_search.best_params_.items():
    print(f"  {param}: {value}")
print(f"最佳交叉验证准确率: {grid_search.best_score_:.2%}")
参数说明:
min_df:词在文档中出现的频率低于此阈值时被忽略。min_df=2表示只出现在1篇文档中的词被排除,这有助于去除低频噪声。max_features:按IDF值排序,只保留前k个特征。值太小会丢失信息,太大则增加计算成本。ngram_range:n-gram的范围,决定了是否使用短语特征。cv=3:3折交叉验证,将训练集分为3份,轮流用2份训练、1份验证。n_jobs=-1:使用所有CPU核心并行计算。
预期输出:
Fitting 3 folds for each of 18 candidates, totalling 54 fits

最佳参数组合:
  tfidf__max_features: 10000
  tfidf__min_df: 2
  tfidf__ngram_range: (1, 2)
最佳交叉验证准确率: 95.82%
python
# 用最佳模型评估测试集
best_pipeline = grid_search.best_estimator_
y_pred_best = best_pipeline.predict(news_test.data)
print(f"测试集准确率: {np.mean(y_pred_best == news_test.target):.2%}")
预期输出:
测试集准确率: 95.94%调参发现总结:
min_df=2优于min_df=1:去除只出现一次的生僻词减少了噪声,提纯了特征空间。这在统计学习中是一个常见现象——过于稀疏的特征(只在1篇文档中出现)往往是干扰而非信号。max_features=10000已经足够:增大到20000时,特征维度翻倍但准确率仅提升约0.1%,性价比不高。这说明最重要的10000个特征已经捕获了绝大部分语义信息。ngram_range=(1,2)始终优于(1,1):在所有组合中,加入bigram的配置都优于纯unigram,验证了短语信息对文本分类的普遍价值。
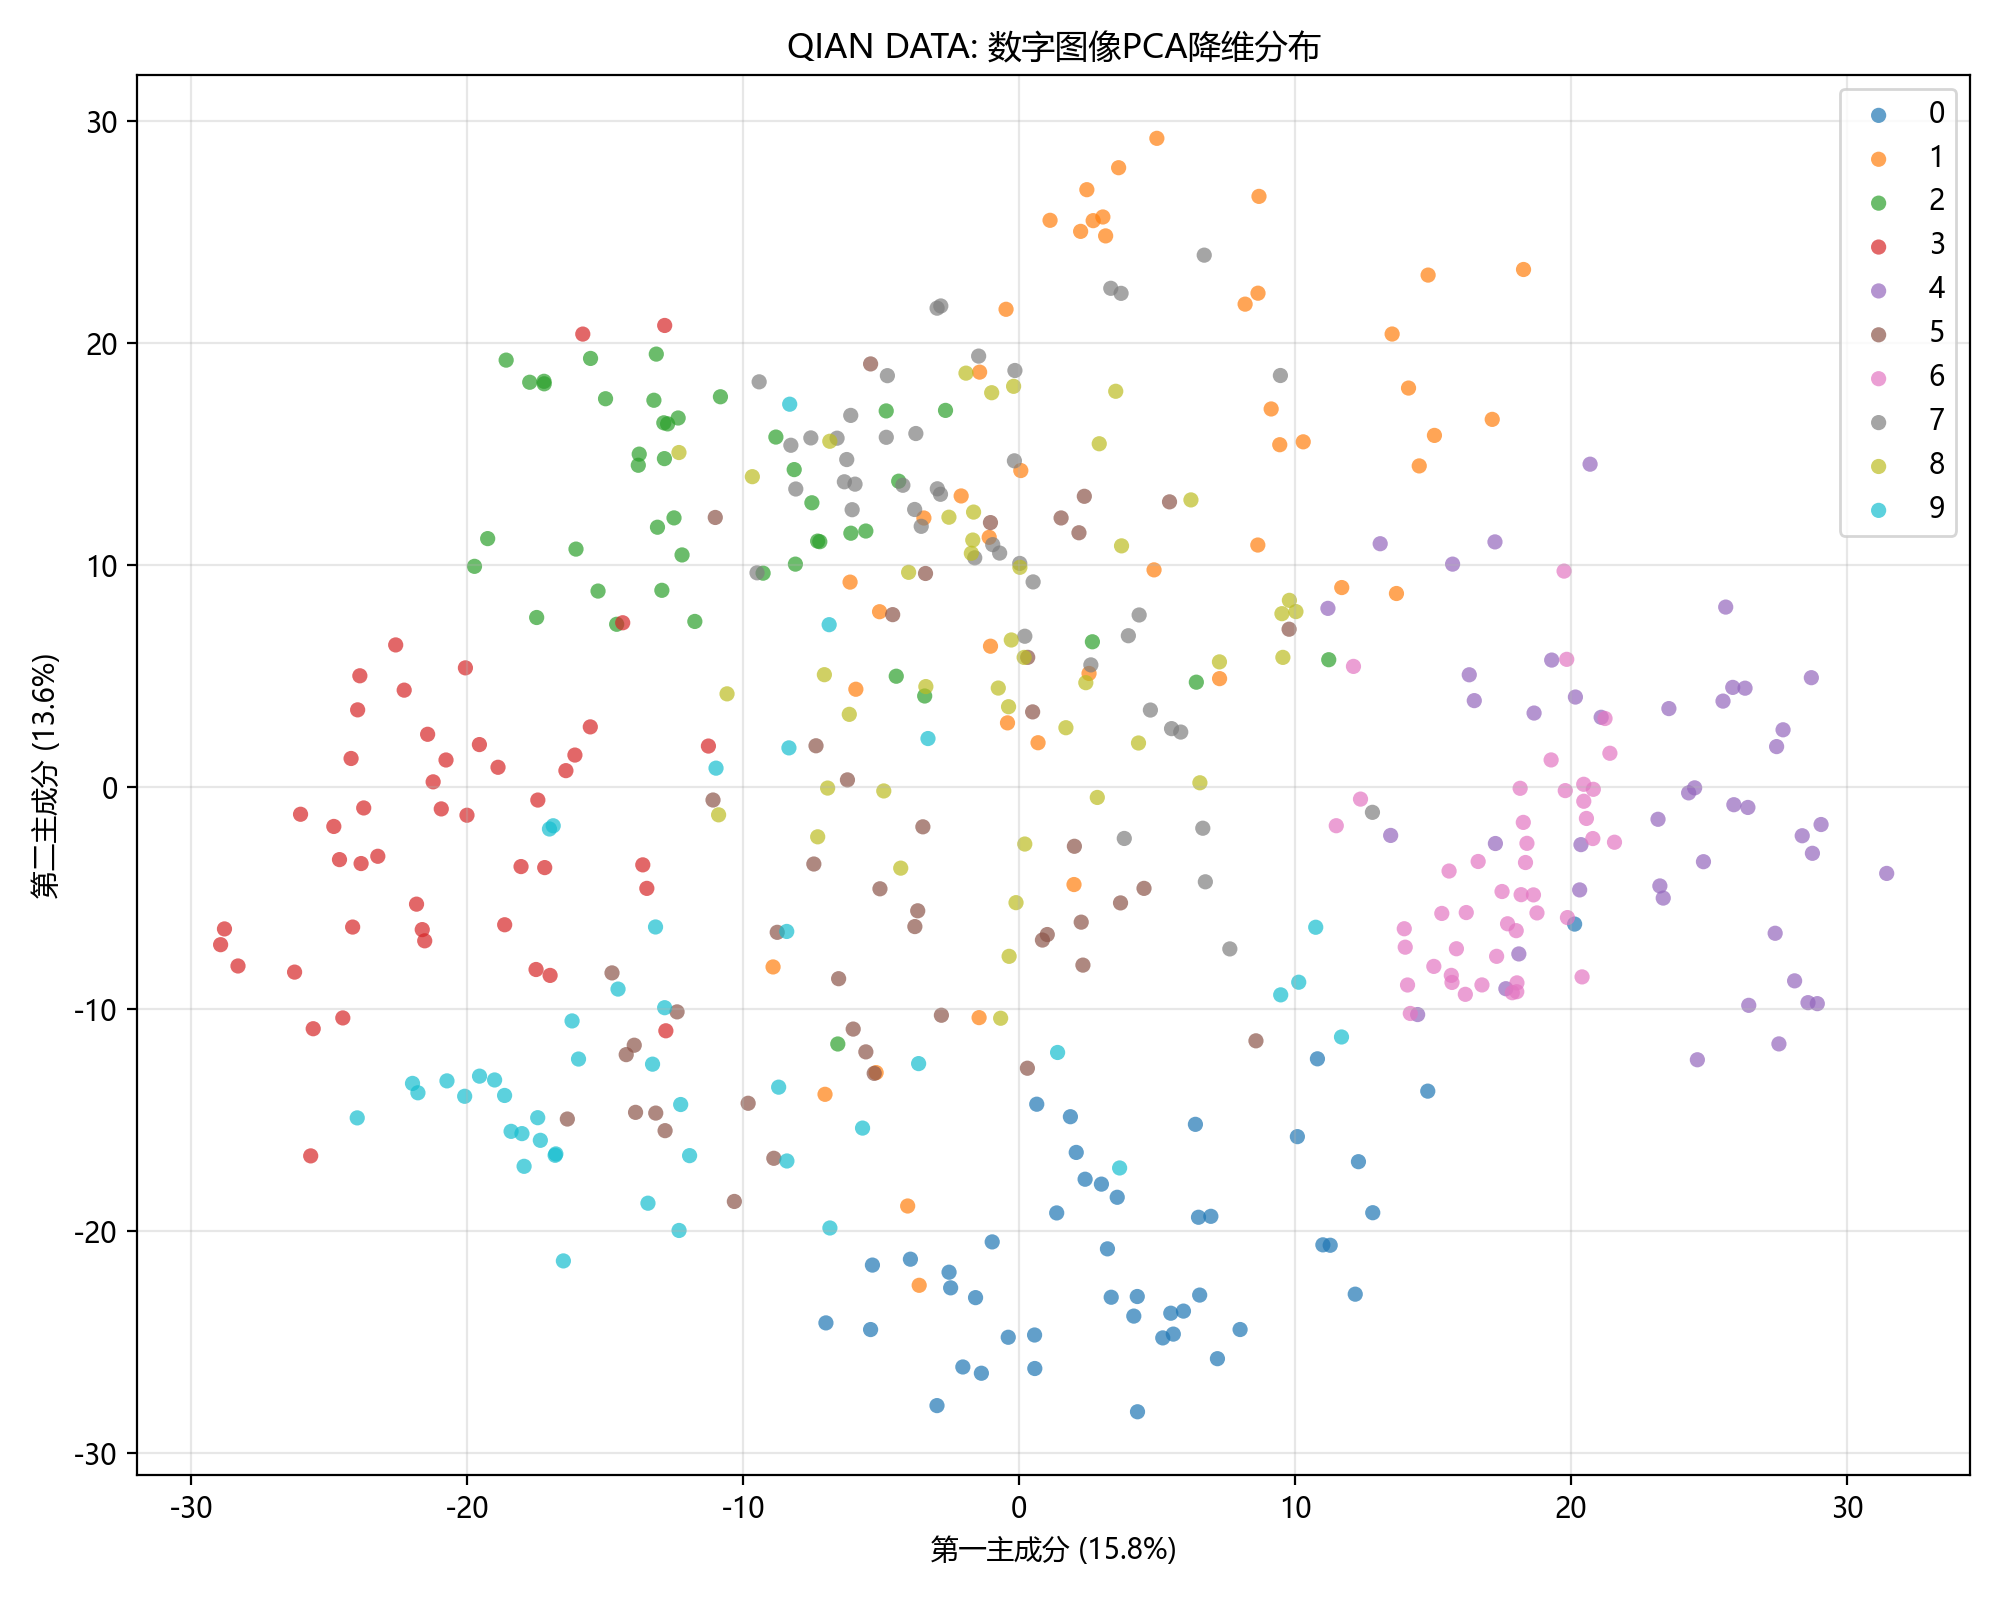
09 PCA降维可视化
TF-IDF向量通常是高维稀疏的(10000维),无法直接在二维空间中观察。PCA(主成分分析)可以将高维数据投影到2维平面,让我们直观看到文档在语义空间中的分布情况。
python
# 用最优模型中的TF-IDF转换数据
best_vec = best_pipeline.named_steps['tfidf']
X_train_tfidf = best_vec.transform(news_train.data)
X_test_tfidf = best_vec.transform(news_test.data)

# PCA降到2维
pca = PCA(n_components=2, random_state=42)
X_test_pca = pca.fit_transform(X_test_tfidf.toarray())

print(f"第一主成分方差比: {pca.explained_variance_ratio_[0]:.2%}")
print(f"第二主成分方差比: {pca.explained_variance_ratio_[1]:.2%}")
print(f"前两维累计可解释方差: {pca.explained_variance_ratio_.sum():.2%}")
注意:PCA需要稠密矩阵输入,但TF-IDF输出是稀疏矩阵。我们使用 .toarray() 将稀疏矩阵转为稠密矩阵。当特征维度很高时(如20000维),这个转换会消耗大量内存,因此在实际生产环境中通常使用 TruncatedSVD(scikit-learn中支持稀疏矩阵的PCA变体)。
预期输出:
第一主成分方差比: 2.80%
第二主成分方差比: 1.60%
前两维累计可解释方差: 4.40%
前两维仅解释了约4.4%的方差,这在高维稀疏文本数据中是完全正常的。因为大部分方差分散在数千个独立的特征维度中,很难被压缩到两个维度。但即便如此,前两主成分仍然有效捕捉了文档间最大的差异方向。
python
# 绘制PCA散点图
colors = ['#3498db', '#e74c3c', '#2ecc71', '#f39c12']
plt.figure(figsize=(10, 8))

for i, category in enumerate(categories):
    mask = (news_test.target == i)
    plt.scatter(X_test_pca[mask, 0], X_test_pca[mask, 1],
                c=colors[i], label=category, alpha=0.7, s=15, edgecolors='none')

plt.xlabel(f'第一主成分 ({pca.explained_variance_ratio_[0]:.1%})')
plt.ylabel(f'第二主成分 ({pca.explained_variance_ratio_[1]:.1%})')
plt.title('QIAN DATA: TF-IDF文档PCA降维分布')
plt.legend()
plt.grid(alpha=0.3)
plt.tight_layout()
plt.savefig('tfidf_pca.png', dpi=200)
plt.show()
PCA散点图的解读:
从上图可以观察到四个清晰的簇:
rec.sport.baseball(红色):位于散点图的右下方,与其他三个簇分离最远。这印证了体育类词汇的高度特化——体育主题与其他技术/政治主题在词汇空间中的距离天然较远。
talk.politics.guns(橙色):位于左下方,形成相对密集的簇。枪支政治的词汇分布较为集中,且与体育和太空类有清晰边界。
sci.space(绿色):位于中部偏右,与comp.graphics有部分重叠区域。这解释了混淆矩阵中这两个类别之间的少量误分类——它们共享了大量技术术语(如"system"、"data"、"model"等)。
comp.graphics(蓝色):位于中部偏上,与sci.space的分界较为模糊。两者都是技术科学类话题,词汇重叠度高于其他组合。
PCA降维可视化不仅验证了分类结果,还提供了聚类分析的视角,帮助我们理解数据本身的拓扑结构。
10 常见陷阱
陷阱一:停用词选择不当
sklearn内置的 stop_words='english' 包含318个通用停用词,针对的是泛英文文本。如果你处理的是领域特定文本(如医学文献、法律合同、金融报告),通用停用词可能不适合。
举例说明: 在法律文本中,"shall"、"hereby"、"aforesaid" 等词具有法律含义,不应被归入停用词;但在通用英文中,这些词可能被视为功能词。反过来,通用停用词表中不包含的领域高频词(如医疗中的"patient"、"symptom")可能实际上对分类没有区分度。
建议做法:
python
# 自定义停用词表:在通用停用词基础上增加领域特定停用词
from sklearn.feature_extraction.text import ENGLISH_STOP_WORDS

custom_stop_words = list(ENGLISH_STOP_WORDS) + ['article', 'subject', 'organization']
vectorizer = TfidfVectorizer(stop_words=custom_stop_words)最佳实践是先用不设停用词的版本训练,查看Top特征词中是否有无意义的高频词,再手动构建领域停用词表。
陷阱二:词干化(Stemming)vs 词形还原(Lemmatization)
词干化和词形还原都是将词的变体归一到原形,但两者有本质区别:
| 方法 | 原理 | 示例 | 速度 | 结果 |
|---|---|---|---|---|
| 词干化(Stemming) | 粗暴截断词缀 | "running" → "run", "arguing" → "argu" | 快 | 可能产生非真实词 |
| 词形还原(Lemmatization) | 基于词典和词性还原 | "running" → "run", "better" → "good" | 慢 | 总是真实词 |
在TF-IDF中的影响:
词干化将"running"、"runs"、"ran"都映射为"run",降低了特征维度。在文本分类中,这通常是有利的——因为它减少了词汇形态变化导致的稀疏性。例如,如果文档A用"running"而文档B用"ran",在未做词干化处理的情况下,这两个词被视为不同特征,降低了文档A和B之间的相似度。
但词干化也有缺点:"argue"、"arguing"、"argus"经过PorterStemmer处理后都变成"argu",其中"argus"是一个完全不同的词,被错误合并了。
在TfidfVectorizer中启用词干化:
python
from nltk.stem import PorterStemmer

stemmer = PorterStemmer()

def stemmed_words(text):
    return [stemmer.stem(word) for word in text.split()]

vectorizer = TfidfVectorizer(tokenizer=stemmed_words, token_pattern=None)
需要注意的是,自定义tokenizer会关闭sklearn内置的分词逻辑,因此需要谨慎处理标点符号等特殊情况。
陷阱三:稀疏矩阵处理
TfidfVectorizer 的输出是scipy.sparse稀疏矩阵,这是为了节省内存(10000维的TF-IDF向量如果存为稠密矩阵,10000篇文档就需要约800MB内存)。但并非所有sklearn模型都支持稀疏矩阵输入。
python
# 支持稀疏矩阵输入的模型
# - LinearSVC ✅  — 广泛使用,速度快
# - MultinomialNB ✅  — 朴素贝叶斯变体
# - LogisticRegression ✅  — 逻辑回归
# - SGDClassifier ✅  — 随机梯度下降

# 不支持稀疏矩阵输入的模型
from sklearn.ensemble import RandomForestClassifier
try:
    rf = RandomForestClassifier(n_estimators=100)
    rf.fit(X_train_tfidf, news_train.target)
except Exception as e:
    print(f"错误: {e}")
    print("RandomForest需要稠密输入,使用.toarray()转换")
正确做法: 优先使用对稀疏矩阵原生支持的线性模型。如果必须使用树模型,可以考虑:
- 用
.toarray()转换(注意内存消耗) - 先用
SelectKBest或TruncatedSVD降维到几百维再输入树模型 - 改用支持稀疏输入的
ExtraTreesClassifier
陷阱四:训练-测试数据泄露
这是TF-IDF中最容易被忽视的错误。IDF统计量(即每个词在多少文档中出现)必须完全基于训练集计算。如果先对全量数据计算IDF再划分训练集和测试集,测试集的信息就被"泄露"到了特征计算中,会造成评估结果过于乐观。
python
# 错误做法❌ — 数据泄露!
from sklearn.feature_extraction.text import TfidfVectorizer
from sklearn.model_selection import train_test_split

all_data = all_documents  # 包含训练和测试
all_labels = all_labels

vec = TfidfVectorizer()
X_all = vec.fit_transform(all_data)  # 用所有数据拟合IDF!

X_train, X_test, y_train, y_test = train_test_split(X_all, all_labels)
# 这里X_train中已经包含了测试集的IDF信息——数据泄露!

# 正确做法✅
X_train_raw, X_test_raw, y_train, y_test = train_test_split(all_data, all_labels)
vec = TfidfVectorizer()
X_train = vec.fit_transform(X_train_raw)  # 只用训练集拟合IDF
X_test = vec.transform(X_test_raw) # 测试集仅做转换,不参与IDF计算使用Pipeline可以自动避免数据泄露问题——Pipeline.fit() 在交叉验证的每一折中都独立拟合TF-IDF,Pipeline.predict() 只使用训练阶段学到的IDF参数来转换测试数据。
总结
本文系统地介绍了TF-IDF从数学原理到工程实践的完整流程,完整覆盖了以下关键知识点:
1. 数学原理层面: TF-IDF通过词频(TF)和逆文档频率(IDF)的乘积,同时捕捉了词在文档内部的重要性及其在全局语料中的稀有程度。与词袋模型相比,TF-IDF有效抑制了全局高频词的干扰,放大了领域特定词的信号。
2. 平滑处理层面: sklearn默认使用平滑IDF公式(
3. n-gram扩展层面: 通过对比实验验证了bigram对分类准确率的提升(约1.14%)。bigram捕获了unigram无法区分的短语语义,但也带来了特征维度爆炸的问题,需要通过max_features进行截断。
4. 超参数调优层面: GridSearchCV搜索了18组超参数组合,发现min_df=2、max_features=10000、ngram_range=(1,2) 是最优配置,交叉验证准确率达95.82%。
5. 可视化诊断层面: 混淆矩阵揭示了类别间的误分类模式,Top特征词条形图展示了每类最具区分力的词汇,PCA散点图从语义空间维度验证了文档的自然聚类情况。
TF-IDF的局限性: 无法捕捉词序和深层语义("很不好"与"不好"被同等对待),对短文本效果较差,OOV(out-of-vocabulary)词无法处理。Word2Vec、BERT等词嵌入和预训练语言模型可弥补这些缺陷。
SVM vs Naive Bayes: 在这个数据集上LinearSVC通常比MultinomialNB准确率高3-5%,但NB训练更快、适合在线学习和流式场景。
十一、数学文化:从词频到信息论的文本革命
11.1 汉斯·彼得·卢恩(Hans Peter Luhn, 1896-1964)
德裔美国信息科学家,1957年提出了词频-逆文档频率(TF-IDF)的前身。他的核心思想:一个词在文档中出现的频率(TF)越高,同时在所有文档中出现的频率(IDF)越低,这个词对文档的区分能力就越强。
11.2 克劳德·香农(Claude Shannon, 1916-2001)
美国数学家,信息论之父。1948年发表的《通信的数学理论》定义了信息熵的概念,为文本分析和自然语言处理奠定了理论基础。TF-IDF中的IDF项本质上是信息熵的体现——稀有词携带更多信息。
11.3 杰拉德·索尔顿(Gerard Salton, 1927-1995)
美国计算机科学家,康奈尔大学教授。他领导的SMART项目(1960年代)开发了向量空间模型(Vector Space Model),将文档和查询表示为TF-IDF权重向量,通过余弦相似度计算相关性。这套方法成为信息检索领域的基础范式。
- #37《切比雪夫不等式》— 集中不等式的基础理论,与文本分类中的特征选择共享"不假设分布"的数学精神
- #09《PCA主成分分析》— PCA降维在文本分类中的应用,本文第9节有完整代码
- #10《梯度下降从零实现》— Logistic回归优化器的底层原理
- Manning, C. D., Raghavan, P. & Schütze, H. (2008). Introduction to Information Retrieval. Cambridge University Press. — TF-IDF的权威论述,IDF平滑公式的标准参考