Vintage 分析——批次×账龄:暴露速度、违约高峰与客群分层
本文为 AI 辅助创作,数据实测与结论推导由作者完成。
关键词:Vintage 分析,账龄,生存曲线,风险函数,右删失
先看一个现象:2018 年新发放贷款的违约率只有 1.79%,而 2015 年是 18%、2016 年是 15.7%——新贷款看起来永远比老贷款安全得多。
这背后不是客群质量的"革命性改善",而是账龄效应:贷款的风险是随发放时间逐步暴露的,新批次的违约还没来得及发生。如果不把账龄对齐,直接拿"当前违约率"跨批次比较,结论必然失真。
同一批 2018 年发放的贷款,如果按账龄对齐——都只看"发放后 6 个月内的表现"——违约率是 2.4%,和 2013、2016 年历史批次几乎一模一样。客群没有变好,只是这些贷款太年轻,还没来得及违约。
这篇用 Vintage 分析(账龄分析)把账龄效应拆开讲透:把每笔贷款放回它的时间轴,横着看违约怎么随账龄暴露,竖着看客群真实怎么变,最后用风险函数告诉你违约高峰到底在哪。
Vintage 表:把每笔贷款放回时间轴
Vintage 分析的思想很简单:不要拿"今天的状态"比较不同时间发放的贷款,要拿"发放后第 N 个月的状态"比较。
做法:把贷款按发放季度分成 cohort(同批),对每一批,统计"发放后 3/6/12/18/24/36 个月内累计违约"的比例:
违约时点用最后还款日近似(最后一次还款后不再还=违约,比真实核销日偏早约 4 个月,但所有批次偏差一致,跨批比较不受影响)。数据:LendingClub 225.7 万笔(2007-2018),剔除无信用分记录样本。
Vintage 分析表(行=发放季度,列=账龄,单位%):
| cohort | n | 3月 | 6月 | 12月 | 18月 | 24月 | 36月 |
|---|---|---|---|---|---|---|---|
| 2008Q1 | 1,013 | 1.4 | 3.8 | 10.2 | 14.5 | 18.7 | 22.8 |
| 2009Q1 | 895 | 1.1 | 3.6 | 6.0 | 8.2 | 11.1 | 13.5 |
| 2010Q1 | 2,172 | 0.8 | 2.2 | 4.6 | 6.3 | 8.3 | 11.0 |
| 2011Q1 | 4,126 | 0.6 | 1.8 | 4.1 | 6.3 | 8.6 | 11.8 |
| 2012Q1 | 8,076 | 0.8 | 2.1 | 5.5 | 8.4 | 11.2 | 15.0 |
| 2013Q1 | 22,706 | 0.5 | 1.7 | 4.6 | 7.7 | 10.4 | 13.9 |
| 2014Q1 | 47,410 | 0.5 | 1.6 | 4.5 | 7.9 | 10.9 | 14.9 |
| 2015Q1 | 84,277 | 0.7 | 2.1 | 5.7 | 9.7 | 13.1 | 17.3 |
| 2016Q1 | 133,887 | 0.7 | 2.4 | 6.6 | 10.7 | 13.6 | — |
| 2017Q1 | 96,779 | 0.7 | 2.3 | 6.0 | 9.5 | — | — |
| 2018Q1 | 107,864 | 0.8 | 2.4 | — | — | — | — |
("—" = 该批贷款还没活到那个账龄,不能填——这是右删失,原理见下)
构造这张表的代码很直接(违约时点用最后还款日近似):
python
import duckdb, pandas as pd

df = duckdb.connect().execute("""
SELECT issue_d, last_pymnt_d, loan_status
FROM read_parquet('lendingclub.parquet') WHERE issue_d IS NOT NULL
""").df()

df["bad"] = df["loan_status"].str.contains("Charged Off|Default", na=False).astype(int)
df["issue"] = pd.to_datetime(df["issue_d"], format="%b-%Y")
df["cohort"] = df["issue"].dt.to_period("Q").astype(str)          # 发放季度
df["lastp"] = pd.to_datetime(df["last_pymnt_d"], format="%b-%Y", errors="coerce")
df["mtd"] = (df["lastp"].dt.to_period("M").astype(int)            # 违约账龄(月)
             - df["issue"].dt.to_period("M").astype(int)).clip(0, 99)

def vintage_table(df, cohorts, ages):
    rows = []
    for c in cohorts:
        sub = df[df["cohort"] == c]
        n = len(sub)
        rows.append([c, n] + [((sub["bad"] == 1) & (sub["mtd"] <= k)).sum() / n * 100
                              for k in ages])
    return pd.DataFrame(rows, columns=["cohort", "n"] + [f"{k}月" for k in ages])

print(vintage_table(df, ["2015Q1", "2018Q1"], [3, 6, 12]))
为什么"—"不能填?这是右删失(right censoring)。表里每个单元格的定义是"该批中发放后 t 个月内违约的比例",它要求批内每笔贷款都活过了 t 个月(违约或不违约都算"活过")。2016Q1 发放的贷款到数据截止只活了约 34 个月——36 月单元格里,那些还没违约的贷款未来可能违约,我们不知道答案。把"不知道"填成 0(没违约)会系统性低估;填成 1 会高估;所以银行标准做法是留空。等这批贷款全部到期(或观察满账龄),单元格自然就确定了。
横着读:每一批贷款的违约时间线
先看每一行怎么走。以 2015Q1 为例:3 个月违约率 0.7% → 6 个月 2.1% → 12 个月 5.7% → 24 个月 13.1% → 36 个月 17.3%。
违约不是均匀发生的,是"暴露"出来的:发放后前 3 个月几乎没人违约(0.7%),到 12 个月已经出来一半(5.7%/17.3%),24 个月后接近平台。把多批的曲线画在一起(账龄对齐),就是经典的 S 形 Vintage 曲线族:
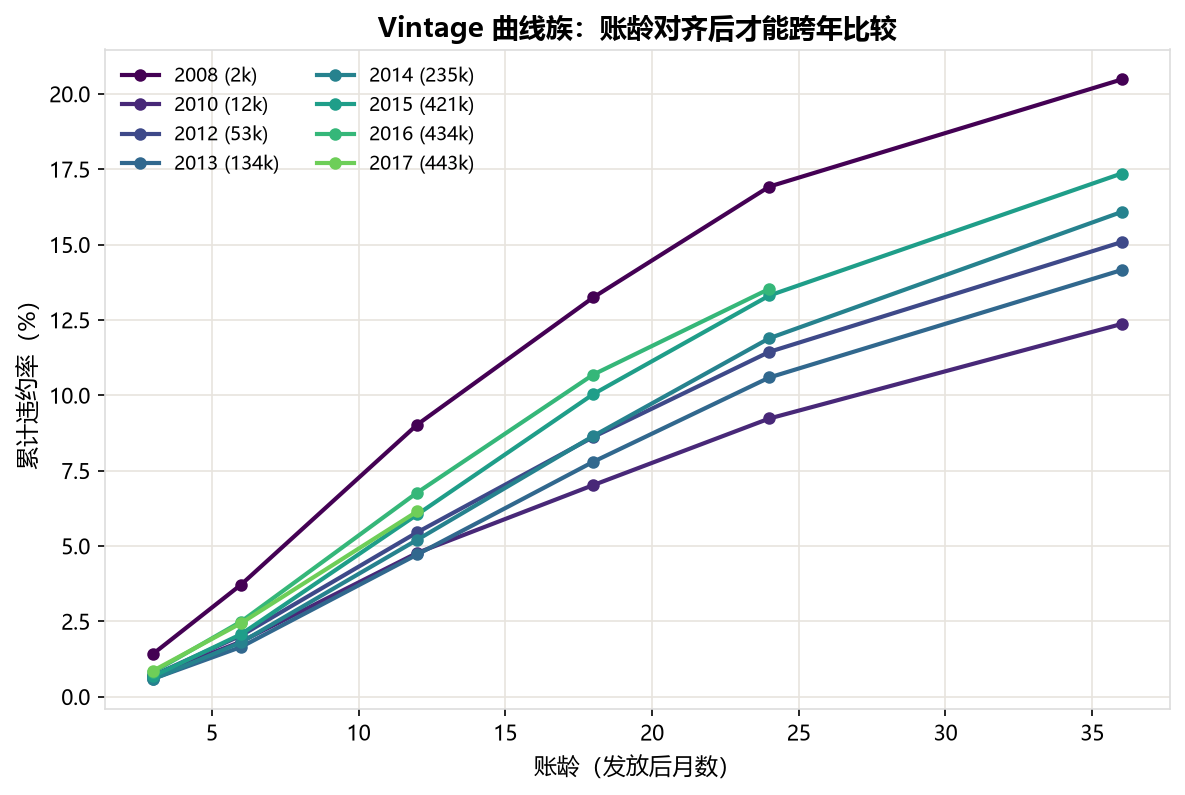
注意图里越新的批次曲线越短(2017/2018 只画到 18/6 个月)——它们只是还没活到那个账龄,跟表现好坏没关系。这就是表格里"—"的意思:右删失。这批贷款里还没违约的那些,未来可能违约,只是我们还没等到。
竖着读:账龄对齐后的真实客群
现在竖着看同一列——同账龄、跨批次。比如 12 月账龄:2008Q1 是 10.2%,2012Q1 是 5.5%,2015Q1 是 5.7%,2016Q1 是 6.6%。
账龄对齐后,客群质量是真实的:2015-2016 的 12 月违约率(5.7%/6.6%)明显高于 2012-2014(5.5%/4.6%/4.5%)——这几年 LendingClub 通过率放宽、客群下沉,真实违约率在上升。18 月账龄同样如此(2015Q1 9.7% vs 2013Q1 7.7%)。
这是 Vintage 表的核心价值:它把"批次差异"和"账龄效应"分开——同一列里只有批次差异,同一行里只有账龄效应。
核心现象:当前违约率被账龄压制
回到开场那个 1.79%。把它放进坐标里看:
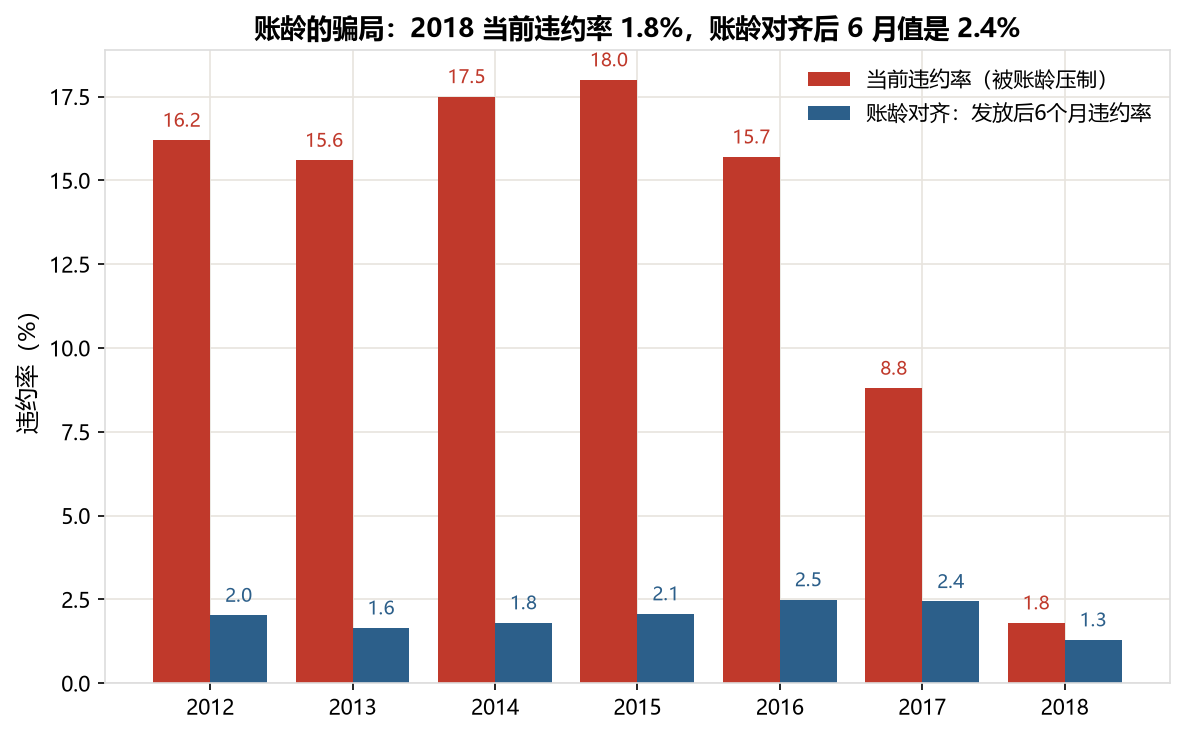
红色柱子是"当前违约率"(直接拿今天的贷款状态算)——2012 年 16.2%、2015 年 18.0%、2017 年暴跌到 8.8%、2018 年 1.8%,看起来客群质量发生了"革命性改善"。
蓝色柱子是账龄对齐后的 6 个月违约率——2012 年 2.1%、2015 年 2.1%、2017 年 2.3%、2018 年 2.4%。几乎一条水平线。
机制很清楚:当前违约率 = 真实违约率 × 已暴露比例。2018 年的贷款只暴露了不到一年(86% 还在贷),违约还没来得及发生;2012 年的贷款已经全部到期,违约全部暴露。红色柱子的"暴跌",是账龄效应压低了新批次的表观违约率,跟客群变好无关。
风险函数:违约高峰在发放后 11 个月
Vintage 表是累计视角。换成风险函数(某账龄时刻的瞬时违约强度)看得更清楚:
风险集法:对每个账龄
python
def hazard_curve(df, max_age=60):
    """风险集法计算违约强度 h(t) = 账龄(t,t+1]违约数 / 风险集"""
    df["obs_m"] = np.minimum((cutoff - df["issue"]).dt.days / 30.44,
                             df["term_m"])          # 观察窗口: min(数据截止, 到期)
    h, n_risk = [], []
    for t in range(max_age):
        at_risk = ((df["obs_m"] >= t) & ((df["bad"] == 0) | (df["mtd"] > t))).sum()
        d = ((df["bad"] == 1) & (df["mtd"] > t) & (df["mtd"] <= t + 1)).sum()
        h.append(d / at_risk if at_risk > 0 else 0.0)
        n_risk.append(at_risk)
    return h
为什么用风险集做分母,不用 cohort 总数? 因为
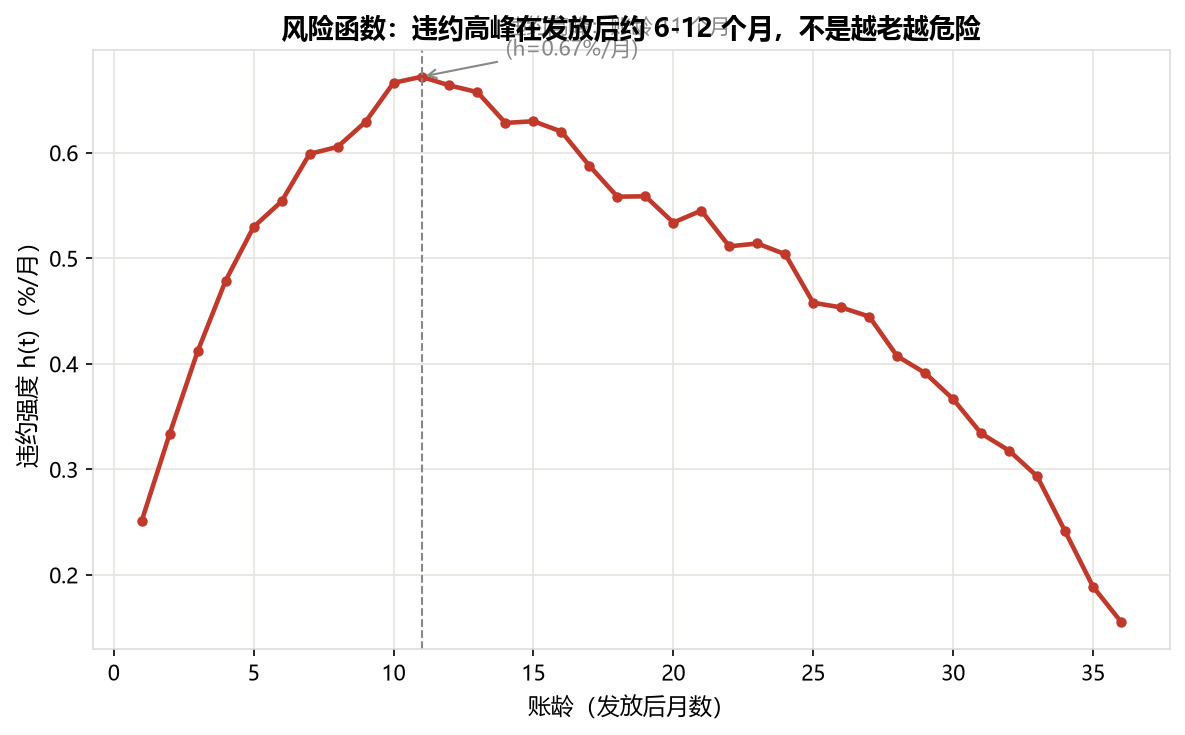
违约高峰在发放后约 11 个月,h≈0.67%/月——不是"时间越长越危险",而是"发放后第一年是危险窗口"。这背后是信贷逻辑:真正的坏客户(欺诈、过度负债)会在 6-12 个月集中暴露(收入断流、多头借贷爆雷);能活过 24 个月的,是经过时间筛选的幸存者,违约强度反而下降。
这个形状对经营的含义是直接的:新批次发放后的 6-18 个月是最需要盯的窗口——催收资源、拨备计提、预警规则都应该向这个账龄段倾斜,而不是平均用力。
分层:不是所有客户都一个节奏
Vintage 曲线是"平均",但客群内部差异巨大。按 fico 分层画 Kaplan-Meier 生存曲线(S(t)=发放后 t 个月仍未违约的比例):
KM 的推导:生存函数
其中
python
def kaplan_meier(sub, max_t=48):
    """KM 生存曲线: 事件=违约(mtd), 删失=未违约在 obs_m 处"""
    t_ev = sub.loc[sub["bad"] == 1, "mtd"].values
    t_cs = sub.loc[sub["bad"] == 0, "obs_m"].values
    surv = np.ones(max_t + 1)
    for t in range(1, max_t + 1):
        n = (t_ev >= t).sum() + (t_cs >= t).sum()      # 风险集
        d = ((t_ev >= t) & (t_ev < t + 1)).sum()       # 本月违约
        surv[t] = surv[t-1] * (1 - d / n) if n > 0 else surv[t-1]
    return surv

km_low  = kaplan_meier(df[df["fico"] < 650])
km_high = kaplan_meier(df[df["fico"] >= 700])
print(1 - km_low[24], 1 - km_high[24])   # 24月累计违约率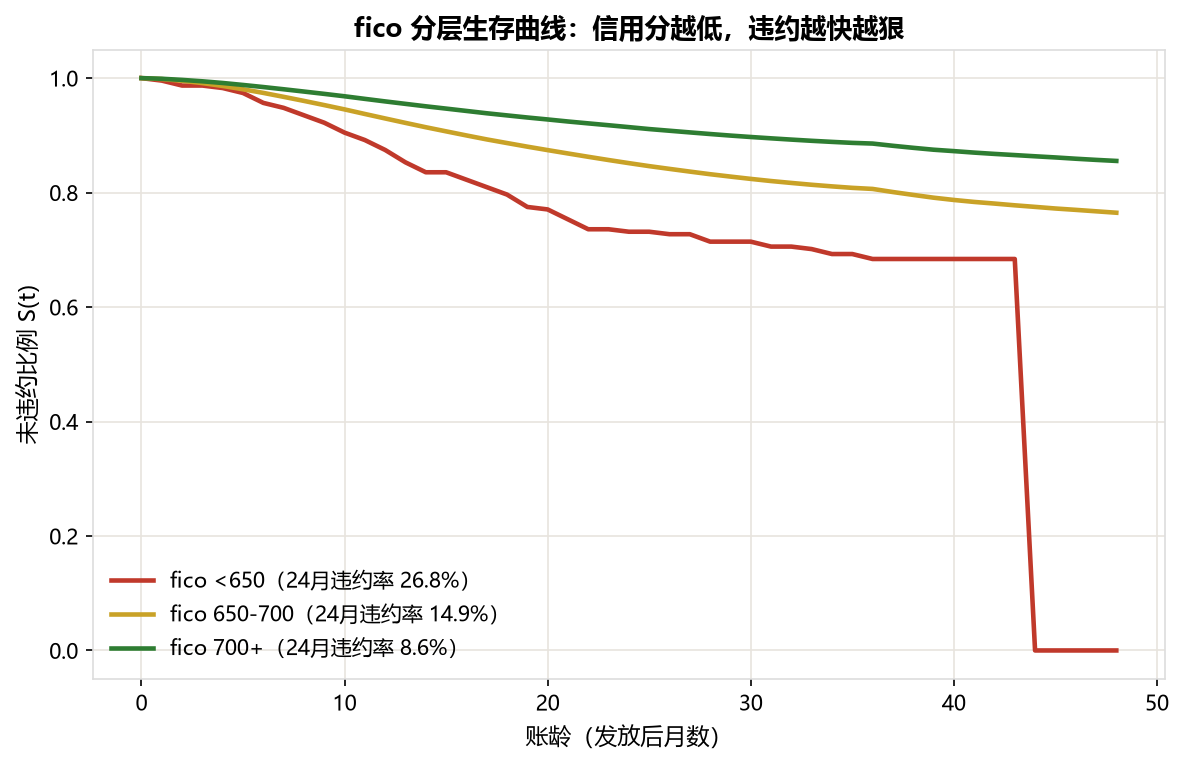
fico <650:24 个月累计违约率 26.8%;650-700:14.9%;700+:8.6%——低分客户不仅违约率高三倍,而且违约来得更快(曲线更陡)。Vintage 的平均曲线(~15%)是这三条线的混合:管理资产组合不能只看总量曲线,要分层看结构——低分段的账龄暴露速度和高分段完全不是一个节奏。
结论:Vintage 分析怎么落地
把整条逻辑收起来:
当前违约率 = 真实违约率 × 已暴露比例。新贷款永远看起来更安全,因为它的违约还没暴露——表观违约率 = 真实违约率 × 已暴露比例。 Vintage 表把账龄效应和批次差异分开:横着读是暴露速度(S 形),竖着读是真实客群(2015-2016 确实在变差)。 风险函数告诉你违约高峰在发放后 11 个月,管理窗口应该聚焦 6-18 个月账龄。 分层生存曲线告诉你低分客户更快更狠,总量曲线掩盖结构。
所以读任何"新增贷款违约率"之前,先问一句:这批贷款发出来多久了?账龄对齐了没有?——这就是 Vintage 分析存在的理由。
边界声明:以上数字在 LendingClub 2,257,017 笔样本(剔除无信用分记录)上测得;违约时点用最后还款日近似(比真实核销日偏早约 4 个月,各批次偏差一致,跨批比较不受影响);数据截止 2018-12,"—"处为右删失未观察满账龄;不同客群/核销政策下具体数字会变,但"账龄效应 + 违约高峰 + 分层差异"三个规律不变。
关键要点:Vintage 表=批次×账龄矩阵,横读暴露速度、竖读真实客群;当前违约率被账龄压制(1.79% 假象 vs 账龄对齐 2.4%);风险函数违约高峰在发放后 11 个月;fico 分层 24 月违约率 26.8%/14.9%/8.6%。
代码与数据:本文所有代码可复现,数据来自 LendingClub 公开数据集(2007-2018Q4)。完整脚本留档在文章同目录 gen_figures.py。