KS 与 AUC——单点 vs 积分,为什么 AUC 相同,KS 能差 40%
本文为 AI 辅助创作,数据实测与结论推导由作者完成。
关键词:KS,AUC,ROC,Mann-Whitney,模型评估
模型评审会上,两个候选模型摆在一起:
- 模型 A:AUC 0.63,KS 0.19
- 模型 B:AUC 0.60,KS 0.16
AUC 高的 A 看着更好;但如果按 KS 排,还是 A 领先——两个指标方向一致,评审没吵起来。
可换一组:两个模型 AUC 都约 0.60——模型 A 的 KS 只有 0.14,模型 B 的 KS 却到 0.20。AUC 一模一样,KS 差了 40%;反过来,KS 相同的两个模型,AUC 也可能差出一截。单看任何一个指标都可能看走眼——这俩到底谁说了算?
这篇把 KS 和 AUC 的数学关系拆到底:一个是单点,一个是积分;在双正态假设下它们有精确的函数关系,现实偏离这个关系,本身就是模型诊断信号。
KS 是什么:单点的最大区分
设好客户分数分布 CDF 为
KS(Kolmogorov-Smirnov) 定义为好坏两个 CDF 的最大垂直距离:
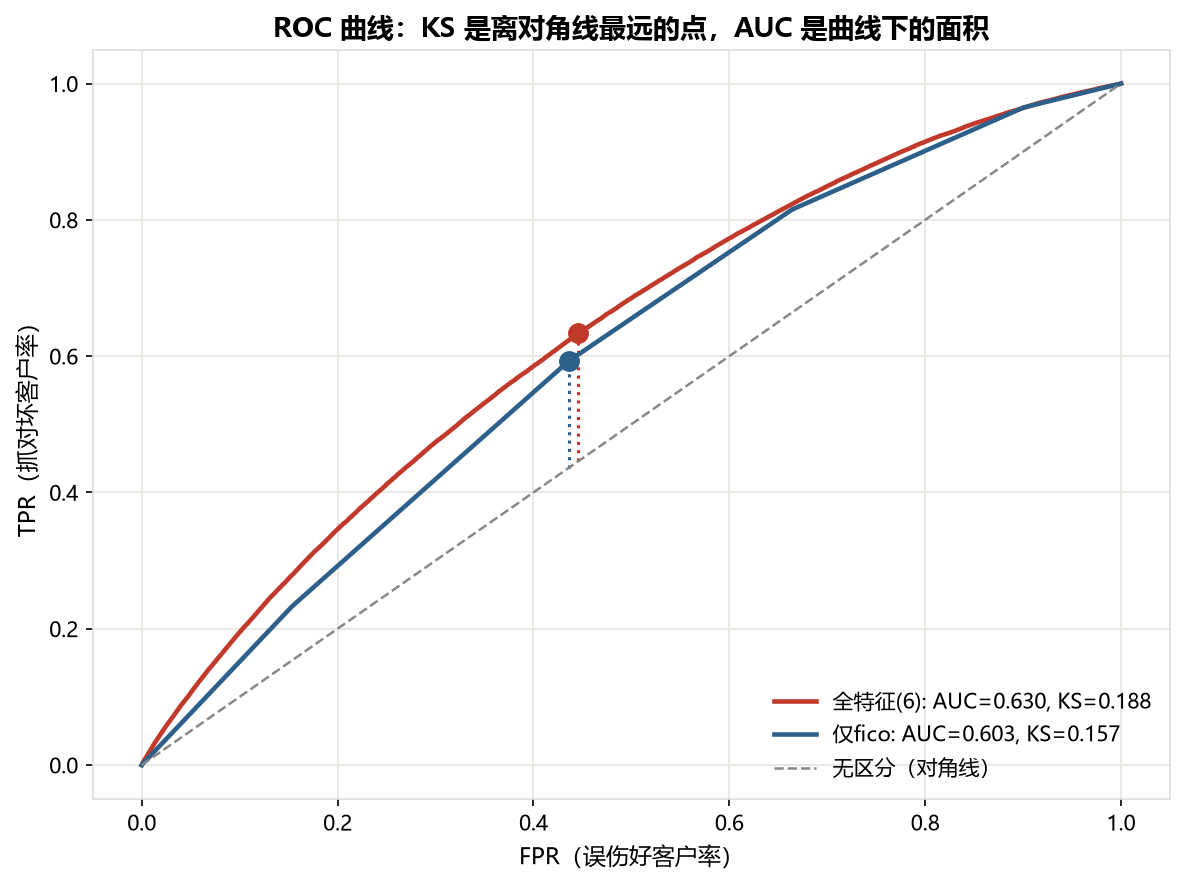
几何上,KS 就是 ROC 曲线上离对角线(
python
def ks_from_roc(fpr, tpr):
    """KS = ROC 曲线上 |TPR-FPR| 的最大值(单点最大区分)"""
    return float(np.max(np.abs(tpr - fpr)))
AUC 是什么:全局的排序概率
AUC 是 ROC 曲线下的面积:
用变量替换(
AUC = 随机抽一个坏客户、一个好客户,坏客户分数更高的概率——它把所有阈值上的表现平均了,是全局排序能力的度量。
单点 vs 积分:为什么没有固定关系
把两个定义并排:
- KS 是曲线上一个点的纵差——最大单点区分
- AUC 是整条曲线下的面积——全部阈值的平均
一个点是函数值,一个是积分值。一般分布下它们之间没有固定的换算关系——知道 KS 推不出 AUC,反之亦然(双正态这个特例见下一节)。两个极端的形状说明问题:
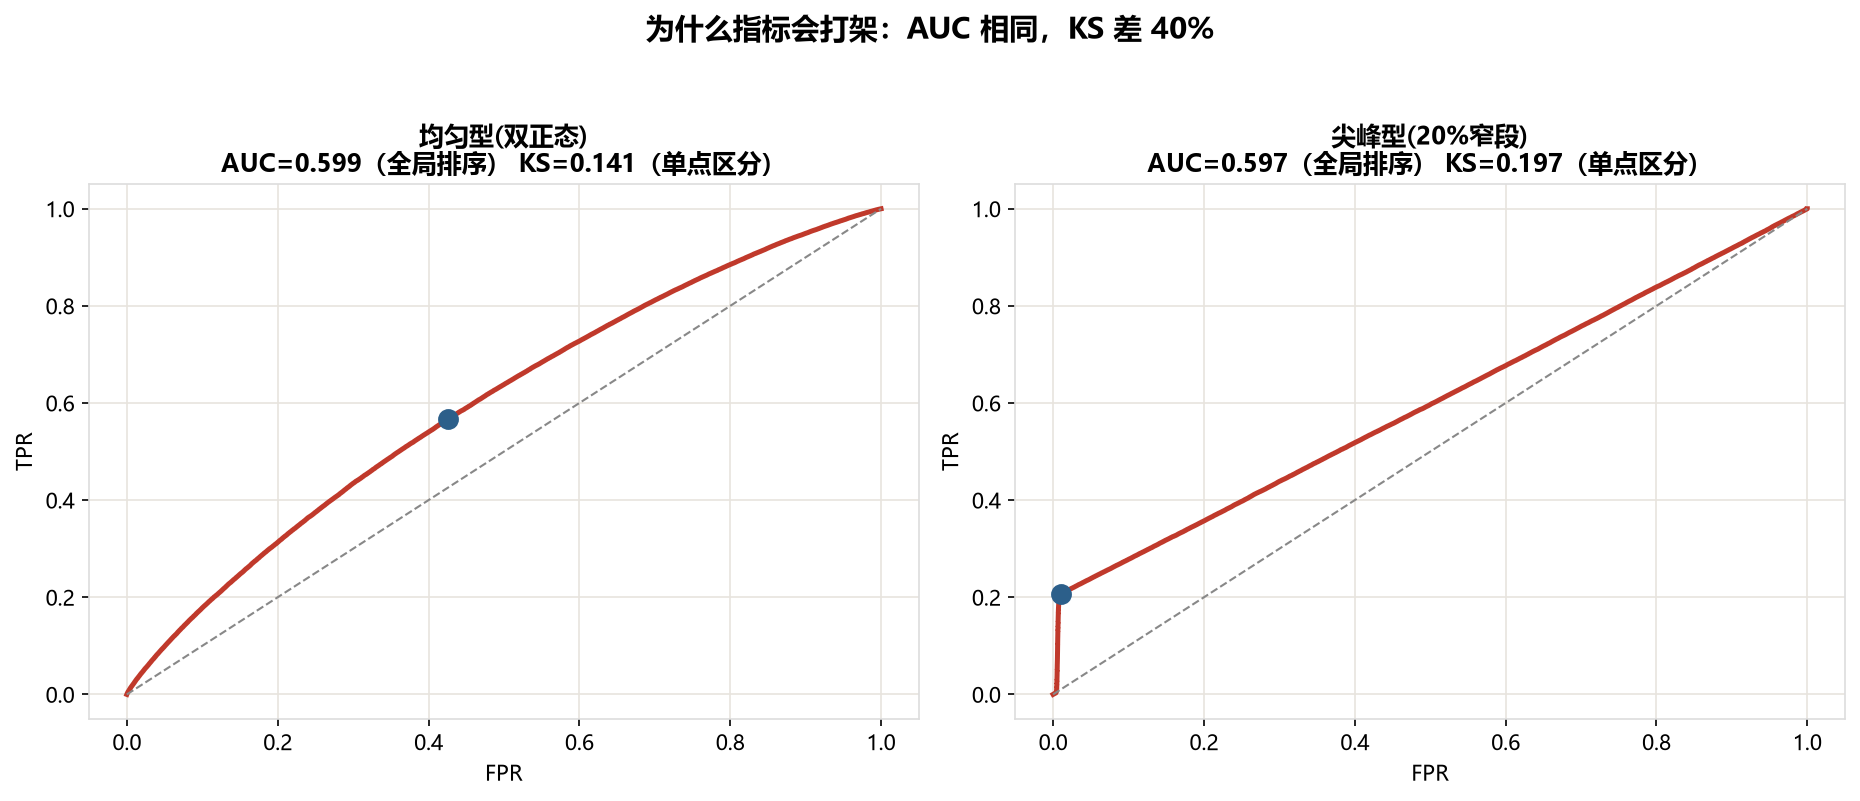
均匀型(左):好坏分数按正态错开,每个阈值都有稳定但温和的区分——KS 和 AUC 同步,落在理论曲线上。
尖峰型(右):绝大多数坏客户与好客户分数重叠(ROC 贴对角线),只有一小撮极端坏客户集中在高分窄段(某阈值处 TPR 陡升)——同样的 AUC 下,KS 明显更高(单点区分突出)。
尖峰型的机理看分数分布更清楚——绝大多数坏客户与好客户重叠,只有一小撮极端离群:
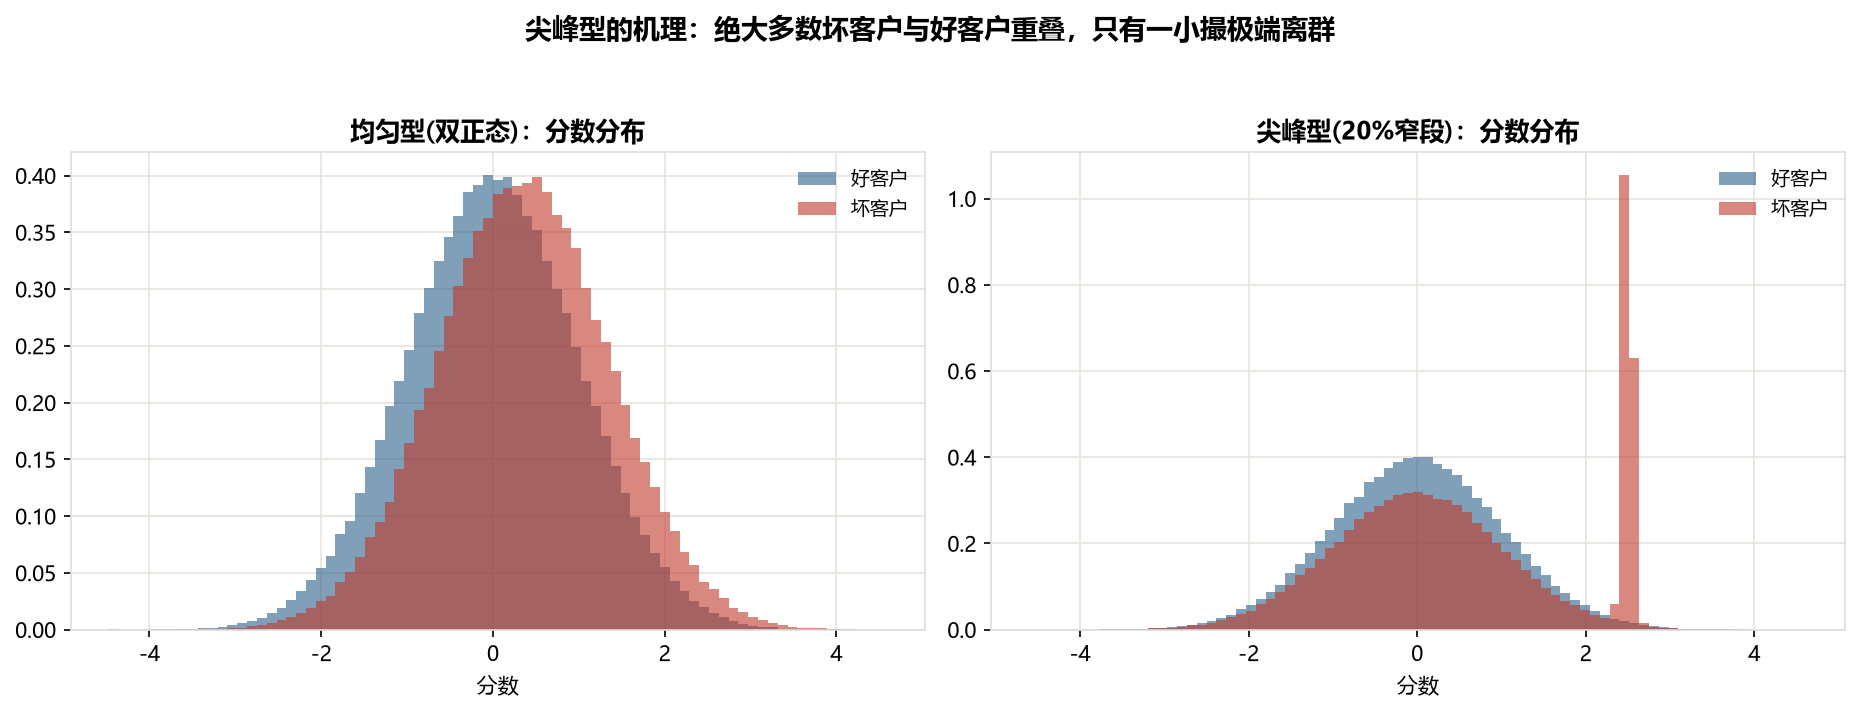
这就是"指标打架"的数学根源:同一个模型,KS 看的是它最好的那一个阈值,AUC 看的是它所有阈值加起来的表现。业务上如果只用单一 cutoff(审批阈值),KS 更相关;如果做全量排序(评分、分层、定价),AUC 更相关。
双正态下的精确关系
什么时候 KS 和 AUC 不再打架?当分数分布是双正态(好客户
AUC:
KS:两个同方差正态 CDF 的差在
令
双正态下,KS 是 AUC 的确定凹函数——不存在打架,知道一个就能推出另一个。数值:
| AUC | 0.70 | 0.80 | 0.90 | 0.95 |
|---|---|---|---|---|
| KS(精确) | 0.29 | 0.45 | 0.64 | 0.76 |
注意:经验近似"KS ≈ 2AUC − 1"是错的(AUC 0.8 会给 0.60,实际 0.45)——真实关系是凹的,AUC 越高,KS 的"通胀"越严重。
实测:你的模型偏离了吗
在 LendingClub 2,257,017 笔上训练 5 个不同特征组合的评分卡,把每个模型的 (AUC, KS) 落在理论曲线上:
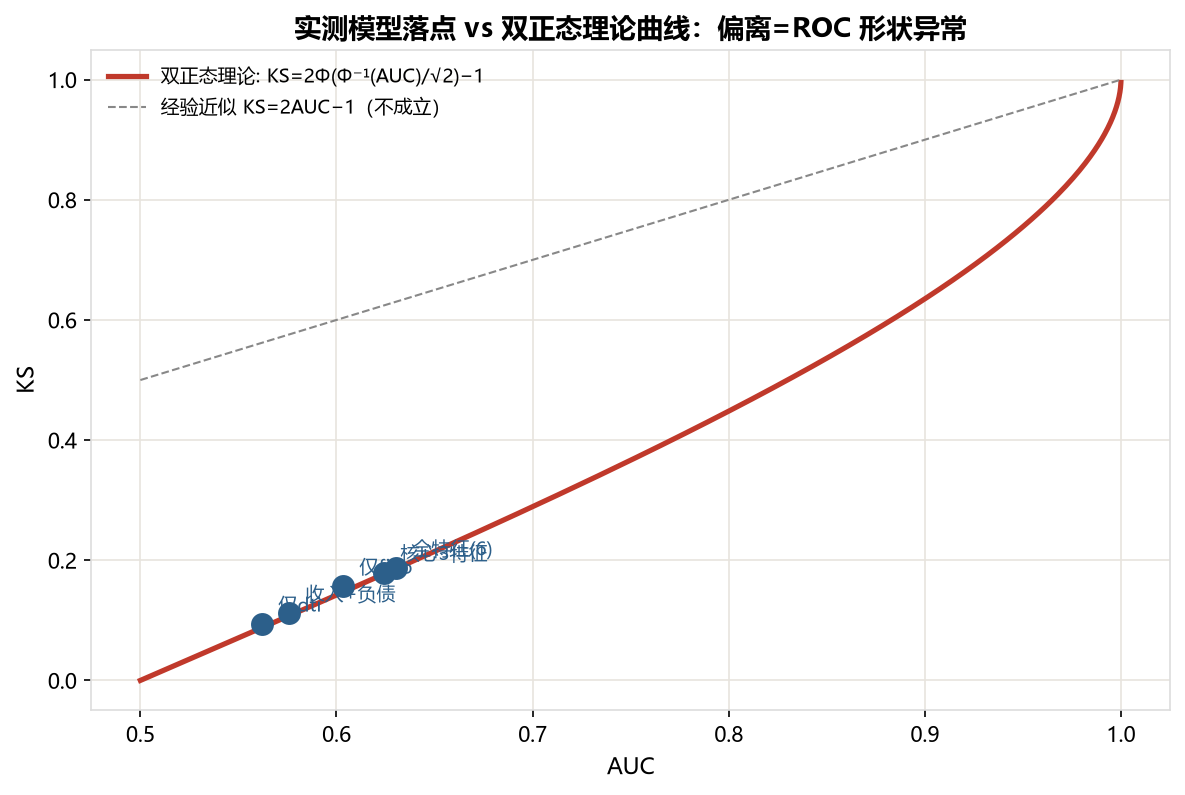
5 个实测点(蓝点)全部落在理论曲线的下方——说明 LendingClub 的 WOE+逻辑回归分数不是双正态(有偏态、长尾、多峰),真实 KS 比双正态预测的低。这正是诊断价值的体现:如果某个模型的落点明显偏离理论曲线,说明它的 ROC 形状异常(尖峰/平台/多段),值得单独查。
模拟对照更直观——两个模拟的 AUC 都约 0.60,但 KS 差了 40%:
| 模拟 | AUC | KS | 理论 KS(同 AUC) | 偏离 |
|---|---|---|---|---|
| 均匀型(双正态) | 0.599 | 0.141 | 0.142 | 贴线(验证关系) |
| 尖峰型(20% 窄段) | 0.597 | 0.197 | 0.138 | +0.059 偏高(尖峰信号) |
均匀型模拟完美落在理论曲线上(验证了公式正确);尖峰型模拟 KS 明显高于理论值——同 AUC 下 KS 偏高 = 单点区分强于整体排序 = ROC 有尖峰。
再看 ROC 本身的形状(图1):KS 点(圆点)是曲线上离对角线最远的位置,AUC 是整个曲线下的面积——一眼看清"单点 vs 积分":
业务怎么用:两个指标各管一段
把数学翻译成业务动作:
| 场景 | 看哪个 | 为什么 |
|---|---|---|
| 模型选型(排序能力) | AUC | 全局排序,不受单一阈值影响 |
| 定审批阈值(单点区分) | KS | 找最优 cutoff 的位置 |
| 风控报告双指标 | 都报 + 落点 | 偏离理论曲线 = ROC 形状异常 = 诊断信号 |
三个实操结论:
第一,双正态假设下不存在打架。 分数近似双正态时,KS 是 AUC 的确定函数,两个指标不会互相矛盾——选型看 AUC 就够,KS 只是它的"翻译"。
第二,同 AUC 下 KS 明显偏高要警惕。 尖峰型模型只在某一段客群有区分度(比如只抓得到极端欺诈者),对中间客群基本随机——用在全量排序上会误伤,这正是"KS 高"的陷阱;反过来 KS 偏低 = 区分均匀(每个阈值都有一点,无突出段),排序型场景这是优点。
第三,用双正态曲线当基准。 每个模型上线前,把 (AUC, KS) 画到理论曲线上:贴线 = 分数近似双正态(正常);明显偏离 = 查 ROC 形状(多峰/尖峰/平台),往往对应特征工程或样本问题。
边界声明:以上数字在 LendingClub 2,257,017 笔样本(剔除缺失,坏账口径 Charged Off/Default)上测得;模拟基于正态分布构造;不同数据/模型下具体数值会变,但"KS 是单点、AUC 是积分、双正态下存在精确关系、现实偏离即诊断信号"四个规律不变。
关键要点:KS=max|TPR−FPR|(单点最大区分),AUC=P(S_b>S_g)(全局排序);双正态下 KS=2Φ(Φ⁻¹(AUC)/√2)−1(凹函数,经验近似 2AUC−1 不成立);同 AUC 下 KS 偏高=ROC 尖峰,实测点偏离理论曲线=形状异常;AUC 选模型、KS 定阈值、落点做诊断。
代码与数据:本文所有代码可复现,数据来自 LendingClub 公开数据集(2007-2018Q4)。完整脚本留档在文章同目录 gen_figures.py。