QIAN数据:门控遗漏定律与设计效应DEFF——定时任务跑了998次只失败4次,就敢说系统可靠吗?
风险科技 2026年9月16日 · 预计阅读 12 分钟
本文由 AI 辅助创作,数据实测与公式推导由作者完成。
(以下系统为作者本人的自动化调度环境,正文已做脱敏:不含作业名、路径与业务数据。)
上个月我给自己的自动化调度系统做了一次体检。翻开执行台账,998 次任务执行,失败 4 次,成功率 99.6%。
这个数字贴在报告里很好看。但同一份记录,换个数法,会得到一个让人不太舒服的答案——出过问题的作业占了 13.8%,是刚才那个数字的 34.4 倍。
两个数字来自同一份台账,都没算错。问题在于,我们平时报的是哪一种,以及报出来的那个数字究竟约束了什么。
先把结论摆出来:这份台账的 998 次执行、失败 4 次,按设计效应折算,有效样本只有约 23 个——名义样本量虚高了 43 倍。要判断"验证够不够",得看三个数:测了多少次(N)、其中多少是真正独立的(DEFF)、这个测法能检出多低的故障率(r)。
关键词:门控遗漏定律,设计效应DEFF,验证充分性,Clopper-Pearson,最优验证次数,定时任务监控
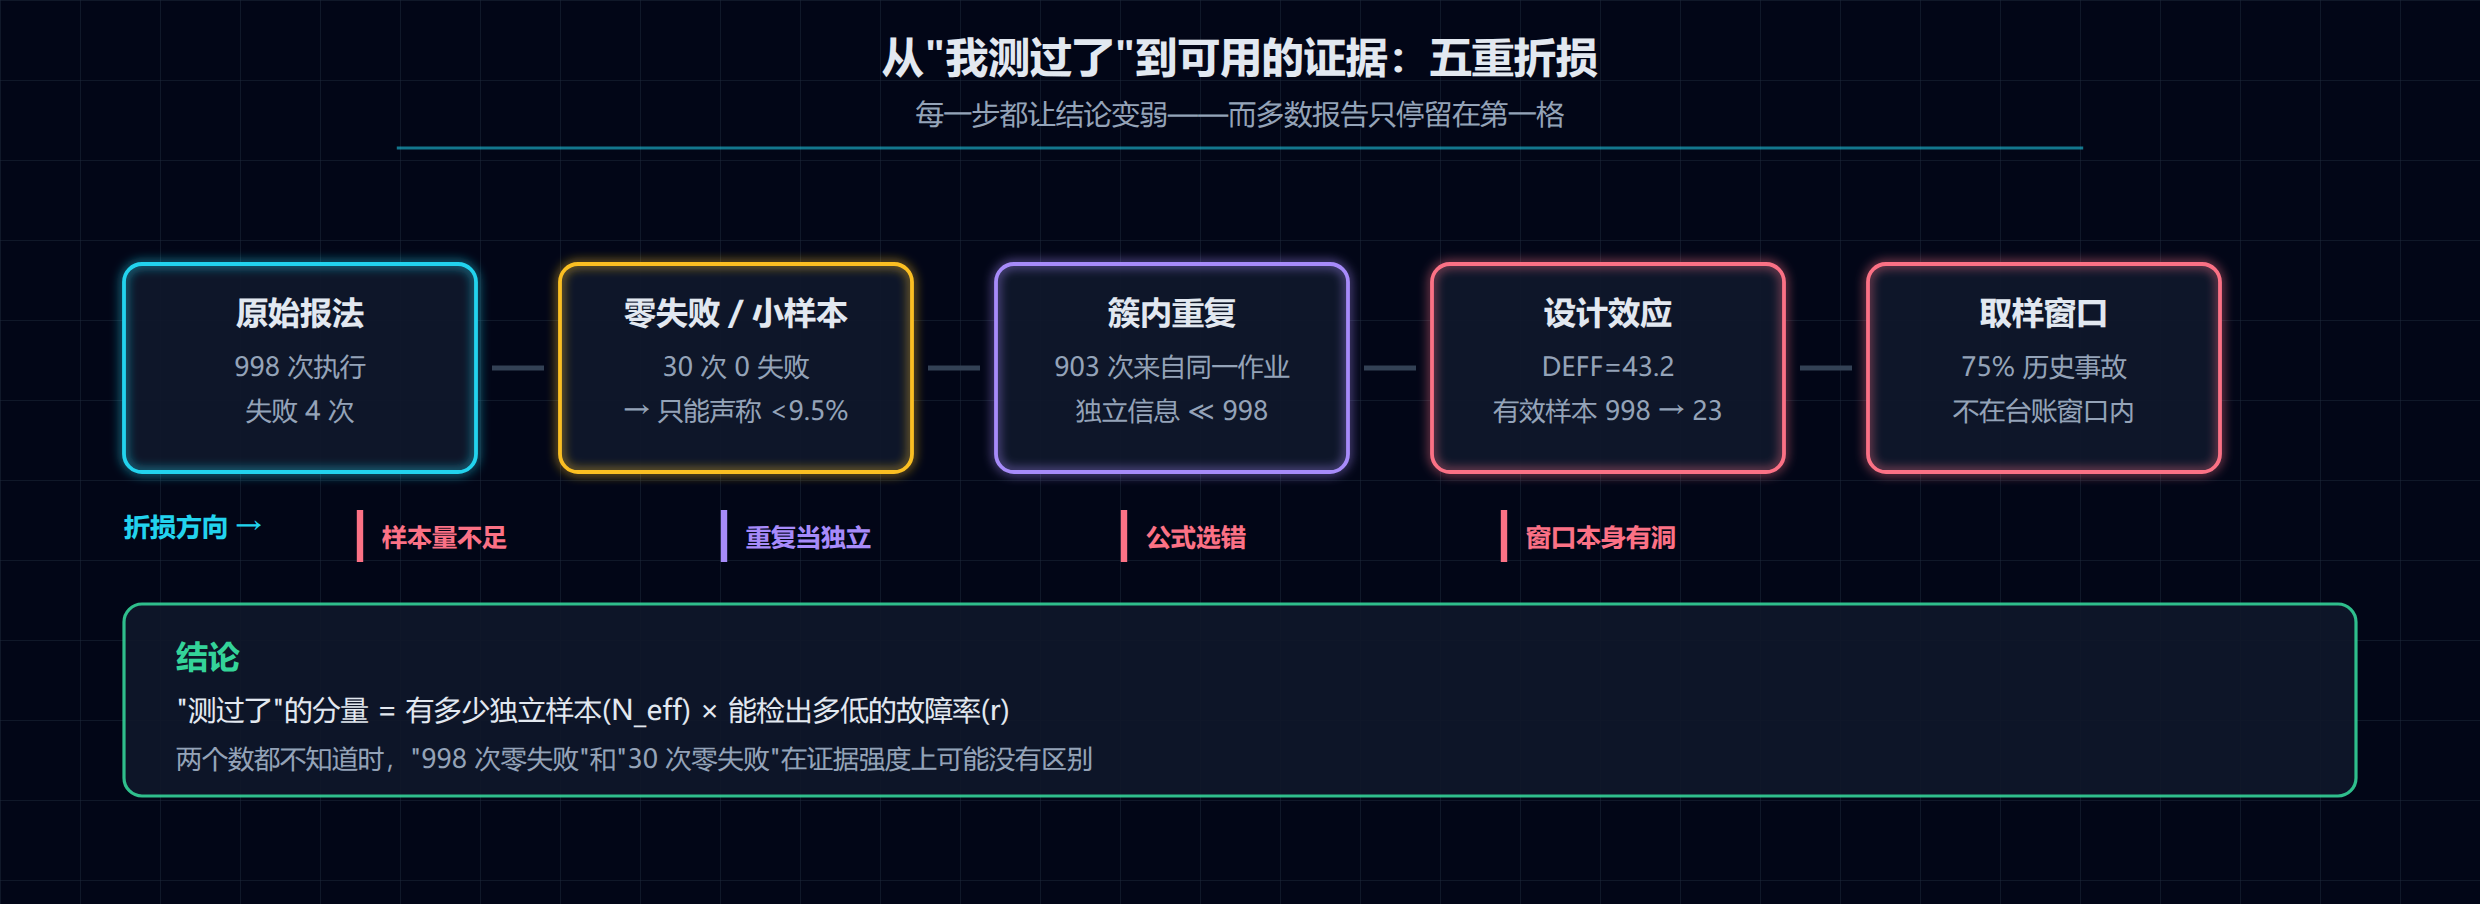
这张图是全文的路线图:从"998 次执行、失败 4 次"这个原始报法出发,结论要经过五重折损才轮到"证据"二字。后面每一节拆掉其中一格。
01 事件:一份"看起来很稳"的台账
先把这份台账摊开。它记录了一段时间内所有定时任务的执行情况:每次执行一行,含作业标识、状态、开始时间。
python
import json
snap = json.load(open('data/ledger_snapshot.json', encoding='utf-8'))
rows = [(e['job'], e['status']) for e in snap['executions']]

print('执行总数  :', len(rows))
print('不同作业数:', len(set(r[0] for r in rows)))
print('失败次数  :', sum(1 for r in rows if r[1] != 'completed'))
执行总数 : 998
不同作业数: 29
失败次数 : 4按执行次数算,失败率是
但"998 次执行"并不是 998 个独立的事件。它们只来自 29 个作业,而且分布极不均匀:
python
sizes = sorted((sum(1 for r in rows if r[0] == j)
                for j in set(r[0] for r in rows)), reverse=True)
print('执行次数分布(前5):', sizes[:5])
print('最大占比        : %.1f%%' % (sizes[0] / len(rows) * 100))
执行次数分布(前5): [903, 8, 7, 7, 7]
最大占比 : 90.5%榜首那个作业一个人跑了 903 次,占全部执行的 90.5%;其余 28 个作业里,多数在整个窗口内只跑了不到 10 次。 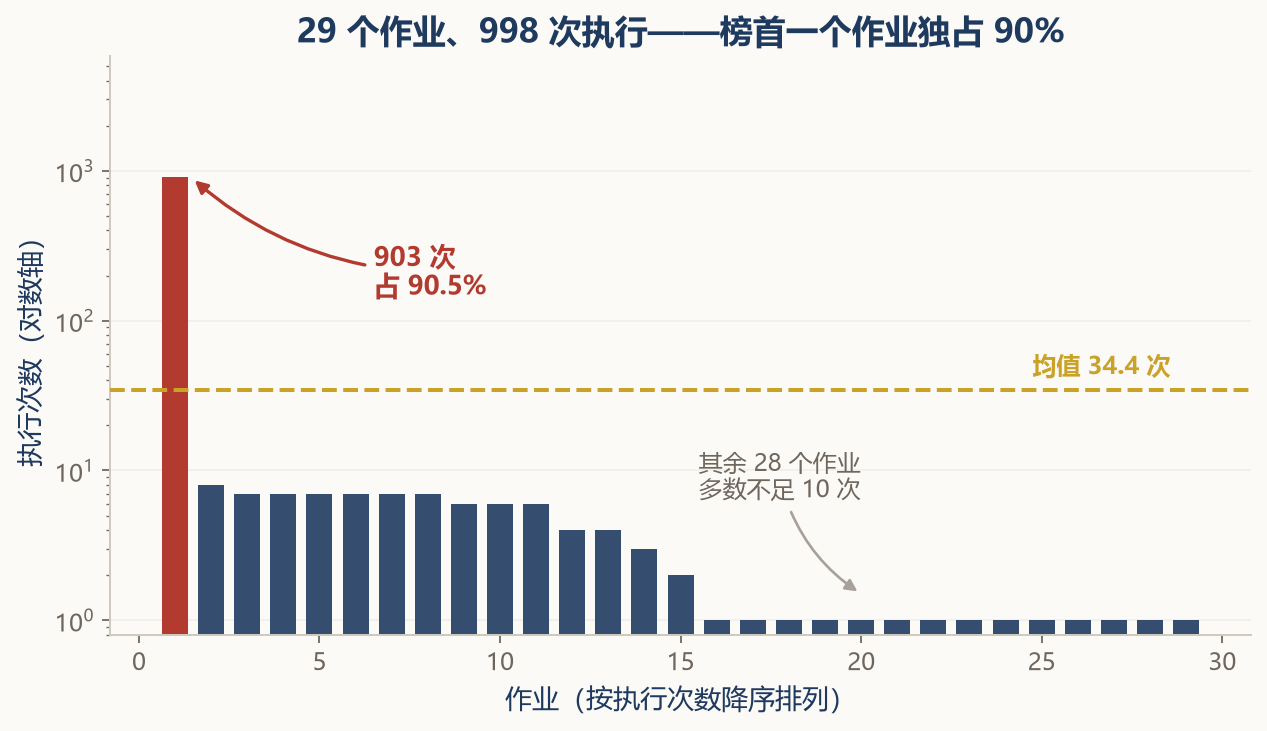
横轴是 29 个作业按执行次数降序排,纵轴取了对数——不用对数轴的话,第二名往后会被压成一条线。红色那根就是榜首,903 次。金色虚线是全组均值 34.4 次,它被一个极端值拉得远高于多数作业的真实水平。
这就带出第一个问题:"执行次数"和"验证过的对象数"是两回事。
02 追问:为什么 99.6% 这个数字不约束任何东西
换个口径,按作业(也就是按"被验证的独立对象")来数:
python
jobs = set(r[0] for r in rows)
bad = [j for j in jobs
       if any(r[1] != 'completed' for r in rows if r[0] == j)]
print('作业数        :', len(jobs))
print('出过问题的作业:', len(bad))
print('口径1 失败率  : %.4f%%' % (4 / len(rows) * 100))
print('口径2 失败率  : %.2f%%' % (len(bad) / len(jobs) * 100))
作业数 : 29
出过问题的作业: 4
口径1 失败率 : 0.4008%
口径2 失败率 : 13.79%同一个系统,同一个月,0.40% 和 13.79%。
要理解这个差距,得先承认一件事:那 903 次执行并不提供 903 份独立信息。同一个作业,用同样的脚本、读同样的数据源、跑在同样的环境里,它第 900 次成功对"这个作业是否可靠"这个问题贡献的信息,和第 2 次成功几乎是重复的。
统计上这类"重复观测"有精确的度量,在下一节给出。但这里先要处理一个更基础的问题——当失败次数是 0 的时候,我们连一个像样的区间都给不出来。
03 方法(一):零失败时,常规区间估计直接崩溃
假设我们对某个作业跑了
最常见的做法是算
区间宽度变成零,结论是"真实故障率等于 0"。这不是精度高,这是估计量在这个点上失效了:宽度正比于
零失败场景必须用精确法。
这个式子不依赖正态近似,是精确解。代入几个真实数字:
python
for N in [10, 30, 100, 300, 1000, 3000, 10000]:
    print('N=%6d   α=0.05 上界=%.4f%%' %
          (N, (1 - 0.05 ** (1 / N)) * 100))
N= 10 α=0.05 上界=25.8866%
N= 30 α=0.05 上界=9.5034%
N= 100 α=0.05 上界=2.9513%
N= 300 α=0.05 上界=0.9936%
N= 1000 α=0.05 上界=0.2991%
N= 3000 α=0.05 上界=0.0998%
N= 10000 α=0.05 上界=0.0300%读法:跑 30 次零失败,你只能声称真实故障率低于 9.5%。想压到 1% 以下,需要大约 300 次零失败;想压到 0.1% 以下,要接近 3000 次。 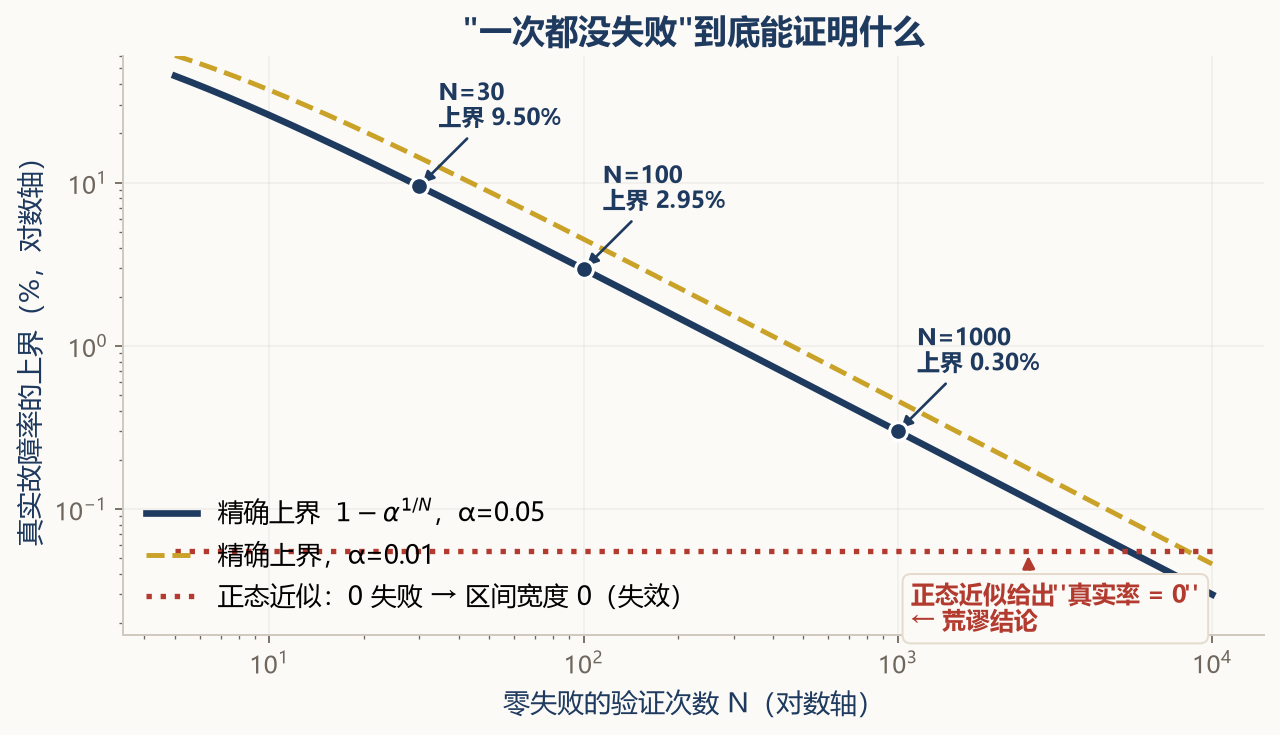
红线是精确上界随
这就是"一次都没出错"这句话的准确分量。它远没有听上去那么强。
(顺带一提,贝叶斯做法在零失败时给出几乎相同的结果:Beta(1,1) 先验下后验为 Beta(1,N+1),
04 方法(二):门控遗漏定律
第二节留下的问题是:
设某个故障在单次验证中现身(被检出)的概率为
这个式子不需要任何近似,是独立性下概率乘积的直接结果。用蒙特卡洛对照验证:
python
import numpy as np
rng = np.random.default_rng(42)
for r, N in [(0.10, 10), (0.05, 30), (0.02, 50), (0.01, 100)]:
    exact = (1 - r) ** N
    mc = 1 - (rng.random((200000, N)) < r).any(axis=1).mean()
    print('r=%.3f N=%3d  解析=%.6f  模拟=%.6f' % (r, N, exact, mc))
r=0.100 N= 10 解析=0.348678 模拟=0.348780
r=0.050 N= 30 解析=0.214639 模拟=0.215060
r=0.020 N= 50 解析=0.364170 模拟=0.365215
r=0.010 N=100 解析=0.366032 模拟=0.366480解析值与 20 万次模拟的偏差在千分之一量级,公式成立。
真正有用的是把它反过来解。要求漏掉概率不超过
小
python
import math
for alpha in [0.10, 0.05, 0.01]:
    row = [math.ceil(math.log(alpha) / math.log(1 - r))
           for r in [0.05, 0.02, 0.01, 0.005, 0.001]]
    print('α=%.2f →' % alpha, row)
α=0.10 → [45, 114, 230, 460, 2302]
α=0.05 → [59, 149, 299, 598, 2995]
α=0.01 → [90, 228, 459, 919, 4603]对应到真实尺度:想知道一个发生率 0.1% 的故障存不存在,95% 把握下需要约 2995 次验证。发生率 1%,需要约 299 次。 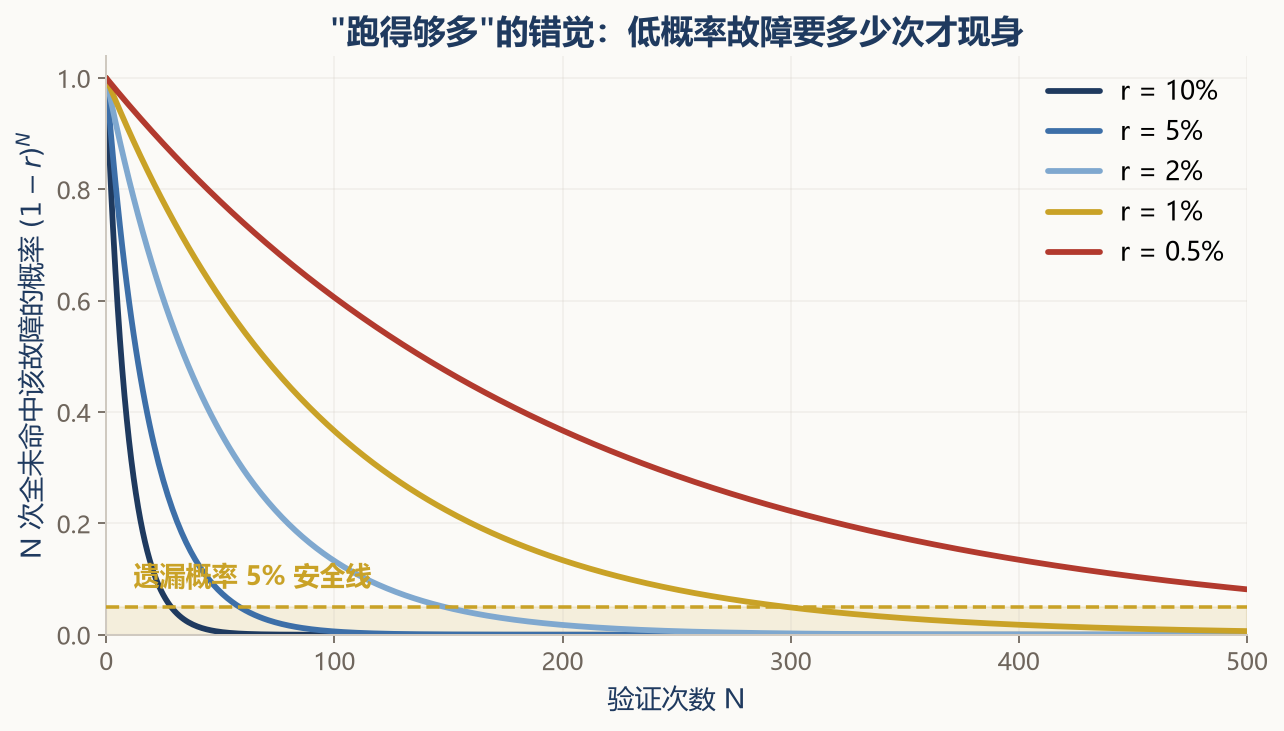
五条曲线是不同真实故障率下"跑
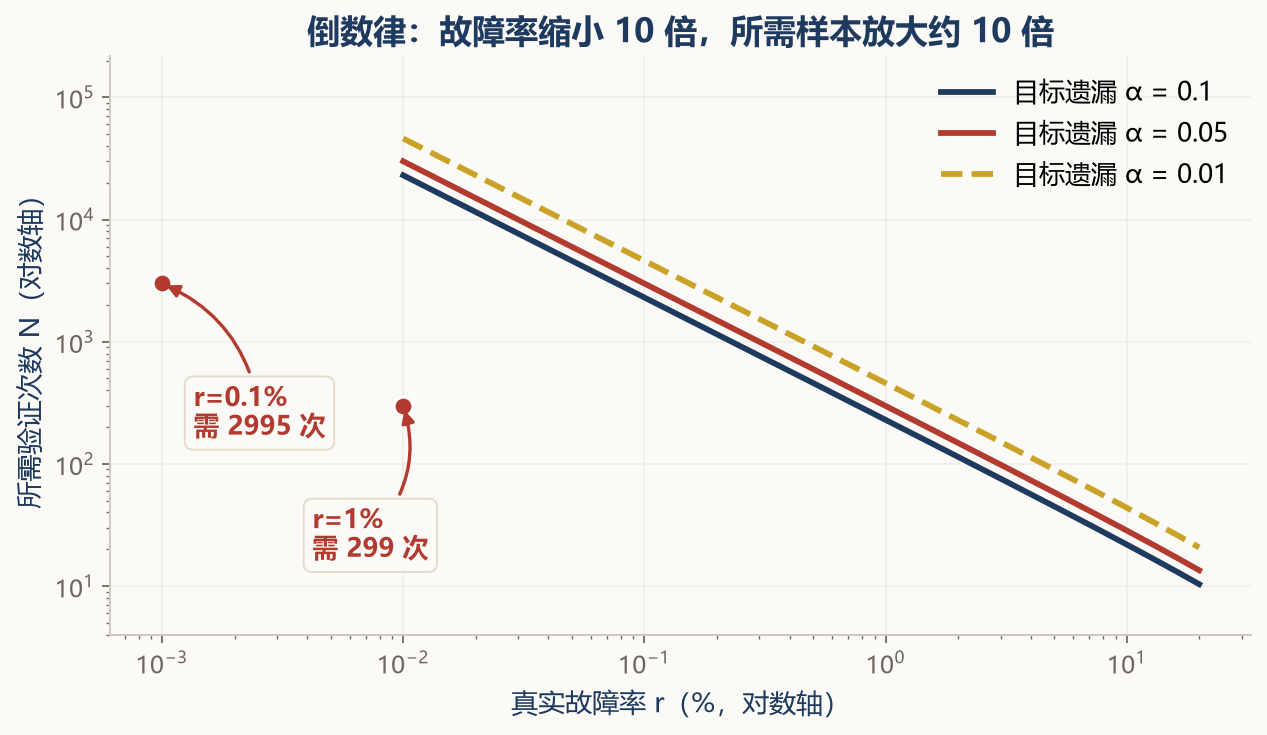
换成双对数坐标,倒数律就变成直线:横轴故障率缩小 10 倍,纵轴所需样本就抬高 10 倍。两个圆点标的是 r=1% 与 r=0.1% 在 α=0.05 口径下的解。
05 拆解(一):重复不是更多样本——设计效应
现在处理第二节那个 34.4 倍的差距。它有个精确的名字:设计效应(Design Effect)。
在簇抽样里,如果观测被分成若干簇(这里是"作业"),簇内有相关性
其中
簇大小相同时这就是全部。但我们的簇长极不均匀——一个 903,多数不到 10——这时要换成 Kish 给出的不等簇长形式:
把真实数字代进去:
python
m, cv = 34.4137931034, 4.8548707   # 真实簇长均值与变异系数(精确值)
for rho in [0.01, 0.02, 0.05, 0.10]:
    simple = 1 + (m - 1) * rho
    kish = 1 + (cv ** 2 * m + m - 1) * rho
    print('ρ=%.2f  简化=%.4f  Kish=%.2f  低估%.1f倍' %
          (rho, simple, kish, kish / simple))
ρ=0.01 简化=1.3341 Kish=9.45 低估7.1倍
ρ=0.02 简化=1.6683 Kish=17.89 低估10.7倍
ρ=0.05 简化=2.6707 Kish=43.23 低估16.2倍
ρ=0.10 简化=4.3414 Kish=85.45 低估19.7倍这是本文我自己踩的坑,值得如实记下来:我一开始用了等簇长那个简化式。按它算,
直到我意识到真实簇长的变异系数是 4.85(标准差 167.07 对均值 34.41)。换成 Kish 式之后:DEFF = 43.23,有效样本从 1000 掉到 23。
也就是说,那份"998 次执行"的台账,按独立信息量折算,大约相当于 23 个独立作业。差距 43 倍。 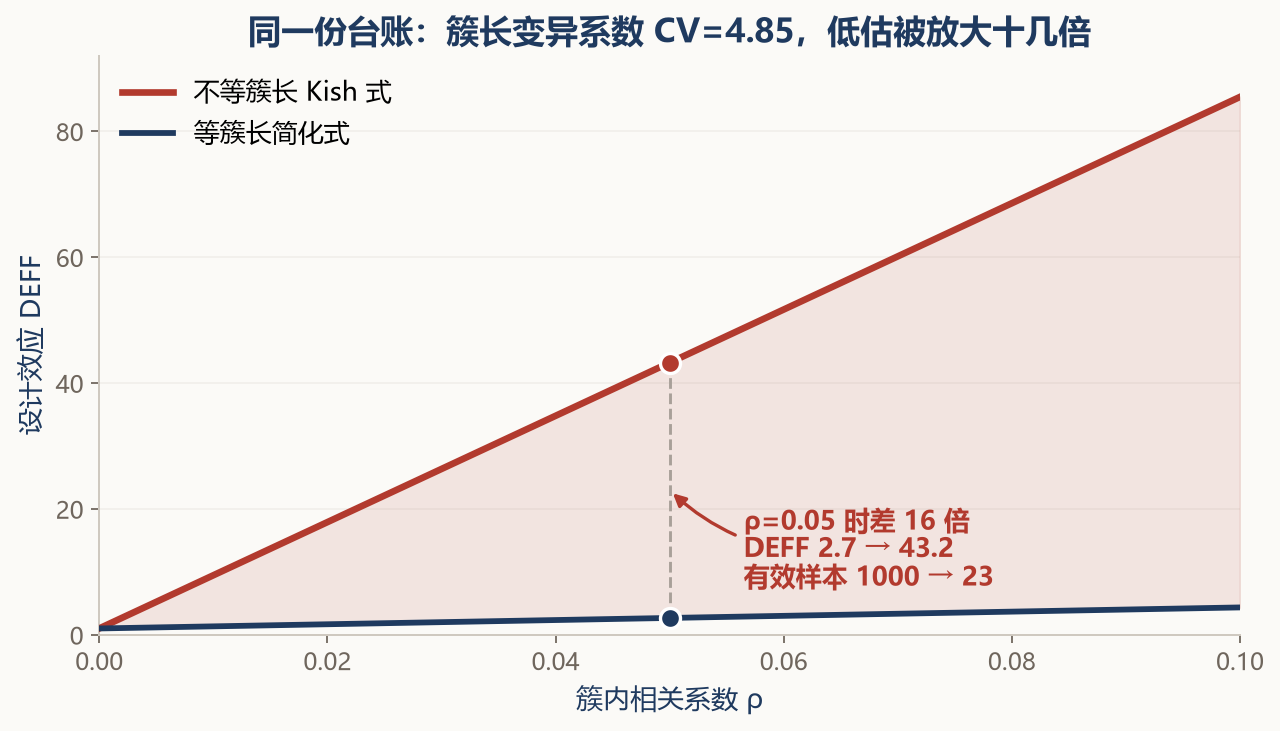
红色是 Kish 式,蓝色是等簇长简化式,两线之间的填充就是被我一开始漏掉的量。ρ 取 0.05 时,简化式给 2.67,Kish 式给 43.23——差 16 倍。这个差距全部来自真实簇长的变异系数 4.85:一个作业 903 次、多数不到 10 次,簇长越不均,简化式的低估越狠。
这个公式我用严格构造验证过一遍——beta-二项模型下,簇概率
python
import numpy as np
rng = np.random.default_rng(42)
k, m = 5000, 10          # 5000 簇×10 观测; k=400 时误差可达 15%
for rho in [0.02, 0.05, 0.10, 0.20]:
    ab = 1 / rho - 1                       # Beta(0.05ab, 0.95ab)
    p_cl = rng.beta(0.05 * ab, 0.95 * ab, k)
    obs = rng.random((k, m)) < p_cl[:, None]
    cm = obs.mean(axis=1); pbar = obs.mean()
    deff_emp = cm.var(ddof=1) / (pbar * (1 - pbar) / m)
    print('ρ=%.2f  理论DEFF=%.2f  实测=%.2f' %
          (rho, 1 + (m - 1) * rho, deff_emp))
ρ=0.02 理论DEFF=1.18 实测=1.21
ρ=0.05 理论DEFF=1.45 实测=1.43
ρ=0.10 理论DEFF=1.90 实测=1.89
ρ=0.20 理论DEFF=2.80 实测=2.88实测与理论在 3% 以内吻合,公式可用。(注:簇数取 400 时误差可达 15%,这里用 5000 簇把蒙特卡洛噪声压下来。)
06 拆解(二):台账自己也有盲区
到这里,前面所有讨论都建立在一个隐含假设上:执行台账是完整的。
我去核对了事故台账,结果是另一记闷棍。
python
ex_w = (min(e[2] for e in EX), max(e[2] for e in EX))
in_w = [i for i in INC if ex_w[0] <= i[2] <= ex_w[1]]
print('执行台账窗口:', ex_w[0], '→', ex_w[1])
print('事故台账窗口:', min(i[2] for i in INC), '→', max(i[2] for i in INC))
print('事故落在执行窗口内: %d/%d' % (len(in_w), len(INC)))
执行台账窗口: 2026-09-09T17:40 → 2026-09-16T00:10
事故台账窗口: 2026-08-28T21:04 → 2026-09-12T22:00
事故落在执行窗口内: 2/8事故台账里 8 条记录,只有 2 条落在执行台账的时间窗内。剩下 6 条——包括同一个作业连续三次限流失败——执行台账里根本看不到。
这背后是留存窗口差异造成的系统性遗漏,与巧合无关:两张表的起点不同。如果我只信执行台账,会得出"系统整体健康"的结论;而事实上,另一张表里躺着 6 条它看不见的事故。
这对"验证"这件事的打击比前两节更彻底。前面说的是"样本量不够",这里说的是取样范围本身就有洞——你再怎么增加
顺带看一眼重复性。8 条事故里,同一个作业重复发生的有 5 条(一个 3 次、一个 2 次)。另一份独立日志里,748 条错误记录中有 216 条来自同一个反复出现的错误,占 29%。
重复的东西看起来像"多",但它们是同一个信息的回声。
07 方法(三):把漏检概率换算成钱,解出最优验证次数
到此为止的结论偏悲观:样本量要求高,有效样本还被严重打折。那是不是应该无限加大验证力度?
不是。验证本身有成本,而漏检的损失随
设单次验证成本
对
解得最优验证次数(注意
取一组可感参数(单次验证 10 元、单次漏检 100 万、年发生 10 次):
python
import math
c_s, c_f, A = 10.0, 1_000_000.0, 10.0
f = lambda N, r: N * c_s + (1 - r) ** N * c_f * A
for r in [0.05, 0.01, 0.005, 0.001]:
    ln1 = math.log(1 - r)
    Ns = math.log(c_s / (-ln1 * c_f * A)) / ln1
    print('r=%.3f  N*=%6.0f  C(N*)=%9.0f  C(1000)=%10.0f'
          % (r, Ns, f(Ns, r), f(1000, r)))
r=0.050 N*= 211 C(N*)= 2309 C(1000)= 10000
r=0.010 N*= 917 C(N*)= 10164 C(1000)= 10432
r=0.005 N*= 1700 C(N*)= 18992 C(1000)= 76540
r=0.001 N*= 6905 C(N*)= 79043 C(1000)= 3686954两个可操作的读数:
其一,最优次数随故障率下降而上升,但只按对数增长。 故障率从 5% 降到 0.1%(50 倍),
其二,过头和不足都要付钱。 看最后一行:真实故障率 0.1% 时,按 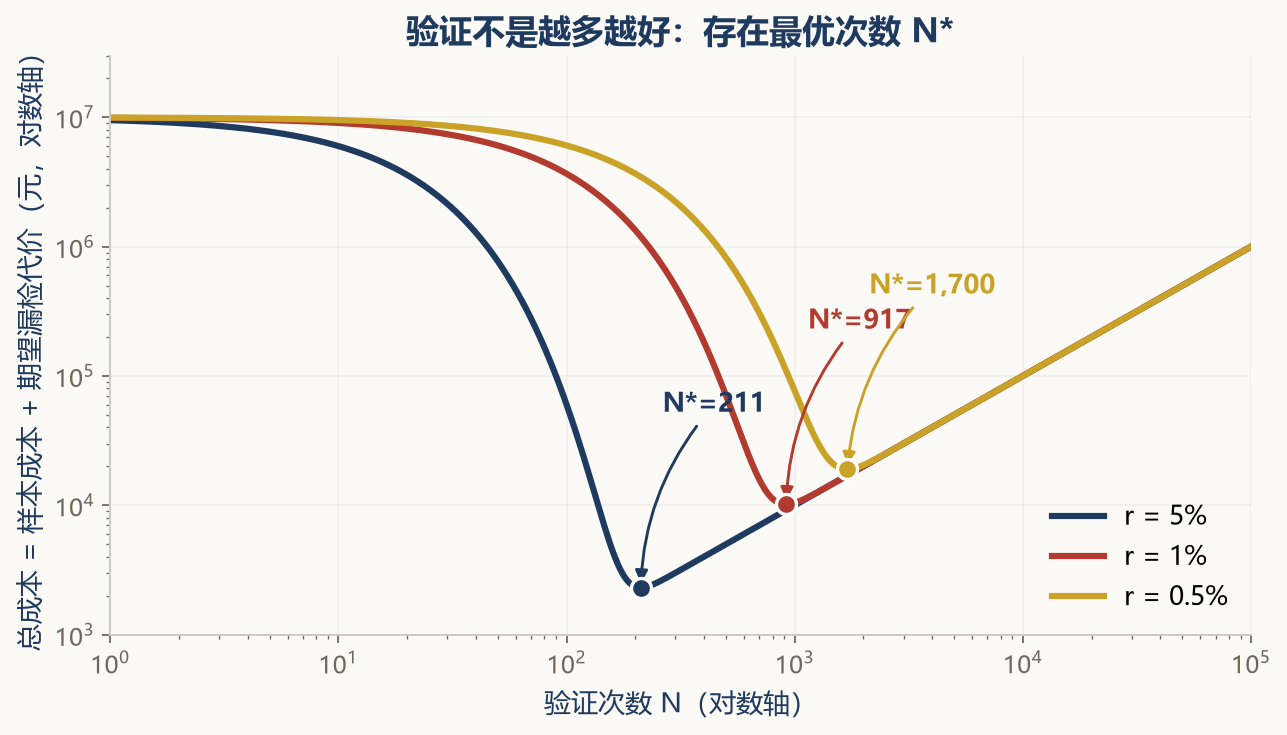
三条曲线是不同故障率下的总成本,圆点标出各自的
08 结论:验证要盯"漏了什么",不是盯"测了多少"
把这条链串起来。
第一,零失败不构成证据,除非
第二,名义样本量会被重复和簇结构严重虚高。 998 次执行在本例中折算成约 23 个独立作业的信息量,虚高 43 倍。数执行次数,等于把同一个信息数了很多遍。
第三,"成功率"这个问题本身取决于你数什么。 同一份台账,0.40% 和 13.79% 都对,但只有后者约束了"这个系统有多少环节曾经不可靠"。
第四,取样窗口的洞,加样本量补不上。 执行台账看不见 75% 的历史事故——这跟
第五,验证力度有最优解。
回到开头那个 99.6%。它没有说谎,它只是回答了一个很窄的问题:这段时间里跑出去的任务,大部分都跑完了。它没有回答、也无法回答的问题是:这套系统里有多少个环节,其实已经出过问题但没被记录。
下次看到"我们测过了,没问题",可以问三个数:测了多少次(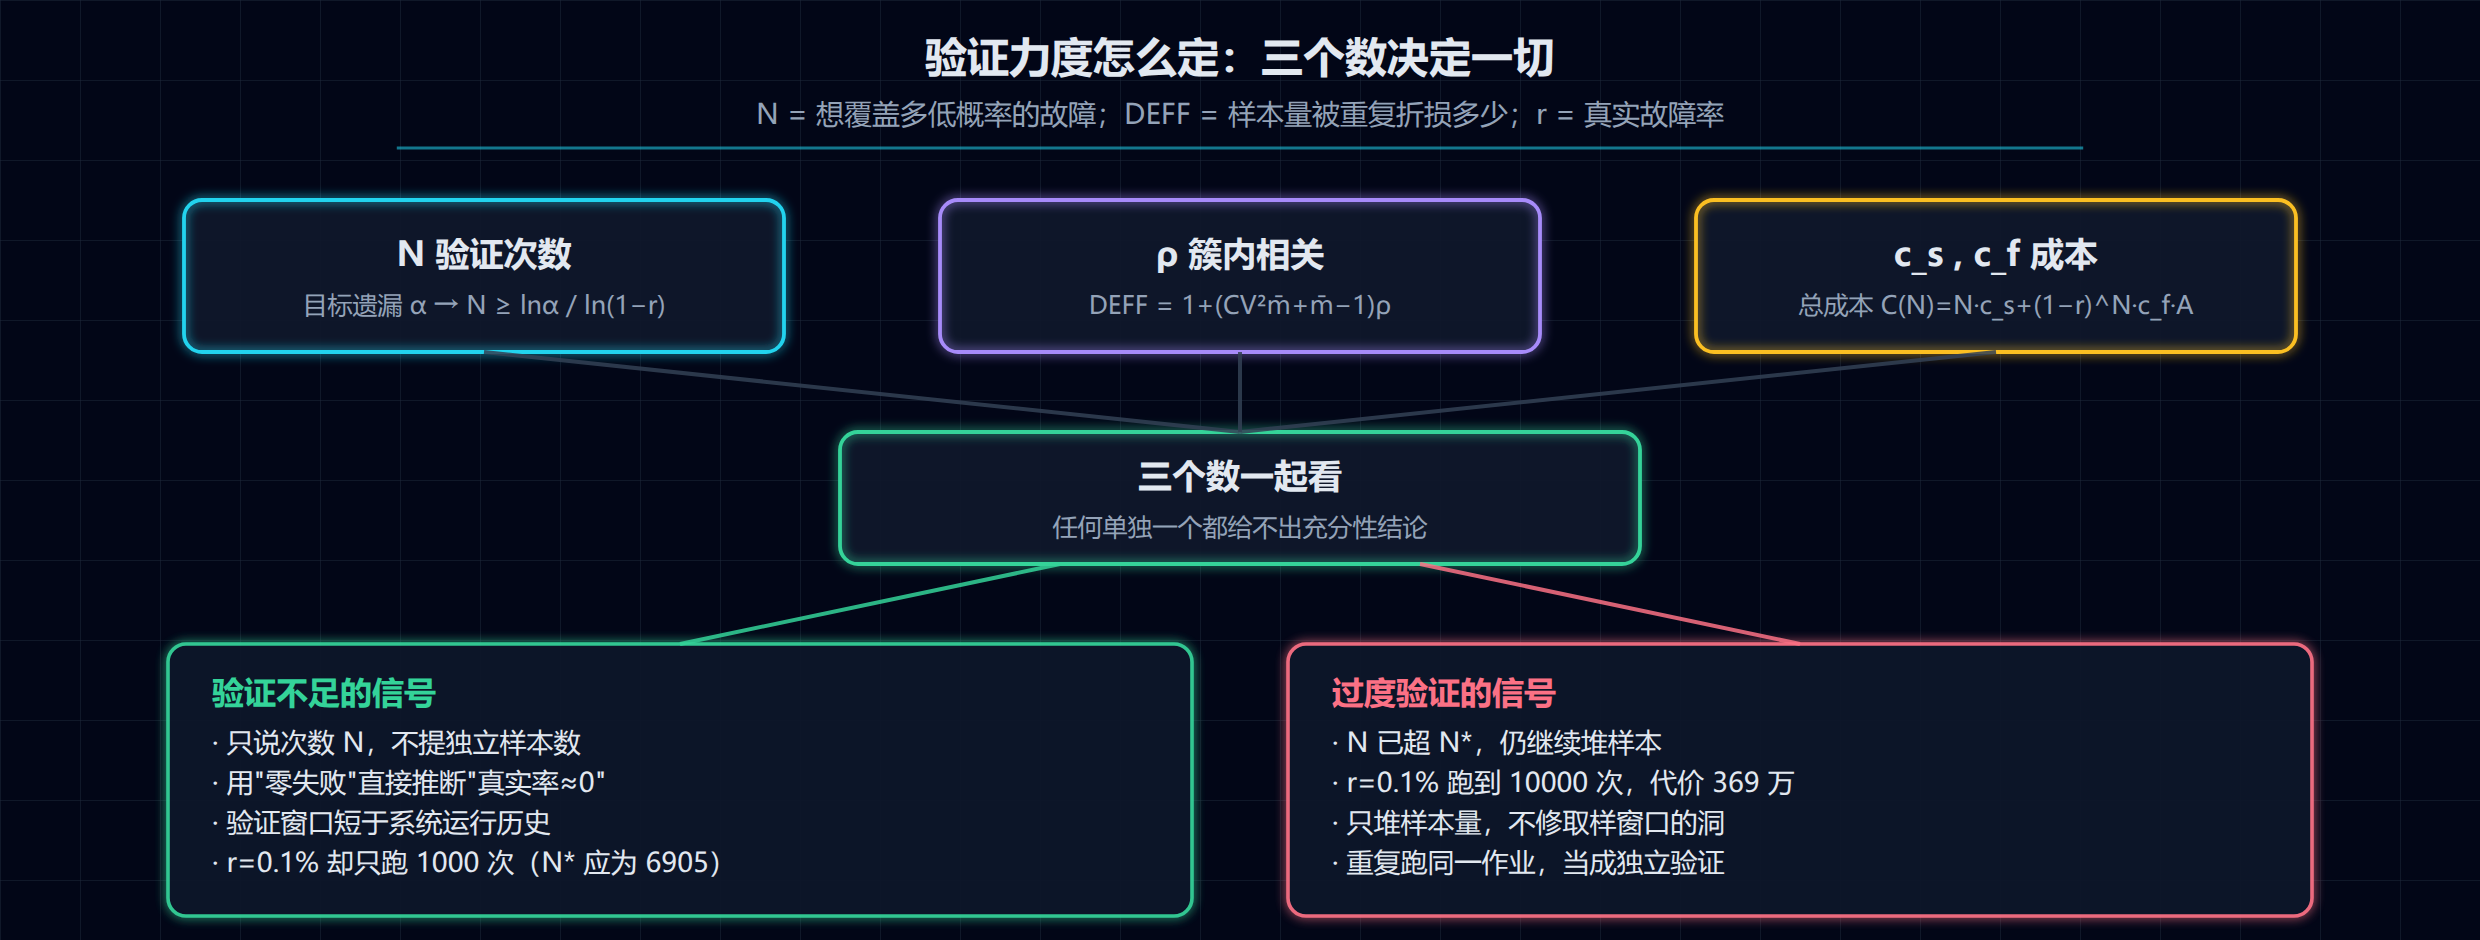
落地成判定:三个数一起看才有结论。左边是验证不足的信号——只说次数不提独立样本数、拿零失败推断真实率为零、窗口短于系统历史、故障率 0.1% 却只跑 1000 次(
数据说明: 执行台账 998 条、事故台账 8 条,均来自作者本人的自动化调度系统(SQLite 本地库),已脱敏处理:不含作业名称、文件路径、业务数据与账号信息。样本量与故障率反解、Clopper-Pearson 精确上界、设计效应、最优验证次数均为公式直接计算,可用文中代码复现。蒙特卡洛对照使用 np.random.seed(42),20 万次重复。
代码环境: Python 3.11,NumPy / SciPy / Matplotlib。所有数字来自 gen_figures.py 实际执行输出,未做任何手工调整。
- Clopper, C. J., & Pearson, E. S. (1934). The use of confidence or fiducial limits illustrated in the case of the binomial. Biometrika, 26(4), 404–413. — 零失败精确上界
的原始来源,本文第 03 节直接使用 - Kish, L. (1965). Survey Sampling. Wiley. — 设计效应与不等簇长下的 DEFF 修正形式,本文第 05 节 Kish 式的出处
- Cochran, W. G. (1977). Sampling Techniques (3rd ed.). Wiley. — 簇抽样下样本均值方差的分解,DEFF 的一般推导