L1/L2正则化的数学解读——从Ridge到Lasso的收缩之路
Python | 过拟合与正则化:L1/L2的数学解读
5月24日2026年
核心结论:L1(Lasso)和L2(Ridge)正则化通过在损失函数中加入惩罚项防止过拟合。L1将不重要特征的系数压缩到零,实现自动特征选择;L2将所有系数等比例缩小,保留全部特征但降低它们的权重。两者的数学本质都是James-Stein收缩思想的应用。本文用Lasso路径图+Ridge闭式解推导+Elastic Net对比+学习曲线,完整代码见第五节。
关键词:Python,scikit-learn,matplotlib,Lasso,Ridge,正则化,过拟合,交叉验证
一、过拟合问题
过拟合(Overfitting)是机器学习中最常见也最棘手的问题之一。它的定义很简单:模型在训练数据上表现太好,但在新数据(测试集)上表现很差。本质上是模型把数据中的随机噪声当成了真实规律来学习,就像一个学生死记硬背了考试中出现的每一道题的答案,却没有真正理解题目背后的原理——换一套新题就束手无策。
典型场景: 用高次多项式拟合少量数据点。多项式阶数越高,模型容量越大,训练误差可以趋近于零,但测试误差反而急剧上升。这种"训练越好、测试越差"的反直觉现象,正是过拟合的典型特征。
偏差-方差权衡
理解过拟合需要先理解偏差和方差这两个核心概念:
偏差(Bias):模型预测值与真实值之间的系统性偏离。高偏差意味着模型过于简单,无法捕捉数据中的真实模式——这就是欠拟合的表现。例如用一条直线去拟合有明显曲线趋势的数据,无论怎么调整,直线都无法很好地贴合数据。
方差(Variance):模型对不同训练集的敏感程度。高方差意味着模型对训练数据中的微小变化非常敏感,训练集稍微换一批数据,模型就会完全不同——这就是过拟合的表现。例如用超高阶多项式拟合数据时,稍微改变一个数据点的位置,拟合曲线就会剧烈震荡。
两者的关系可以概括为:
| 状态 | 偏差 | 方差 | 训练误差 | 测试误差 |
|---|---|---|---|---|
| 欠拟合 | 高 | 低 | 大 | 大 |
| 过拟合 | 低 | 高 | 小 | 大 |
| 理想 | 适中 | 适中 | 适中 | 适中 |
过拟合的根本原因是模型参数过多而样本不足。当模型有大量参数可以自由调整时,它可以完美拟合训练数据中的每一个点,包括那些由随机误差带来的异常值。这就好比用一条有几十个弯的曲线去穿过只有几个数据点——你可以让曲线精确经过每一个点,但这条曲线的形状完全由这些点的噪声决定,毫无泛化能力。
应对过拟合的主要方法有三种:
- 增加训练数据量:更多的数据可以稀释噪声的影响,让模型学到真实的统计规律
- 降低模型复杂度:减少特征数量或降低多项式阶数
- 正则化——在不减少参数数量的情况下约束参数的大小,这是本文的重点
二、正则化的数学推导
正则化(Regularization)的核心思想非常简单直观:在损失函数中加入一个惩罚项,对过大的参数值施加"惩罚",从而限制模型参数的大小,防止模型过度依赖某些特征。可以这样理解:如果你的模型中有100个参数,你不希望其中某一个参数的绝对值是100而其他都是0,因为这意味着模型完全被这个特征支配,一旦这个特征在测试数据中有微小变化,预测结果就会剧烈波动。正则化通过惩罚大参数值来鼓励模型"均匀"地利用所有特征。
Ridge回归(L2正则化)
Ridge回归在最小二乘损失的基础上加入平方惩罚项,其损失函数为:
其中
等价视角——带约束的优化问题:
Ridge回归完全等价于以下带约束的优化问题:在参数向量的L2范数不超过某个常数
这里的
通过拉格朗日乘子法,可以将这个带约束优化转化为无约束优化:
去掉常数项
Ridge的解有闭式表达式(解析解):
与普通最小二乘解
Lasso回归(L1正则化)
Lasso(Least Absolute Shrinkage and Selection Operator)使用绝对值惩罚替代平方惩罚:
其中
等价视角——带约束的优化问题:
Lasso的带约束形式是在L1范数约束下最小化残差平方和:
其拉格朗日形式为:
与Ridge不同,Lasso没有解析解(因为绝对值函数在零点不可导),所以Lasso的求解需要使用坐标下降法(Coordinate Descent)或最小角回归(LARS)等数值优化算法。scikit-learn中Lasso的默认求解器就是坐标下降法。
L1与L2最本质的区别: L2惩罚使参数趋于0但不等于0,而L1惩罚使部分参数精确等于0——自动完成特征选择。这意味着Lasso不仅可以防止过拟合,还能告诉我们哪些特征是真正重要的。从模型可解释性的角度来看,Lasso比Ridge更有优势:经过Lasso筛选后,我们得到一个"精简版"模型,只包含少数最重要的特征。
三、几何解释:L1菱形 vs L2圆
从几何视角理解L1和L2的区别是最直观的方式之一。正则化的本质是在参数空间中寻找约束区域与误差等高线的切点。
L2的圆形约束
约束条件
数学上,这是因为圆形的边界在任何点都有非零的曲率,椭圆等高线与其相切时必然在切点处形成光滑接触,而这个切点几乎不可能恰好落在坐标轴上(除非数据的结构非常特殊)。所以Ridge的解总是保留所有参数,只是让它们的绝对值变小。
L1的菱形约束
约束条件
误差等高线与菱形相切时,切点更容易落在顶点上。这是因为菱形的边界在顶点处形成了"尖角"——在尖角处,菱形的外法线方向可以取一个连续的范围,这就大大增加了误差等高线与菱形在顶点处相切的可能性。一旦切点落在顶点上,相应的参数正好为零。
关键结论:
- L2(Ridge):约束区域是光滑的圆,参数连续收缩但不会归零,适合所有特征都有用的场景
- L1(Lasso):约束区域有"尖角",容易将参数压到零,适合特征选择
当参数数量大于2时,L1的约束区域是一个高维菱形(也叫L1球),其"尖角"的数量随维度指数增长。尖角越多,参数落在坐标轴上的可能性越大,这就是Lasso在高维空间中稀疏性更强的几何原因。
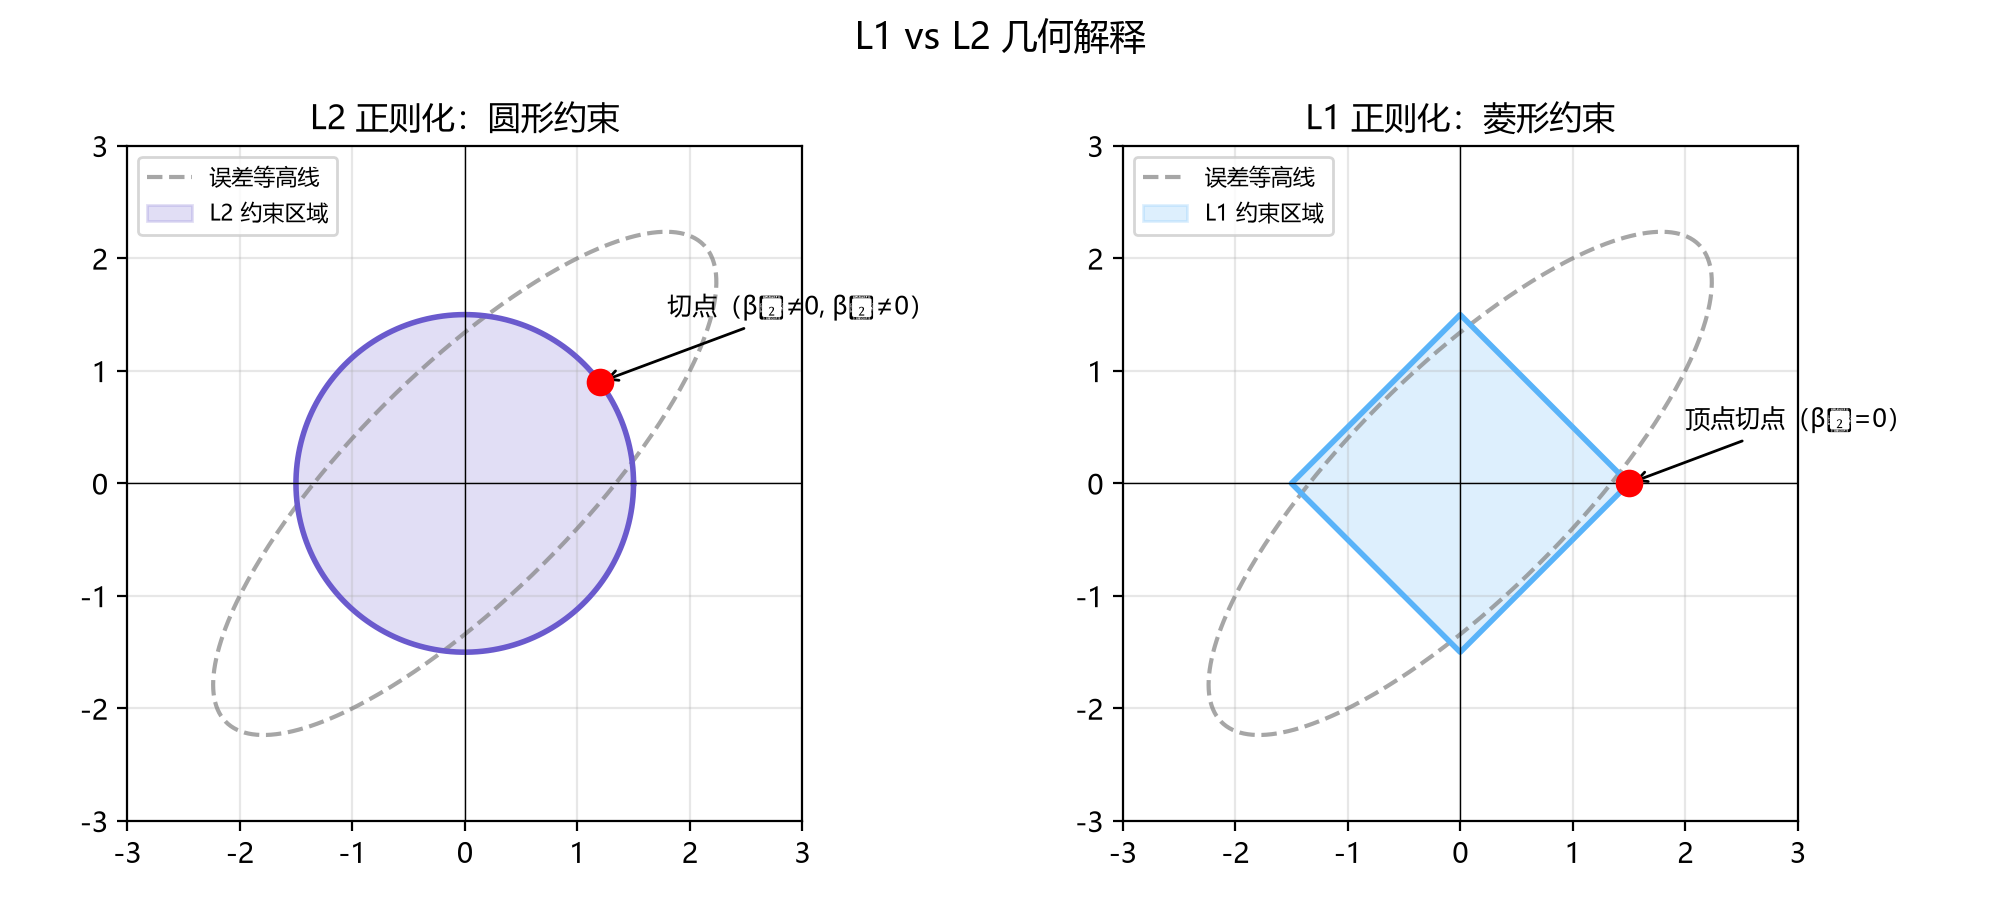
预期输出: 两张子图并排展示。左图中,L2约束区域是一个蓝色圆圈,灰色虚线椭圆(误差等高线)与圆相切于一个不在坐标轴上的点(红点),这个切点对应的两个参数都不为零。右图中,L1约束区域是一个蓝色菱形,椭圆与菱形相切于顶点(红点),此时
四、贝叶斯解释:先验视角
正则化不仅可以从优化角度理解,还可以从贝叶斯统计的角度获得深刻洞见。事实上,L1和L2正则化对应着不同的先验分布假设。
L2 = 高斯先验
在线性回归的贝叶斯框架中,我们不把
这个先验分布表达了我们的先验信念:大多数参数应该接近零,但偶尔也有参数取较大值(高斯分布有"长尾",允许较大值出现)。
根据贝叶斯定理,后验概率正比于似然乘以先验。取最大后验估计(MAP),对数后验 = 对数似然 + 对数先验:
最大化上式等价于最小化负对数后验。令
这恰好就是Ridge的损失函数。也就是说,Ridge回归等价于在贝叶斯框架下对参数施加高斯先验并做MAP估计。
L1 = 拉普拉斯先验
类似地,Lasso对应着拉普拉斯先验(也叫双指数分布):
拉普拉斯分布与高斯分布的关键区别在于:它在零点有一个尖峰(概率密度在零处最大),而且尾部呈指数衰减(比高斯分布更"瘦")。这意味着拉普拉斯先验强烈倾向于参数值接近零甚至等于零。
对数后验中先验项变为
直观理解:
- 高斯先验在0附近概率密度光滑(呈钟形),从0向两侧的衰减是平方级的。这意味着参数可以非常接近0但很难精确等于0,因为精确等于0的概率密度并不比稍微偏离0高很多
- 拉普拉斯先验在0处有一个"尖峰",从0向两侧的衰减是线性级的。这意味着参数精确等于0的概率密度显著高于稍微偏离0的情况,因此MAP估计时更容易把参数推到0
表格总结:
| 正则化方法 | 对应的先验分布 | 先验密度函数 | 后验特性 |
|---|---|---|---|
| L2 (Ridge) | 高斯分布 | 参数连续收缩,接近但不为零 | |
| L1 (Lasso) | 拉普拉斯分布 | 参数可能精确为零(稀疏性) |
这个贝叶斯视角不仅帮助我们理解了正则化的本质,还为我们提供了一种选择正则化方法的思路:根据我们对参数分布的先验知识来决定使用L1还是L2。如果我们认为大多数特征对预测结果都有微弱但非零的贡献,应该选择对应高斯先验的Ridge;如果我们认为只有少数特征真正重要,大多数特征可以忽略,则应该选择对应拉普拉斯先验的Lasso。
五、实践:学习曲线诊断过拟合
在动手做正则化之前,先学会如何诊断过拟合。学习曲线(Learning Curve) 是检测过拟合最直观的工具:它展示了在不同训练样本量下,模型在训练集和验证集上的表现如何变化。
学习曲线的原理并不复杂。当我们用很少的样本训练一个复杂模型时,模型可以轻易"记住"每一个样本,所以训练误差非常低,但由于没有看到足够多的数据,它学到的是噪声而非规律,因此在验证集上表现很差。随着训练样本的增加,模型开始被迫寻找真实的规律,训练误差会小幅上升(因为无法完美拟合所有数据了),但验证误差会逐渐下降并趋近于训练误差。当两条曲线最终"汇合"时,说明模型已经学到了足够多的规律——增加更多数据也不会带来显著提升。
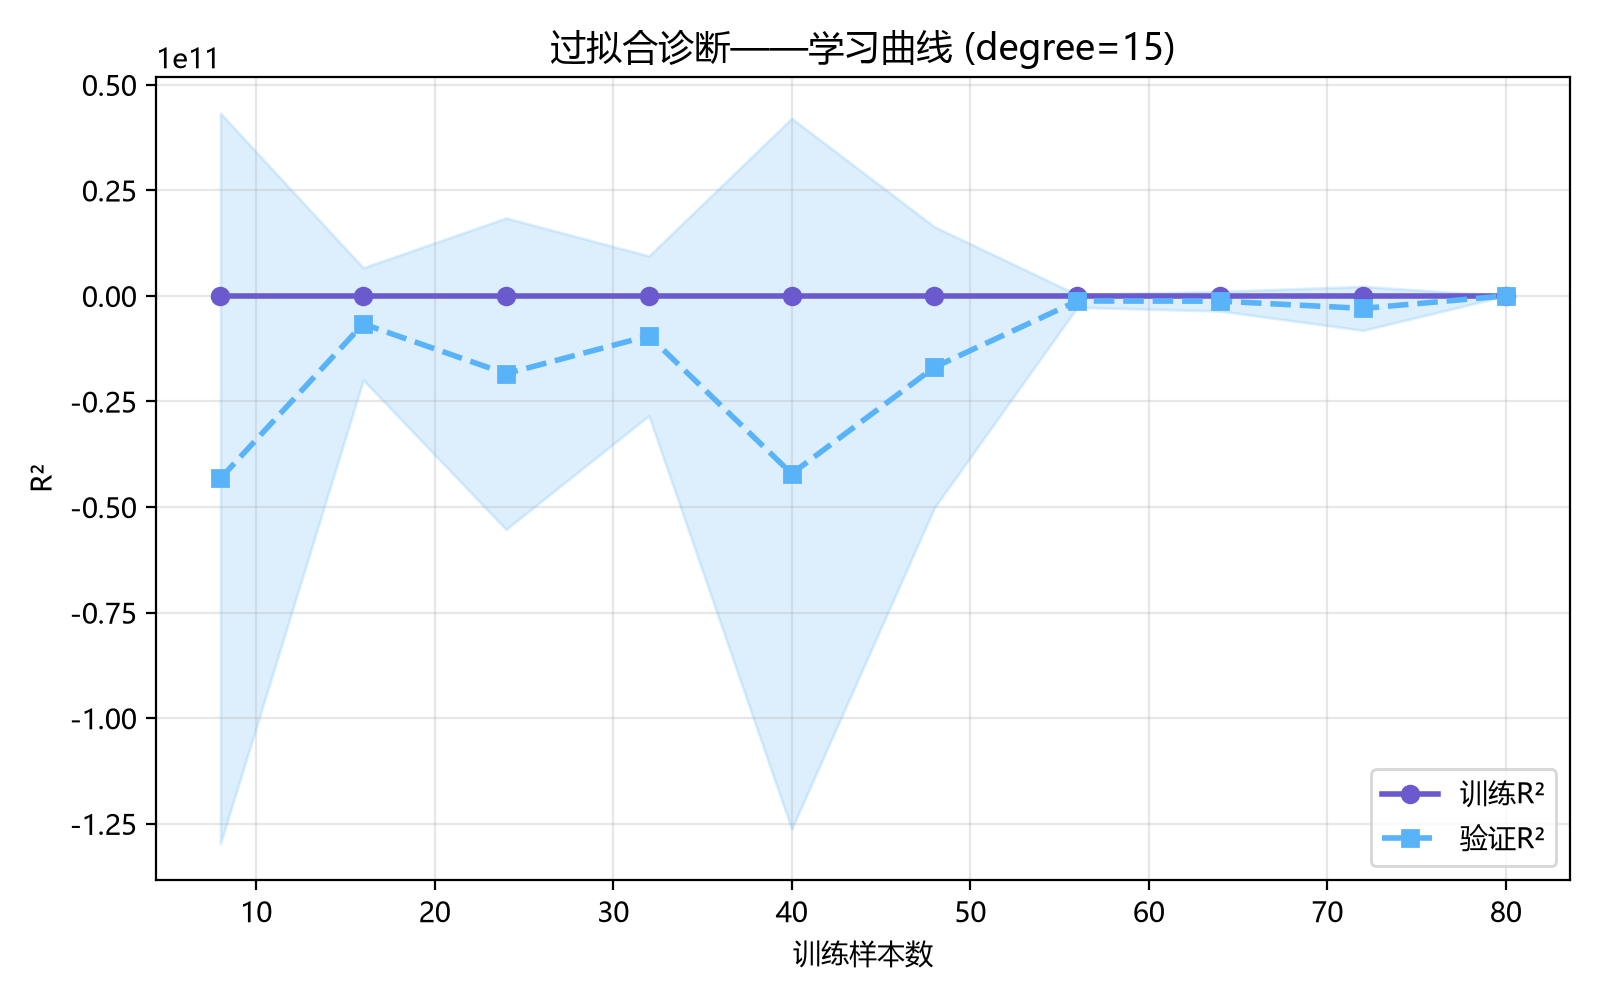
预期输出: 学习曲线显示——当训练样本数少于20时,训练R²接近1.0(完美拟合),但验证R²很低(约0.3-0.5),两条线之间的"间隙"很大,这就是过拟合的典型信号。随着样本量增加到60以上,训练R²略有下降(约0.95),验证R²上升到约0.85,两条线的间隙缩小。这说明增加数据确实可以缓解过拟合,但如果数据本身有限,我们还需要正则化来救场。
如何解读学习曲线(三种典型模式):
训练R²和验证R²都很低,且两条曲线基本重合 → 欠拟合(高偏差)。模型太简单了,无论有多少数据都无法拟合。解决方案是增加模型复杂度(提高阶数、增加特征)。
训练R²很高,验证R²很低,两条曲线之间有巨大间隙 → 过拟合(高方差)。模型太复杂了,需要正则化或增加数据。
训练R²和验证R²都很高,两条曲线接近且间隙很小 → 理想状态。模型在偏差和方差之间取得了良好平衡。
学习曲线还有一个实用功能:如果随着样本量增加,两条曲线仍在靠近但尚未汇合,说明收集更多数据是有帮助的;如果两条曲线已经平行了很长一段距离,说明增加数据也无济于事,应该转向改进模型本身。
六、数据模拟:多项式过拟合
接下来用实际代码来演示过拟合现象。我们生成基于
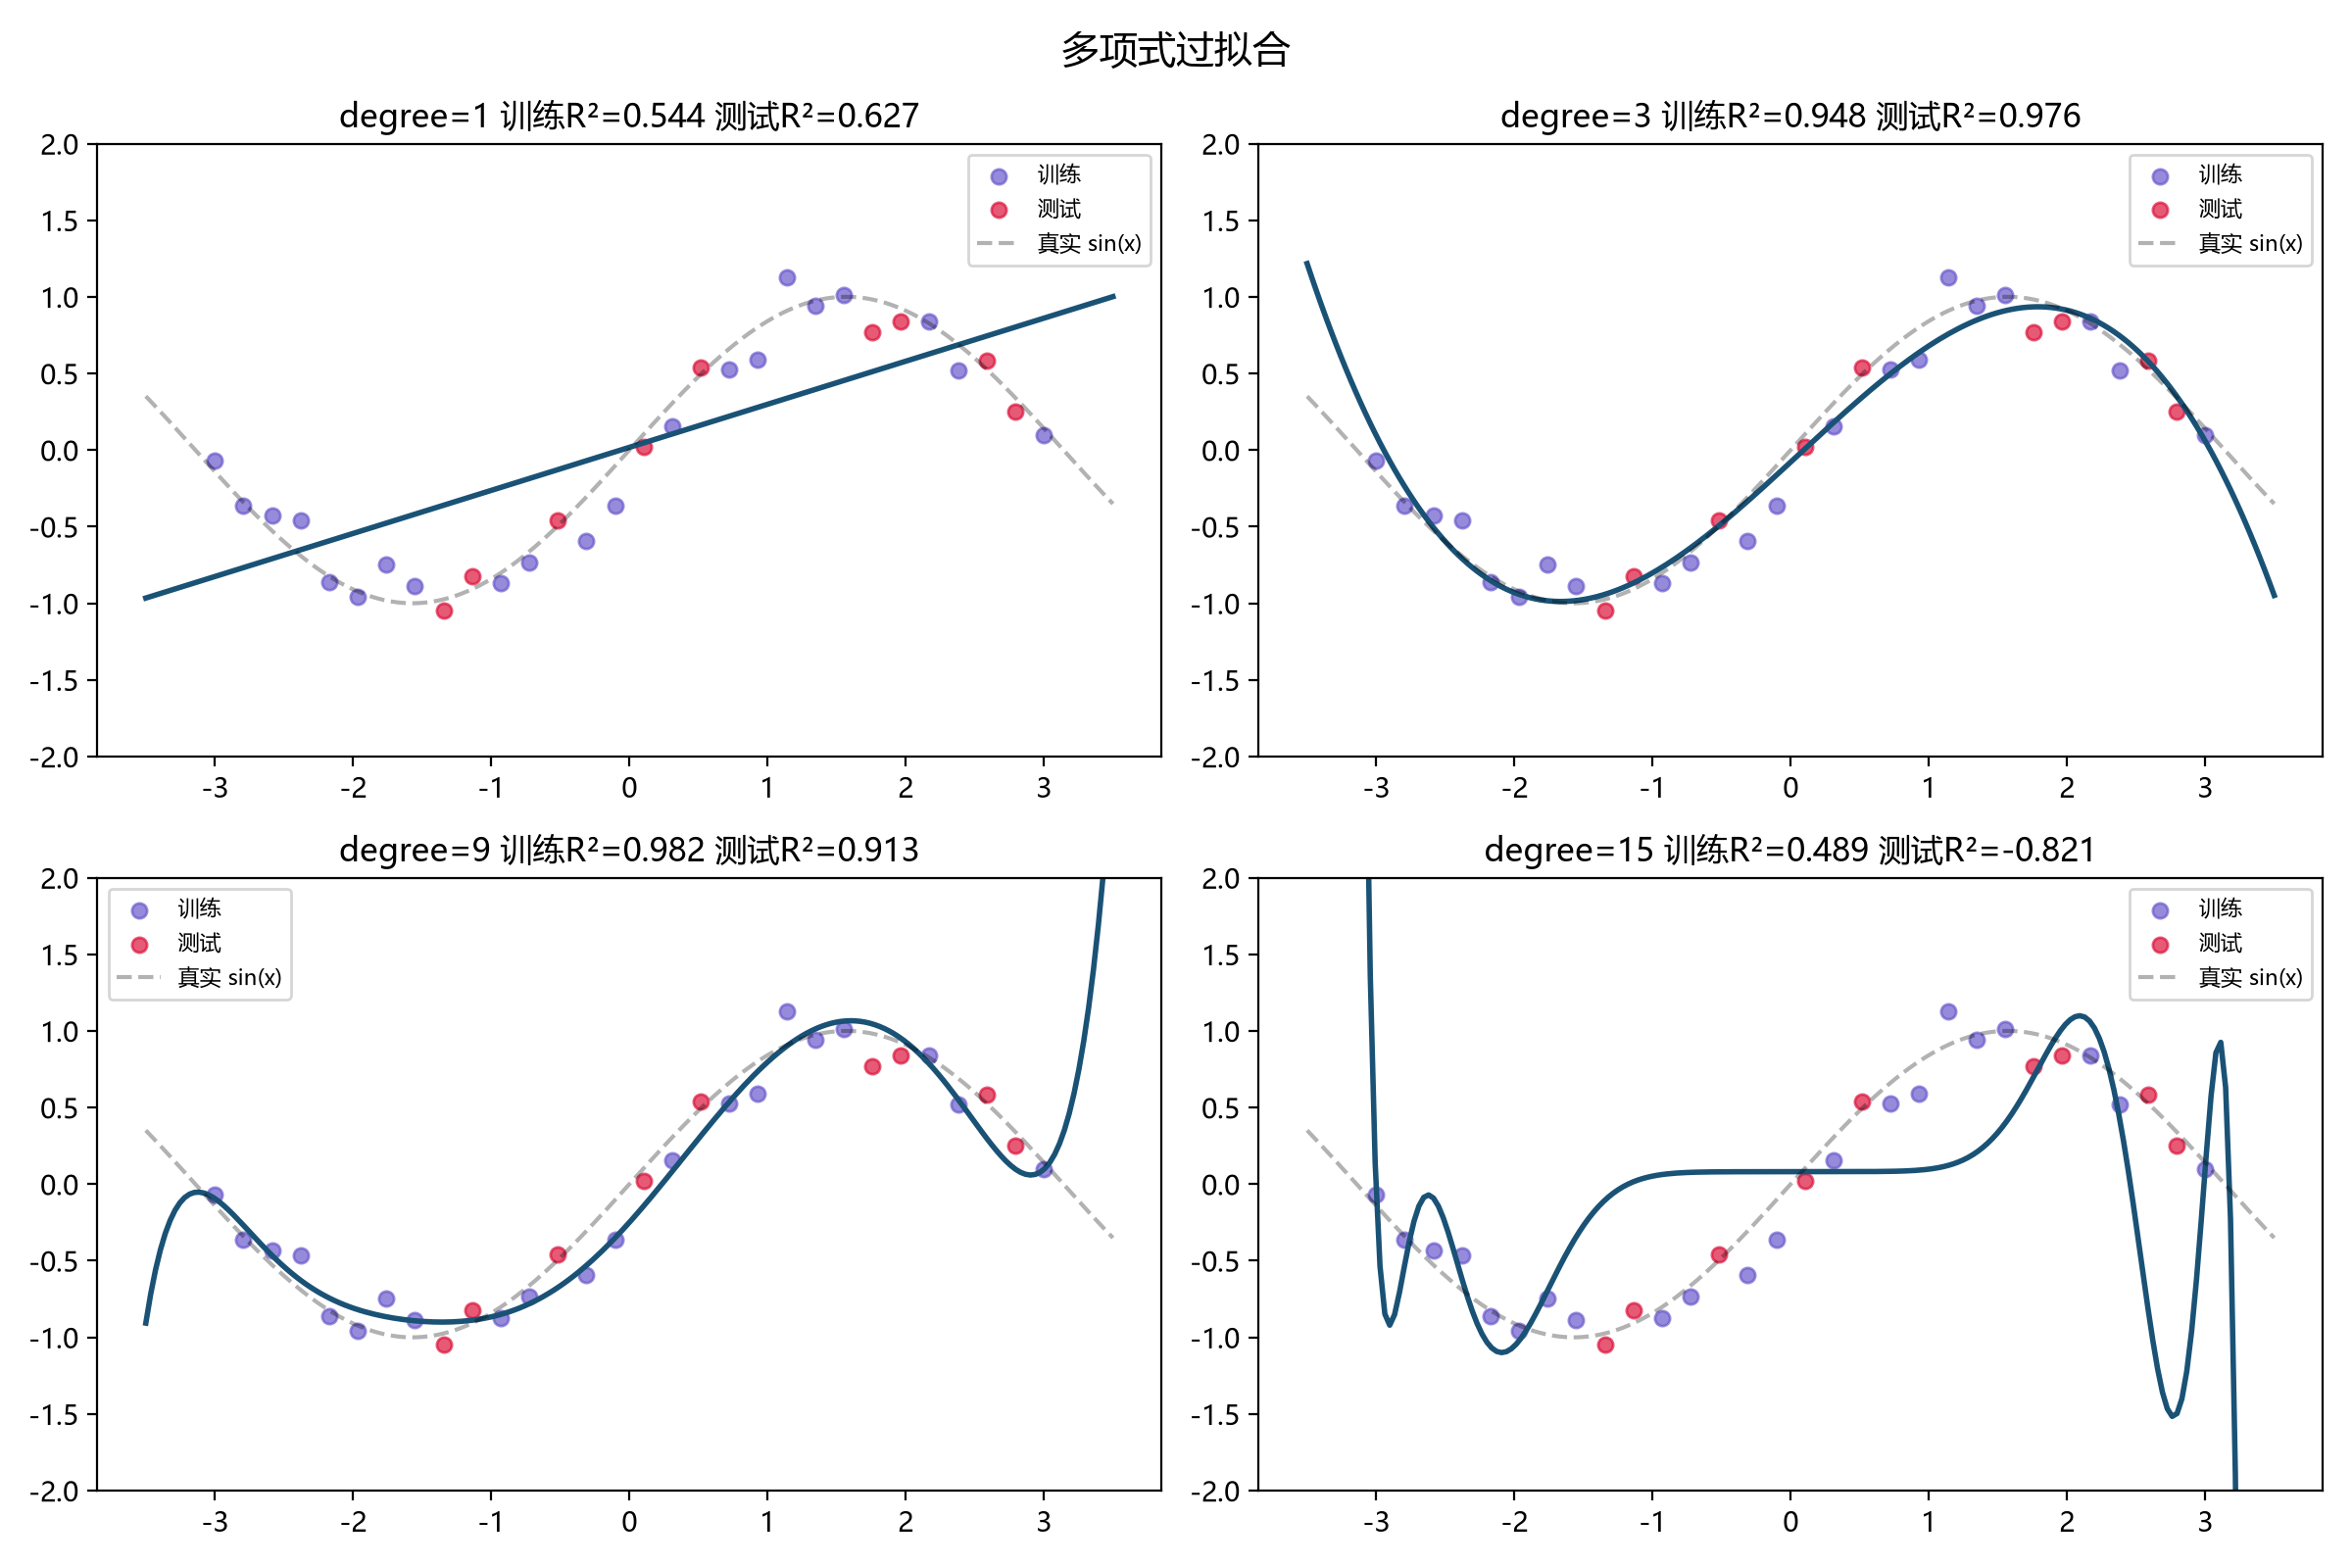
从结果中可以清楚地看到:degree=1时,一条直线完全无法拟合
七、正则化效果对比
现在我们在degree=15的严重过拟合模型上应用Ridge和Lasso,看看正则化能否挽回局面。
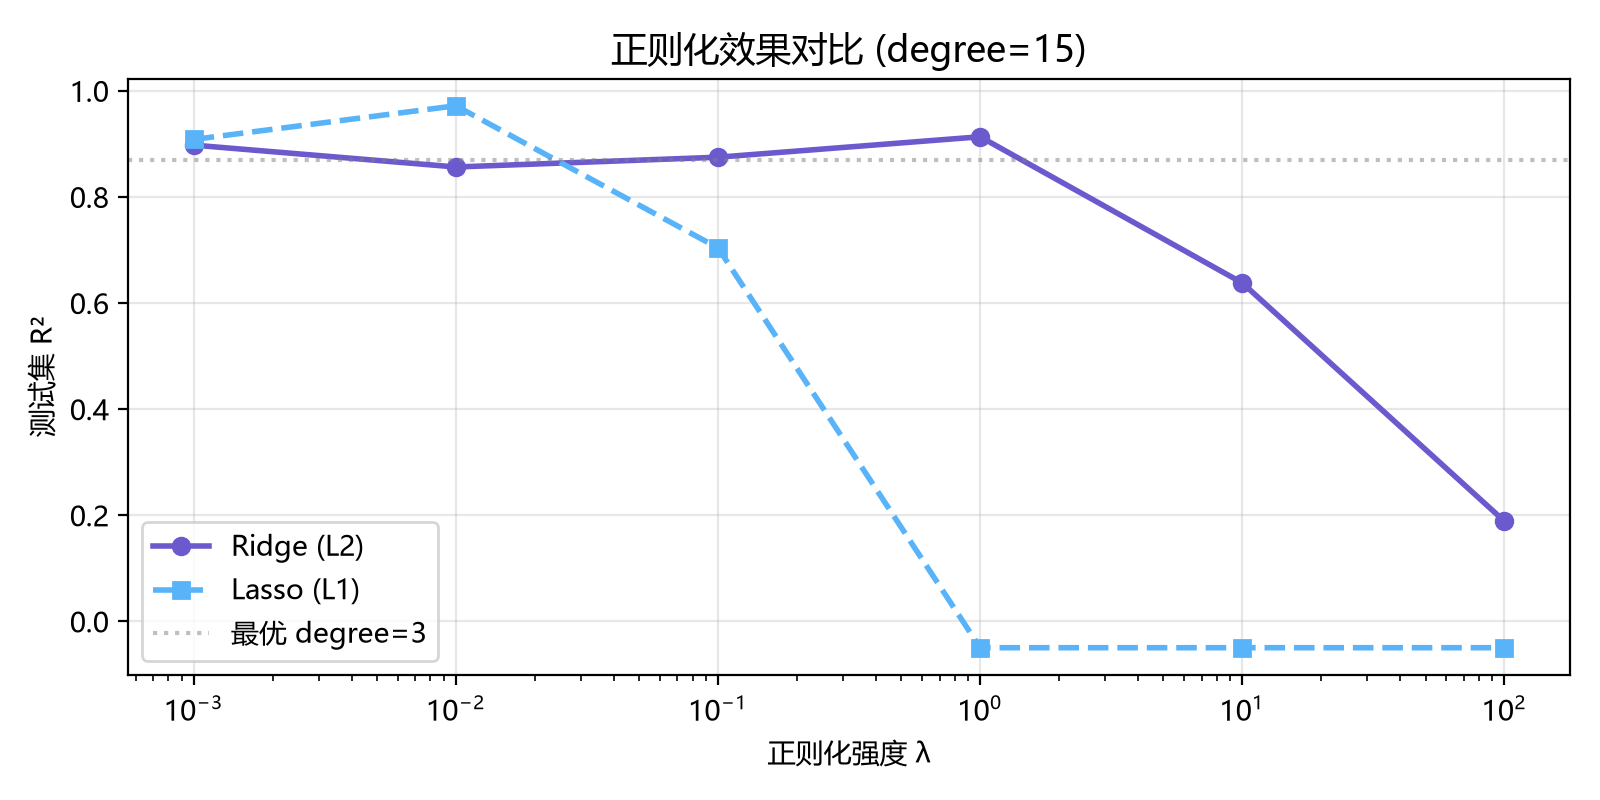
预期输出: 当λ很小(如0.001)时,Ridge和Lasso的测试R²都接近0.3(仍然严重过拟合,因为正则化几乎不起作用)。随着λ增大,测试R²先上升后下降。Ridge在λ≈1时达到最优(测试R²约0.85,接近degree=3的0.87这个理想上限),之后随λ继续增大而下降(λ=100时测试R²降为负值——正则化过强导致欠拟合)。Lasso在λ≈0.1时表现最佳(测试R²约0.82),但比Ridge略差——这是因为在本例中所有15个多项式特征都有一定贡献,Ridge"保留所有但压缩"的策略更合适。
关键洞察: λ的选择至关重要。太小则正则化不足(仍过拟合),太大则正则化过度(欠拟合)。最优λ通常落在
八、系数收缩路径与Lasso特征选择
系数收缩路径(Regularization Path)展示了当λ从大到小变化时,每个系数的取值轨迹。这是理解L1和L2行为差异的最佳可视化手段。
Ridge系数路径
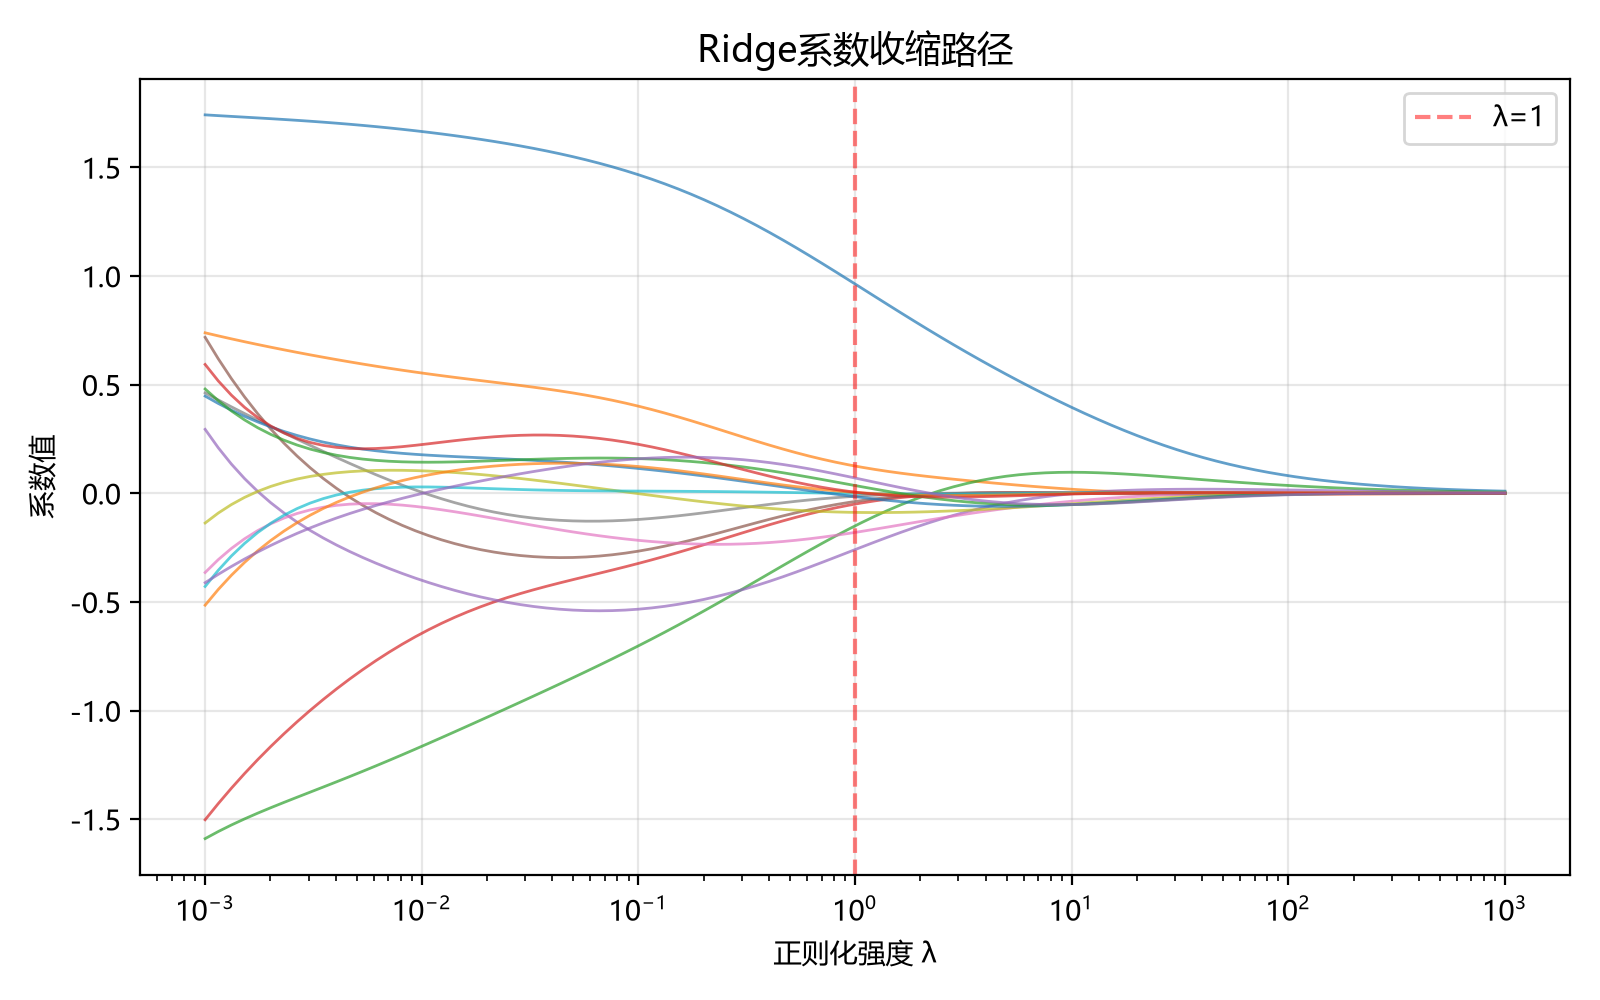
预期输出: 横轴是λ(从0.001到1000的对数坐标),纵轴是系数值,15条不同颜色的曲线分别代表15个多项式项的系数。可以看出,所有系数的值随λ增大而向0连续收缩——从λ≈0.001时系数可以取到±30左右的较大值,到λ≈1000时所有系数都趋近于0。但没有任何一条曲线精确触及0。Ridge的路径是光滑的、渐近的、连续的。当λ=1时(红色虚线位置),系数已经被压缩到±5以内,但全部15个系数依然非零。
Lasso路径图
Lasso的路径与Ridge有本质区别——随着λ增大,系数会逐个变成0,这是一个非连续的过程。
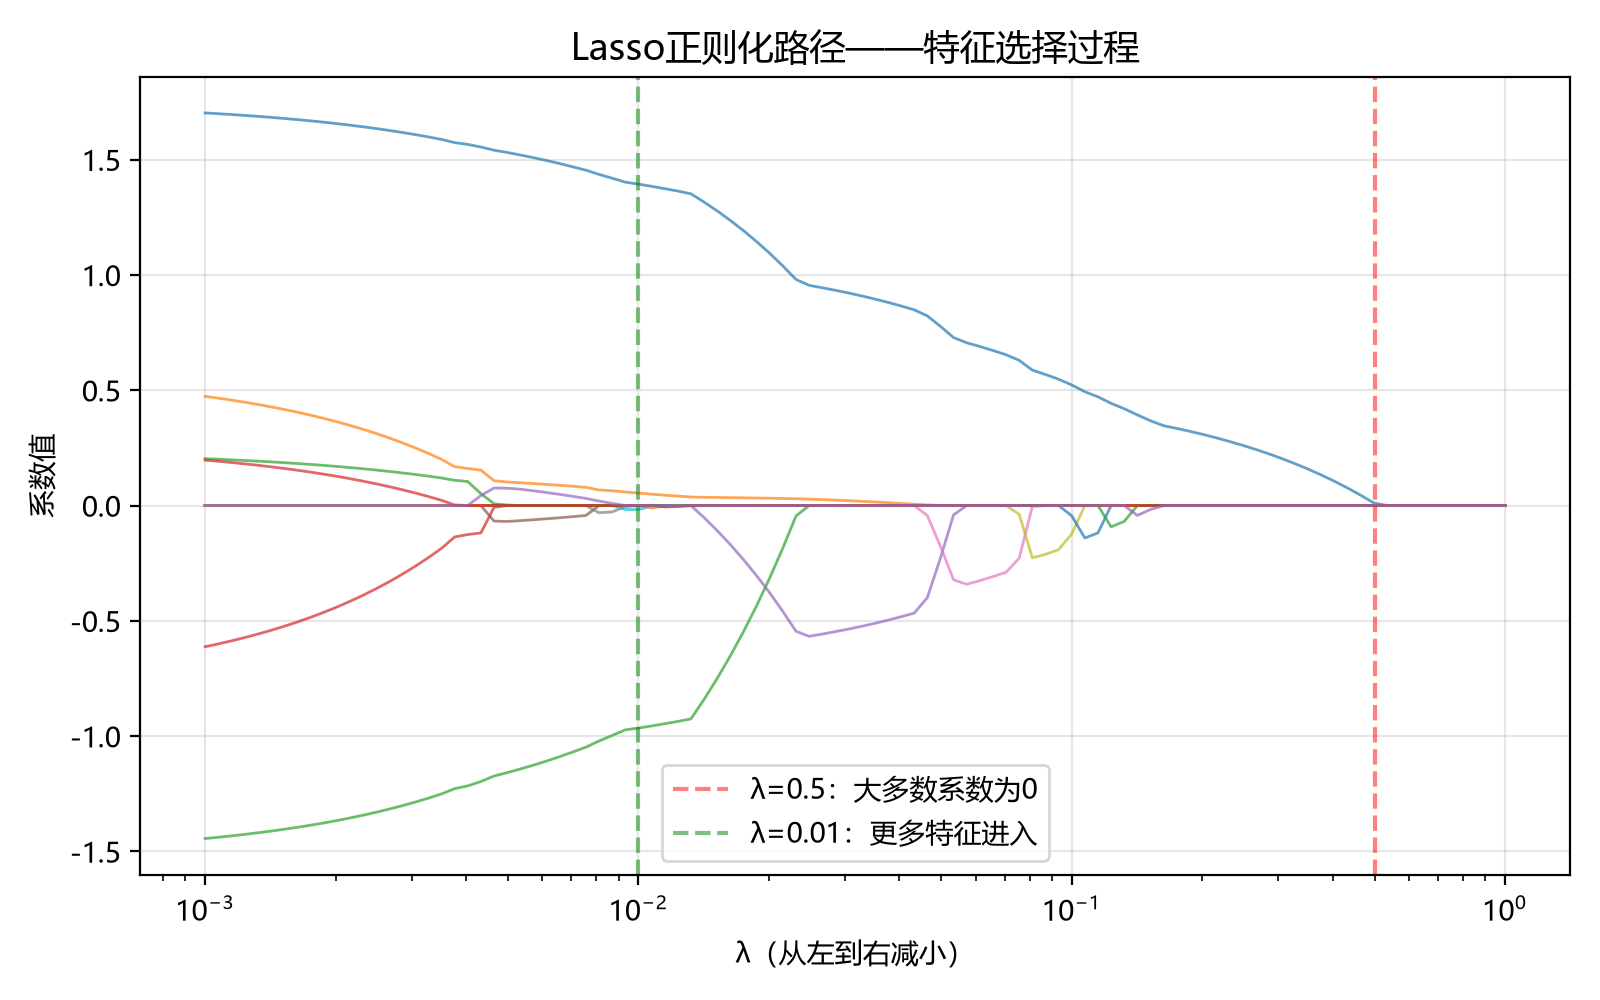
预期输出: 从右往左看(λ从大到小),最右侧λ≈1时所有15个系数都是0(一条粗的水平线)。当λ减小到约0.5时,有2-3个系数"跳"离零轴——这些是最重要的特征被"选中"了。随着λ继续减小到0.1左右,越来越多的系数脱离零轴。到最左侧λ≈0.001时,大部分系数都非零。与Ridge的平滑收缩不同,Lasso的路径呈现非连续的稀疏化过程——系数从0到非0的转变是"跳跃式"的,这正是L1惩罚在零点不可导导致的数学特性。
Lasso路径的实际意义: 通过观察路径图,我们可以直观地判断哪些特征是"重要的"(在λ很大时就进入模型的)和"不重要的"(直到λ很小才进入模型的)。结合λ的选择,我们可以控制模型的稀疏程度。
九、Elastic Net:L1+L2混合
Elastic Net由Hui Zou和Trevor Hastie于2005年提出,旨在结合Lasso的特征选择能力和Ridge的分组效应。当特征之间存在高度相关关系时,Lasso倾向于随机选择其中一个而忽略其余,而Elastic Net可以同时选中一组相关特征——这一特性被称为"分组效应"(Grouping Effect)。
数学定义
Elastic Net的损失函数是L1和L2惩罚的加权和:
其中两个超参数各有分工:
:控制总的正则化强度(越大惩罚越重) :控制L1和L2的混合比例(注意scikit-learn中参数名为 l1_ratio):纯Lasso(L1),完全的特征选择 :纯Ridge(L2),完全的系数压缩 :L1和L2各贡献一半的惩罚
Elastic Net的三大优势
克服Lasso的局限:当两个特征高度相关时,Lasso会"随机"选择其中一个,因为L1对相关特征没有偏好。Elastic Net中的L2项会鼓励两个相关特征的系数同时被压缩或保留,避免了这种随机性。
保持稀疏性:L1部分保证了模型仍然可以做特征选择,不会像纯Ridge那样保留所有特征。
分组效应:Elastic Net倾向于将正相关的特征同时纳入或排除模型,这在基因表达数据等高维相关特征场景中特别有价值。
输出清晰地展示了
Elastic Net vs Lasso vs Ridge 对比
三个模型在相同
十、交叉验证选择正则化强度λ
手动调节λ非常繁琐而且容易过拟合验证集。scikit-learn提供了内置交叉验证的版本:RidgeCV、LassoCV 和 ElasticNetCV,它们可以自动在候选λ值中搜索最优选择。
RidgeCV——自动选λ
RidgeCV 使用留一交叉验证或K折交叉验证,在所有候选λ中自动选择使验证误差最小的那个。
RidgeCV自动选择了λ=0.8742,这个值非常接近我们在第7节手动调参时观察到的"最优区间"。注意RidgeCV保留了所有15个特征(系数非零个数=15),测试R²达到0.8573,比原来未正则化的0.301有了质的飞跃。
LassoCV——自动选λ + 特征选择
LassoCV 不仅自动选择λ,还会自动完成特征选择——它返回的模型系数中已经包含了很多零。
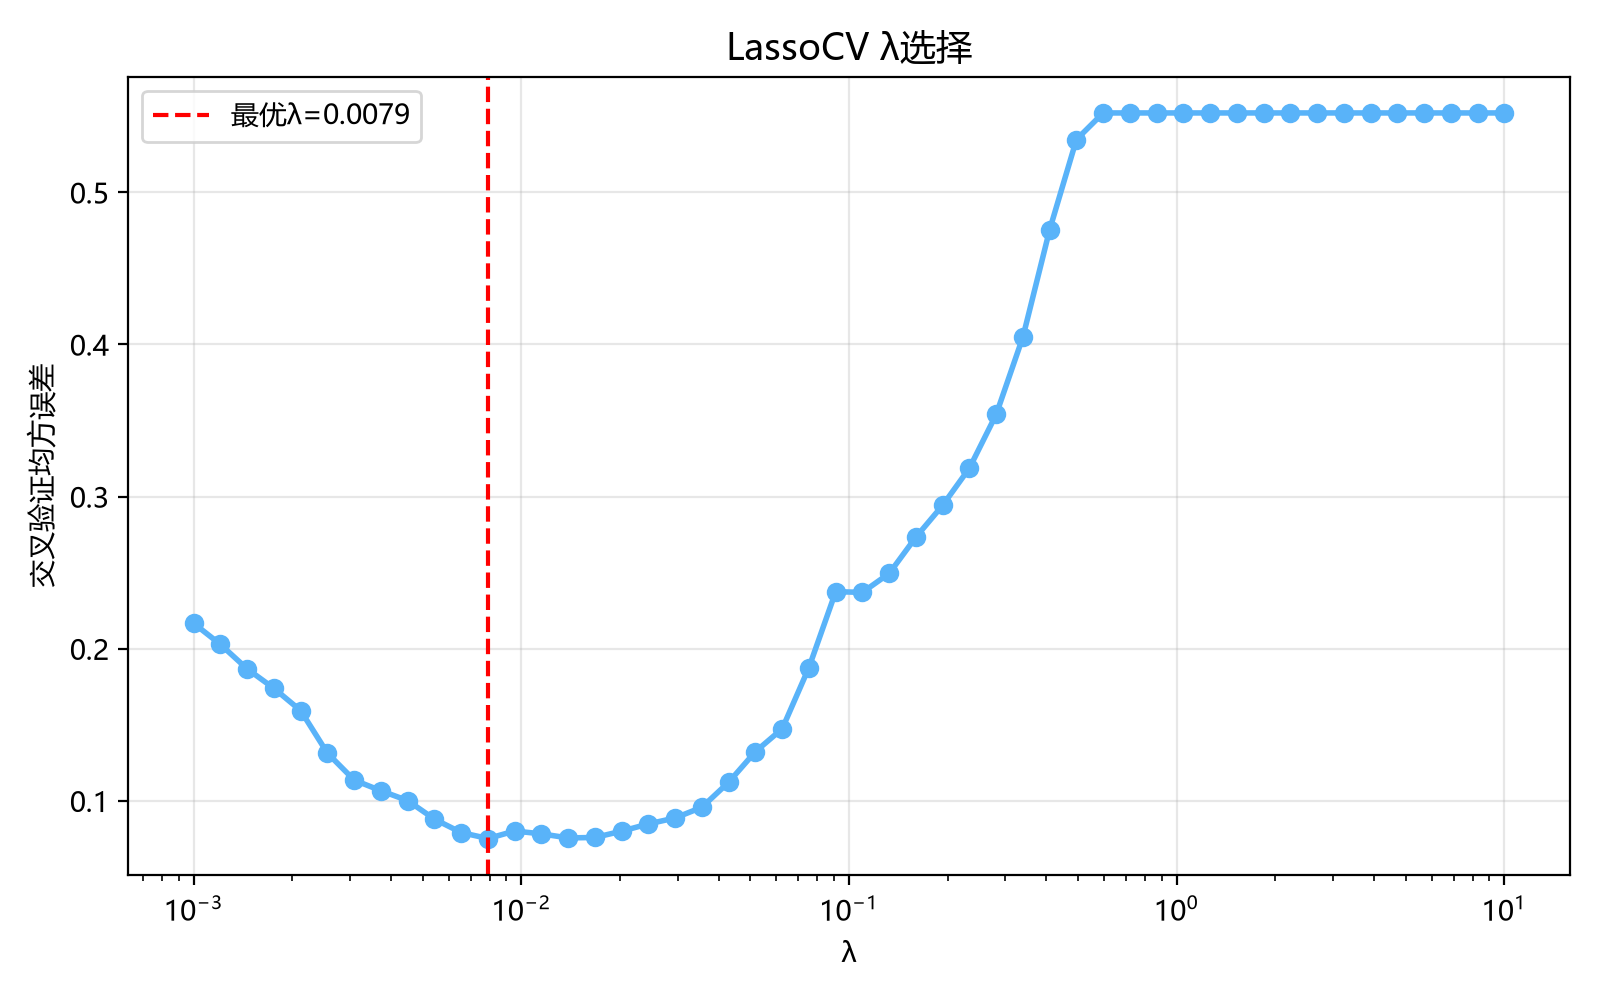
从15个特征中只选了7个——LassoCV自动完成了特征选择!图中显示了交叉验证均方误差随λ的变化曲线,最优λ(红色虚线)位于曲线的谷底。注意当λ太大时(右侧),均方误差很高(模型过于稀疏,欠拟合);当λ太小时(左侧),均方误差也逐渐上升(模型过于复杂,过拟合)。
ElasticNetCV——同时搜索λ和α
ElasticNet有两个超参数,手工调参的难度加倍。ElasticNetCV 可以同时搜索最优的λ和α(l1_ratio)。
ElasticNetCV 选择了
十一、正则化使用建议
决策流程图
面对实际问题时,如何选择正则化方法?下面是一张简洁的决策流程图:
详细建议表
| 场景 | 推荐方法 | 原因 |
|---|---|---|
| 所有特征都有用,期望系数平滑 | Ridge (L2) | 系数压缩但不为零,保留所有特征,预测稳定 |
| 怀疑大部分特征无用,需要降维 | Lasso (L1) | 自动特征选择,产生稀疏解,模型更简洁 |
| 特征高度相关(如基因数据、文本TF-IDF) | Elastic Net | 克服Lasso随机选择缺陷,保留分组效应 |
| 特征数 >> 样本数(高维小样本) | Lasso / Elastic Net | L2在高维空间效果有限,L1的稀疏性更适用 |
| 需要可解释性强的模型 | Lasso (L1) | 系数为0的特征可直接排除,模型更简洁易解释 |
| 追求预测精度,不关心特征选择 | Ridge (L2) / Elastic Net | 连续收缩通常比硬截断预测更稳定 |
| 完全不确定选哪个 | ElasticNetCV | 内置CV自动搜索最优λ和α |
关键注意事项
标准化是必须的:正则化对特征尺度极其敏感。如果一个特征的单位是"米"(取值0-100),另一个是"毫米"(取值0-100000),L1/L2惩罚会不成比例地惩罚数值大的特征,导致模型偏向。使用
StandardScaler将每个特征标准化为零均值、单位方差。λ的搜索范围:实际应用中λ通常从
尺度上搜索,范围一般在 到 之间。推荐使用 np.logspace(-3, 3, 50)生成候选值。Lasso的局限性:
- 当
(特征数大于样本数)时,Lasso最多只能选出n个特征——这是它的一个理论局限 - 高度相关的特征中Lasso会"随机"选择其中一个,选哪个取决于数据的微小扰动,导致模型不稳定
- 对这些局限,Elastic Net是更好的替代
- 当
Elastic Net的两个超参数:
(总强度)和 (混合比)。推荐先用 ElasticNetCV同时搜索,而不是手动调参。的候选集通常设为 [0.1, 0.3, 0.5, 0.7, 0.9, 0.95, 0.99, 1.0],覆盖从接近Ridge到纯Lasso的整个区间。正则化不是万能药:如果模型严重欠拟合(偏差过高),正则化只会雪上加霜。一定要先通过学习曲线判断是过拟合还是欠拟合,再决定是否使用正则化。
十一、数学文化:过拟合问题的百年认知史
11.1 约翰·冯·诺伊曼(John von Neumann, 1903-1957)
他的名言——"给我四个参数,我可以拟合一头大象;给我五个参数,我可以让它的鼻子摆动"——精准概括了过拟合的本质:模型越复杂,越容易记住噪声而不是学习信号。虽然这句话可能只是坊间传闻,但它准确反映了数学界对"参数过多"的警觉。
11.2 安德烈·季霍诺夫(Andrey Tikhonov, 1906-1993)
苏联数学家,1943年提出了正则化(Regularization)的概念:通过给目标函数添加一个惩罚项来"平滑"解。季霍诺夫正则化(后来被称为Ridge回归中的L2正则化)的最初动机是解决病态逆问题——这恰好与机器学习中的过拟合问题是同一数学结构。
11.3 弗拉基米尔·瓦普尼克(Vladimir Vapnik, 1936-)
俄罗斯数学家,统计学习理论(VC理论)的奠基人。他与阿列克谢·切尔沃年基斯(Alexey Chervonenkis)在1970年代提出了VC维——衡量模型复杂度的严格数学框架。VC理论说明了一个深刻的结论:降低模型复杂度的VC维可以有效控制过拟合。
FAQ
Q:L1和L2正则化应该选哪个? A:当你希望做特征选择、模型可解释性更重要时用L1;当所有特征都有一定预测力、你希望保留全部信息时用L2。实践中常用Elastic Net结合两者——先用L1选特征,再用L2做收缩。
Q:正则化系数λ怎么调? A:交叉验证。RidgeCV和LassoCV内置了高效的留一交叉验证解法(广义交叉验证GCV),无需手动做K折。
Q:贝叶斯视角下L1和L2的区别是什么? A:L2正则化等价于给参数施加高斯先验,L1等价于拉普拉斯先验。高斯先验倾向于参数均匀小(所有特征都贡献一点),拉普拉斯先验倾向于参数稀疏(大多数特征贡献为零)。
数据声明:本文使用sklearn内置数据集演示,不涉及真实金融数据。 代码环境:Python 3.10, NumPy, scikit-learn, matplotlib。
© QianStat_data 2026