风控策略规则的代理变量冗余——九条规则三个维度,最优只需三条
2026年8月11日 · 预计阅读 10 分钟
关键词:代理变量,策略冗余,独有命中,Lift,集合覆盖,策略最优
01 现象:九条规则,三个维度,拦的是同一批人吗
为什么你的策略系统里规则越加越多,拦截率却不涨?
上一篇(#105)讲了"逻辑冗余":规则A命中的每一个客户,规则B都命中,A是B的子集——布尔代数可以直接证明,删掉A不影响任何结果。
但真实业务里,更常见的冗余长这样:同一个风险维度,被换着花样加了多条规则。
举一个几乎每家机构都有的场景。策略团队三年里陆续加了9条规则,仔细一看,它们其实只覆盖三个风险维度:
| 维度 | 规则 | 谁加的 |
|---|---|---|
| A 负债压力 | A1 负债率 > 30% | 同事1 |
| A2 月供收入比 > 0.15 | 同事2 | |
| A3 贷款额收入比 > 0.40 | 同事2 | |
| B 多头授信 | B1 账户数 >= 19 | 同事3 |
| B2 总账户数 >= 40 | 同事1 | |
| B3 近6月查询次数 >= 2 | 同事3 | |
| C 信用历史 | C1 信用分 < 680 | 同事2 |
| C2 逾期次数 >= 2 | 同事1 | |
| C3 近12月催收 >= 1 | 同事3 |
每条规则单独看都有道理:负债高的、多头借贷的、信用差的,都是风险信号。但问题是——A1、A2、A3 都在测"这人还不还得起钱",B1、B2、B3 都在测"这人借了多少家",C1、C2、C3 都在测"这人以前信用好不好"。
同一件事,测三遍,有意义吗?
02 追问:代理变量,是不是天然冗余
先看一个残酷的事实。把 LendingClub 2007-2018 年公开贷款数据(226万笔,剔除缺失后样本 2,257,038 笔)里的变量两两算相关:
月供收入比(pti,月供/月收入)和贷款额收入比(lti,贷款额/年收入),相关系数 0.987——它们几乎是同一个变量。一个客户贷款额高,月供必然高;月供收入比高,贷款额收入比也高。A2 和 A3 这两条规则,本质是同一把尺子的两种刻度。
再算账户数(open_acc)和总账户数(total_acc):
多头授信维度里,B1 和 B2 也高度相关。
为什么会出现这种"同一个维度换着花样加规则"?因为真实业务里,字段有缺失、有噪声、不同数据源口径不同——团队为了"稳健",每发现一个新字段就补一条规则。初衷是好的,但代价是规则之间大量重复拦截。
这里有个关键区分(和#105的分工):
- #105 逻辑冗余:A⊆B,布尔代数证明,任何时候任何数据都成立
- 本文 统计冗余:A 和 B 没有包含关系,但在真实数据上拦的是高度重叠的一批人——不能证明,只能实测
逻辑冗余可以靠数学判定,统计冗余只能靠数据说话。本文就是给统计冗余一个完整的量化框架,并且回答一个更实际的问题:给定目标覆盖率,最少要留几条规则?
03 方法:独有命中、Lift、重叠度、集合覆盖
3.1 独有命中——一条规则的"不可替代性"
和#105一样,先定义独有命中(unique hits):只被这条规则拦截、不被任何其他规则拦截的客户数。
其中
大:这条规则拦下了一批别人拦不到的人——不可替代 小:它拦的人,其他规则基本都拦了——候选冗余
3.2 Jaccard 重叠度——谁和谁拦的是同一批人
两两重叠用 Jaccard 相似度:
3.3 Lift——一条规则的"抓风险能力"
独有命中看"能不能删",Jaccard 看"和谁重叠",还缺一个指标回答"这条规则拦的人,到底有多危险"。风控行业用 Lift:
:这条规则拦的人群风险和整体没区别——无效规则 :它精准命中了比平均更危险的人,越高越值钱
Lift 和独有命中是正交的两个视角:独有命中看量(拦了多少别人拦不到的人),Lift 看质(拦的人是不是真危险)。一条规则可能独有命中很多但 Lift 接近 1(拦了一大堆"其实没那么糟"的人),也可能独有命中很少但 Lift 很高(拦的每一笔都是风险)——策略最优两个都要看。
3.4 贪心集合覆盖——策略最优的最小规则集
独有命中只回答"单条规则可不可替代",不回答"整体最少要几条"。后者是经典的集合覆盖问题(set cover):
要找覆盖全部拦截客户的最小规则子集
更重要的是业务的问法不是"100% 覆盖要几条",而是**"我要拦下 95% 的高风险客户,最少几条规则"**——这直接给出策略优化的目标函数。
04 拆解结果:真实数据怎么说
在 LendingClub 2,257,038 笔样本上,把 9 条规则全部跑一遍。整体坏账率 13.21%,9 条规则合计拦截 1,372,887 人(60.83%)——拦截率偏高是因为 C1 信用分<680 一条就拦了 31.6%,规则之间大量重叠(这正是 4.3 要量化的冗余)。
4.1 单规则命中与独有命中
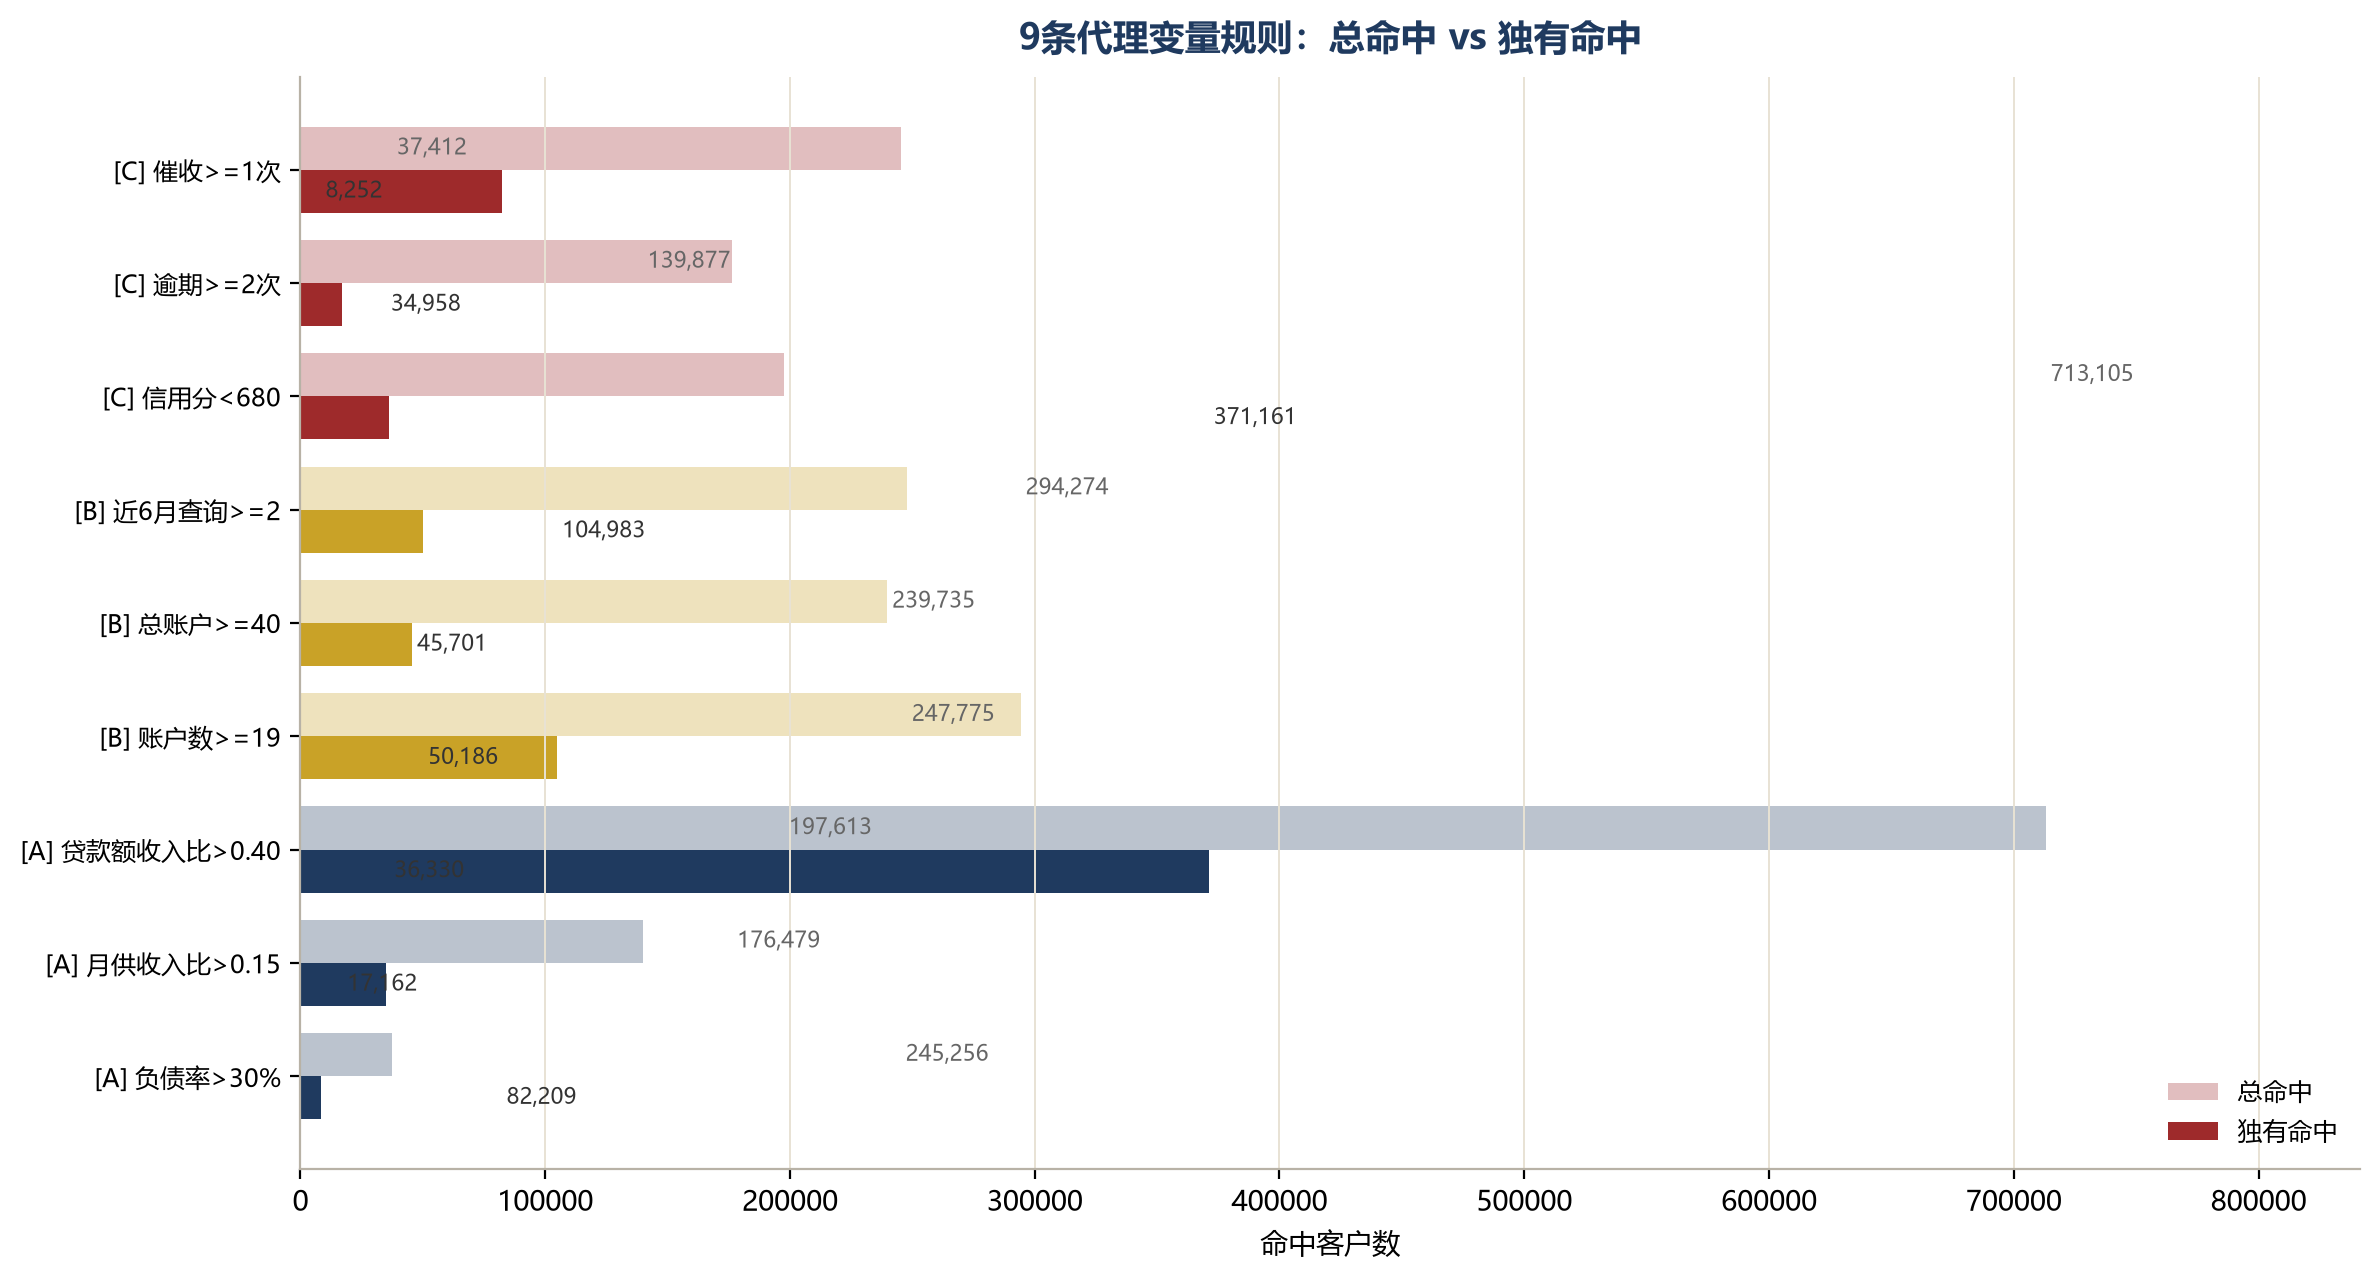
| 规则 | 维度 | 总命中 | 独有命中 | 独有占自身 | 命中坏账率 |
|---|---|---|---|---|---|
| A1 负债率>30% | 负债压力 | 245,256 | 82,209 | 33.5% | 17.02% |
| A2 月供收入比>0.15 | 负债压力 | 176,479 | 17,162 | 9.7% | 16.99% |
| A3 贷款额收入比>0.40 | 负债压力 | 197,613 | 36,330 | 18.4% | 16.62% |
| B1 账户数>=19 | 多头授信 | 247,775 | 50,186 | 20.3% | 13.99% |
| B2 总账户>=40 | 多头授信 | 239,735 | 45,701 | 19.1% | 14.08% |
| B3 近6月查询>=2 | 多头授信 | 294,274 | 104,983 | 35.7% | 19.05% |
| C1 信用分<680 | 信用历史 | 713,105 | 371,161 | 52.0% | 17.88% |
| C2 逾期>=2次 | 信用历史 | 139,877 | 34,958 | 25.0% | 15.70% |
| C3 催收>=1次 | 信用历史 | 37,412 | 8,252 | 22.1% | 16.09% |
注意:9 条规则没有一条独有命中为 0——不像#105的同特征阶梯那样有"必然冗余"。每条规则都拦下了一些别人拦不到的人。所以不能简单删,要量化"值不值得留"。
两个观察:
第一,代理变量确实在重复拦人。 A2 月供收入比的独有命中只有 17,162(占自身 9.7%),也就是说它拦的 17.6 万人里,90% 已经被其他规则拦了。A2 和 A3(相关 0.987)几乎互为替身。
第二,命中坏账率分层明显。 B3 近6月查询>=2 的命中坏账率 19.05%,是全表最高的——频繁查询是真风险信号;而 B1 账户数>=19 只有 13.99%,接近整体均值。同样是"多头授信"维度,B3 比 B1/B2 精准得多。
4.2 单规则 Lift:谁真正抓到了高风险人群
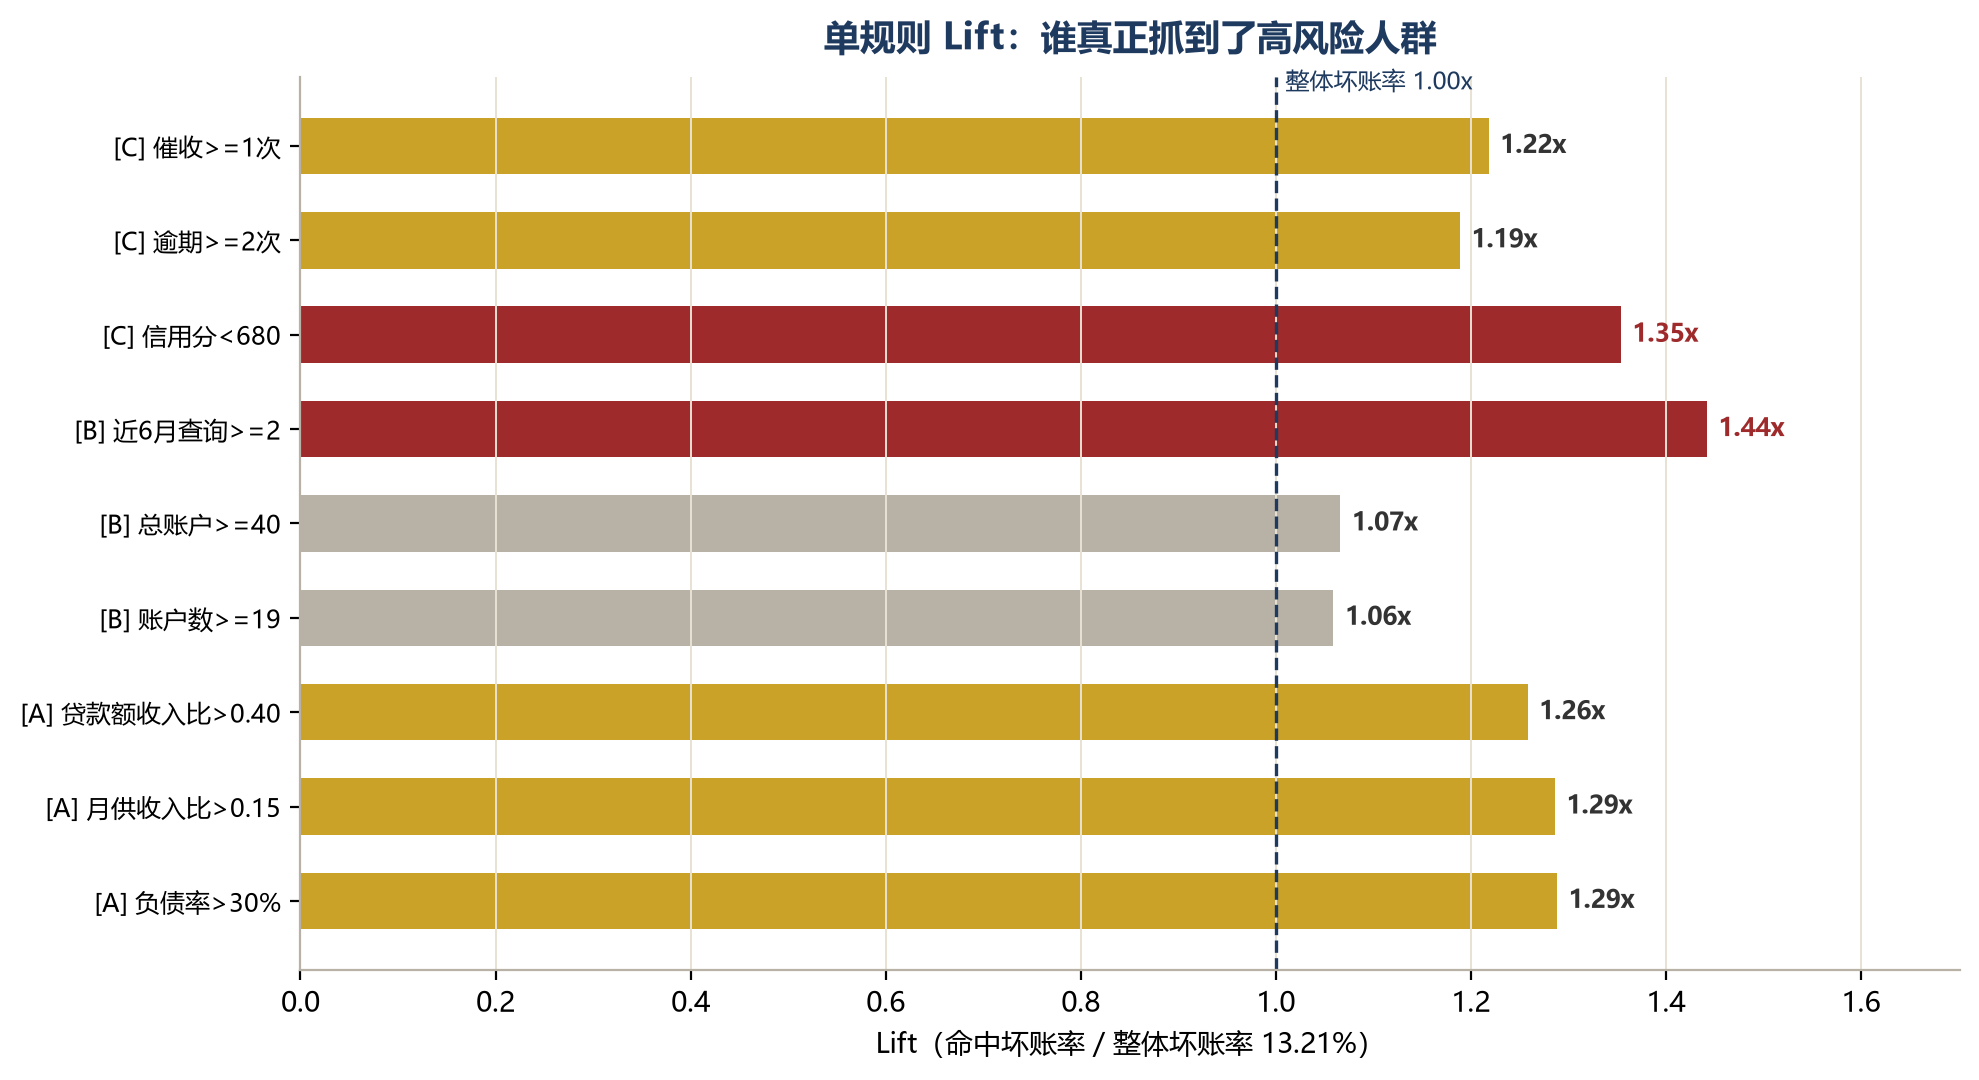
上一节表里最后一列是命中坏账率,把它除以整体坏账率(13.21%)就是每条规则的 Lift(定义见 3.3):
| 规则 | 维度 | 命中坏账率 | Lift |
|---|---|---|---|
| B3 近6月查询>=2 | 多头授信 | 19.05% | 1.44x |
| C1 信用分<680 | 信用历史 | 17.88% | 1.35x |
| A1 负债率>30% | 负债压力 | 17.02% | 1.29x |
| A2 月供收入比>0.15 | 负债压力 | 16.99% | 1.29x |
| A3 贷款额收入比>0.40 | 负债压力 | 16.62% | 1.26x |
| C3 催收>=1次 | 信用历史 | 16.09% | 1.22x |
| C2 逾期>=2次 | 信用历史 | 15.70% | 1.19x |
| B2 总账户>=40 | 多头授信 | 14.08% | 1.07x |
| B1 账户数>=19 | 多头授信 | 13.99% | 1.06x |
Lift 揭示了独有命中看不到的真相:
- B3 近6月查询>=2 的 Lift 高达 1.44x——频繁查询的人坏账率是整体均值的 1.44 倍,它是9条规则里"性价比"最高的一条,虽然命中只有 29 万,但每一笔都打在风险上
- B1 账户数>=19 的 Lift 只有 1.06x——账户多的人坏账率只比整体高 6%,接近无效规则。这解释了一个反直觉现象:多头授信维度里,B1 总命中比 B3 多,但真正值钱的是 B3
- 有意思的是,Lift 和独有命中并不总是同向:B1 独有命中 5 万(比 B3 的 10 万少),Lift 却低得多——数量大不等于质量高
单规则 Lift 回答"哪条规则该留",但策略优化还要回答"留几条、拦多少"。这就是通过率与风险的博弈。
4.3 重叠矩阵:维度内高、跨维度低
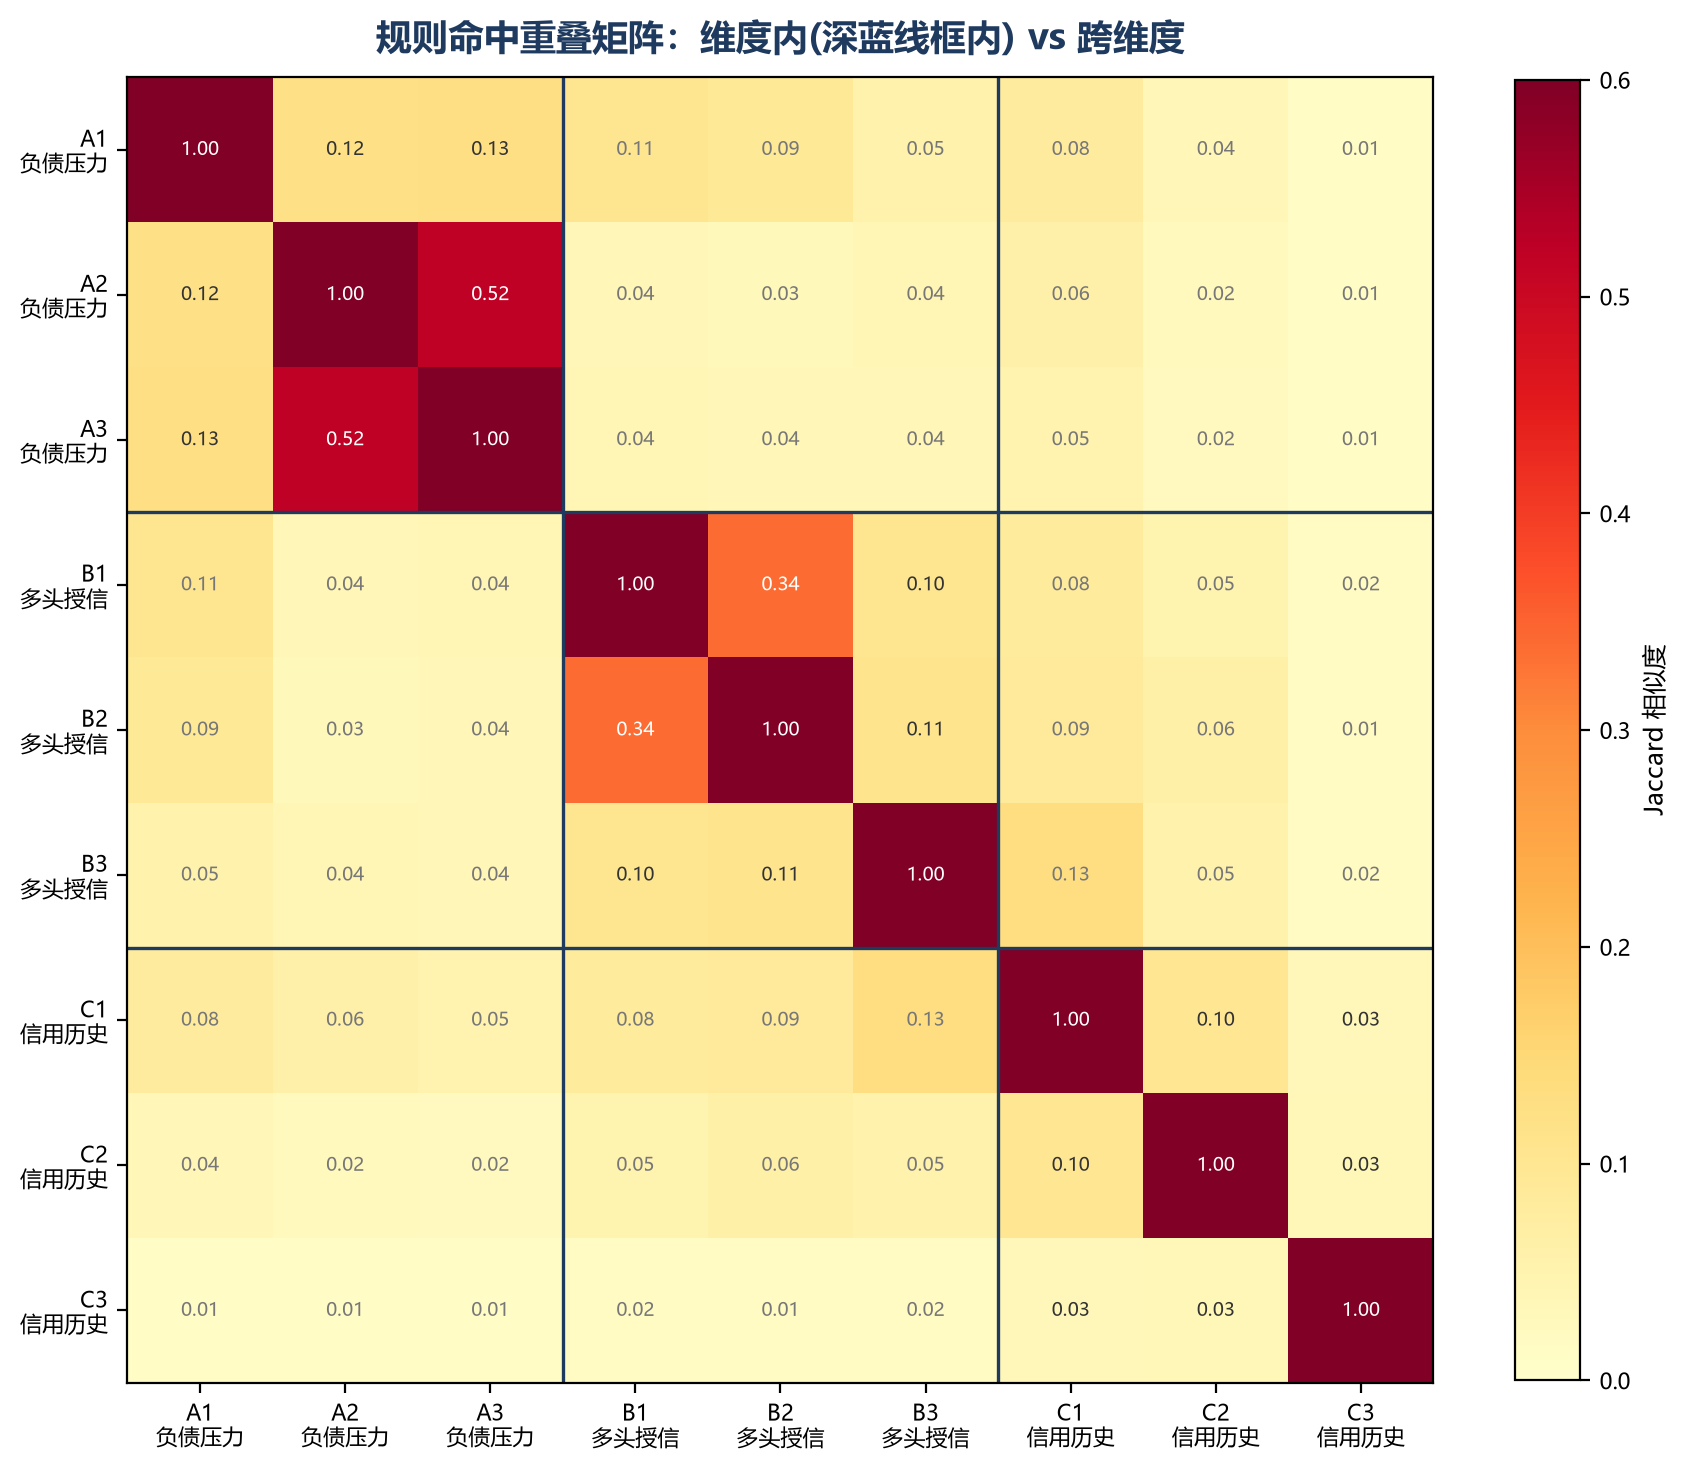
Jaccard 矩阵按维度分块(深蓝线框内是同一维度):
- 维度内均值 0.165,最高 0.518(A2 月供收入比 ∩ A3 贷款额收入比——相关系数 0.987 的直接体现)
- 跨维度均值 0.048(最高 0.130)
同维度代理变量的重叠度是跨维度的 3.4 倍——说明"同一风险维度换着花样加规则"确实在重复拦人,而不同维度的规则相对互补。
4.4 贪心覆盖:边际收益递减
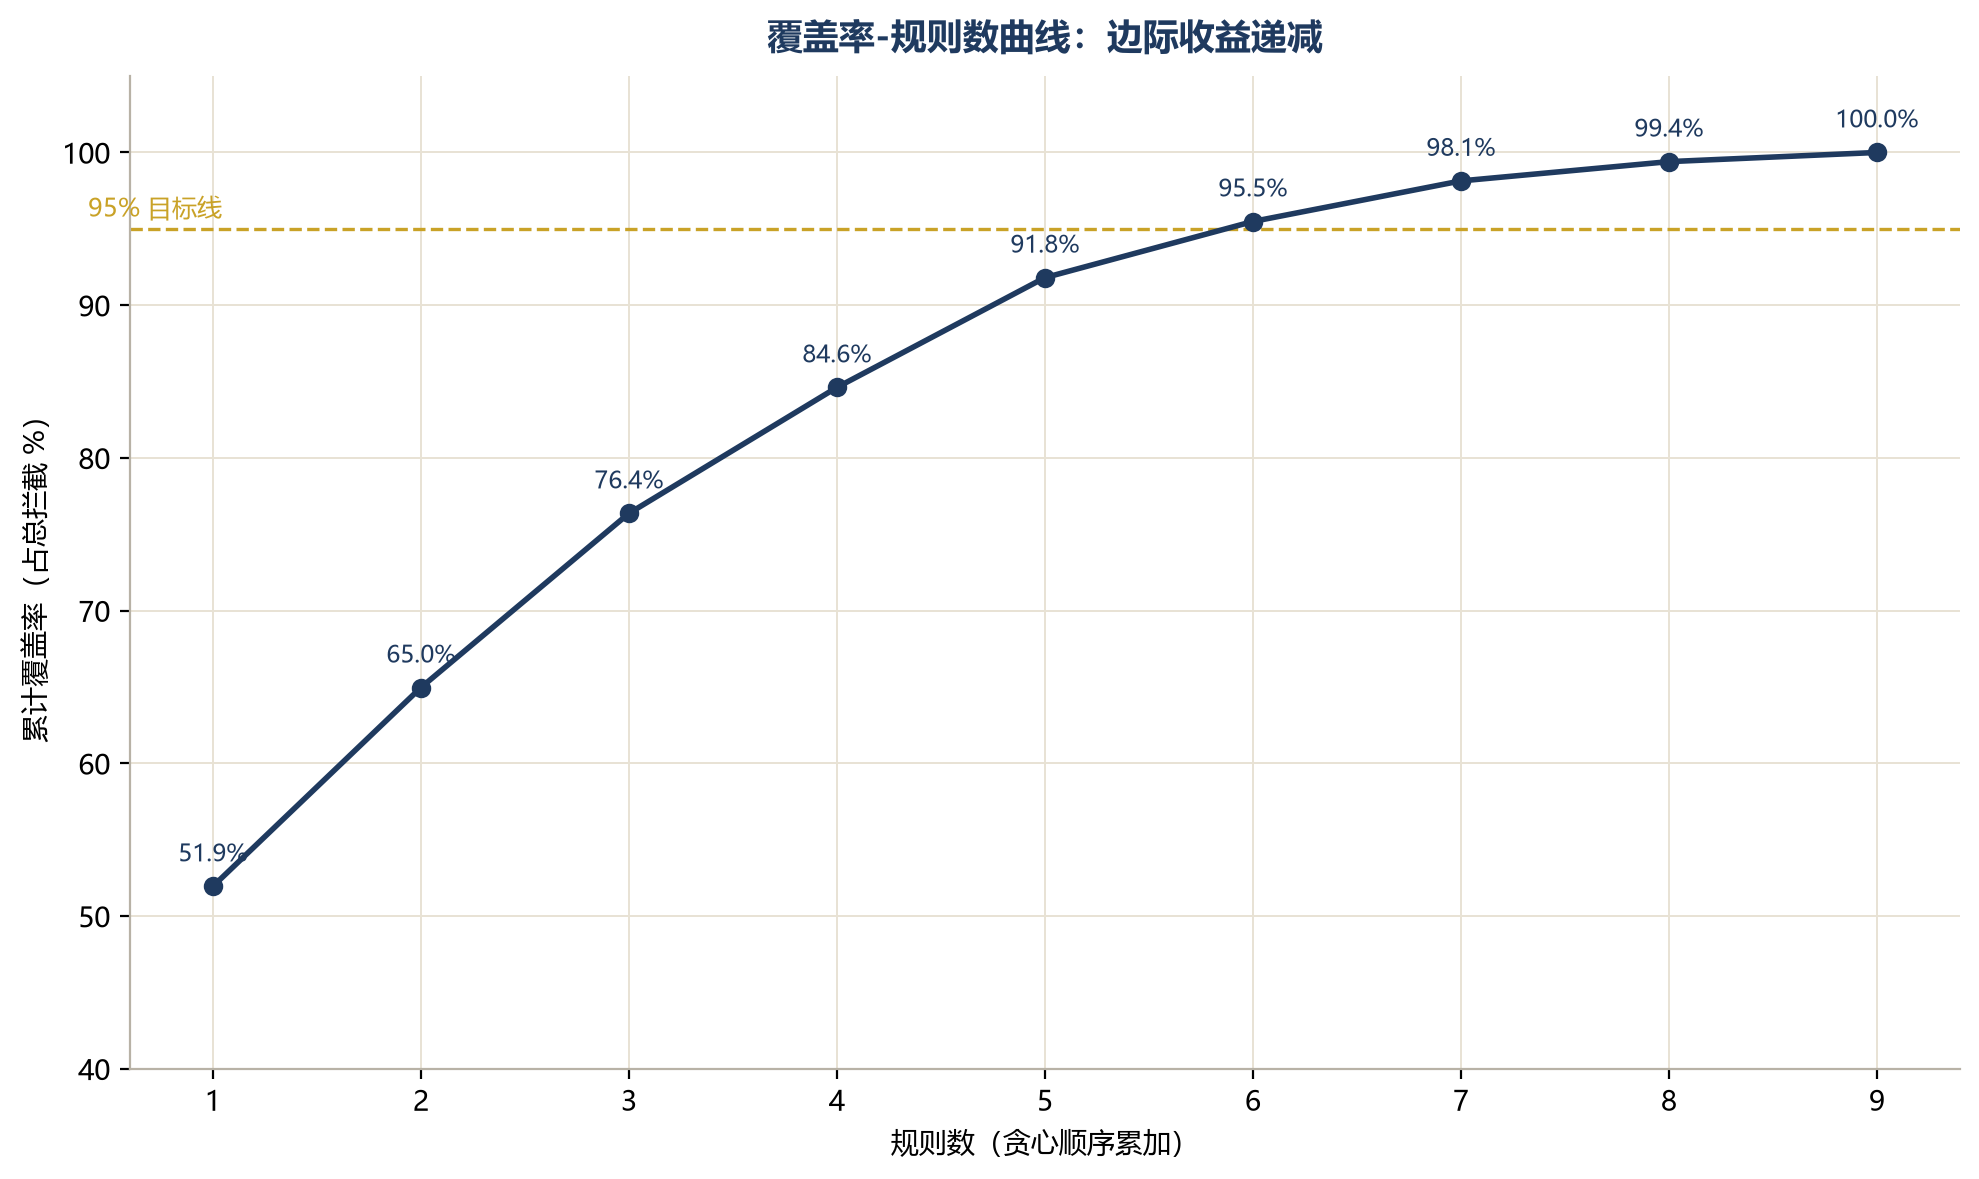
按贪心顺序逐条加入,覆盖率曲线:
| 步 | 加入规则 | 新增命中 | 累计覆盖 | 覆盖率 |
|---|---|---|---|---|
| 1 | C1 信用分<680 | 713,105 | 713,105 | 51.94% |
| 2 | B3 近6月查询>=2 | 178,692 | 891,797 | 64.96% |
| 3 | A1 负债率>30% | 156,582 | 1,048,379 | 76.36% |
| 4 | B1 账户数>=19 | 113,257 | 1,161,636 | 84.61% |
| 5 | A3 贷款额收入比>0.40 | 98,688 | 1,260,324 | 91.80% |
| 6 | B2 总账户>=40 | 50,494 | 1,310,818 | 95.48% |
| 7 | C2 逾期>=2次 | 36,486 | 1,347,304 | 98.14% |
| 8 | A2 月供收入比>0.15 | 17,331 | 1,364,635 | 99.40% |
| 9 | C3 催收>=1次 | 8,252 | 1,372,887 | 100.00% |
边际收益快速递减:前 3 条覆盖 76%,前 6 条覆盖 95%,最后 3 条只贡献 4.5% 的增量(合计 62,069 人)。
穷举验证: 9 条规则共
| 目标覆盖率 | 最少规则数 | 实际覆盖 |
|---|---|---|
| 90% | 5 条 | 91.80% |
| 95% | 6 条 | 95.48% |
| 99% | 8 条 | 99.40% |
策略团队开会时老板问"拦 95% 要几条",答案不是拍脑袋,是这张表。
这里有个值得注意的巧合:贪心前 3 条(C1 信用分 → B3 查询 → A1 负债率)恰好就是 4.2 Lift 最高的 3 条。覆盖率最大化和命中质量最大化,两个独立视角在 3 条处重合——这暗示"每维度留 1 条"可能不只是省事,而是真的划算。4.6 会验证这一点。
4.5 通过率与风险的博弈:叠加规则的整体对比
4.4 的贪心覆盖只回答"覆盖率-规则数",但真实策略决策还要回答另一个问题:每加一条规则,业务通过率下降多少,风险降多少。把 9 条规则按贪心顺序逐条叠加,每一步记录两个指标:通过率(1 - 拦截率)和通过人群的坏账率(没被拦下的那部分人,最终还有多少会坏账):
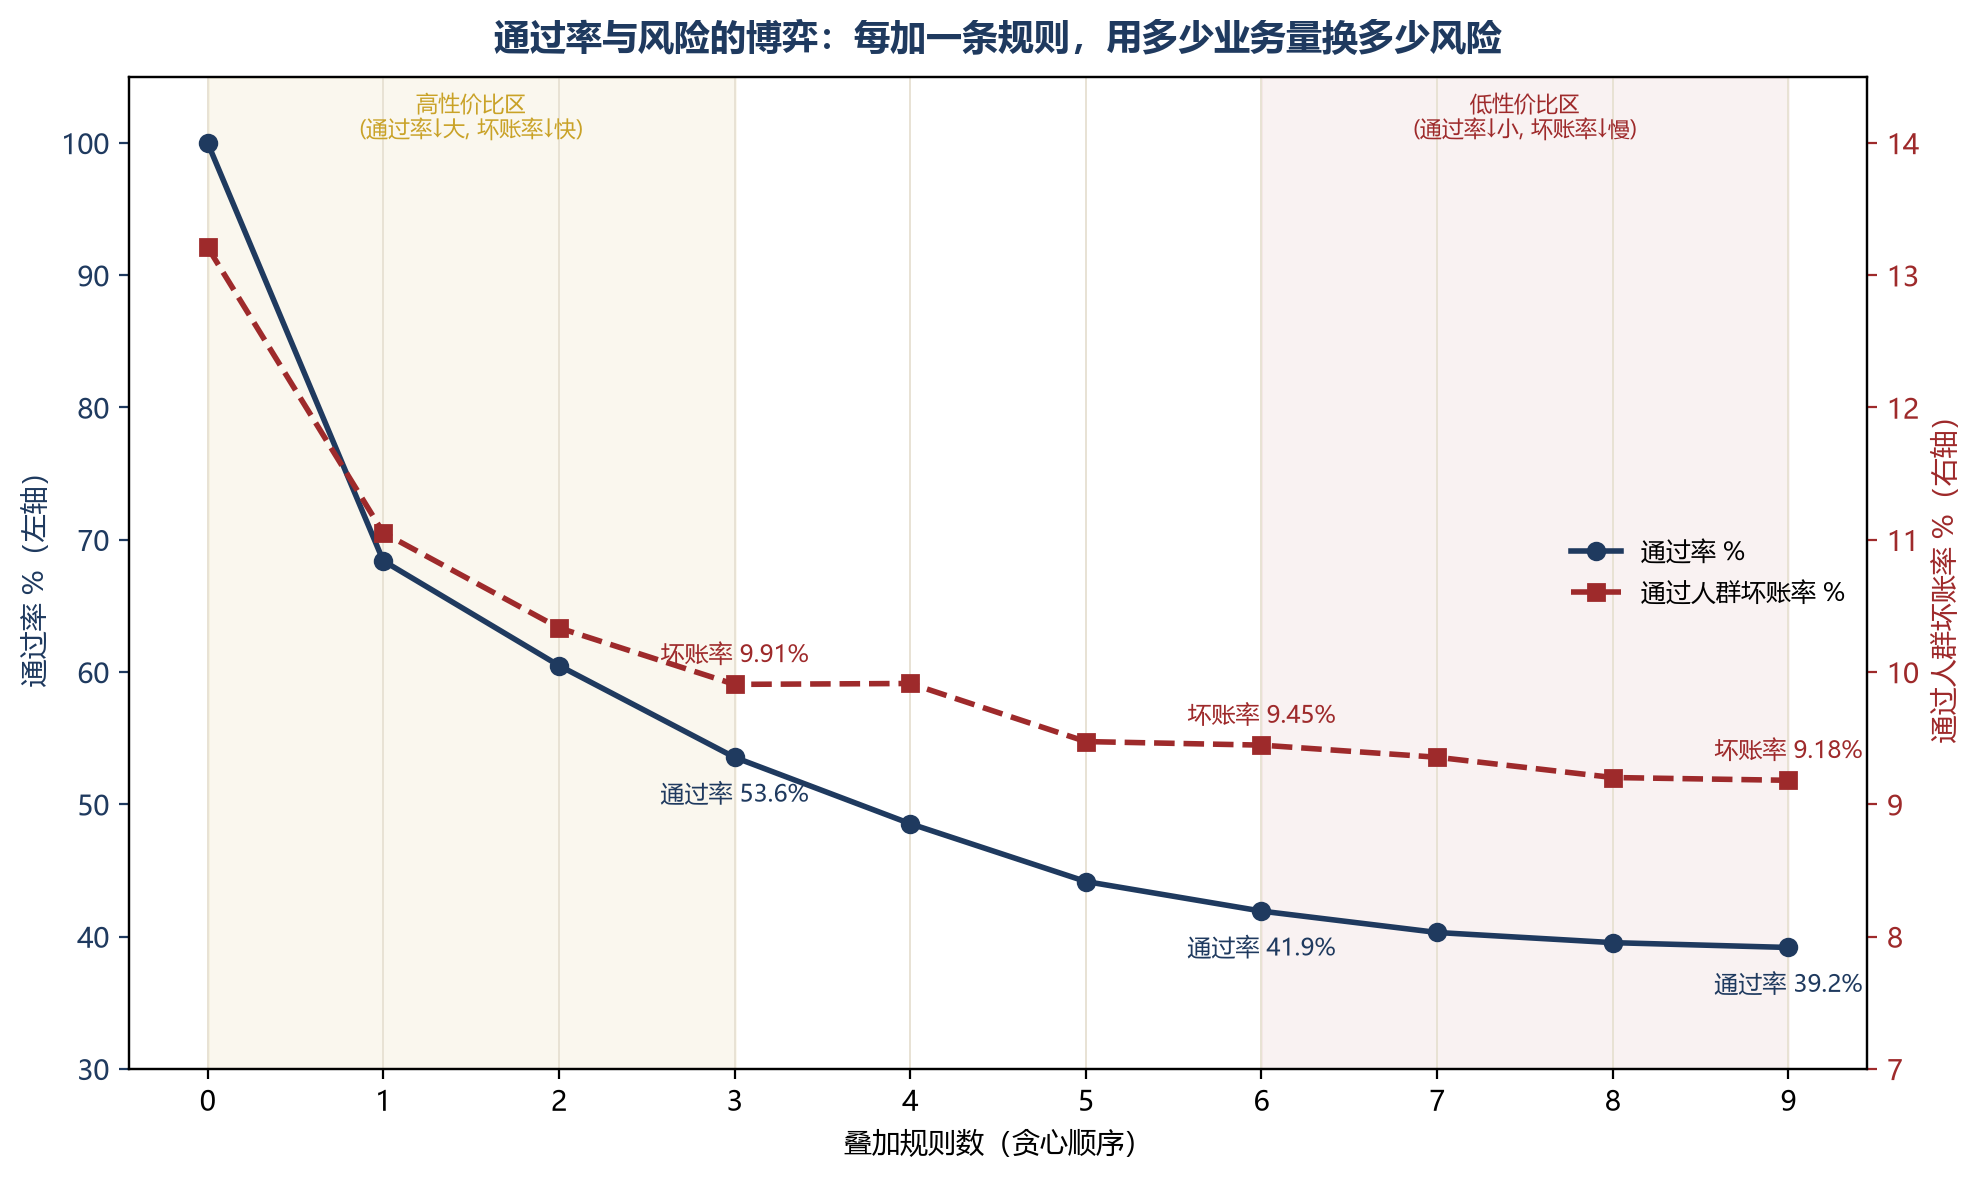
| 叠加规则数 | 通过率 | 通过人群坏账率 | 漏拦坏账 | 漏拦率 |
|---|---|---|---|---|
| 0(不拦) | 100% | 13.21% | 298,177 | 100% |
| 1 | 68.41% | 11.05% | 170,646 | 57.23% |
| 2 | 60.49% | 10.33% | 141,080 | 47.31% |
| 3 | 53.55% | 9.91% | 119,735 | 40.16% |
| 4 | 48.53% | 9.91% | 108,589 | 36.42% |
| 5 | 44.16% | 9.47% | 94,429 | 31.67% |
| 6 | 41.92% | 9.45% | 89,391 | 29.98% |
| 7 | 40.31% | 9.36% | 85,110 | 28.54% |
| 8 | 39.54% | 9.20% | 82,121 | 27.54% |
| 9(全量) | 39.17% | 9.18% | 81,175 | 27.22% |
博弈的本质在这张表里,但用"百分比点"对比容易绕晕——换个更业务化的口径:每拦下 100 个客户,里面有几个真坏账。
| 区间 | 新拦人数 | 其中坏账 | 每拦100人的坏账数 |
|---|---|---|---|
| 前 3 条规则(0→3) | 1,048,379 | 178,442 | 17.0 个 |
| 第 4-6 条(3→6) | 262,439 | 30,344 | 11.6 个 |
| 第 7-9 条(6→9) | 62,069 | 8,216 | 13.2 个 |
等一下——第 7-9 条(C2 逾期、A2 月供收入比、C3 催收)每拦 100 人有 13.2 个坏账,反而比第 4-6 条(11.6)高?这里要区分"数量冗余"和"质量":第 7-9 条虽然是"低覆盖增量"(新增命中少),但它们的命中质量并不差(C2 逾期 Lift 1.19、C3 催收 1.22),只是命中的总量小——它们拦的人不多,但拦到的人里有相当比例是坏账。
所以真正的博弈结论要分两层:
第一层,数量边际递减。 从覆盖角度看,前 3 条覆盖 76%,后 6 条只补 24%。贪心顺序下,越往后单条规则新增的拦截量越少(从 71 万降到 8 千)。
第二层,质量不随数量同步衰减。 从 Lift 看,第 7-9 条(C2 1.19x / A2 1.29x / C3 1.22x)的命中质量并不比第 4-6 条(B1 1.06x / B2 1.07x / A3 1.26x)差——真正拖后腿的是 B1 账户数>=19(1.06x)和 B2 总账户>=40(1.07x)这对"多头授信"的弱代理变量。
把两层合起来,策略最优的完整答案浮现了:
- 数量上,9 条里前 6 条已覆盖 95.5%,第 7-9 条只是"补漏"(覆盖增量 4.5%)
- 质量上,真正 Lift 低的是 B1/B2(1.06-1.07x)——"数量不小但质量差"
- 所以最优不是简单的"前 6 条"或"每维度 1 条",而是贪心覆盖顺序 + Lift 质量双排序的交叉:优先保留高 Lift 规则(B3/C1/A1),优先删除低 Lift 规则(B1/B2),再按覆盖率目标定条数
单规则 Lift 告诉你哪条该留(B3 1.44x,B1 1.06x 该删),叠加博弈曲线告诉你留几条(前 3 条覆盖性价比最高)——但两个视角合起来怎么定最终方案,见 4.6。
4.6 策略最优:更少的规则,更精准的拦截
现在把 4.5 的博弈结论收敛成一个具体方案对比:每个维度只留最优的 1 条(A1 负债率>30% + B3 近6月查询>=2 + C1 信用分<680),3 条规则 vs 全量 9 条:
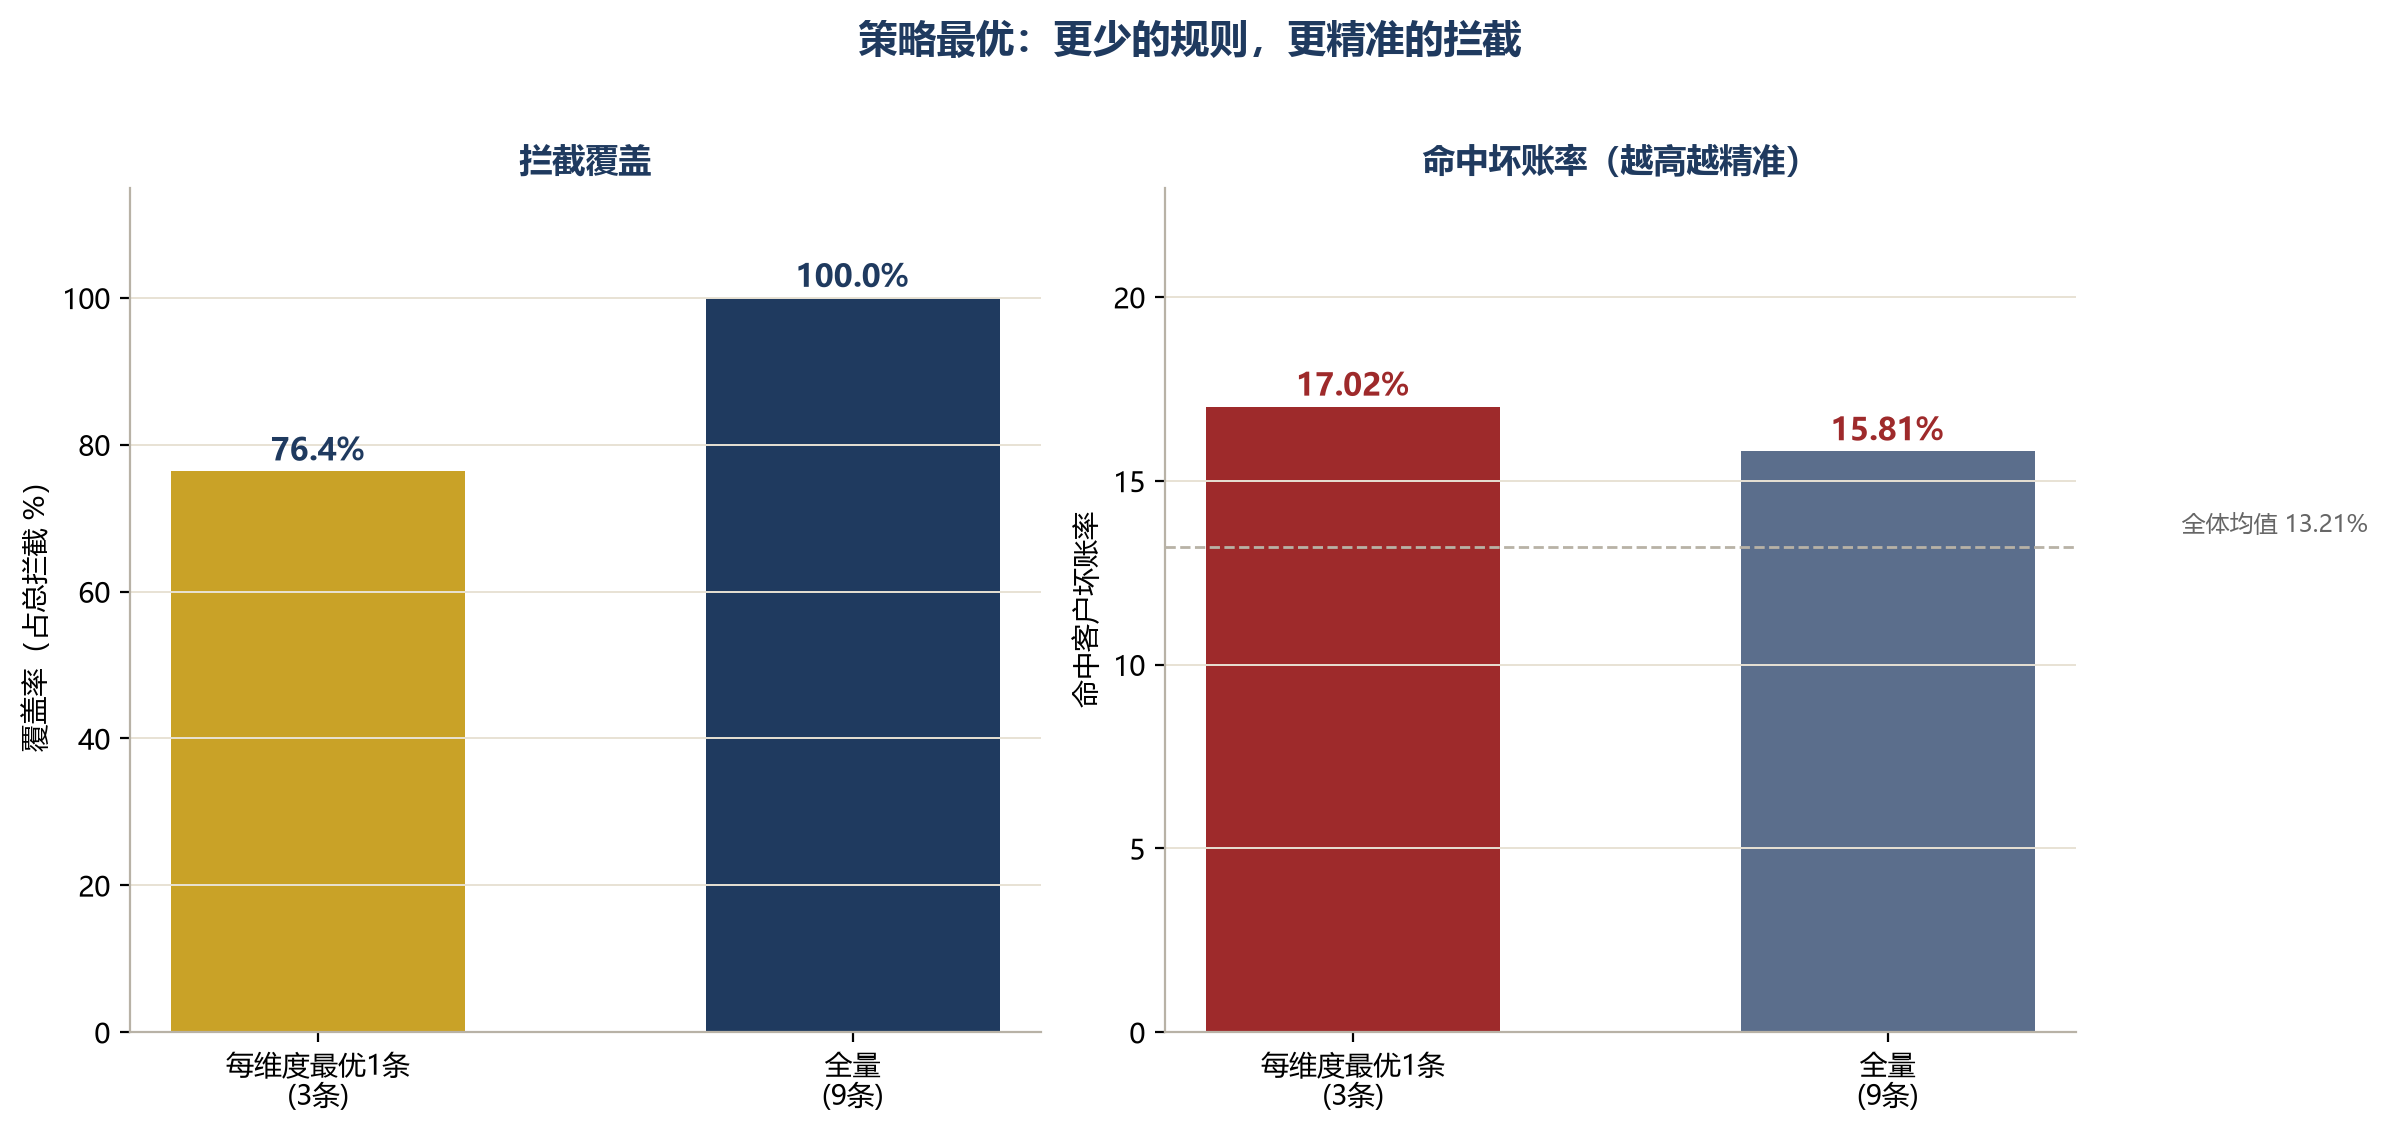
| 方案 | 覆盖人数 | 占总拦截 | 命中坏账率 | 拦截坏账笔数 |
|---|---|---|---|---|
| 每维度最优 1 条(3条) | 1,048,379 | 76.36% | 17.02% | 178,442 |
| 全量 9 条 | 1,372,887 | 100% | 15.81% | 217,002 |
反直觉的结论出现了:3 条规则比 9 条规则更精准。
覆盖率从 100% 降到 76%,但命中坏账率从 15.81% 升到 17.02%。为什么?3 条方案保留的是每个维度 Lift 最高的一条(A1 负债率 1.29x、B3 查询 1.44x、C1 信用分 1.35x),删掉的 6 条各有各的"弱":
- A2 月供收入比:与 A3 相关 0.987(几乎同一变量),独有命中仅占自身 9.7%——被同维度的 A1/A3 覆盖
- A3 贷款额收入比:与 A2 互为替身,A 维度留下 Lift 更高的 A1 就够
- B1 账户数>=19 / B2 总账户>=40:Lift 只有 1.06-1.07x,拦的人坏账率 14% 左右,接近整体均值 13.21%——质量型冗余
- C2 逾期 / C3 催收:覆盖增量小(贪心第 7、9 位,合计只补 3.2% 覆盖)——尾部补漏
删掉这 6 条后,剩下的拦截集中到了真风险人群,所以 3 条方案的命中坏账率反而更高。
代价是漏拦了 324,508 人(23.64%),其中坏账约 38,560 笔。所以策略最优不是一个点,是一条权衡曲线:
- 要全覆盖(监管/审慎要求)→ 9 条,接受 15.81% 的命中坏账率(更宽的网)
- 要精准(获客/利润导向)→ 3 条,接受 76% 的覆盖率(更准的枪)
- 折中(95% 覆盖)→ 6 条,坏账率落在中间
05 结论:怎么科学地给策略系统"减脂"
回到开头的问题。策略系统减冗余,正确流程是四步:
第一步:维度归并。 把规则按风险维度分组(负债/多头/信用),先问"这个维度真的需要多条规则吗"。相关性越高的代理变量,重叠概率越大——本文两对相关 >0.7 的变量(0.987、0.718)都出现了高 Jaccard 重叠(0.518、0.339),值得优先核查。
第二步:算独有命中。 逐条算
第三步:画覆盖率曲线 + 博弈曲线。 用贪心集合覆盖画出"覆盖率-规则数"曲线,按目标覆盖率反推最少规则数;再看叠加过程中的"通过率 vs 通过人群坏账率",确认每加一条规则的实际风险收益——这是策略最优的量化依据。
第四步:质量复核(Lift)。 算每条规则的 Lift(命中坏账率/整体坏账率)。Lift 接近 1 的规则(本文的 B1 账户数>=19 是 1.06x、B2 总账户>=40 是 1.07x,几乎不区分风险)是"数量不小但质量差"的典型,优先删除;同时注意漏拦的绝对笔数,监管场景下"漏"比"误"更致命。
关键区别(也是本文和#105的分工):
- #105 逻辑冗余:A⊆B,布尔代数证明,任何时候任何数据都成立
- 本文 统计冗余:命中集合高度重叠,只能在当前数据上验证,换数据要重跑
"统计冗余"的结论必须限定边界:在 LendingClub 这 2,257,038 笔样本上,3 个维度的 9 条代理变量规则,最优只需每个维度 1 条(3 条覆盖 76%,命中坏账率反而更高);通过率-风险博弈曲线显示前 3 条规则性价比最高,被删的 6 条分三类——同维度冗余(A2/A3)、低 Lift 质量冗余(B1/B2)、尾部补漏(C2/C3)。真实业务数据上,这个结论不一定成立——但方法成立:独有命中、Jaccard、Lift、贪心集合覆盖、目标覆盖率反推、通过率-风险博弈,这套流程跑一遍,你的系统里哪些规则是"同一把尺子的两种刻度",一目了然。
数据说明: LendingClub 2007-2018年公开贷款数据(226万笔),本地parquet读取,剔除缺失值后样本2,257,038笔。9条规则按负债率(dti)、月供收入比(installment/annual_inc/12)、贷款额收入比(loan_amnt/annual_inc)、账户数(open_acc)、总账户数(total_acc)、近6月查询(inq_last_6mths)、信用分(fico_range_low)、逾期(delinq_2yrs)、催收(collections_12_mths_ex_med)定义,仅作方法论演示,不代表任何真实机构的策略。坏账定义为loan_status属于Charged Off/Default/Late(31-120 days)/In Grace Period。Lift=命中坏账率/整体坏账率。独有命中、Jaccard、Lift、贪心覆盖、通过率-风险博弈均来自DuckDB实际查询与Python计算。
代码环境: Python 3.11,DuckDB,pandas,numpy,matplotlib;随机种子seed=42(本实验无随机性依赖)。