违约时间才是真信号——Cox 生存分析与竞争风险
本文为 AI 辅助创作,数据实测与结论推导由作者完成。
关键词:Cox 比例风险模型,生存分析,风险比 HR,竞争风险,Aalen-Johansen
风控部评审两个模型。模型 A:AUC 0.70,输出"这笔贷款会不会违约"。模型 B:同样 AUC 0.70,但它多回答一个问题——如果违约,大约什么时候?
从"会不会"到"什么时候",区别有多大?想象两笔都违约的贷款:一笔在发放后 3 个月违约(本金几乎没回收),一笔在 30 个月后违约(大部分已经还了)。前者损失可能接近本金,后者损失可能只有零头。只看会不会违约,这两笔是一样的;看什么时候违约,它们天差地别。
生存分析(Survival Analysis)就是回答"什么时候"的建模框架。上一篇用 Vintage 表看了违约怎么随账龄暴露(描述层),这篇进入模型层:Cox 比例风险模型告诉你什么特征在加速违约(风险比 HR),Aalen-Johansen 累计发生率函数告诉你竞争风险下真实的违约概率(提前还清会干扰估计)。
从"会不会"到"什么时候":为什么时点重要
违约损失不是"违约就全额损失"。一笔贷款的生命周期里,钱是逐月收回的。设违约发生在发放后
其中
Cox 比例风险模型:风险怎么随特征缩放
模型设定
设违约时间
是基线风险(所有特征取 0 时的风险,只随账龄变) 是特征乘数——特征每变化一单位,风险乘以
这就是"比例风险":任何两个客户的风险函数之比
偏似然:不需要基线风险也能估 β
Cox 的关键洞察:估计
其中
风险比 HR:不是概率,是乘数
:特征值越大,违约风险越高(加速违约) :特征值越大,违约风险越低(延缓违约) - HR 是乘法效应,不是加法——fico 每 +1 个标准差 HR=0.69,表示风险乘以 0.69(降 31%);两个标准差就是
实测:什么特征在加速违约
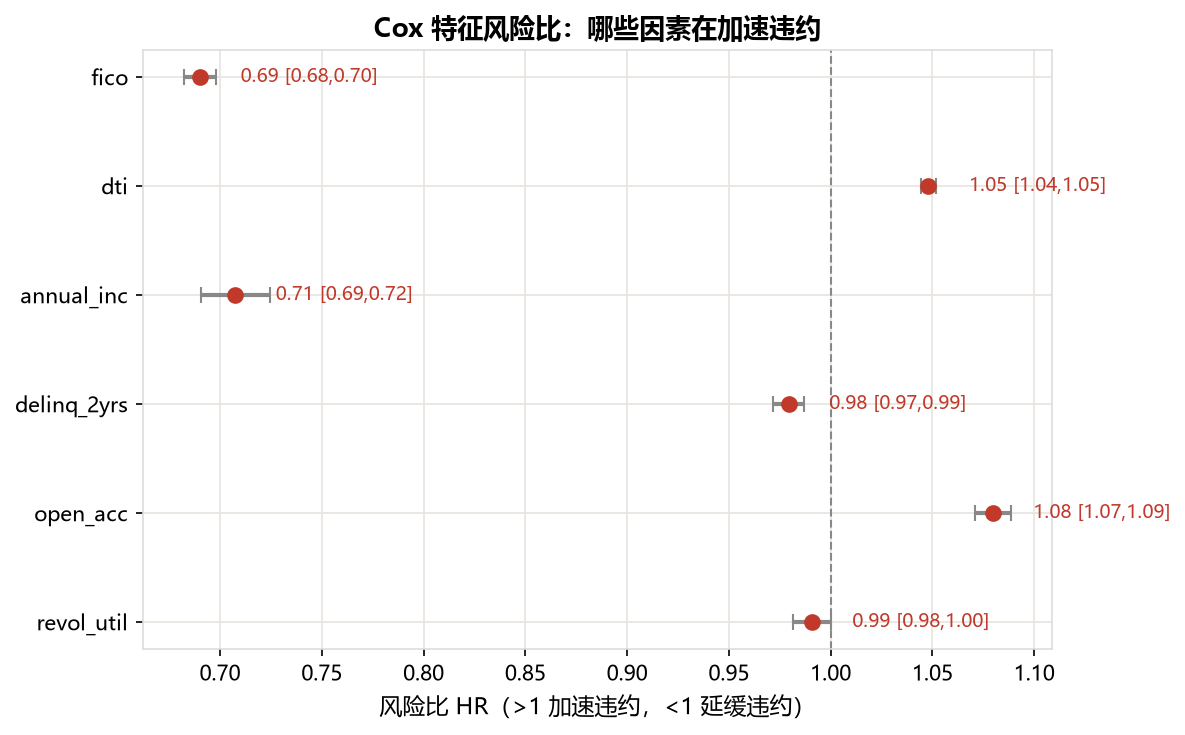
LendingClub 2,257,159 笔(违约 26.9 万,11.92%),特征标准化后 Cox 回归,HR=每 +1 标准差的风险比:
| 特征 | HR | 95% CI | 解读 |
|---|---|---|---|
| fico | 0.690 | [0.682, 0.698] | 信用分 +1SD → 违约风险降 31%(强保护) |
| annual_inc | 0.707 | [0.691, 0.725] | 收入 +1SD → 风险降 29% |
| open_acc | 1.080 | [1.071, 1.089] | 账户数 +1SD → 风险升 8%(多头借贷信号) |
| dti | 1.048 | [1.044, 1.052] | 负债率 +1SD → 风险升 5% |
| delinq_2yrs | 0.979 | [0.972, 0.987] | 逾期次数 +1SD → 风险略降(反直觉) |
| revol_util | 0.991 | [0.981, 1.000] | 循环利用率:条件效应接近中性 |
两个发现:
第一,fico 和收入是主导保护因素(HR 0.69/0.71),账户数和负债率是风险因素(HR 1.08/1.05)——和业务直觉一致,但 Cox 给出的是控制了其他特征后的净效应(偏效应),比单变量相关性可靠。
第二,delinq_2yrs 的 HR=0.979 是反直觉点:逾期次数越多,风险反而略降?这不是"逾期无害",而是边际效应 ≠ 条件效应(承接 #108 的核心结论)——条件于 fico、dti 等特征后,逾期次数携带的增量信息很小,甚至方向反转(高逾期客户往往同时被其他高风险特征标记,那些特征已经把风险解释了;delinq 剩下的边际信号里,可能有"逾期后修复"的客户群)。单变量看 delinq 一定推高风险,多变量偏效应可能翻转——这正是 Cox 相比"看相关性"的价值。
Cox 还能直接预测生存曲线(给定特征,逐月未违约概率):
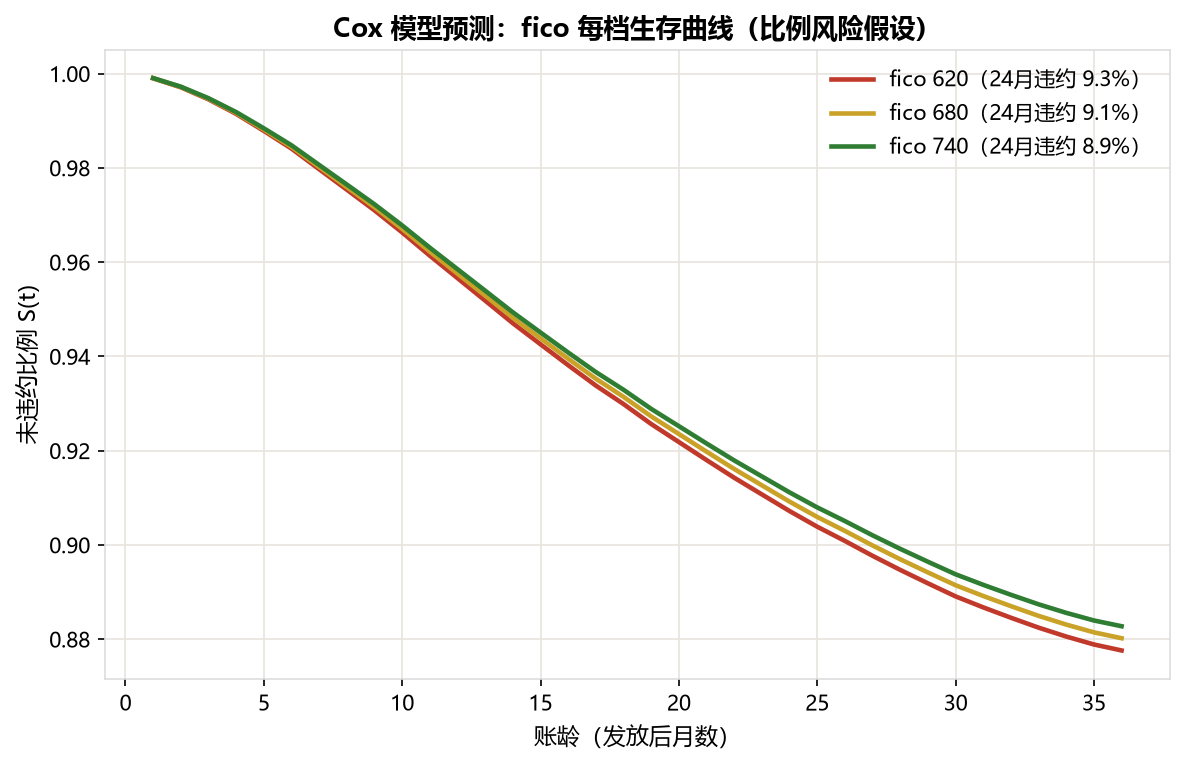
fico 620 的客户 24 个月未违约率约 82%,fico 740 约 94%——比例风险假设下,不同特征的曲线平行(log 尺度),形状相同、水平不同。
竞争风险:提前还清是竞争对手
生存分析有个隐蔽的坑:贷款只有两种结局——违约,或还清。还清(Fully Paid)不是"没违约",它是违约的竞争事件(competing risk):一笔贷款还清了,就永远不可能再违约。
上一篇的 KM 生存曲线把还清当删失(censoring)——意思是"还没观察到违约,可能未来违约"。这在"还清"上语义错了:还清意味着"确定不违约了",跟"未来可能违约"是两回事。把确定不违约的当"可能违约"处理,会高估违约率——KM 的乘积里,还清客户退出分母但不退出"未违约"的计数逻辑,导致生存率被低估、违约率被高估。
正确处理用累计发生率函数(Cumulative Incidence Function, CIF),Aalen-Johansen 估计:
其中
实现就是逐月递推:
python
def aalen_johansen(d, max_t=48):
    """CIF_j(t) = Σ_{s≤t} S(s-)·λ_j(s); 事件1=违约, 事件2=还清, 0=删失"""
    T_ev = d.loc[d["cause"] > 0, "T_c"].values
    T_cs = d.loc[d["cause"] == 0, "T_c"].values
    cif1 = np.zeros(max_t + 1); cif2 = np.zeros(max_t + 1)
    S = np.ones(max_t + 1)
    for t in range(1, max_t + 1):
        n_risk = (T_ev >= t).sum() + (T_cs >= t).sum()
        d1 = ((d["cause"] == 1) & (d["T_c"] >= t) & (d["T_c"] < t + 1)).sum()
        d2 = ((d["cause"] == 2) & (d["T_c"] >= t) & (d["T_c"] < t + 1)).sum()
        cif1[t] = cif1[t-1] + S[t-1] * d1 / n_risk
        cif2[t] = cif2[t-1] + S[t-1] * d2 / n_risk
        S[t] = 1 - cif1[t] - cif2[t]
    return cif1, cif2, S
实测:KM 高估了多少
LendingClub 全样本(违约 11.92%,还清 47.7%),对比 KM(还清当删失)和 CIF(还清当竞争事件):
| 账龄 | KM 违约率 | CIF 违约率 | KM 高估 |
|---|---|---|---|
| 24 月 | 12.4% | 11.9% | +0.5pp |
| 36 月 | 16.3% | 15.1% | +1.2pp |
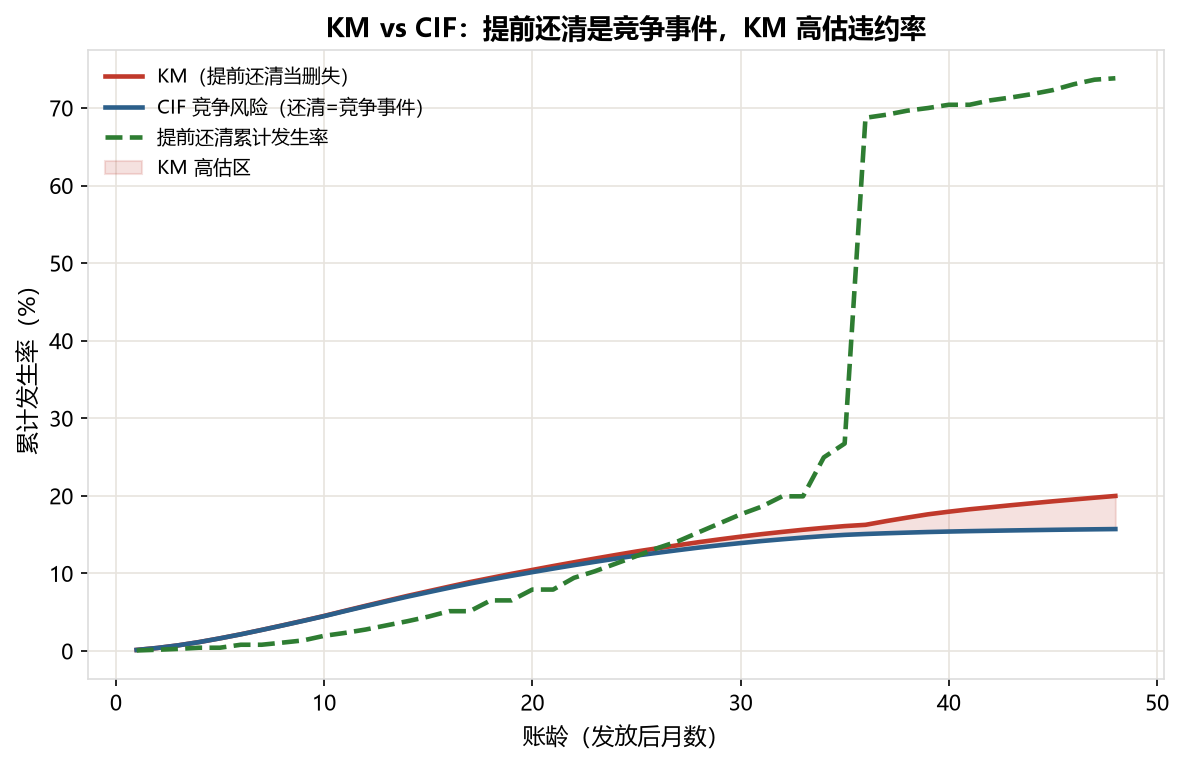
KM 高估随账龄扩大(36 月高估 1.2pp)——因为越往后,还清客户越多,被 KM 误当"删失"的竞争事件越多。1-2pp 看着不大,但用在拨备计提上就是实打实的钱:如果按 KM 的 16.3% 提拨备,而真实竞争风险违约率是 15.1%,每年多提的拨备对应着被高估的预期损失。
竞争风险全景图更直观——贷款结局随账龄的演化:
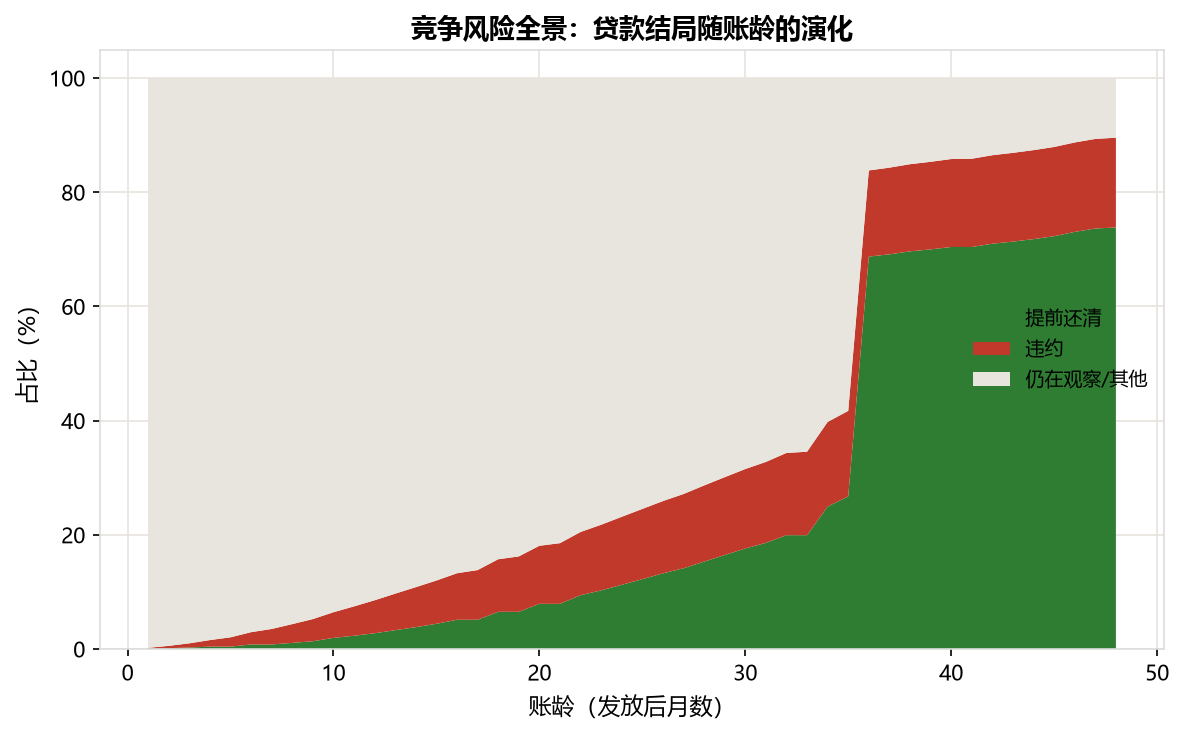
36 个月后,约 40% 的贷款已还清、15% 已违约、45% 仍在观察——提前还清是这个组合里最大的"竞争对手",忽略它,所有单结局分析都会系统性偏差。
结论:三层才是完整的违约风险图景
把 #110 和本篇串起来:
Vintage 表(描述层):违约怎么随账龄暴露,账龄对齐才能跨批比较; Cox 模型(模型层):什么特征在加速违约——fico/收入是保护因素(HR 0.69/0.71),账户数/负债率是风险因素(HR 1.08/1.05),条件效应会翻转直觉(delinq HR 0.98); 竞争风险 CIF(严谨层):提前还清是竞争事件,KM 把还清当删失会高估违约率(36 月高估 1.2pp),拨备计提应该用 CIF。
AUC 告诉你"会不会",Cox 告诉你"什么时候",CIF 告诉你"在竞争下的真实概率"——三层叠起来,才是完整的违约风险图景。风控模型评审的时候,别只看 AUC 了。
边界声明:以上数字在 LendingClub 2,257,159 笔样本(剔除缺失)上测得;违约时点用最后还款日近似(偏早约 4 个月);Cox 假设比例风险(特征效应不随时间变)与线性 log 风险,实际数据可能轻微违反;竞争风险分析中"还清"用 Fully Paid 近似(含到期还清与提前还清)。不同数据下具体数值会变,但"时点影响损失、特征有净效应、竞争风险会高估单结局估计"三个规律不变。
关键要点:违约时点决定损失(EL 的 LGD 依赖 T);Cox 用偏似然估 HR(fico 0.69/annual_inc 0.71 保护,open_acc 1.08/dti 1.05 风险);条件效应≠边际效应(delinq 翻转);竞争风险下 KM 高估违约率(36 月 +1.2pp),用 Aalen-Johansen CIF。
代码与数据:本文所有代码可复现,数据来自 LendingClub 公开数据集(2007-2018Q4)。完整脚本留档在文章同目录 gen_figures.py。