评分卡地形图——模型眼里的安全平原,现实里的危险山脊
评分卡模型评估最危险的地方,不在它拒绝的人里,而在它批准的人里。
策略会上常见的一幕:模型团队说"测试集 KS 0.24,模型没问题";业务团队说"这批客户坏账一半,模型肯定有问题"。两个都对——因为模型在某个网格上预测 31% 违约,而那批客户的实际坏账率是 50%。整体指标把局部失准平均掉了。
本文用 LendingClub 134.5 万笔真实贷款,建一个标准评分卡(WOE + 逻辑回归),然后换一种评估方式:把模型预测和真实违约率都画成 fico×dti 的"风险地形图"。四组交叉变量反复指向同一个结论——评分卡在"特征组合矛盾"的人群上系统性失灵,而这些恰恰是策略评估最容易漏掉的人。
关键词:风险策略评估,评分卡,PDP部分依赖,交叉变量,模型监控
01 策略评估的盲区:整体指标之下,藏着看不见的山脊
先看一组数据。LendingClub 2007-2018 年 134.5 万笔已完成周期的贷款(好样本 107.7 万、坏样本 26.9 万,整体坏账率 19.96%),按放款时间切分:前 80%(2007-06 至 2016-10,107.6 万笔)训练评分卡,后 20%(2016-10 至 2018-12,26.9 万笔)做测试。
测试集坏账率 21.77%,高于训练集的 19.51%——客群在恶化,这是模型上线后要面对的真实世界。
建一个标准评分卡:12 个变量(fico、dti、收入、金额、逾期次数、近期查询、循环使用率、账户数、期限、用途、房屋状态),WOE 等频分箱 + 逻辑回归。评估结果:
| 指标 | 训练集 | 测试集 |
|---|---|---|
| AUC | 0.6892 | 0.6682 |
| KS | 0.2705 | 0.2417 |
KS 0.24,在评分卡里算"能用"的水平。按常规流程,这个模型可以进策略评审了。
但 KS 只能告诉你"整体区分度还行",告诉不了你模型在哪个局部不可信。把测试集按 fico×dti 分成 30×30 的网格,数每个格子的实际坏账率,问题就暴露了:
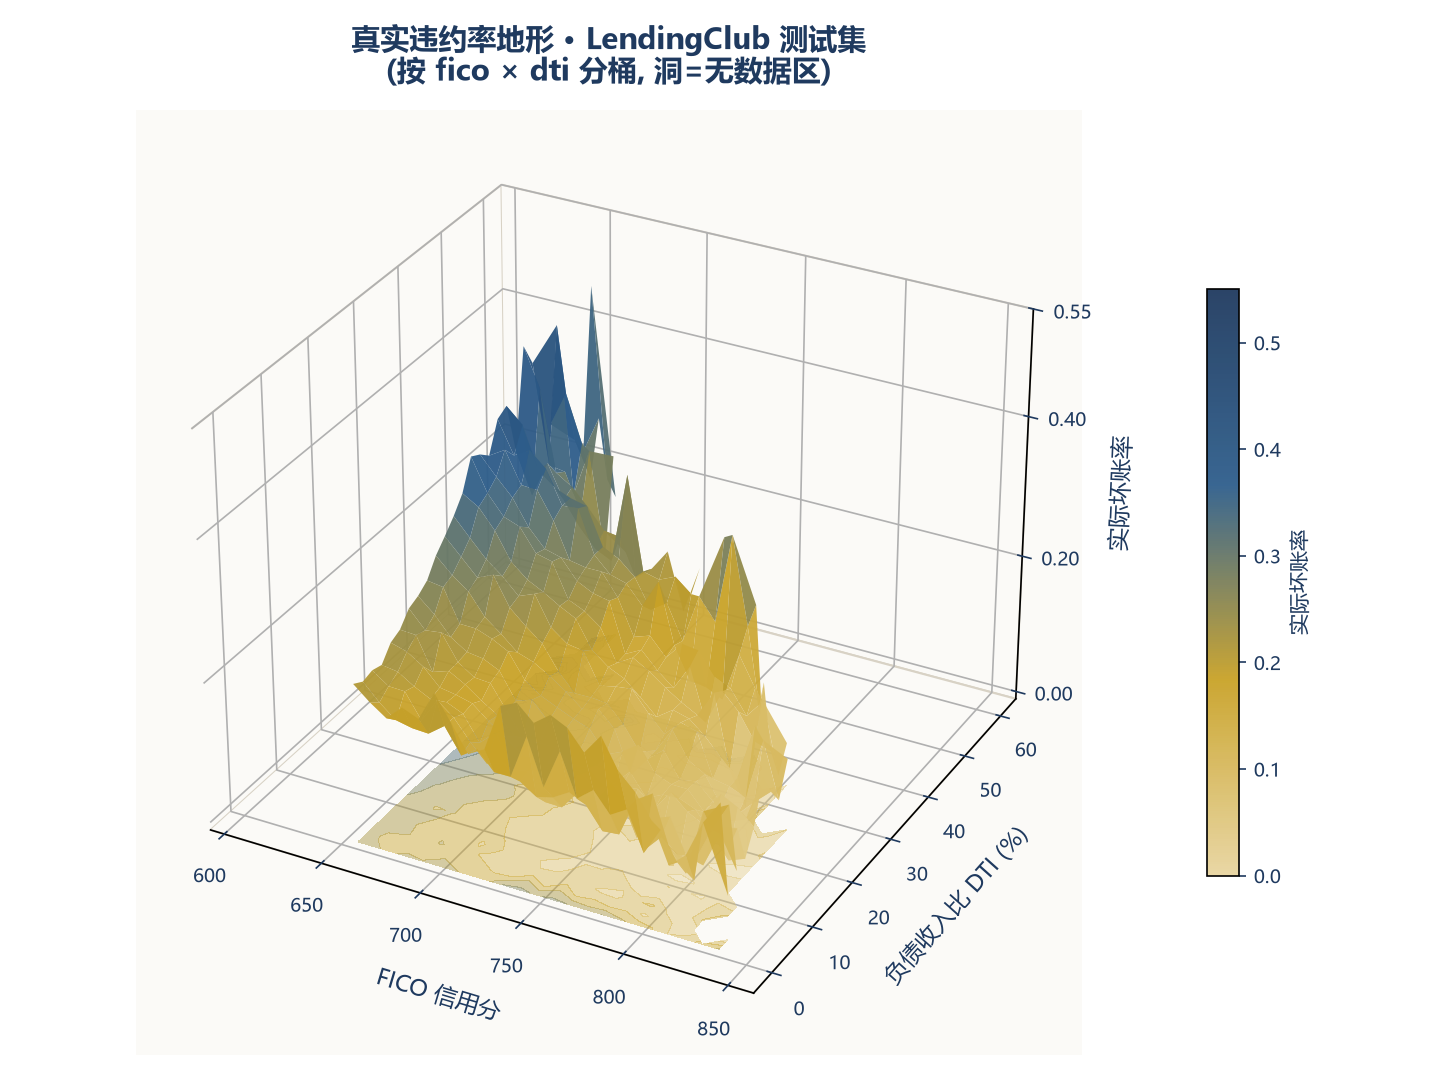
真实地形的最高点:fico=667、dti=52(中低信用分 + 高负债),实际坏账率 51.4%——超过一半的人违约。而这个位置的模型预测是多少?31.0%。模型把一半人违约的格子,评估成"中等风险"。
如果策略按模型分数一刀切 600 分,这一格 62 个客户全部放进来。 这就是整体指标掩盖局部失准的直接后果。
02 追问:模型在哪里说谎——把评分卡画成地形图
要回答"模型在哪里不可信",需要一个能看局部的工具。做法:把 fico 和 dti 当作地图的经纬度,把模型预测的违约概率当作海拔,画出"模型眼中的地形图";再把真实坏账率画成"现实的地形图"。两张图叠在一起,裂缝一目了然。
先看模型地形(WOE 评分卡 PDP,控制其他变量后的 fico×dti 净效应):
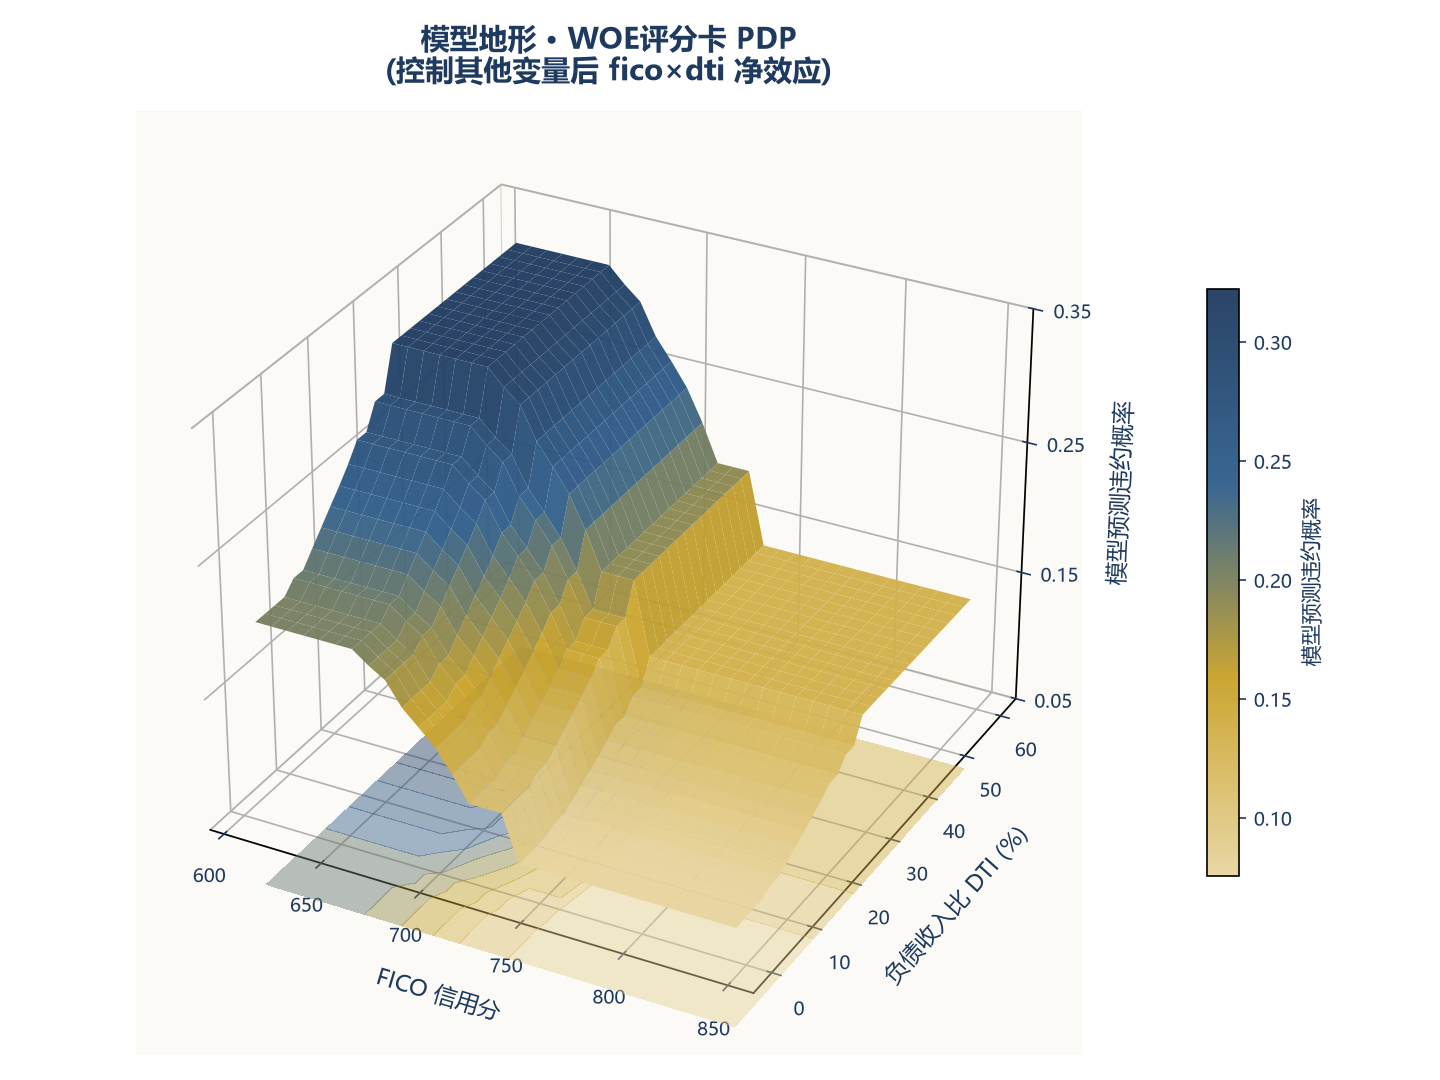
模型地形平滑、单调、符合直觉:fico 越高、dti 越低,风险越低。右下角的"安全平原"违约概率 7.6%,左上角"危险区"32.2%。这大概是模型开发者想要的完美地形。
再看差异地形(模型预测 − 实际坏账率,红色 = 模型低估风险):
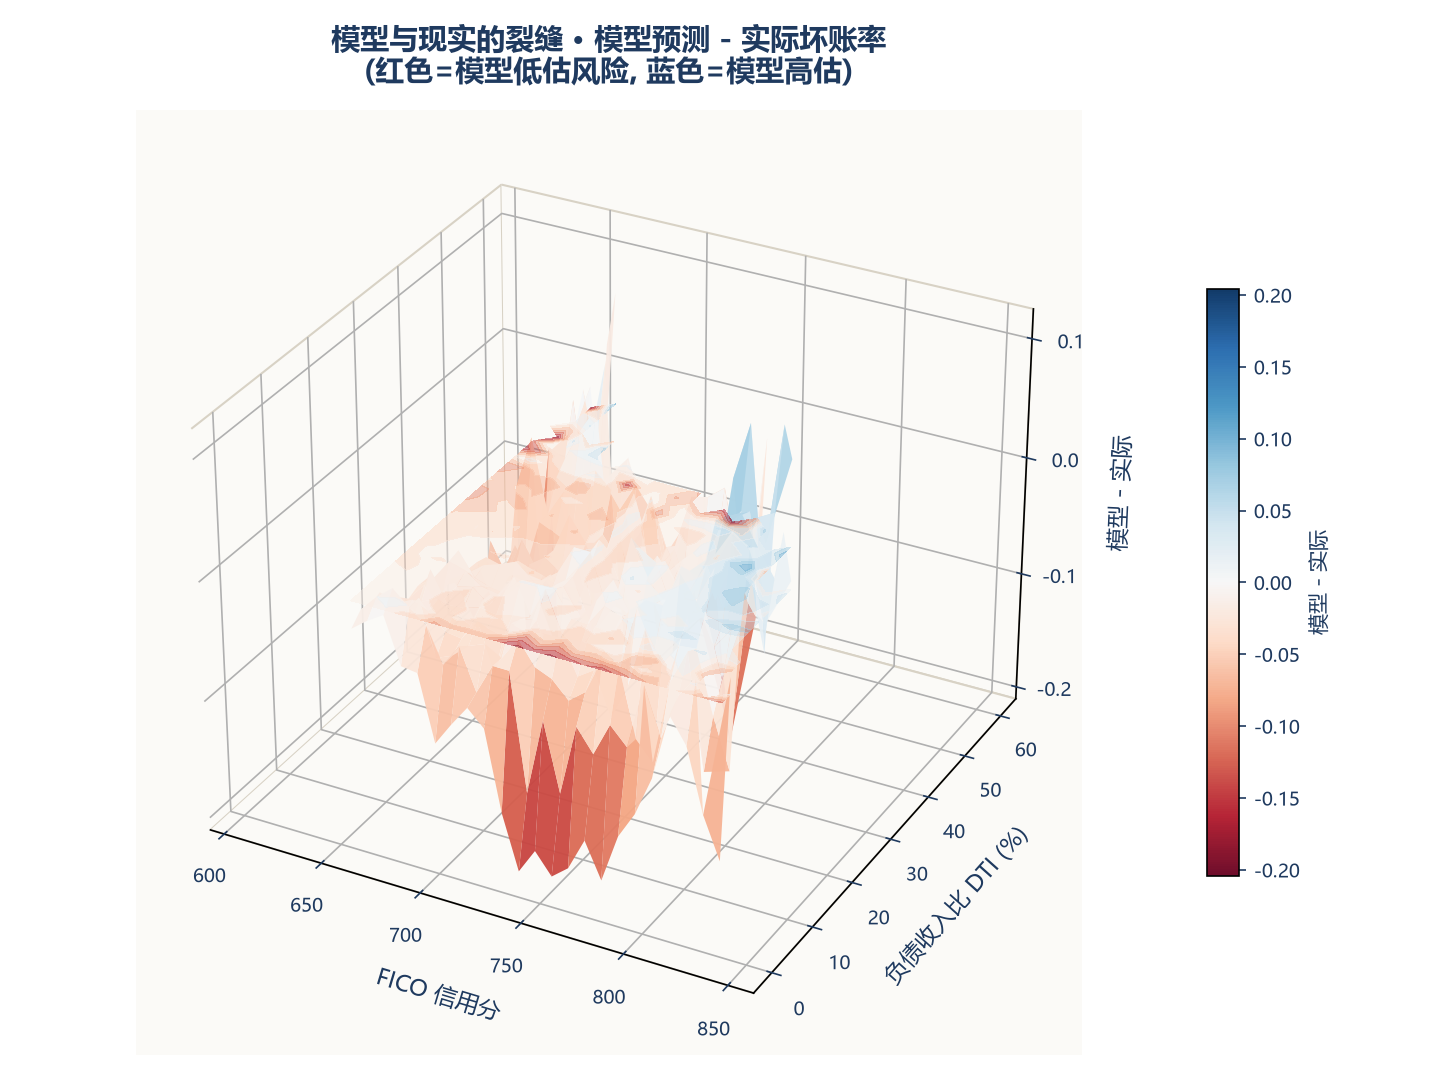
红色区域暴露了两条裂缝:
- 右下角:fico 650-680 × dti 40-55,模型低估约 19 个百分点——"低分+高负债"被模型评估为中等风险,实际是 50% 坏账。
- 左上角沿 dti=0 的一条边:fico 739-780 的高分段、零负债人群,模型预测 7.6%,实际坏账率 25%-26%——模型最信任的"高分+零负债",恰恰是它错得最离谱的地方。
03 方法:风险地形图怎么画
3.1 WOE 分箱与 IV
对每个连续变量做等频分箱,第
IV(信息价值)衡量变量区分能力:
IV 排序(训练集计算,防泄漏):term 0.206 > fico 0.121 > dti 0.077 > 收入 0.030 > 金额 0.028 > 近期查询 0.026。
python
import numpy as np
np.random.seed(42)

def woe_bin(x, y, nbins=10):
    """等频分箱 → WOE 映射 + IV (空箱平滑)"""
    q = np.unique(np.nanpercentile(x, np.linspace(0, 100, nbins + 1)))
    idx = np.digitize(x, q[1:-1])
    nb, ng = np.zeros(len(q)), np.zeros(len(q))
    for i in range(len(idx)):
        nb[idx[i]] += y[i]; ng[idx[i]] += 1 - y[i]
    tot_b, tot_g = nb.sum(), ng.sum()
    woe = {}
    for i in range(len(q) - 1):
        g = max(ng[i], 1e-9); b = max(nb[i], 1e-9)   # 分子分母同时平滑, 防空箱log(0)
        woe[i] = np.log((b / tot_b) / (g / tot_g))
    iv = sum((nb[i] / tot_b - ng[i] / tot_g) * woe[i] for i in range(len(q) - 1))
    return woe, iv
3.2 逻辑回归与评分卡分数
WOE 编码后的特征进入逻辑回归:
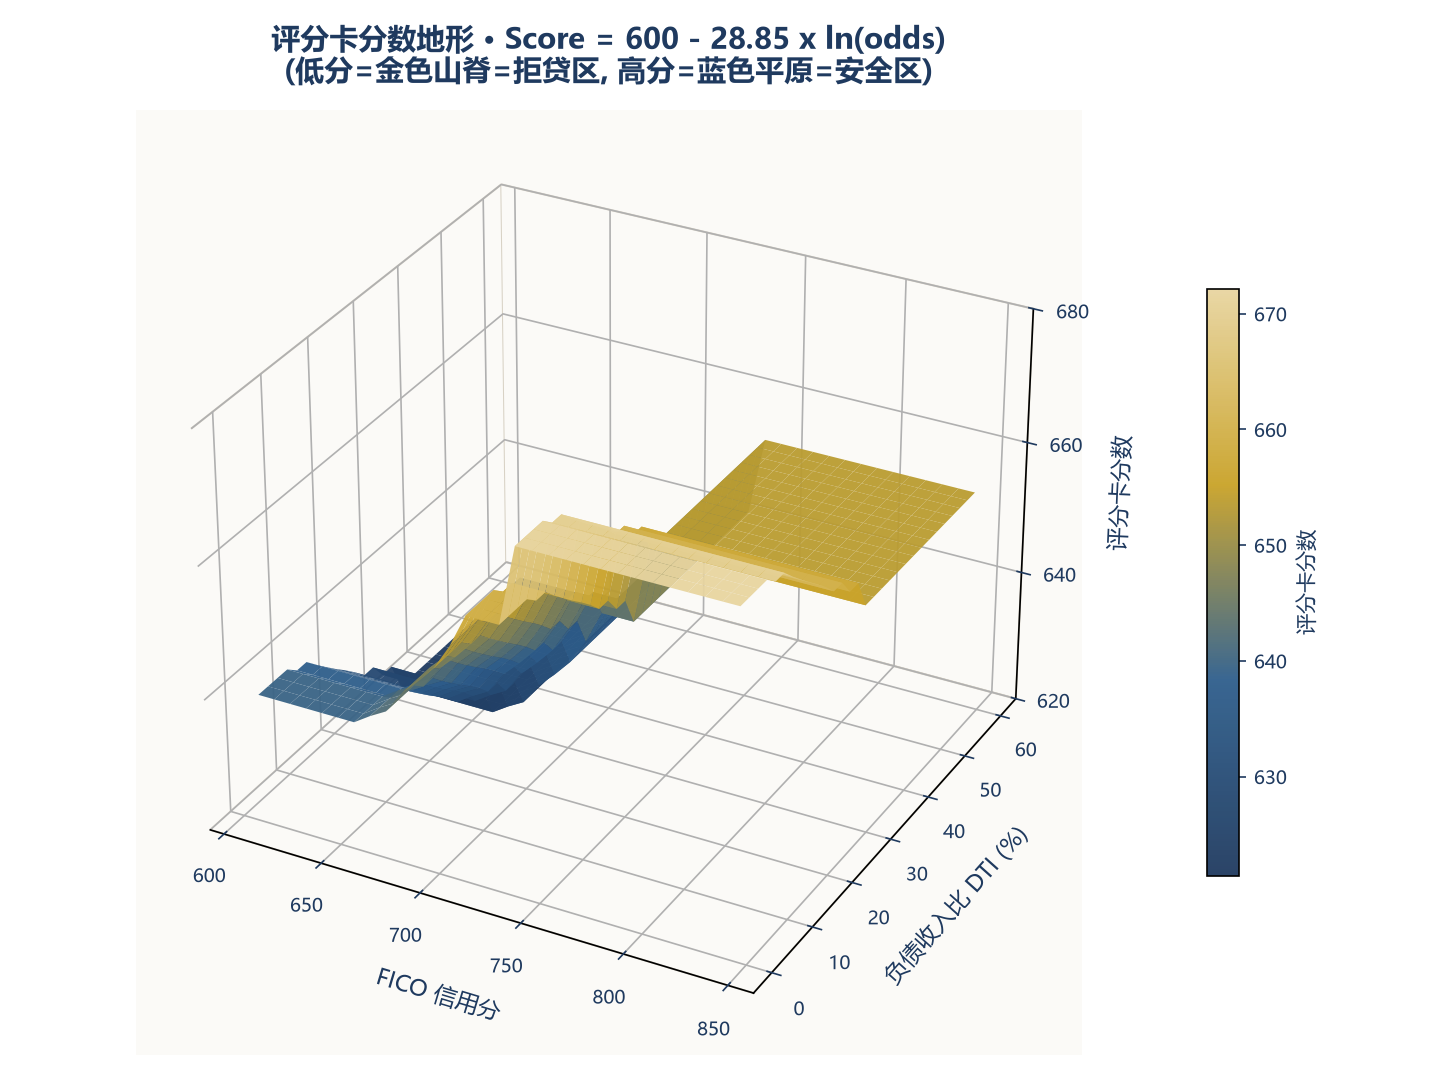
分数映射(基准 odds=1:1 对应 600 分,odds 每翻倍加 20 分):
即
3.3 PDP:把模型投影到二维平面
模型有 12 个变量,单独看 fico×dti 的作用用部分依赖(Partial Dependence):
对网格上每个点 (fico, dti),把所有测试样本的 fico、dti 改成该点的值,其他 10 个变量保持每个样本的真实值,取预测平均——这是控制住收入、逾期、查询次数等因素后的净联合效应。
python
np.random.seed(42)
# base: 抽样10万个测试样本的WOE矩阵(12列); i_fico/i_dti 为对应列号
# woe_map: 训练集算好的 {箱号: WOE}; grid_a/grid_b: fico/dti 网格坐标
for a in range(N_G):
    for b in range(N_G):
        M = base.copy()
        M[:, i_fico] = woe_map[grid_a[a]]  # 强制替换 fico 的 WOE
        M[:, i_dti]  = woe_map[grid_b[b]]  # 强制替换 dti 的 WOE
        Z[a, b] = clf.predict_proba(M)[:, 1].mean()  # 其余变量保持真实值,取平均
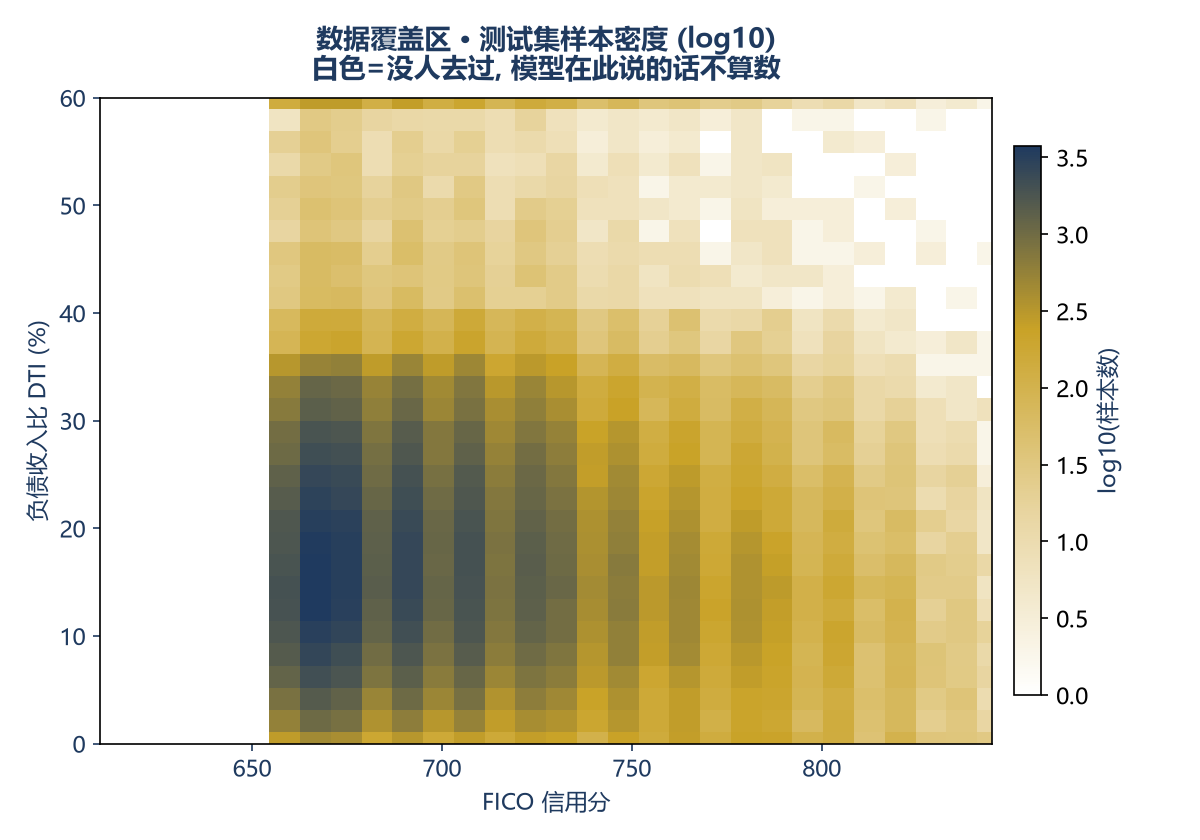
真实地形则是把测试集按同样网格分桶、直接数坏账率(桶内样本 <30 视为无数据,留白——模型在数据空白区说的话不算数)。数据覆盖区长这样:
04 拆解:四组交叉变量,四条裂缝
只画 fico×dti 一组可能是个例。把同样的方法用到另外三组交叉变量上,裂缝是系统性的。
4.1 裂缝一:fico×dti——"零负债陷阱"
fico≥700 且 dti=0(零负债)的人群:样本 264 笔,实际坏账率 26.9%,模型平均预测 9.6%,低估 17.3 个百分点。对照组(fico≥700 且 0<dti≤10,样本 25,183)坏账率 14.1%。95% 置信区间(21.6%~32.3% vs 13.7%~14.5%)完全不重叠。
dti=0 人群画像反常:中位收入 $48,000 却配 FICO 740(征信逻辑里高信用分几乎必然伴随负债史),借款用途 "other" 占 23.9%(全样本债务合并占 55.6%)。"高 FICO + 零负债"在 P2P 客群里,更可能是资料包装或征信信息不足的信号(机制推断:公开数据能证实坏账率与画像统计,无法证实个体动机)。
策略含义:命中"高分+零负债"组合 → 触发收入负债交叉验证 → 异常人工复核。这条规则可以直接落地。
4.2 裂缝二:fico×revol_util——"刷爆信用卡的高分人群"
fico≥700 且循环账户使用率 >80%(信用卡接近刷爆):样本 5,451,坏账率 21.3%;使用率 30-50% 的对照组 16.8%。模型在 fico 715×使用率 90% 处预测 13.6%、实际 28.0%,低估 14.4pp。
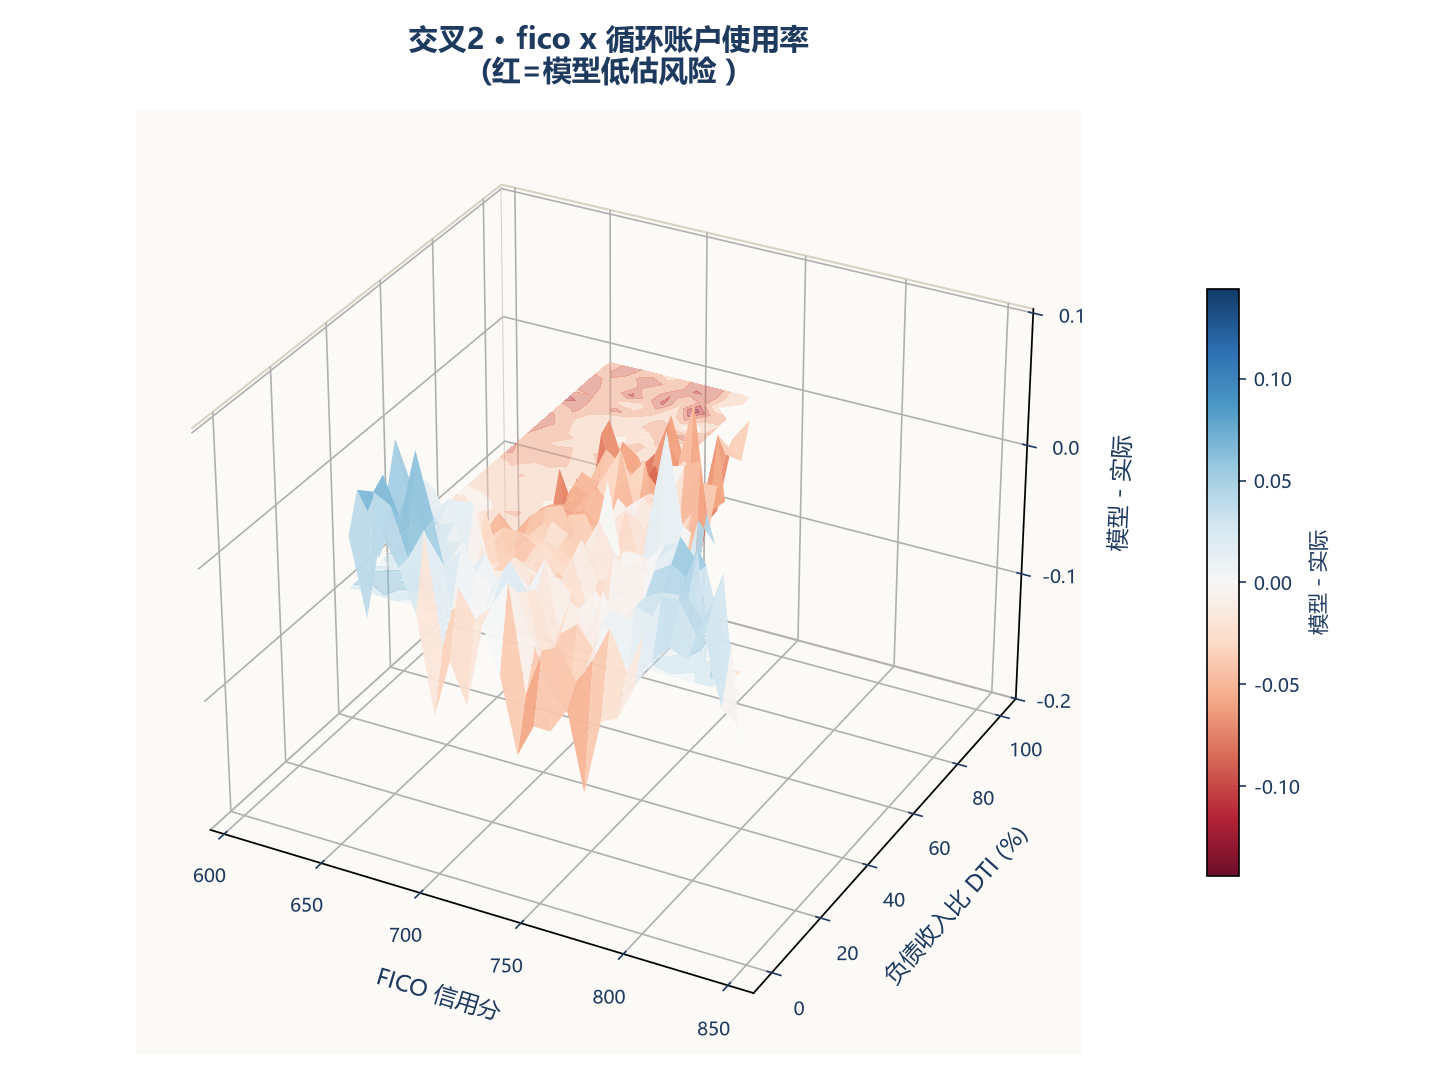
策略含义:高分客户不能只看 fico——使用率 >80% 是资金链紧张的强信号。额度审批时,高分+高使用率应下调额度上限。
4.3 裂缝三:fico×annual_inc——"收入与征信错配"
fico 740 × 年收入 $8,621:模型预测 12.1%、实际 37.1%,低估 25.0pp(样本 62)。fico 675 × 收入 $8,621 的格子实际坏账率 42.8%(样本 304)。整条低收入边界都是模型低估区——高信用分配申报收入极低,在真实世界里是高风险组合,在模型里是"信用好"。
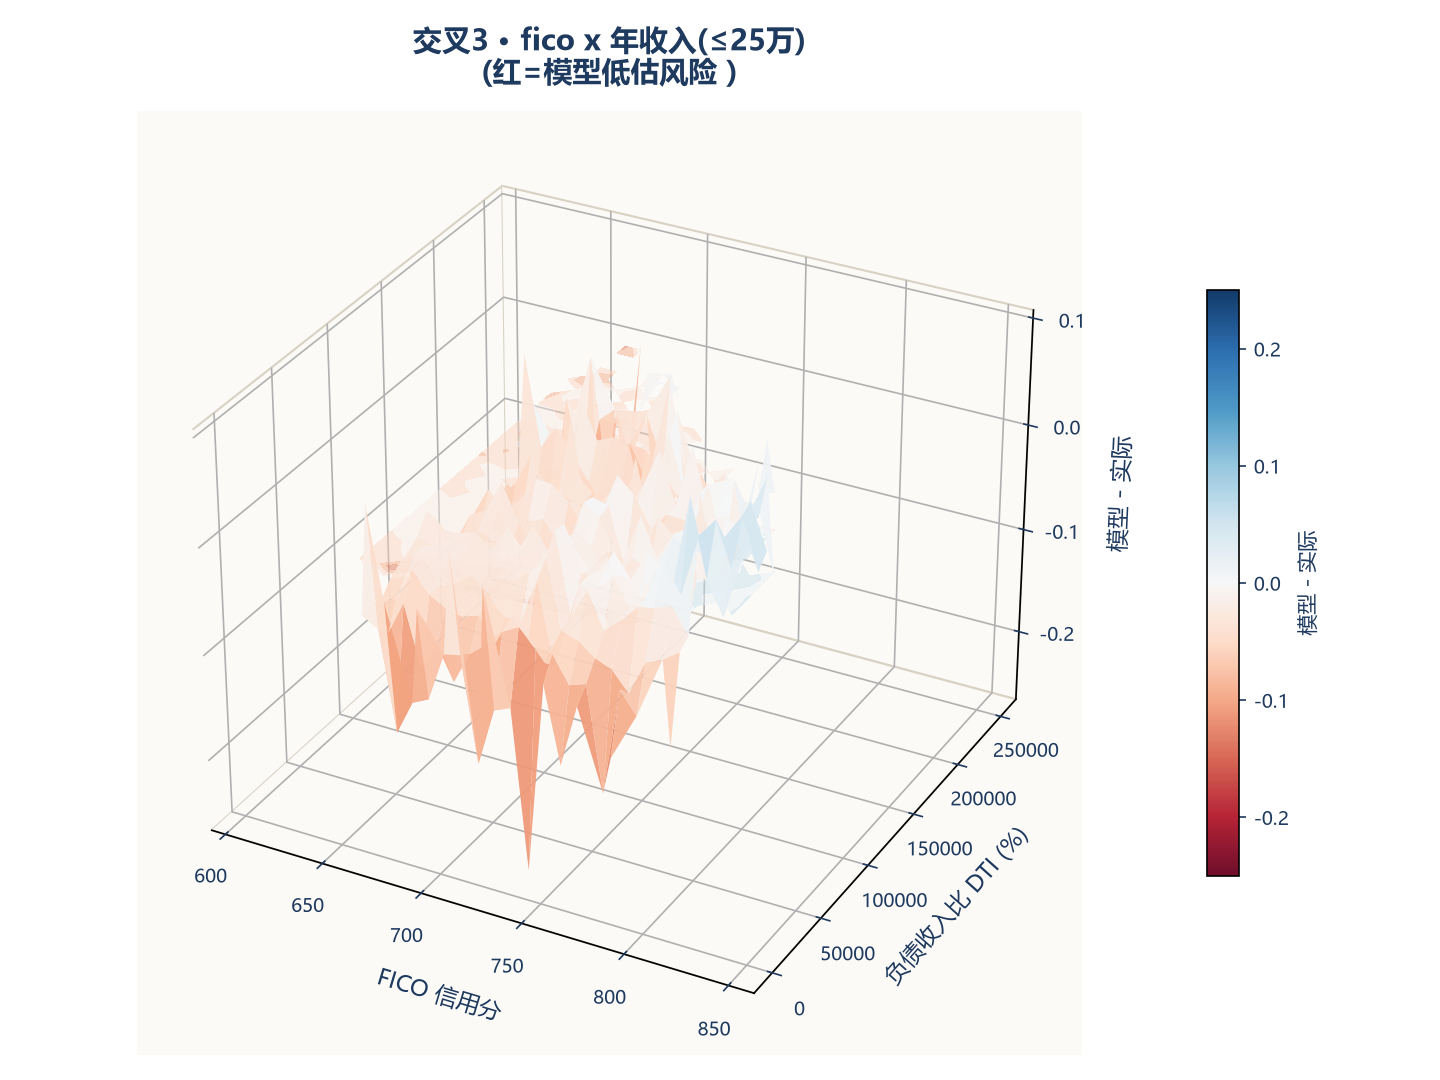
策略含义:收入与信用分严重错配(分位差过大)→ 收入核验/要求流水,不能信申报值。
4.4 裂缝四:dti×revol_util——"双重资金压力"
dti 35 × 使用率 90%:模型预测 23.2%、实际 47.2%,低估 24.0pp(样本 89);dti 29 × 使用率 79% 低估 18.3pp(样本 396)。中高负债 + 高使用率同时出现,是流动性枯竭的组合,模型把它评估成"中等偏上"。
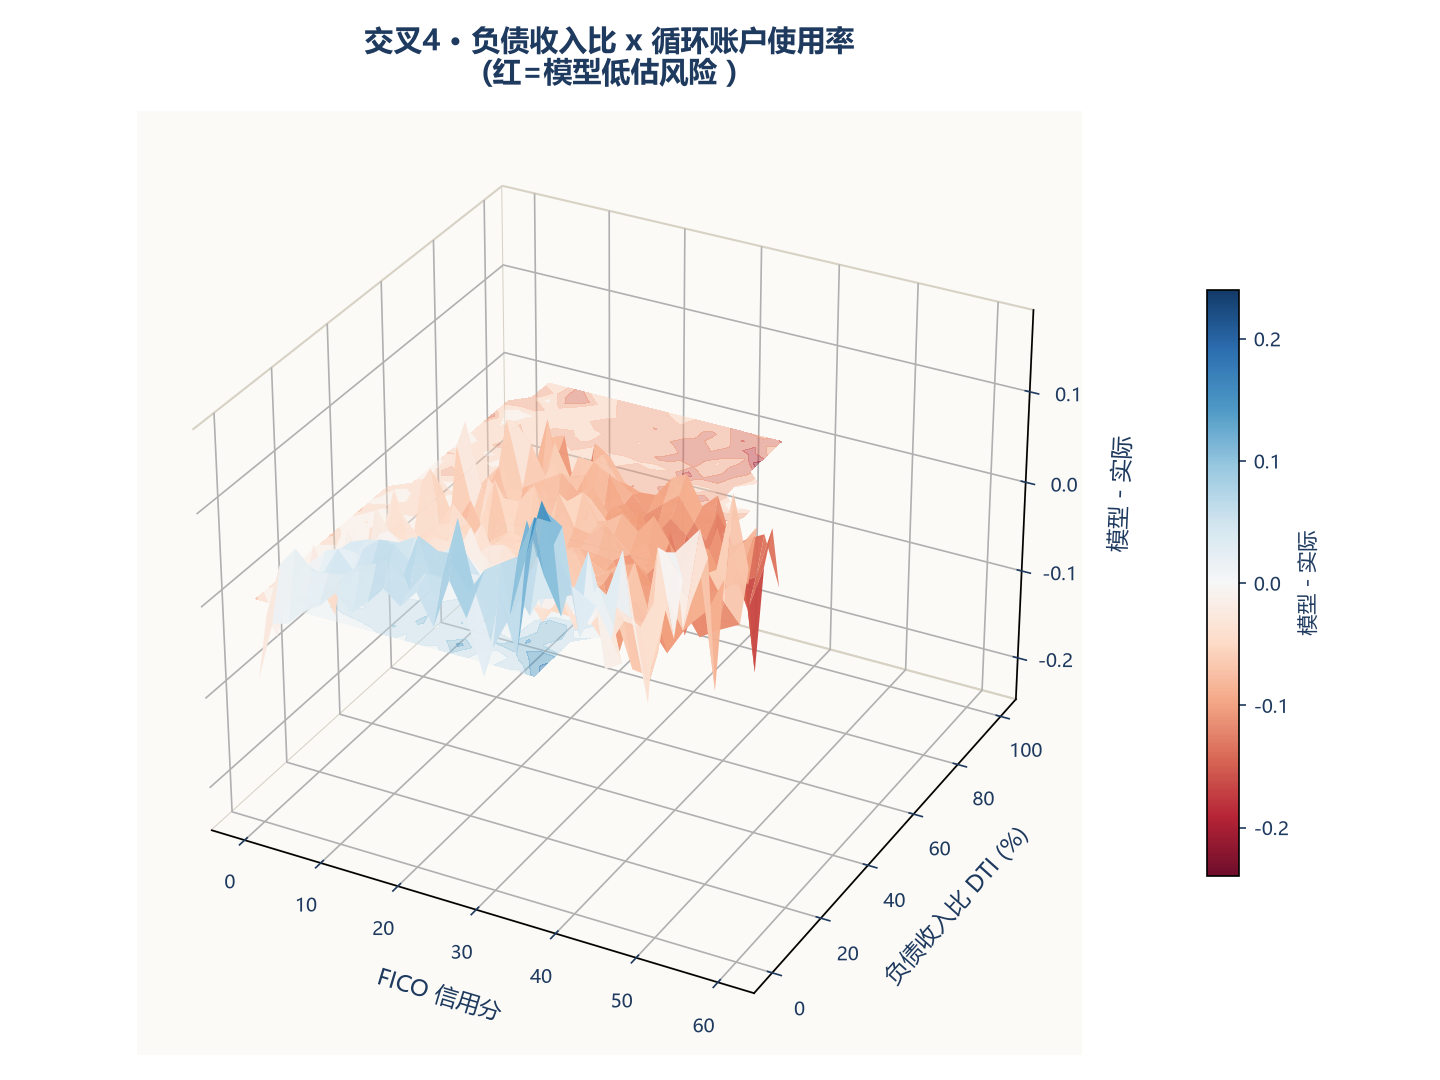
策略含义:dti 与使用率双高 → 直接触发人工审批/拒贷,不依赖模型分数。
4.5 四条裂缝的共同规律
| 交叉变量 | 矛盾组合 | 模型预测 | 实际坏账 | 低估 |
|---|---|---|---|---|
| fico×dti | 高分+零负债 | 9.6% | 26.9% | 17.3pp |
| fico×revol_util | 高分+刷爆 | 13.6% | 28.0% | 14.4pp |
| fico×annual_inc | 高分+低收入 | 12.1% | 37.1% | 25.0pp |
| dti×revol_util | 中负债+高使用率 | 23.2% | 47.2% | 24.0pp |
四条裂缝指向同一件事:评分卡是线性模型,没有交互项,天然看不见"特征组合矛盾"。单个变量看都合理(fico 高=好、dti 低=好),组合起来却可能是包装信号。这是整体指标(AUC/KS)永远发现不了、地形图一眼就能看到的盲区。
05 策略评估怎么用:从地形图到策略动作
地形图不是展示工具,是策略评估的工作台。五个具体用法:
① 分群差异化阈值。 模型预测 15% 违约率的等高线不是直线——fico 低区 dti 拉到 60 才到 15%,fico 高区 dti 30 就到了。同一个分数在不同区域含义不同。策略上按地块分群设阈值:蓝色平原区(fico 高+dti 低)降阈值放量,金色山脊区(fico 低+dti 高)加严。
② 定价与额度矩阵。 地形图高度直接映射风险定价:平原区低利率抢客,山脊区加价或拒贷。等高线最密的地方=风险随变量变化最陡,利率/额度微调在这些格影响最大。fico×dti 每格一个额度系数,用真实坏账率校准,比一维额度表精细。
③ 模型监控:重画地形图对比漂移。 上线后定期重画真实地形,与上线时对比。整体 KS 掉了你不知道掉在哪,地形图直接告诉你"哪块地长出了新山脊"。本文测试期坏账率 21.77% vs 训练 19.51%,PSI 只会说整体漂了,地形图会说漂在 fico 低区+高 dti 区。
④ 裂缝直接转规则。 四组裂缝已经给出四条可落地规则(见 04 节):高分+零负债交叉验证、高分+高使用率降额、收入错配核验、负债+使用率双高人工审批。地形图发现异常区域 → 归因 → 转规则,这是完整的落地流程。
⑤ 拒绝推断与人工复核布防。 红色失准区(模型低估)是拒绝推断的重灾区——按模型分数拒绝的客户里,若模型在该区系统性失真,隐藏着被错杀或漏放的人。红色区 = 人工复核优先布防区。
损失测算(说服力的最后一击):fico≥700 & dti=0 人群 264 人,实际坏账 26.9% vs 模型预期 9.6%,多出约 46 笔坏账,按平均贷款 $12,603 粗算 ≈ $58 万美元损失——而这个人群只占测试集的 0.13%。fico≥700 & 使用率>80% 的 5,451 人,坏账率差 4.5pp,多出约 245 笔,粗算 ≈ $310 万。口径说明:忽略回收率,粗算上限,实际损失取决于核销时点与回收。
评分卡整体"能用"和局部"可信",是两件事。地形图让第二件事变得可评估、可行动。
06 结论:模型评估的下一个动作
回到开头:KS 0.24 的模型能不能进策略?能,但前提是你知道它在哪四个区域说谎。本文的答案不是"别用评分卡",而是:整体指标 + 交叉地形图,缺一不可——前者回答"模型行不行",后者回答"模型哪里不行,策略怎么补"。
给模型团队和策略团队各留一句话:
- 模型团队:把 PDP 地形图加进模型评估报告,和 AUC/KS 一起交。
- 策略团队:红色失准区就是你的规则清单——每条裂缝都值得一条人工复核规则。
数据说明: LendingClub 官方公开数据集 accepted_2007_to_2018Q4(226 万笔原始申请,本文筛选已完结周期贷款 134.5 万笔)。坏样本口径:Charged Off + Default;好样本:Fully Paid;未终结状态剔除。训练/测试按放款时间 80/20 切分(2007-06~2016-10 / 2016-10~2018-12),WOE 分箱参数仅在训练集计算。模型:12 变量 WOE + 逻辑回归(L2,C=1.0),测试集 AUC 0.6682 / KS 0.2417。地形图网格 30×30,真实分桶剔除越界值(dti<0/>60、revol_util>100、收入>25万)且桶内样本 <30 视为无数据。dti=0 高分段人群 264 笔,95% 置信区间 21.6%~32.3%;对照组 25,183 笔,13.7%~14.5%,不重叠。损失测算是粗算上限(平均贷款额×多出坏账笔数,忽略回收)。
代码环境: Python 3.12.3 · numpy 2.5.1 · scikit-learn 1.9.0 · duckdb 1.5.5 · matplotlib 3.11.0
© QianStat_data 2026 · 数据来自 LendingClub 公开数据集