评分卡单调性——WOE 排序与回归系数,谁在说谎
本文为 AI 辅助创作,数据实测与结论推导由作者完成。
关键词:评分卡,单调性,WOE,逻辑回归,共线性,SymPy
一张评分卡上线前,模型团队做了个例行检查:每个特征的风险方向对不对。结果查出两件怪事。
第一件:负债率 dti 的 WOE 曲线在尾部拐了个弯——dti 从 10 升到 40,风险一路升高(这符合直觉),但 dti 超过 60 之后,风险反而骤降。负债率越高的客户越安全?这说不通。
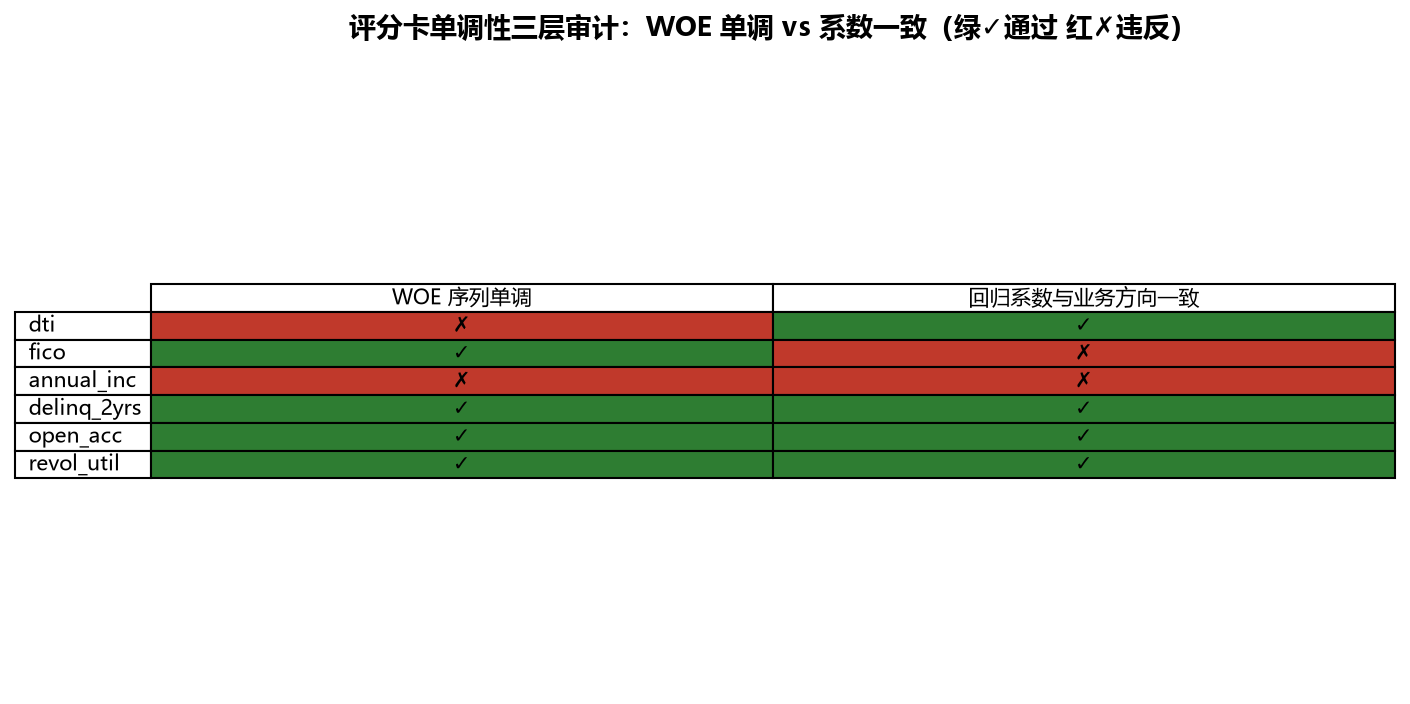
第二件:信用分 fico 的 WOE 单调递增(分越高越安全,符合常识),但放进多变量逻辑回归后,fico 的系数竟然是负的——模型说"fico 越高,违约概率越大",跟单变量完全相反。
单变量都正常,多变量全翻车。问题出在哪?
这篇把评分卡单调性拆成三层审计:WOE 序列排序、回归系数符号、符号计算验证。你会发现:单调性不是业务拍脑袋的要求,它是 logit 函数结构里写死的性质;而真实数据里的违反,分箱层和模型层各有一类。
评分卡凭什么必须单调?
先说业务直觉。评分卡的每个特征分箱都对应一个分数贡献,最终分数决定放不放款。如果某个特征不单调——比如 dti 30-40 段比 20-30 段"更安全"——会发生什么?
分数套利。借款人只要把负债率从 35 申报成 45,分数反而更高,贷款更容易批。风险信号被系统性绕开,评分卡就成了摆设。
可解释性崩溃。审批被拒的客户问"为什么",你没法解释"因为你负债率太高——哦不对,是你负债率不够高"。
监管与公平。评分卡是强监管模型,特征方向必须符合业务逻辑,反向特征是合规风险。
所以单调性是刚需。但有意思的是:对逻辑回归评分卡来说,单调性不是我们"加"进去的约束,它是模型结构里天然存在的性质——前提是特征进入模型的方式和方向正确。这就引出了数学结构。
单调性藏在 logit 的结构里
评分卡的数学骨架是逻辑回归。违约概率与特征的关系:
做 logit 变换,右侧变成线性:
评分卡把 logit 仿射变换成"分数"(FICO 那套 A - B·logit 的玩法):
关键在这一步。对 x 求导:
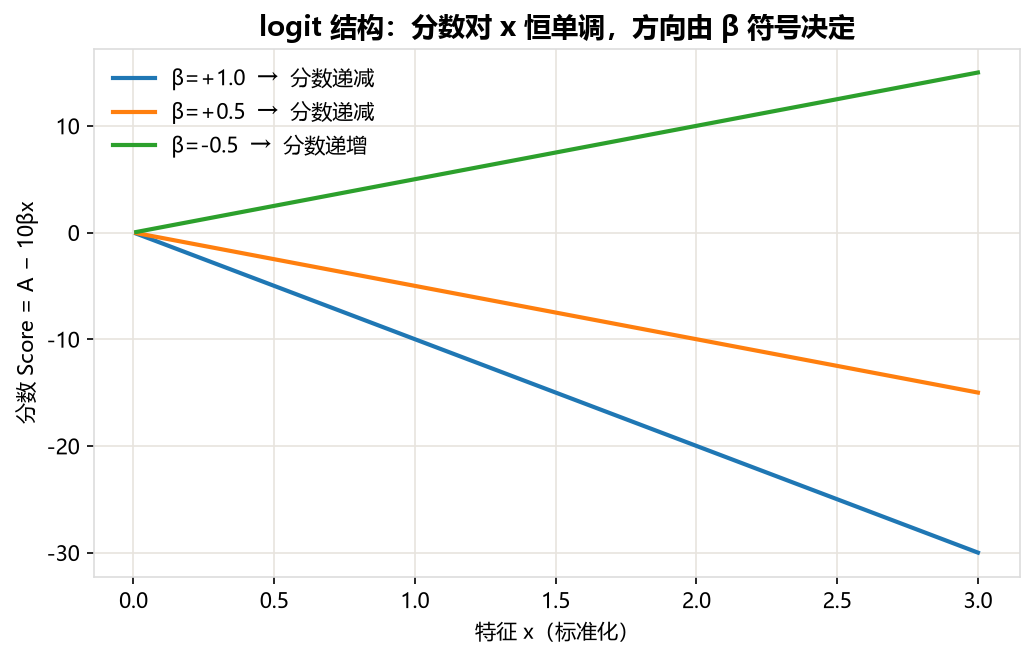
导数是常数。这意味着:只要 β ≠ 0,分数对 x 就是严格单调的——单调方向完全由 β 的符号决定,与 x 的取值无关。这是 logit 结构写死的性质,不需要任何额外约束。
用 SymPy 可以把这个证明写下来(代码可运行):
python
import sympy as sp

x = sp.symbols("x", positive=True)
b = sp.symbols("beta", real=True)

# 分数 = A - B·logit, 截距 A 不影响单调性, 取 B=10
logit  = b * x
score  = -sp.Rational(10) * logit
dscore = sp.diff(score, x)

print(sp.simplify(dscore))     # -10*beta
print(sp.simplify(dscore) == -10 * b)   # True
输出:
-10*beta
True但这里有个隐藏前提:公式里 x 是"特征进模型的方式"。真实评分卡里,特征不是原始值直接进模型,而是先分箱、再换成 WOE。这一步把连续变量变成了分段常数函数——单调性就从"整体导数恒号"变成了"相邻分箱的分数贡献必须同向"。
WOE 分箱:单调性变成了排序问题
分箱后,每个特征有 k 个分箱,第 i 箱的 WOE(Weight of Evidence,证据权重)定义为:
其中
WOE 替换后,逻辑回归变成对 WOE 特征回归,每个分箱的分数贡献是:
相邻分箱的分数差:
于是单调性的数学判据浮出水面:
对"越高越危险"的特征(如 dti、逾期次数),要求 WOE 严格递减(
)且 ;对"越高越安全"的特征(如 fico、收入),要求 WOE 严格递增且 。
两个条件缺一不可:β 的符号决定整体方向,WOE 的排序决定分箱间的一致性。这就是"三层审计"的由来。
三层审计:方法 + 可运行代码
第一层:WOE 序列单调性(数据侧)
对每个特征的分箱,检查相邻 WOE 差是否全部同号:
python
import numpy as np
import pandas as pd

def check_woe_monotonic(woe: np.ndarray, direction: str) -> list:
    """direction='down' 越高越危险(WOE递减); 'up' 越高越安全(WOE递增)
    返回违反单调的相邻分箱索引"""
    diffs = np.diff(woe)
    viol = []
    for i, d in enumerate(diffs):
        ok = (d <= 0) if direction == "down" else (d >= 0)
        if not ok:
            viol.append(i)
    return viol

# dti 实测 WOE(8箱, 业务方向 down)
dti_woe = np.array([0.311, 0.179, 0.031, -0.114, -0.244, -0.357, 0.397, 0.752])
print(check_woe_monotonic(dti_woe, "down"))   # [5, 6] —— 尾部两处反转
输出:
[5, 6]第二层:回归系数符号(模型侧)
WOE 替换后拟合逻辑回归,检查系数符号与业务方向一致:
python
from sklearn.linear_model import LogisticRegression

# X 是 WOE 替换后的特征矩阵(6列), y 是坏账标签
lr = LogisticRegression(penalty=None, max_iter=2000)   # WOE 已是标准化尺度, 去 L2 正则
lr.fit(X, y)
coef = dict(zip(features, lr.coef_[0]))

business_dir = {"dti": "down", "fico": "up", "annual_inc": "up",
                "delinq_2yrs": "down", "open_acc": "down", "revol_util": "down"}
for c, b in coef.items():
    ok = (b > 0) if business_dir[c] == "up" else (b < 0)
    print(f"{c:12s} 系数 {b:+.4f}  方向一致={ok}")
实测输出(LendingClub 2,257,017 笔,坏账率 11.92%,AUC 0.631):
dti          系数 -0.7279  方向一致=True
fico         系数 -0.9199  方向一致=False   ← 单变量单调, 多变量翻转!
annual_inc   系数 -0.8243  方向一致=False   ← 同上
delinq_2yrs  系数 -0.0883  方向一致=True
open_acc     系数 -0.9875  方向一致=True
revol_util   系数 -0.2078  方向一致=True
第三层:符号计算验证(数学侧)
对分段 WOE 变换后的分数函数,用 SymPy 验证每一段的导数符号:
python
import sympy as sp

# 分段 WOE 变换: f(x) = w_i 当 x ∈ 第 i 箱
# 分数函数 Score(x) = -B·β·f(x), 每段内是常数, 跳变在分箱边界
# 单调性 = 所有相邻分数贡献同向
# 符号判据: sign(Δs_i) = -sign(β) · sign(WOE_{i+1} - WOE_i)
beta = sp.symbols("beta", real=True)
woe_i, woe_j = sp.symbols("woe_i woe_j", real=True)

# 相邻分箱分数差
delta_s = -sp.Rational(10) * beta * (woe_j - woe_i)
# 要求: 对 down 方向特征, WOE_{i+1} < WOE_i 且 beta<0 → Δs_i > 0
# 用 simplify 验证两个条件组合下 Δs_i 恒正
cond = sp.Q.negative(beta) & sp.Q.negative(woe_j - woe_i)
print(sp.simplify(delta_s))                    # -10*beta*(woe_j - woe_i)
print(sp.ask(sp.Q.positive(delta_s), cond))    # True
输出:
-10*beta*(woe_j - woe_i)
True三层审计各管一段:WOE 排序抓分箱层的错,系数符号抓模型层的错,符号计算把"方向必须一致"这件事变成可证明的数学命题。
真实数据:两类违反都出现了
在 LendingClub 2,257,017 笔样本(剔除缺失与异常,坏账口径 Charged Off/Default,坏账率 11.92%)上,构造 6 特征评分卡。完整结果:
| 特征 | IV | WOE 序列 | 业务方向 | 回归系数 | 单变量单调 | 系数一致 |
|---|---|---|---|---|---|---|
| fico | 0.159 | [-1.24,-0.42,-0.24,0.03,0.46,1.04] | 越高越安全 | -0.92 | ✅ | ❌ |
| dti | 0.049 | [0.31,0.18,0.03,-0.11,-0.24,-0.36,0.40,0.75] | 越高越危险 | -0.73 | ❌ 尾部反转 | ✅ |
| revol_util | 0.044 | [0.46,0.34,0.06,-0.12,-0.20,-0.26] | 越高越危险 | -0.21 | ✅ | ✅ |
| annual_inc | 0.035 | [-0.21,-0.21,-0.16,-0.10,-0.02,0.10,0.27,0.45] | 越高越安全 | -0.82 | ❌ 首段微降 | ❌ |
| open_acc | 0.005 | [0.22,0.06,-0.04,-0.05,-0.06,-0.08] | 越高越危险 | -0.99 | ✅ | ✅ |
| delinq_2yrs | 0.004 | [0.03,-0.08,-0.17,-0.22,-0.24] | 越高越危险 | -0.09 | ✅ | ✅ |
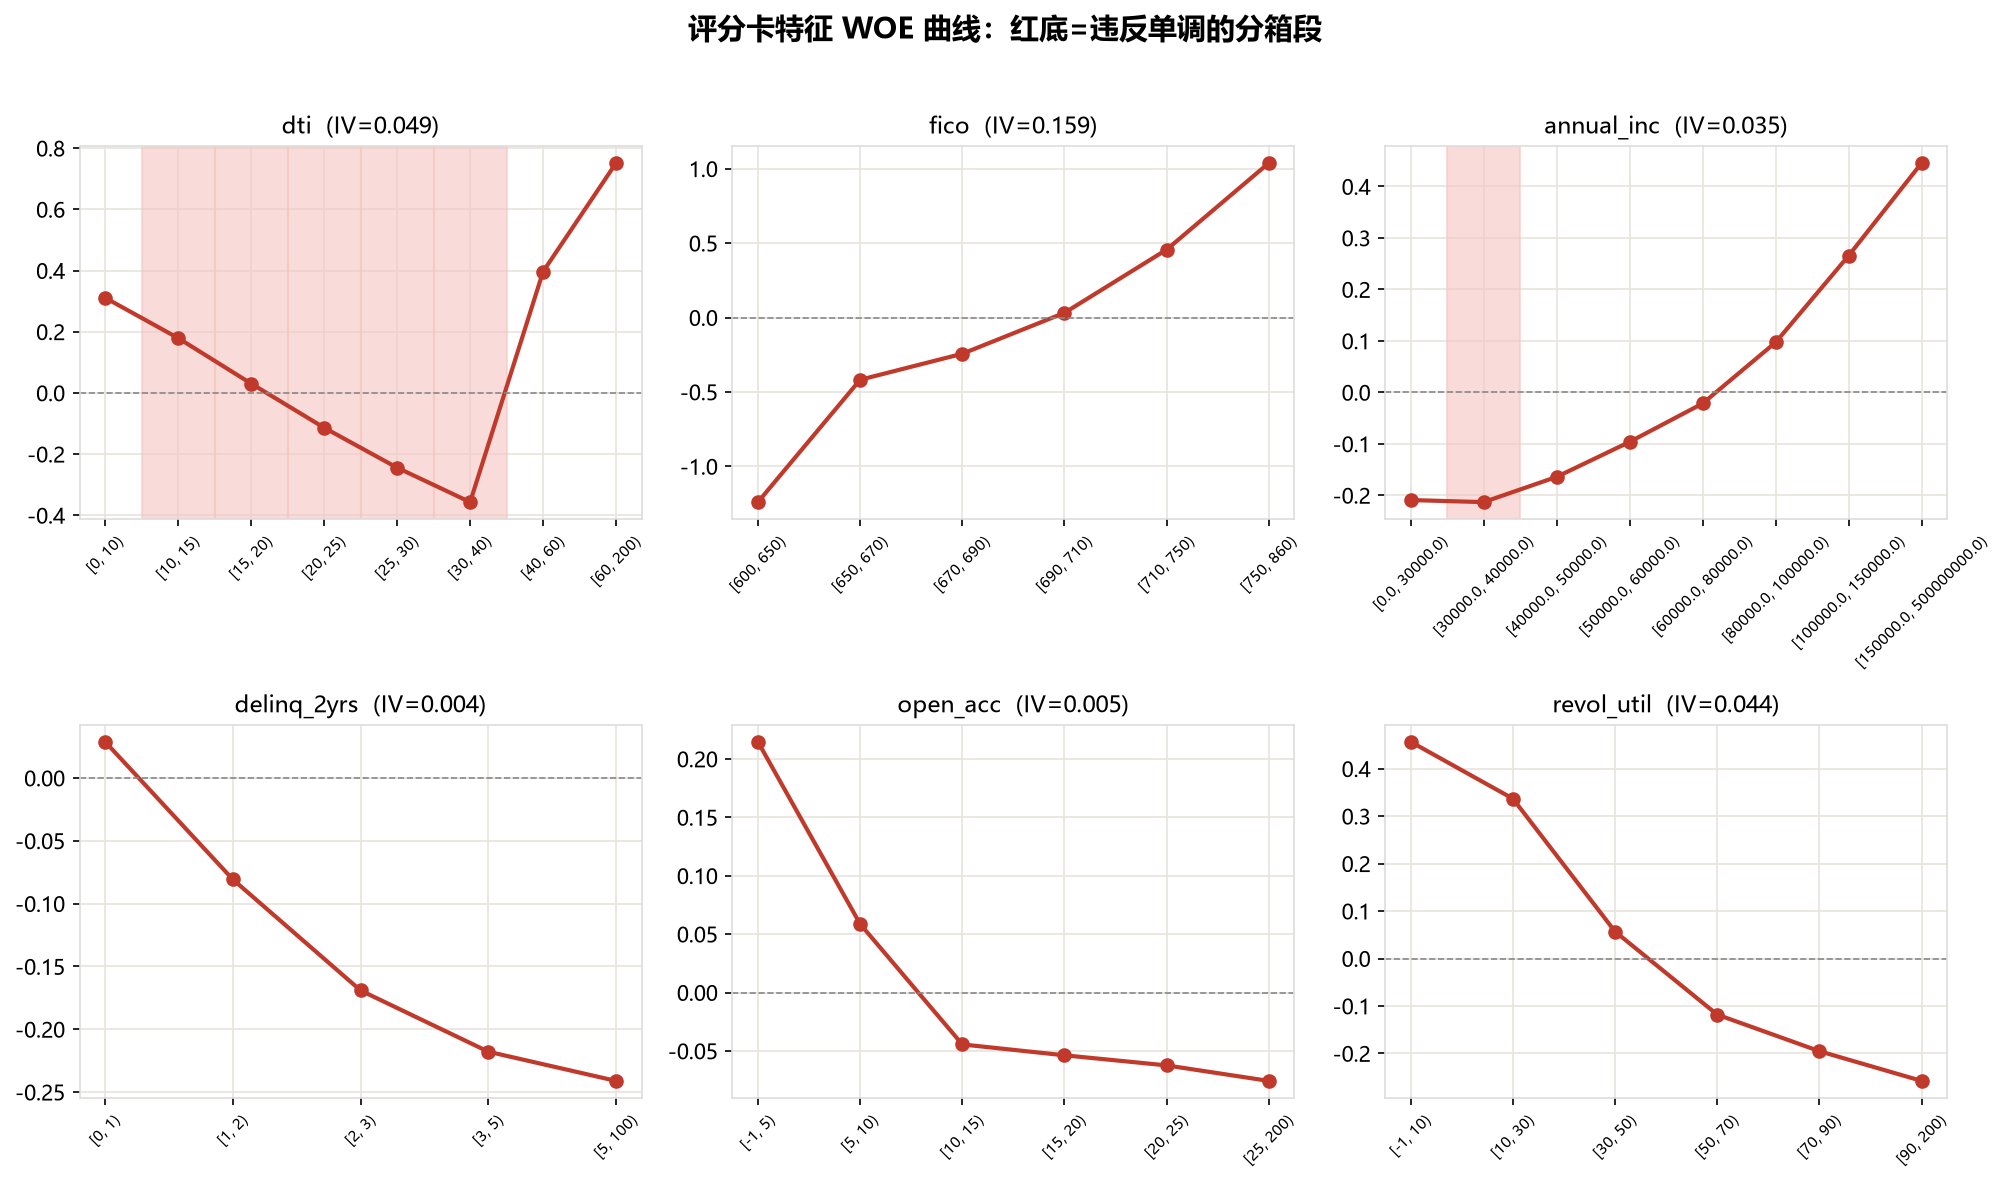
红底标出违反单调的分箱段。两个典型问题:
发现一:dti 的尾部 U 型反转(分箱层违反)。dti 从 10 到 40,WOE 一路从 0.31 降到 -0.36(越来越危险,符合直觉);但 40-60 箱是 -0.36,60 以上突然跳到 0.40、0.75——高负债人群反而"变安全"了。
发现二:fico 与 annual_inc 的系数翻转(模型层违反)。单变量看,fico 的 WOE 严格递增、annual_inc 基本递增,都没问题;但多变量回归里两个系数都是负的,与"越高越安全"的业务方向相反。查 WOE 特征相关矩阵:
               dti   fico  annual_inc  delinq_2yrs  open_acc  revol_util
dti          1.000  0.046       0.170       -0.014     0.280       0.162
fico         0.046  1.000       0.084        0.207    -0.013       0.472
annual_inc   0.170  0.084       1.000       -0.079    -0.214      -0.062
delinq_2yrs -0.014  0.207      -0.079        1.000     0.061       0.004
open_acc     0.280 -0.013      -0.214        0.061     1.000      -0.073
revol_util   0.162  0.472      -0.062        0.004    -0.073       1.000
fico 与 revol_util 在 WOE 空间的相关系数高达 0.472。高信用分的人循环利用率通常也高(敢用额度 = 信用好),两个变量带着高度重叠的信息进模型。多变量回归里,fico 的偏效应被 revol_util 吸收后符号翻转——这是教科书级的共线性抑制效应(suppression):单变量的边际单调,不等于控制其他变量后的条件单调。
为什么 dti 会 U 型反转?
这是全篇最值得琢磨的机制问题。dti 超过 60 的客户,按直觉应该是风险最高的,为什么实际坏账率反而低?
先看数据:dti 60 以上分箱的样本量占比很小(dti 分布的长尾),能进入贷款池的高负债客户,是被前面更严的规则(信用分、收入、额度上限)筛过一轮的"幸存者"——他们负债率高,但其他维度(尤其是 fico)足够好,整体风险反而低。
严谨地说:这是样本选择效应。评分卡里 dti 的边际效应是"高负债 + 其他条件不变"才危险;但真实客群里"高负债"几乎总是伴随"其他条件更严",两股力量抵消后,尾部反而安全。单变量 WOE 曲线看到的"反转",是混杂了其他特征的边际图像,不是 dti 的纯效应。
这也解释了为什么 fico 的系数翻转和 dti 的 U 型是同一个根源的两种表现:特征之间不是独立的,单变量图像 ≠ 多变量实情。
怎么修:两层修复,各修各的
修复一:分箱合并(治 dti 的 U 型)
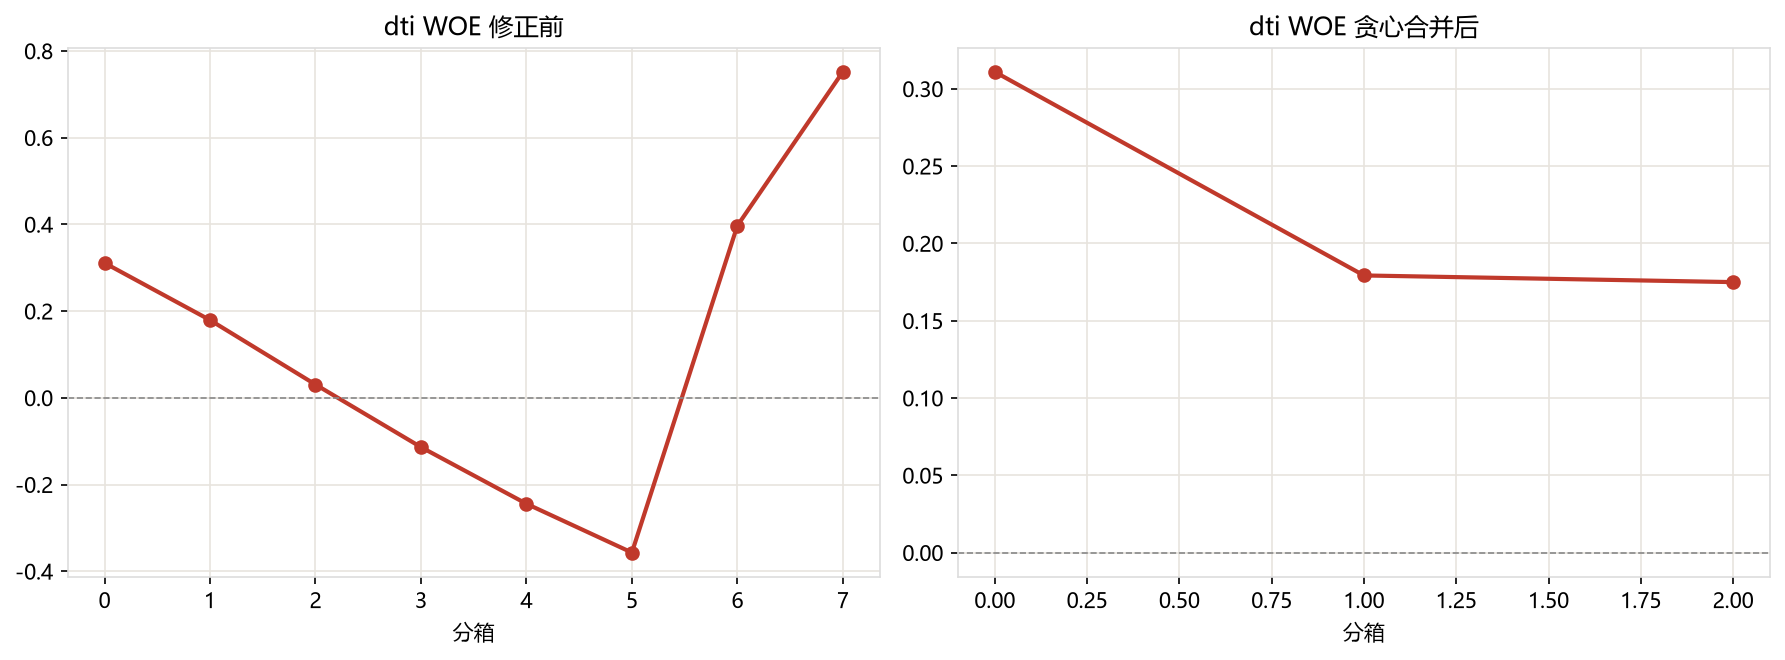
对违反单调的分箱做贪心合并——相邻违反的分箱并成一箱,取合并后的 WOE 均值,重复直到序列单调:
python
def fix_monotone(woe: np.ndarray, direction: str):
    """贪心合并违反方向的分箱, 返回修复后 WOE 与合并次数"""
    w = woe.copy()
    merged = 0
    i = 0
    while i < len(w) - 1:
        bad = (w[i] > w[i+1]) if direction == "down" else (w[i] < w[i+1])
        if bad:
            w[i] = (w[i] + w[i+1]) / 2
            w = np.delete(w, i + 1)
            merged += 1
            if i > 0: i -= 1
        else:
            i += 1
    return w, merged

dti_woe = np.array([0.311, 0.179, 0.031, -0.114, -0.244, -0.357, 0.397, 0.752])
w_fix, n = fix_monotone(dti_woe, "down")
print(w_fix, n)   # [0.311 0.179 0.175] 5 —— 尾部 6 箱合成 1 箱
输出:
[0.311 0.179 0.175] 5dti 从 8 箱合并到 3 箱:[0,10) [10,15) [15,200)。尾部"反转段"全部收进一个"≥15 高风险"箱,单调性恢复。代价是分箱粒度变粗——但这正是业务能接受的:为了单调性,牺牲尾部精度。
修复二:共线性处理(治 fico 的翻转)
fico 系数翻转的根因是和 revol_util 高度相关(r=0.472)。两个处理方向:
- 二选一:fico 与 revol_util 保留 IV 更大的那个(fico IV=0.159 > revol_util 0.044),另一个从模型中剔除——这是最常用的做法,直接消掉共线源
- 业务裁定:如果两个都想要(比如监管要求必须保留 fico),就用业务方向约束回归(如 isotonic 约束或手工指定符号),而不是接受一个"fico 越高越危险"的怪模型
代码层面,共线性诊断就一行:
python
corr = X.corr()
print(corr.abs().unstack().sort_values(ascending=False).head(3))
# revol_util  fico      0.472
# dti         open_acc  0.280
# dti         annual_inc 0.170
修复后重新审计
修复不是一次性的。合并分箱、剔除特征后,重新跑三层审计:WOE 排序是否全部单调、系数符号是否全部符合业务方向、SymPy 判据是否通过。三层全绿,评分卡才敢上线。
结论:评分卡单调性,是三层审计的合谋
回到开头的两件怪事:dti 尾部反转是分箱层的错(WOE 排序被样本选择效应扭曲),fico 系数翻转是模型层的错(共线性让偏效应反转符号)。两层错误,靠一层审计都抓不全——必须三层一起:
第一层查 WOE 排序(数据说了什么),第二层查系数符号(模型学了什么),第三层用符号计算证明(数学上该是什么)。
单调性不是业务拍脑袋的"应该",它是 logit 结构里写死的性质(
边界声明:以上数字在 LendingClub 2,257,017 笔样本(剔缺失/异常,坏账口径 Charged Off/Default)上测得;分箱边界、特征选择、样本口径不同,具体违反位置会变,但"三层审计 + 两类违反"的框架不变。
关键要点:评分卡单调性 = WOE 排序(数据层)∩ 系数符号(模型层)∩ 符号验证(数学层);单变量单调 ≠ 多变量单调(共线性可翻转符号);分箱层违反靠合并修,模型层违反靠共线性诊断。
代码与数据:本文所有代码可复现,数据来自 LendingClub 公开数据集(2007-2018Q4)。完整脚本留档在文章同目录 gen_figures.py。