风控策略规则里的冗余——布尔代数怎么把规则迷宫变简单
2026年8月10日 · 预计阅读 11 分钟
关键词:布尔代数,规则化简,策略优化,逻辑等价,风控引擎
01 事件:一套策略系统,三个团队,九条规则
策略分析师老周接手了一套风险策略系统。上任第一天,他打开规则引擎的配置页,看到的是这样的东西——拦截条件一共有9条,每条都是"并且/或者"拼起来的组合:
| # | 规则(伪代码) | 谁写的 |
|---|---|---|
| 1 | 大额 且 高负债率 | 同事2 |
| 2 | 大额 且 近期逾期 | 同事2 |
| 3 | 高负债率 且 近期逾期 | 同事3 |
| 4 | 高负债率 且 近期逾期 且 账户过多 | 同事3 |
| 5 | 高负债率 且 近期逾期 且 低收入 | 同事3 |
| 6 | 大额 且 账户过多 | 同事1 |
| 7 | 大额 且 账户过多 且 低收入 | 同事1 |
| 8 | 大额 且 账户过多 且 高负债率 | 同事1 |
| 9 | 大额 且 账户过多 且 近期逾期 | 同事1 |
规则引擎的逻辑是:命中任意一条就拦截。也就是说,这些规则之间是"或"的关系。
老周第一反应是数了一下:每个客户进来,引擎最多要做9次条件判断。这看起来不算多,但这是对每个申请人都要跑一遍的逻辑,一天几百万次。
更让他不安的是第四条到第九条——它们看起来像是某几条规则的"加强版"。第四条"高负债率 且 近期逾期 且 账户过多",和第三条"高负债率 且 近期逾期"比,多了一个"账户过多"条件。多了一个条件,意味着更严格,意味着能命中的客户一定更少。
那问题来了:既然第四条命中的客户,一定也会被第三条命中——那第四条还有存在的意义吗?
02 追问:规则为什么会冗余
三组规则为什么会写成这样?不是因为他们笨,而是因为策略系统是长出来的,不是设计出来的。
同事2上线时只写了第一条"大额且高负债"。后来发现有一批欺诈是大额+近期逾期,于是补了第二条。同事3接手时没看同事2的规则,自己按经验写了第三条,后来又怕漏,加了两个"加强版"。同事1同理。
每个组都只对自己写的规则负责,没有人对整个规则集负责。这就是规则迷宫的来源——它和代码里的"屎山"是同一个东西,只不过规则引擎里的屎山,每天都在真实地拦截客户。
但这篇文章要讲的不是管理问题,是数学问题。 我们真正要问的是:
这些规则里,有多少是逻辑上重复的?能不能在不改变任何拦截结果的前提下,把9条规则化简成更少、更快的规则?
答案是:能。工具是布尔代数,一门300年前就存在的数学。
03 方法:布尔代数的化简原理
3.1 把规则翻译成逻辑表达式
先把9条规则翻译成数学语言。定义5个"原子命题":
| 记号 | 含义 | LendingClub字段 |
|---|---|---|
| 大额借款( | loan_amnt | |
| 高负债率( | dti | |
| 近期逾期次数多( | delinq_2yrs | |
| 开立账户过多( | open_acc | |
| 低收入( | annual_inc |
"且"对应逻辑与(AND,记作
其中,比如
3.2 三条化简定律
布尔代数有三条基本定律,是化简的核心工具。
定律一(分配律):与对或的分配
反过来用,就是从"两条规则都有公共条件
定律二(吸收律):大项吃掉小项
如果一条规则是另一条规则的"加强版"(多了条件),那加强版是冗余的——因为只要加强版命中,原规则一定命中。反过来,如果
定律三(幂等律):重复的项只算一次
3.3 手工化简三组规则
同事3(规则3/4/5):
先用分配律把公共因子
再用吸收律:
三条规则,化简成一条:高负债率 且 近期逾期。第四条"账户过多"和第五条"低收入"是纯冗余——它们命中的每一个客户,第三条都已经拦下了。
同事1(规则6/7/8/9):
提取公共因子
括号里是"恒真"——只要
四条规则,化简成一条:大额 且 账户过多。
全部合并(9条 → 4条):
把三组化简后的结果合起来:
9条规则 → 4条规则。原来每次判断最多10次逻辑运算,现在5次。
3.4 数学上严格验证:真值表穷举
手工化简可能出错。但布尔代数有个好处:逻辑等价性可以机械验证。
对
这就是"化简"和"删规则"的本质区别:删规则是拍脑袋,化简是证明过的等价变换。
04 拆解结果:真实数据怎么说
光有数学证明还不够。我们在LendingClub 2007-2018年公开贷款数据(226万笔)上,把这三组规则真实跑了一遍。
4.1 五个规则原子的真实命中率
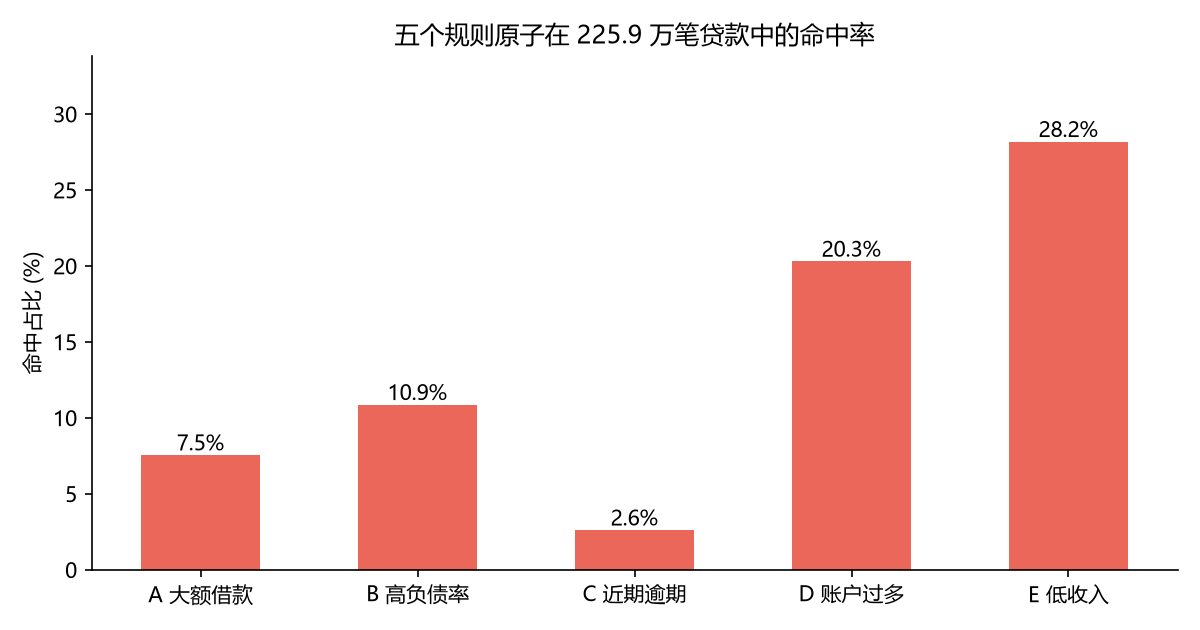
| 原子 | 含义 | 命中数 | 命中率 |
|---|---|---|---|
| A | 大额借款(>3万) | 170,515 | 7.5% |
| B | 高负债率(>30%) | 245,398 | 10.9% |
| C | 近期逾期(>2次) | 58,866 | 2.6% |
| D | 账户过多(>15个) | 458,581 | 20.3% |
| E | 低收入(<5万) | 636,579 | 28.2% |
样本量:2,258,928笔(剔除缺失值后的完整样本)。
4.2 化简前后:命中数完全一致
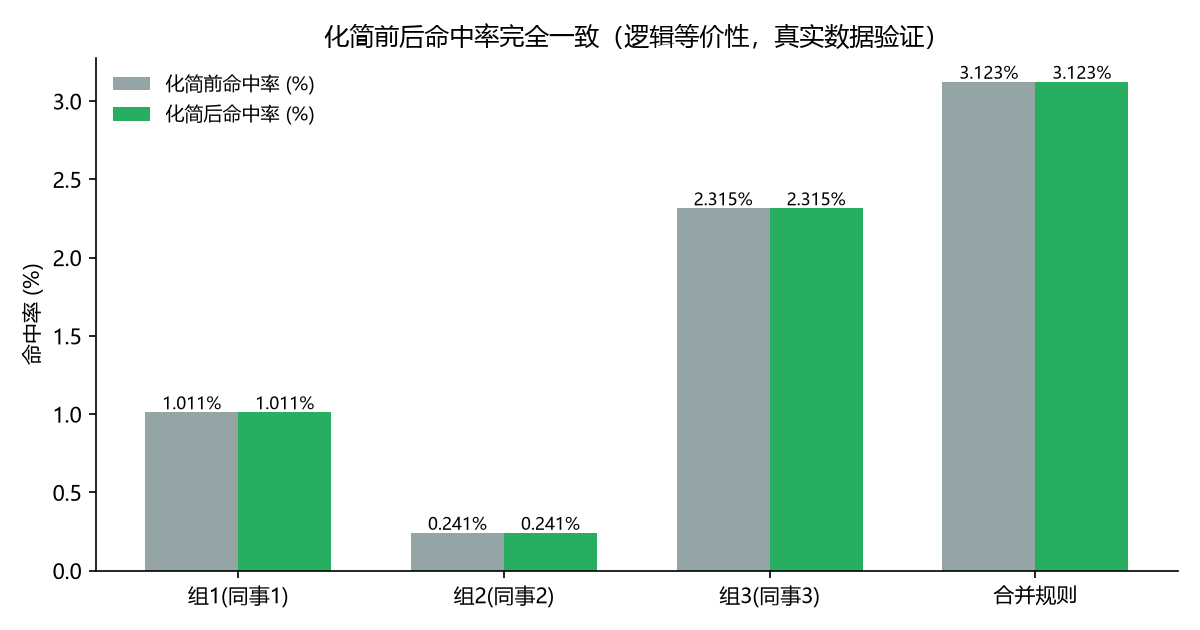
| 规则组 | 化简前命中 | 化简后命中 | 是否一致 |
|---|---|---|---|
| 组1(同事1) | 52,284 | 52,284 | ✅ |
| 组2(同事2) | 22,846 | 22,846 | ✅ |
| 组3(同事3) | 5,448 | 5,448 | ✅ |
| 合并规则 | 70,545 | 70,545 | ✅ |
四个组的命中数分毫不差。这不是巧合——真值表已经证明过逻辑等价,数据只是把这个证明落到了真实业务上。
4.3 计算量:每次判断从10次降到5次
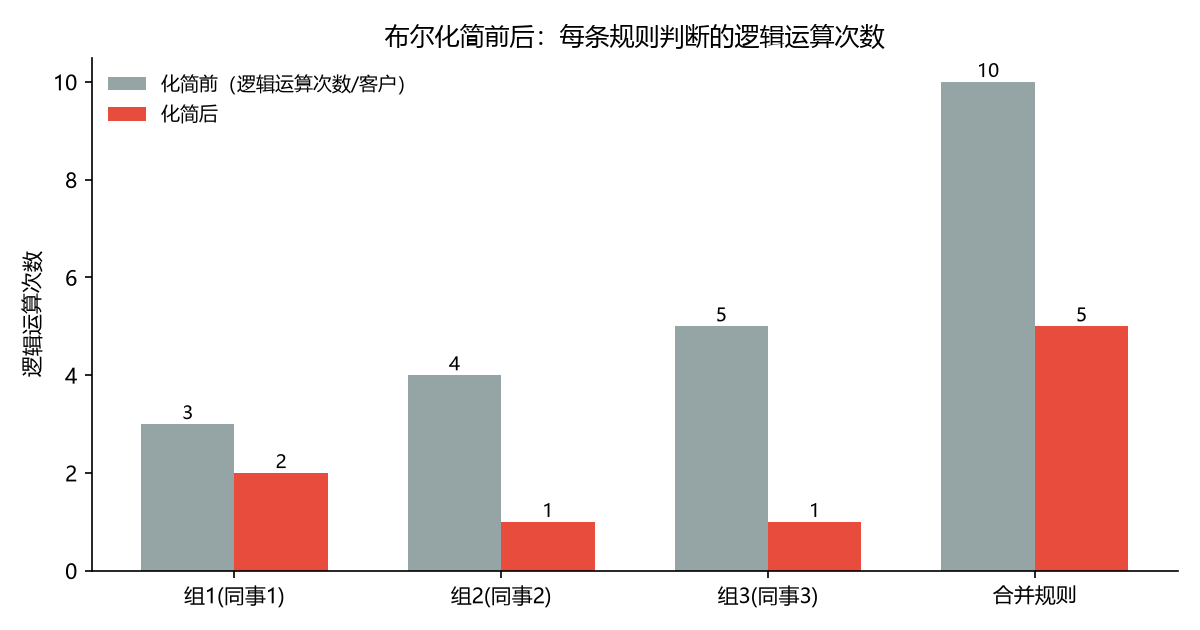
| 规则组 | 化简前运算次数 | 化简后运算次数 | 下降 |
|---|---|---|---|
| 组1(同事1) | 5 | 1 | 80% |
| 组2(同事2) | 3 | 2 | 33% |
| 组3(同事3) | 4 | 1 | 75% |
| 合并 | 10 | 5 | 50% |
4.4 冗余长什么样:子集关系
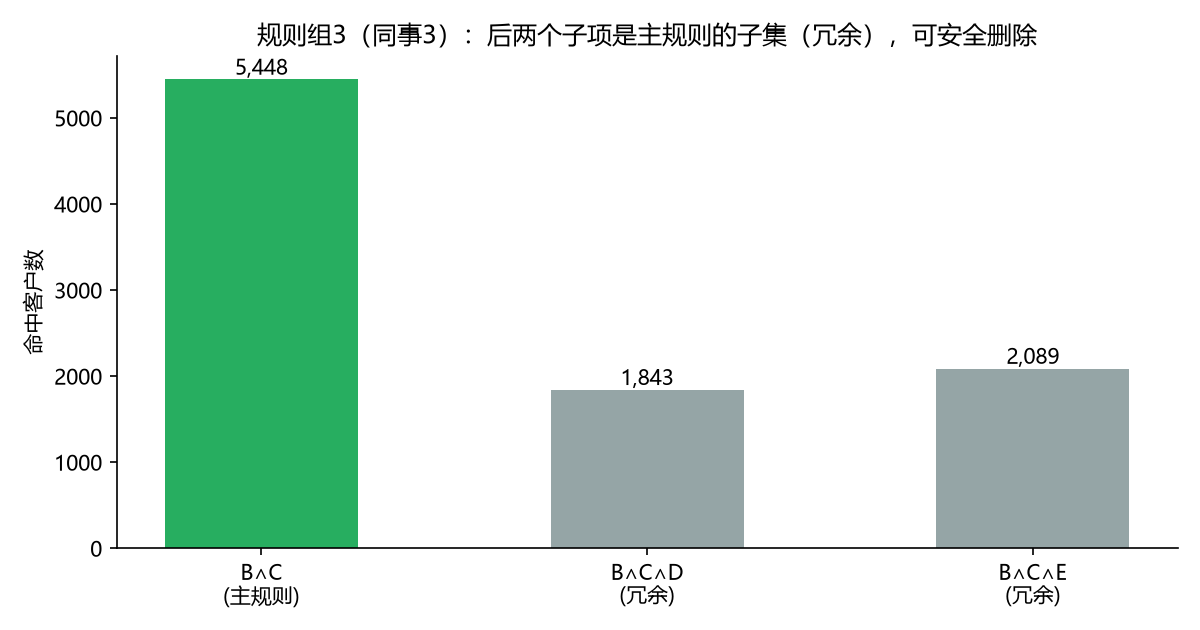
以组3(同事3)为例:主规则
05 如果重来:规则化简的正确姿势
老周最后没有手撕规则。他做的是三件事:
第一步:规则翻译。把规则引擎里每一段"并且/或者"翻译成逻辑表达式,原子命题对齐到真实数据字段。
第二步:机器化简。用符号计算库(Python的SymPy,simplify_logic)自动化简——手工只适合3-4个原子的情况,规则一多必须交给机器。真值表验证自动附带。
第三步:真实数据回归。化简后的规则集,在历史数据上跑一遍,确认命中集合和化简前完全一致——先证明等价,再上生产。
这套流程里最反直觉的一点是:化简规则和删规则是两回事。
删规则是"我觉得这条没用,删了吧"——靠直觉,可能出错,业务方不敢签字。
化简是"我证明了这条规则命中的每一个客户,都会被另一条规则命中,所以它在逻辑上是冗余的"——靠证明,可复现,业务方可以放心。
06 方法论提炼:迷宫不只是风控有
这套"翻译 → 化简 → 验证"的流程,不止适用于风控规则引擎。任何由"条件组合"构成的系统,都有同一个数学结构:
- 风险策略规则集:命中任意一条就拦截(本文案例)
- 授信审批矩阵:满足任意一组条件就降额/拒贷
- 监控告警规则:满足任一组合就触发告警
- 营销人群圈选:满足任一标签组合就进池
它们的共同点:规则是多个团队/多个时期叠加出来的,冗余必然存在。而布尔代数给出的是数学上最严格的化简方式——不改变任何行为,只删掉逻辑上多余的判断。
真正的收益不是省那几次逻辑运算。是规则系统变得可维护了:4条规则比9条规则好审计、好解释、好调参。在策略系统里,"少"本身就是一种风险控制——规则越少,出错的表面越少,解释成本越低。
170多年前,布尔写下《思维定律的研究》时,大概没想到这套逻辑代数会在一个半世纪后,被用来清理一套风险规则引擎。
数据说明: LendingClub 2007-2018年公开贷款数据(226万笔),本地parquet读取,剔除缺失值后样本2,258,928笔。规则原子按贷款金额、负债率、逾期次数、账户数、收入五个字段定义,仅作方法论演示,不代表任何真实机构的策略。命中数来自DuckDB实际查询,化简由SymPy 1.14完成,逻辑等价性经真值表穷举验证。
代码环境: Python 3.11,SymPy 1.14.0,DuckDB,pandas,matplotlib;随机种子seed=42(本实验无随机性依赖)。