概率校准——什么时候是白干,什么时候救命
本文为 AI 辅助创作,数据实测与结论推导由作者完成。
关键词:概率校准,逻辑回归,ECE,Brier,Platt scaling,Isotonic,先验偏移
同一套 LendingClub 数据,同一个逻辑回归模型,只改了一件事——训练和测试怎么切分——两个数字天差地别:
- 随机切分(训练/测试同分布):期望校准误差 ECE = 0.0009,接近完美校准
- 时间切分(用 2007-2013 训练、2016 之后测试):ECE = 0.0904,预测概率系统性偏高
模型没变,变的是环境。这就是校准的全部秘密:逻辑回归在同分布数据上天然校准,校准工具在模型训练阶段大部分时间是白干;但部署环境一变,模型立刻失准,而错误使用校准工具还会更糟。
这篇把概率校准的数学讲透:什么是校准、逻辑回归为什么天然校准(这是评分卡基线的隐藏优势)、什么时候校准是白干、什么时候救命、以及怎么救。
校准是什么:预测概率与实际频率的差
模型输出一个概率
即:凡是模型给出 20% 的样本,实际违约率就该是 20%。校准度量的是"预测的绝对水平准不准",跟模型能不能把好坏人分开(那是区分度)是两码事。
两个标准度量:
期望校准误差(ECE):把预测概率分成
ECE = 0 表示完美校准。这个公式就是可靠性图的数值版:把
Brier 分数(均方概率误差):
Brier 可以分解成三部分(Murphy 分解):
即
逻辑回归为什么天然校准
这是全篇第一个反直觉点:评分卡用的逻辑回归,在训练分布上天然校准,不需要任何校准工具。原因在损失函数。
逻辑回归的 MLE 等价于最小化对数损失:
对数损失是严格 proper scoring rule:对任意固定的
MLE 在大样本下一致,所以逻辑回归估计的概率收敛到真实条件概率——这就是"天然校准"的数学根源。评分卡用逻辑回归做基线,等于白送一个校准良好的概率输出(对比:树模型的最小化目标是 Gini/信息增益,不保证校准,是公认的校准差生)。
实测场景A:校准工具在这里是白干
在 LendingClub 2,257,017 笔样本(坏账率 11.92%)上,6 特征 WOE 评分卡,随机切分 60/20/20(train/calib/test,三份坏账率 11.94%/11.87%/11.93%,同分布):
| 指标 | 校准前 | Platt 校准后 | 变化 |
|---|---|---|---|
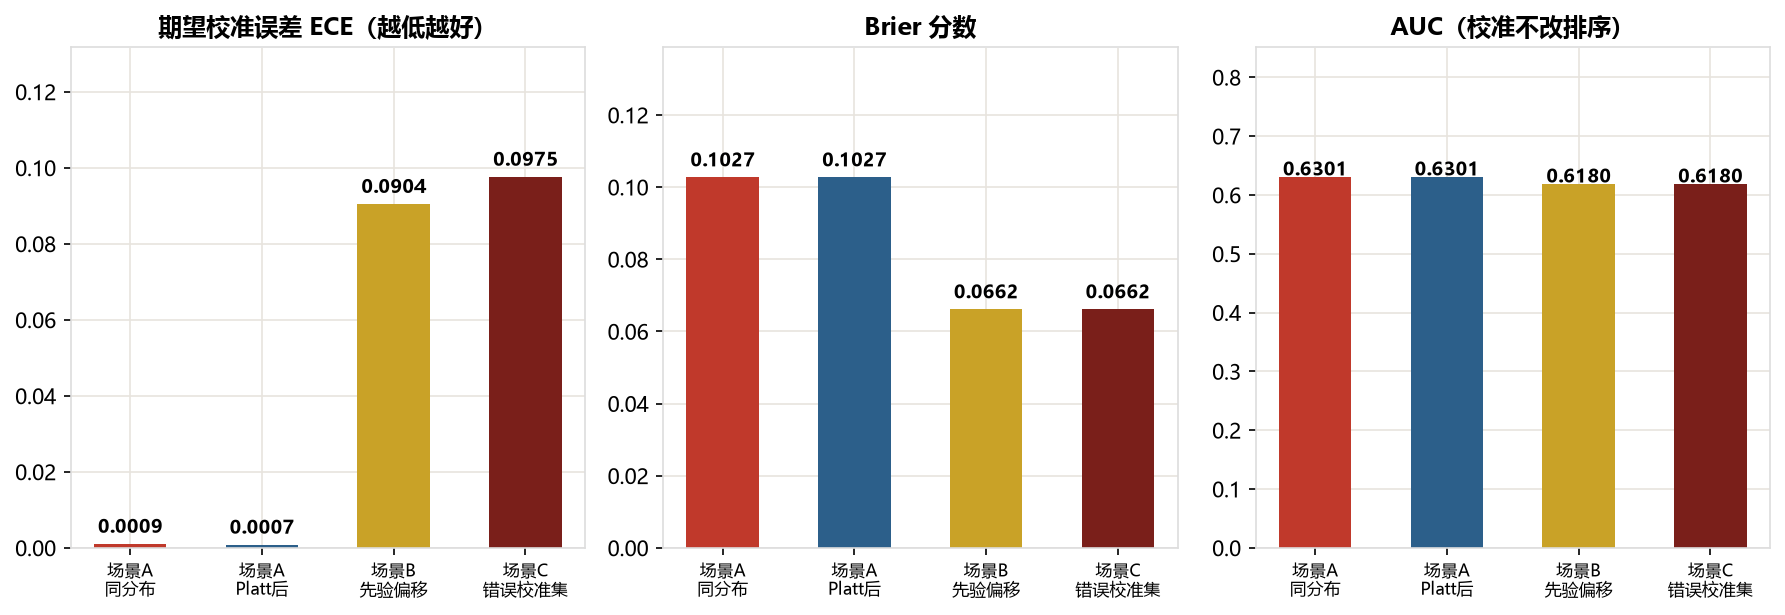
| ECE | 0.0009 | 0.0007 | 几乎不动 |
| Brier | 0.1027 | 0.1027 | 不动 |
| AUC | 0.6301 | 0.6301 | 不动 |
可靠性图直接贴在完美对角线上:
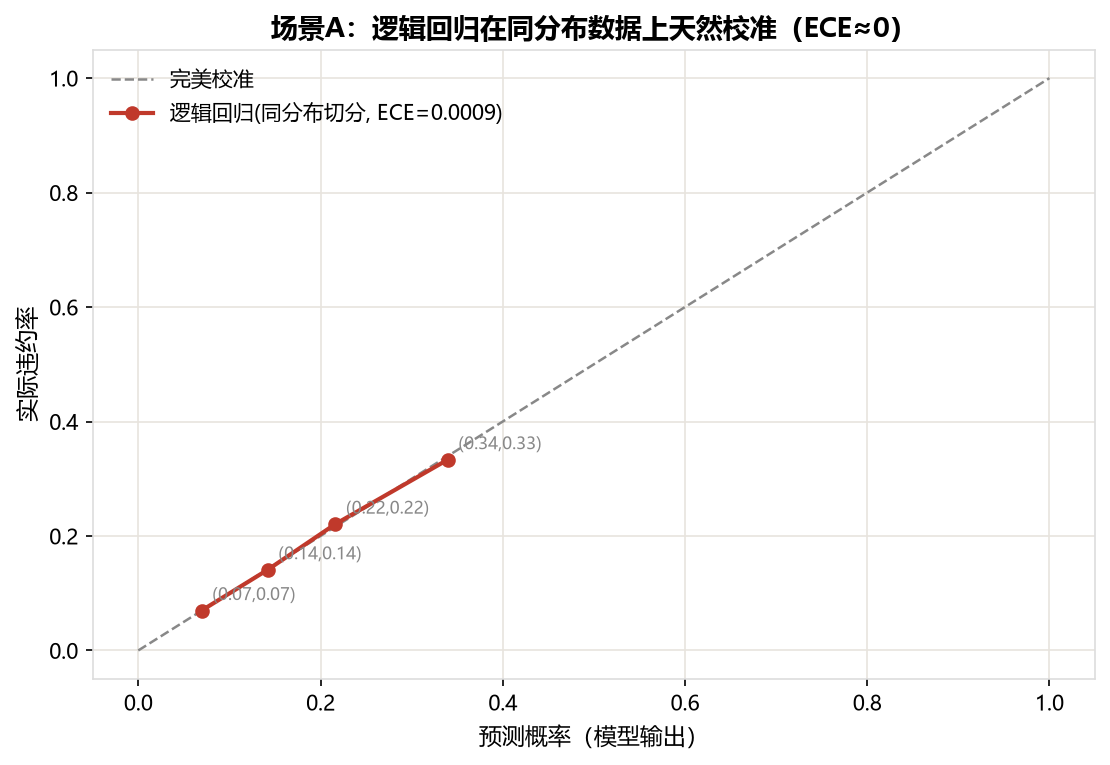
校准工具在这里是白干——模型本来就准,Platt 拟合出的变换是
校准和区分是两回事
为什么 ECE 这么低而 AUC 只有 0.63?因为两个指标管的事完全不同:
- AUC/KS 管排序:坏客户分数是不是普遍高于好客户(相对水平)
- 校准管水平:预测概率的绝对值对不对(绝对水平)
评分卡的数学结构把两者连起来看更清楚(承接 #108 单调性):
分数与概率是单调映射——模型排序对,分数-违约率曲线严格递增(图2);但曲线整体上下平移的偏差,就是校准问题:
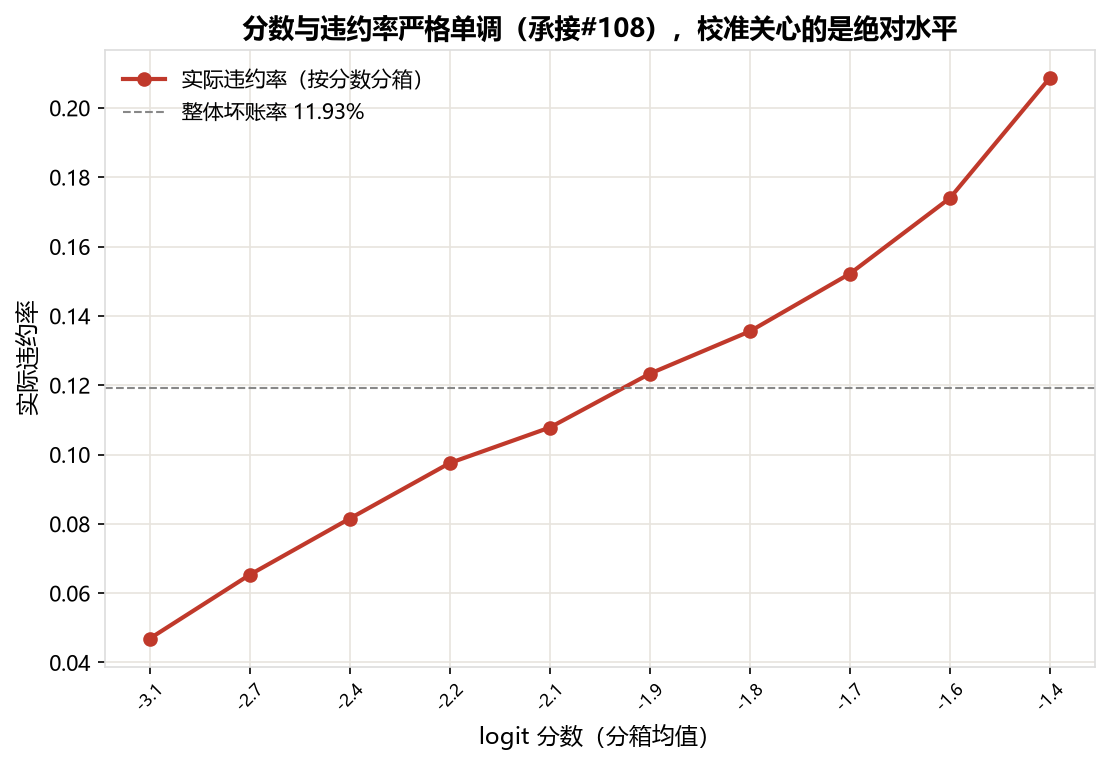
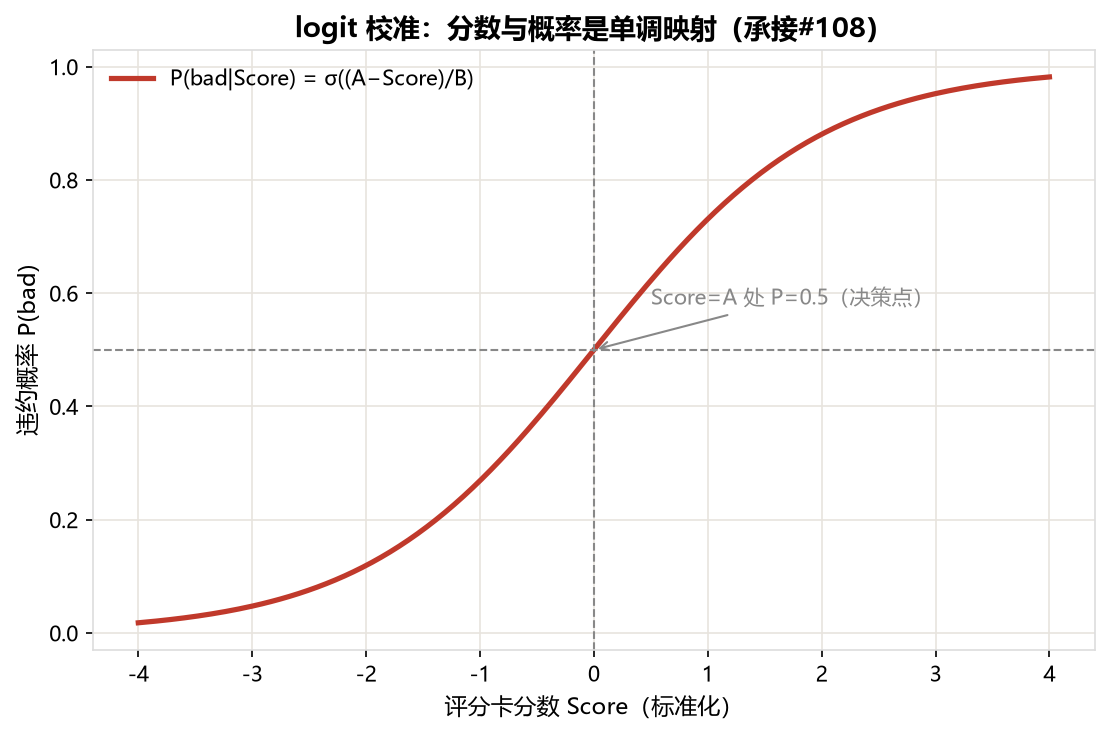
AUC 0.63 表示排序能力中等(6 个 WOE 特征的极限),但排序对不代表水平对。校准管的是那条曲线的"上下位置",区分度管的是它的"陡峭程度"——两套机制,两个指标,谁也替代不了谁。
实测场景B:环境变了,模型就不准了
那校准问题什么时候出现?答案:部署环境与训练环境不一致时。最典型的就是时间——先验偏移(prior shift)。
把同一套数据按时间切分:2007-2013 训练(坏账率 15.87%)、2013-2015 校准(17.50%)、2016 之后测试(6.16%)。LendingClub 后期通过率收紧、客群质量上升,测试期坏账率只有训练期的一半不到:
| 指标 | 随机切分(场景A) | 时间切分(场景B) |
|---|---|---|
| ECE | 0.0009 | 0.0904 |
| 预测均值 vs 实际 | 11.9% vs 11.9% | 17.2% vs 6.2% |
同一个模型,预测均值 17.2%,实际只有 6.2%——模型在"坏账率高"的时代训练,拿到"坏账率低"的时代用,每笔贷款的违约概率都高估了 10 个百分点以上。
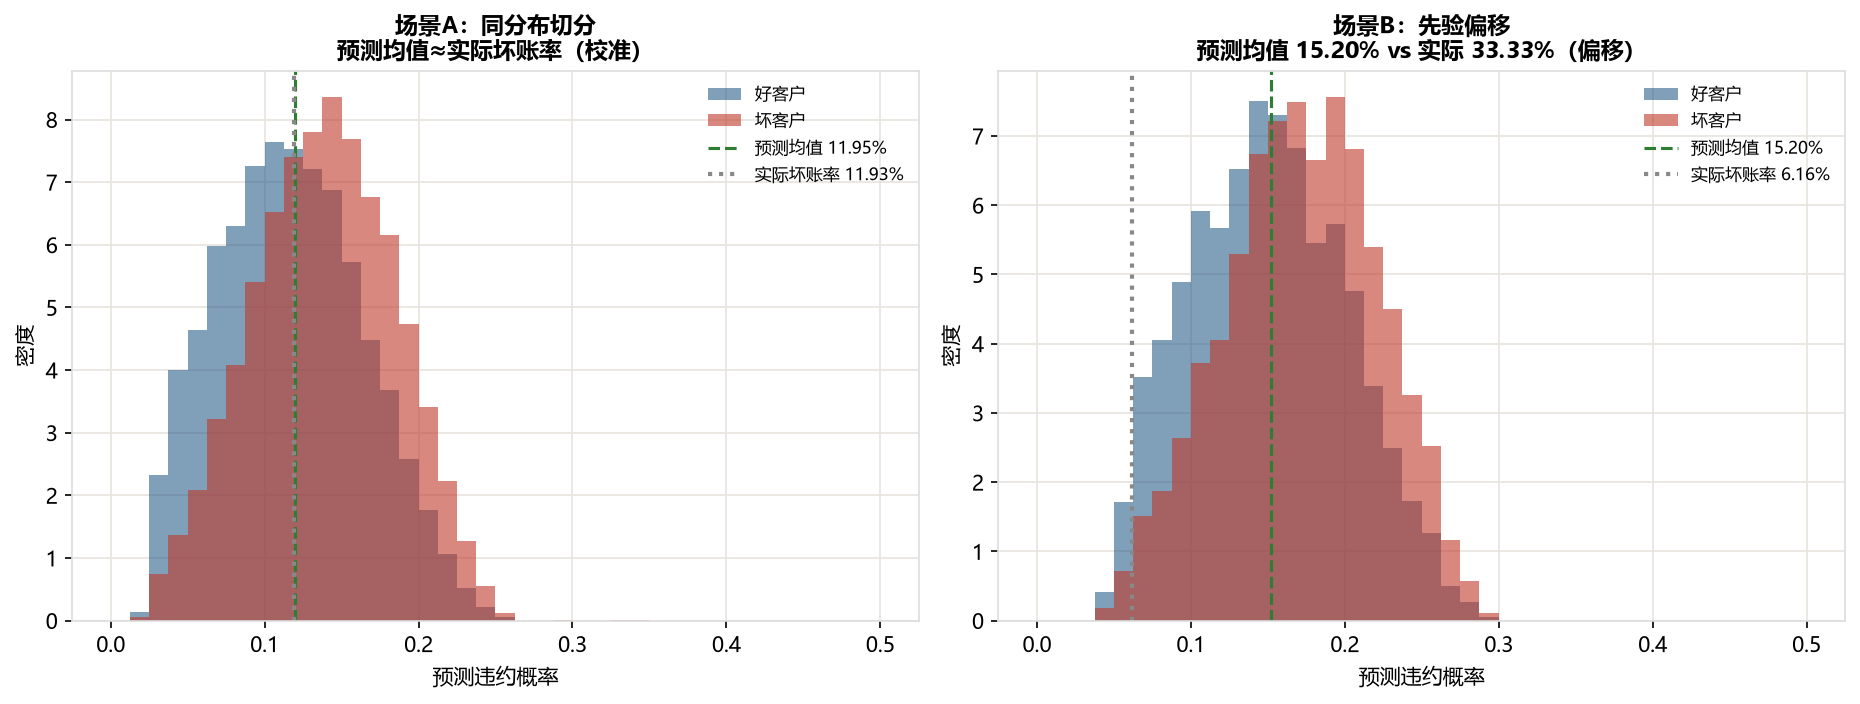
注意左图(场景A):预测均值 ≈ 实际坏账率(校准);右图(场景B):预测均值 17.2% 与实际的 6.2% 之间隔着一道巨大的沟。校准问题的根源是环境漂移,不是模型本身——这解释了为什么"校准"在 ML 社区是热门话题而在评分卡上线初期没人关心:模型刚上线时分布没变,用不着;上线一年后分布变了,才想起来。
校准工具箱:Platt 和 Isotonic
Platt scaling:双正态假设下的最优变换
Platt 校准的数学根基是双正态模型。假设好客户分数
代入两个正态密度并展开:
后验 logit 是分数的线性函数。因为逻辑回归的
参数
python
from scipy.special import logit as sp_logit
from sklearn.linear_model import LogisticRegression

# 校准集: 用基模型预测概率 p_calib, 真实标签 y_calib
platt = LogisticRegression()
platt.fit(sp_logit(np.clip(p_calib, 1e-6, 1-1e-6)).reshape(-1, 1), y_calib)
# 应用: 对测试集预测概率 p_test 做同样变换
p_test_cal = platt.predict_proba(sp_logit(np.clip(p_test, 1e-6, 1-1e-6)).reshape(-1, 1))[:, 1]
Isotonic regression:非参数保序
不假设双正态,直接求一个单调非降的变换
求解用 PAVA(Pool Adjacent Violators Algorithm,合并相邻违规块):
- 按预测概率排序样本,每点一个块,块内取均值
- 相邻块若违反单调(前块均值 > 后块均值),合并成一块取加权均值
- 重复直到全部块单调
python
from sklearn.isotonic import IsotonicRegression

iso = IsotonicRegression(out_of_bounds="clip")
iso.fit(p_calib, y_calib)
p_test_cal = iso.predict(p_test)
PAVA 保证得到全局最优的分段常数单调解,是"让概率变准"里最通用的工具——缺点是阶梯状、易过拟合(箱数多),需要校准集样本量充足。
实测场景C:校准集错了,越校越糟
校准工具不是万能药,它的前提是校准集必须代表部署分布。场景C就是反面教材:用时间切分的校准集(2013-2015,坏账率 17.50%)去校准模型,部署到测试集(2016 之后,坏账率 6.16%):
| 指标 | 场景B(不校准) | 场景C(错误校准集 Platt) |
|---|---|---|
| ECE | 0.0904 | 0.0975 |
| Platt 参数 | — | α=1.107, β=0.233(把概率整体拉高) |
校准集坏账率 17.5% 比测试集 6.16% 高出一倍多,Platt 学到的变换是"把概率再拉高"(β>0)——本来已经偏高,校准后更高了。ECE 从 0.0904 恶化到 0.0975:
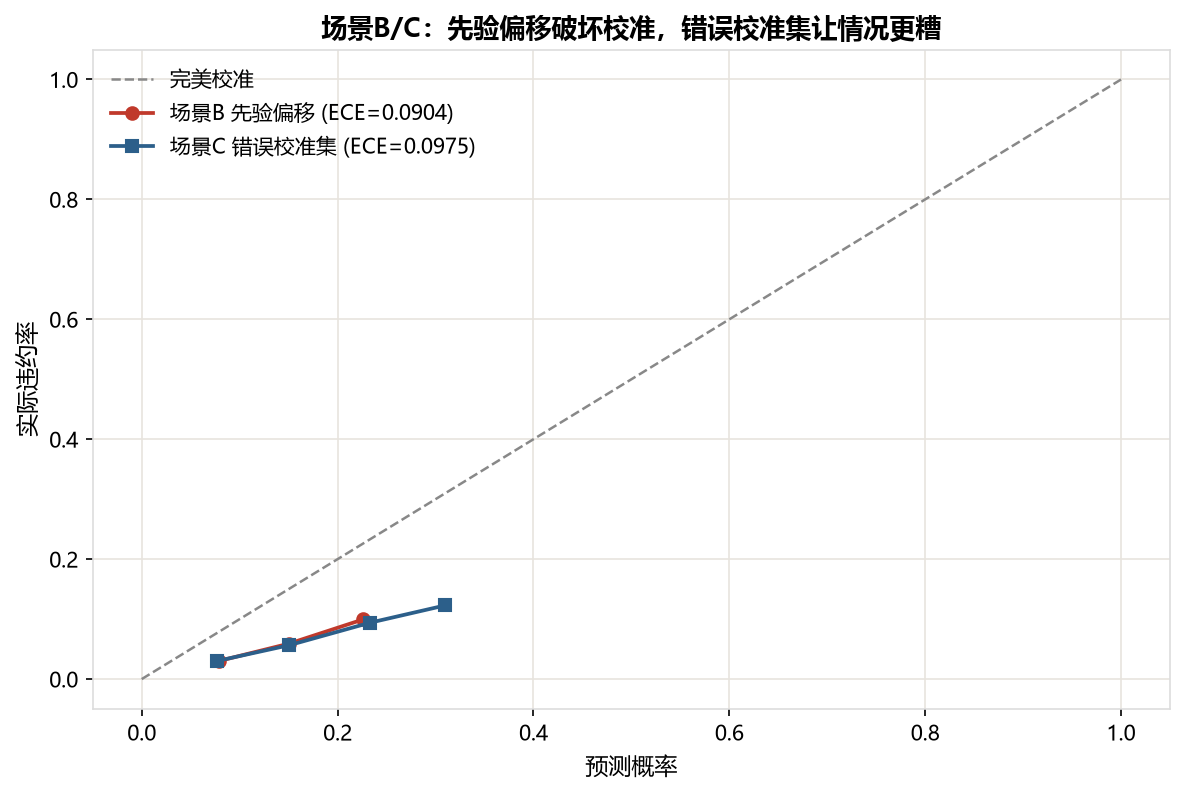
这个反直觉点值得刻进脑子里:校准是"用部署分布重标定"——校准集选错,校准比不校准更糟。很多人拿着训练分布的数据做 Platt,以为在"修模型",实际在做"加偏"。
正确姿势:上线后的滚动校准
把三场景串起来,校准的正确用法就清楚了:
| 场景 | 校准前 ECE | 该不该校准 | 怎么做 |
|---|---|---|---|
| A 同分布部署 | 0.0009 | 不用(白干) | 什么都不做 |
| B 环境漂移(有代表校准集) | 0.0904 | 要 | 用与部署同期的样本拟合 Platt/Isotonic |
| C 环境漂移(校准集错) | 0.0904 | 要但别用错集 | 校准集必须代表部署分布,否则更糟 |
落地动作:评分卡上线后,每季度用最近 3-6 个月的实际表现样本做一次滚动校准——样本来自部署期,先验自然与部署一致,Platt/Isotonic 才能真正把概率拉回真实水平。同时监控两个数字:区分度(AUC/KS,管排序有没有退化)和校准度(ECE/Brier 的可靠性项,管水平有没有漂移)——两个一起看,缺一个都会漏掉半边问题。
结论:校准是部署维护工具,不是模型训练工具
三句话总结这篇:
逻辑回归在同分布数据上天然校准——proper scoring rule + MLE 的数学保证,评分卡基线自带校准属性,这是它相对树模型的隐藏优势; 校准问题来自环境漂移,不是模型本身——时间切分下 ECE 从 0.0009 飙到 0.0904,模型一个字没改; 校准的前提是校准集代表部署分布——场景C里错误校准集把 ECE 从 0.0904 推到 0.0975,越校越糟。
下次有人跟你说"模型概率不准,加个 Platt",先问一句:你的部署分布和训练分布一样吗?校准集是从部署期取的吗?——两个都答不上来,那个 Platt 大概率是白干,甚至帮倒忙。
边界声明:以上数字在 LendingClub 2,257,017 笔样本(剔缺失/异常,坏账口径 Charged Off/Default)上测得;分箱边界、特征选择、切分方式不同,具体 ECE 会变,但"同分布天然校准、漂移破坏校准、错误校准集帮倒忙"三个规律不变。
关键要点:校准 = 预测概率与实际频率的差(ECE/Brier 可靠性项);逻辑回归天然校准(proper scoring rule);校准问题来自环境漂移;校准集必须代表部署分布;评分卡上线后每季度滚动校准。
代码与数据:本文所有代码可复现,数据来自 LendingClub 公开数据集(2007-2018Q4)。完整脚本留档在文章同目录 gen_figures.py。