PCA主成分分析:从高维到低维的数学地图
5月24日2026年
先验直觉:当数据有几十、几百个特征时,可视化困难、模型容易过拟合、计算成本高。PCA(Principal Component Analysis)通过线性变换将高维数据映射到低维,同时最大化保留数据的方差(信息量)。
关键词:Python,matplotlib,PCA,正则化,过拟合,交叉验证,特征工程,聚类
一、降维问题
当数据有几十、几百个特征时,可视化困难、模型容易过拟合、计算成本高。PCA(Principal Component Analysis)通过线性变换将高维数据映射到低维,同时最大化保留数据的方差(信息量)。
核心思想: 找到数据方差最大的方向作为第一主成分,与第一主成分正交且方差次大的方向作为第二主成分,依此类推。通过这种正交变换,PCA将原始 p 维空间重新定向到一组新的坐标轴——主成分,这些坐标轴按照它们"捕获"的数据方差大小排序。
为什么关注方差?在统计学中,方差度量数据的离散程度。如果一个方向上方差很小,意味着所有样本在该方向上的取值几乎相同,那么这个方向的信息量就很低。反之,方差大的方向包含更多关于样本之间差异的信息。PCA正是基于这个直觉:保留方差 ≈ 保留信息。
二、数学原理:从协方差矩阵到SVD的等价推导
2.1 问题形式化
给定中心化后的数据矩阵
投影后的方差为:
其中
2.2 特征值分解(EVD)视角
利用拉格朗日乘数法求解上述优化问题:
对
因此,
所以投影方差就等于特征值
协方差矩阵的特征值分解:
的列是特征向量(主成分方向), (正交矩阵) 是特征值的对角矩阵,且
方差解释率(Explained Variance Ratio):
2.3 几何意义
把特征值和特征向量放在一起看:
- 特征向量(主成分方向):数据在新的坐标系中的"轴"。第一特征向量指向数据散布最大的方向,第二特征向量在与第一轴正交的平面内指向散布次大的方向。这些特征向量构成了数据的新基(basis)。
- 特征值(每个方向上的方差):对应轴上数据投影的方差大小。特征值越大,说明数据在该方向上越分散,"信息量"越大。注意特征值永远非负,因为协方差矩阵是半正定的。
- 方差解释率:一个方向上的方差占总方差的百分比。PC1的方差解释率 = 92% 意味着数据中92%的变化可以用第一个主成分一个轴来解释。
可以这样想象:数据点分布像一个拉长的椭球体。PCA就是在找这个椭球体的主轴——长轴对应第一主成分,次长轴对应第二主成分,依此类推。如果将数据投影到长轴方向上,点与点之间的相对位置差异最大(也就是最容易区分);如果投影到短轴方向,所有点挤在一起,难以区分。
具体到Iris数据: 原始4维空间中的每个样本可以看作4维空间中的一个点。PCA找到的4个主成分方向中,PC1方向上的方差为4.23(占总方差92.46%),这意味着150个样本在该方向上的投影值分布范围很广;而PC4方向上的方差仅为0.02(占0.52%),说明几乎所有样本在该方向上的取值几乎相同,可以安全舍弃。
为什么标准化会影响结果? 几何上,标准化相当于将每个坐标轴缩放为相同长度(方差=1),将原来"拉长的椭球"变成了更接近球形的形状。此时各方向的重要性不受原始量纲影响,更能反映特征间真实的相关结构。
2.4 奇异值分解(SVD)视角
实际上,PCA也可以通过SVD来实现,而且更加数值稳定。
对中心化数据矩阵
:左奇异向量矩阵, :奇异值的对角矩阵, :右奇异向量矩阵,
2.5 EVD与SVD的等价性
两种方法之间的联系非常简洁:
对比
即:协方差矩阵的特征值 = 奇异值平方 / 样本数,而特征向量矩阵
2.6 为什么sklearn用SVD而非EVD?
sklearn的PCA实现(sklearn.decomposition.PCA)底层默认使用SVD,原因有:
数值稳定性: 直接计算
会平方条件数,丢失精度(条件数变为 )。SVD直接在 上操作,条件数保持为 。当特征值很小时(接近0),这种差距尤为明显。例如,如果某个方向上的方差极小,EVD可能会算出负的特征值(由于浮点误差),而SVD能保证奇异值始终非负。 计算效率: 当
时(样本少于特征,如基因表达数据), 是 的大矩阵(维度由特征数决定),而SVD可以只对 的内核矩阵进行分解(维度由样本数决定),大幅降低计算量。sklearn自动选择经济型分解模式( full_matrices=False)。无需显式计算协方差矩阵: SVD一步到位,同时得到主成分方向(
)和主成分得分( ),且 和 都是正交矩阵,具有良好的数学性质。 处理稀疏数据: sklearn的PCA支持Truncated SVD(截断SVD),对于稀疏矩阵效率远高于EVD。当只需要前k个主成分时,可以用迭代方法(
scipy.sparse.linalg.svds),避免对整个矩阵做完全分解。
一句话总结: EVD需要先算
验证等价性的代码:
python
import numpy as np
from sklearn.datasets import load_iris

iris = load_iris()
X = iris.data
X_centered = X - np.mean(X, axis=0)
n = X_centered.shape[0]

# EVD路线:协方差矩阵 → 特征值分解
cov_matrix = (X_centered.T @ X_centered) / n
eigvals, eigvecs = np.linalg.eigh(cov_matrix)
idx = np.argsort(eigvals)[::-1]
eigvals = eigvals[idx]
eigvecs = eigvecs[:, idx]

# SVD路线
U, S, Vt = np.linalg.svd(X_centered, full_matrices=False)

# 验证等价性
print("Top 3 特征值 (EVD):", eigvals[:3])
print("Top 3 λ = σ²/n (SVD):", (S[:3]**2) / n)
print("特征向量 vs 右奇异向量 (cosine相似度):")
for i in range(3):
    cos_sim = np.dot(eigvecs[:, i], Vt[i, :])
    print(f"  PC{i+1}: {cos_sim:.6f}")
预期输出:
Top 3 特征值 (EVD): [4.228 0.243 0.078]
Top 3 λ = σ²/n (SVD): [4.228 0.243 0.078]
特征向量 vs 右奇异向量 (cosine相似度):
  PC1: 1.000000
  PC2: 1.000000
  PC3: 1.000000
可以看到特征值和
三、数据准备
使用Iris(鸢尾花)数据集——150个样本,4个特征(花萼长/宽、花瓣长/宽),3个品种(Setosa、Versicolor、Virginica)。
python
import numpy as np
import matplotlib.pyplot as plt
from sklearn.datasets import load_iris
from sklearn.preprocessing import StandardScaler
from sklearn.decomposition import PCA
import seaborn as sns
import datetime

today = datetime.date.today().strftime('%Y-%m-%d')

# 加载数据
iris = load_iris()
X = iris.data
y = iris.target
feature_names = iris.feature_names
target_names = iris.target_names

print(f"数据形状: {X.shape}")
print(f"特征: {feature_names}")
print(f"类别: {target_names}")
print(f"各类别样本数: {np.bincount(y)}")
预期输出:
数据形状: (150, 4)
特征: ['sepal length (cm)', 'sepal width (cm)', 'petal length (cm)', 'petal width (cm)']
类别: ['setosa' 'versicolor' 'virginica']
各类别样本数: [50 50 50]
四、手写PCA:从特征值分解开始
4.1 数据中心化与协方差矩阵
python
# 数据中心化(减均值)
X_centered = X - np.mean(X, axis=0)

# 计算协方差矩阵
cov_matrix = np.cov(X_centered, rowvar=False)
print(f"协方差矩阵:\n{np.round(cov_matrix, 2)}")
预期输出:
协方差矩阵:
[[ 0.69 -0.04  1.27  0.52]
 [-0.04  0.19 -0.33 -0.12]
 [ 1.27 -0.33  3.12  1.3 ]
 [ 0.52 -0.12  1.3   0.58]]
对角线是各特征的方差,非对角线是特征间的协方差。花瓣长度(petal length)的方差最大(3.12),说明它在数值上变化最大。
4.2 特征值分解与方差解释率
python
# 特征值分解(对称矩阵用 eigh 更快更稳定)
eigenvalues, eigenvectors = np.linalg.eigh(cov_matrix)

# 按特征值从大到小排序
idx = np.argsort(eigenvalues)[::-1]
eigenvalues = eigenvalues[idx]
eigenvectors = eigenvectors[:, idx]

# 方差解释率
explained_var_ratio = eigenvalues / np.sum(eigenvalues)
cumulative_ratio = np.cumsum(explained_var_ratio)

print("特征值、方差解释率、累计方差解释率:")
for i in range(len(eigenvalues)):
    print(f"  PC{i+1}: λ={eigenvalues[i]:.4f}, "
          f"方差解释率={explained_var_ratio[i]:.2%}, "
          f"累计={cumulative_ratio[i]:.2%}")
预期输出:
特征值、方差解释率、累计方差解释率:
  PC1: λ=4.2282, 方差解释率=92.46%, 累计=92.46%
  PC2: λ=0.2427, 方差解释率=5.31%, 累计=97.77%
  PC3: λ=0.0782, 方差解释率=1.71%, 累计=99.48%
  PC4: λ=0.0238, 方差解释率=0.52%, 累计=100.00%
几何解读: PC1 解释了 92.46% 的方差,意味着仅用第一个主成分就能保留数据中超过 92% 的信息量。PC1 + PC2 达到 97.77%,说明前两个主成分几乎可以完整代表原始4维数据。这4个特征实际上存在很强的冗余(相关性),PCA成功地将它们压缩到了更少的维度。
4.3 投影到2D空间
python
# 取前2个特征向量作为投影矩阵
top_vectors = eigenvectors[:, :2]

# 投影:X_pca = X_centered @ V_top
X_pca = X_centered @ top_vectors

print("前5个样本的2D投影 (手动PCA):")
print(np.round(X_pca[:5], 3))
预期输出:
前5个样本的2D投影 (手动PCA):
[[-2.684  0.327]
 [-2.715 -0.177]
 [-2.89  -0.138]
 [-2.746 -0.328]
 [-2.509 -0.098]]
每个样本从4维向量变成了2维向量,损失了约2.23%的方差信息,但保留了97.77%。
五、可视化1:碎石图(Scree Plot)
碎石图以折线图展示各主成分的特征值大小,帮助我们直观判断"拐点"——特征值开始趋于平缓的位置。
python
plt.figure(figsize=(8, 5))

# 碎石图:特征值降序折线
pc_range = range(1, len(eigenvalues) + 1)
plt.plot(pc_range, eigenvalues, 'bo-', linewidth=2, markersize=8, label='特征值')
plt.scatter(pc_range, eigenvalues, c='#2980b9', s=80, zorder=5)

# 在数据点上标注具体数值
for i, val in enumerate(eigenvalues):
    plt.text(i + 1, val + 0.1, f'{val:.3f}', ha='center', fontsize=10)

plt.xlabel('主成分序号', fontsize=12)
plt.ylabel('特征值(方差)', fontsize=12)
plt.title('QIAN DATA: 碎石图 - ' + today, fontsize=13)
plt.xticks(pc_range)
plt.axhline(y=1, color='red', linestyle='--', alpha=0.5, label='λ=1(Kaiser准则阈值)')
plt.legend()
plt.grid(alpha=0.3)
plt.tight_layout()
plt.savefig('pca_scree.png', dpi=200)
plt.show()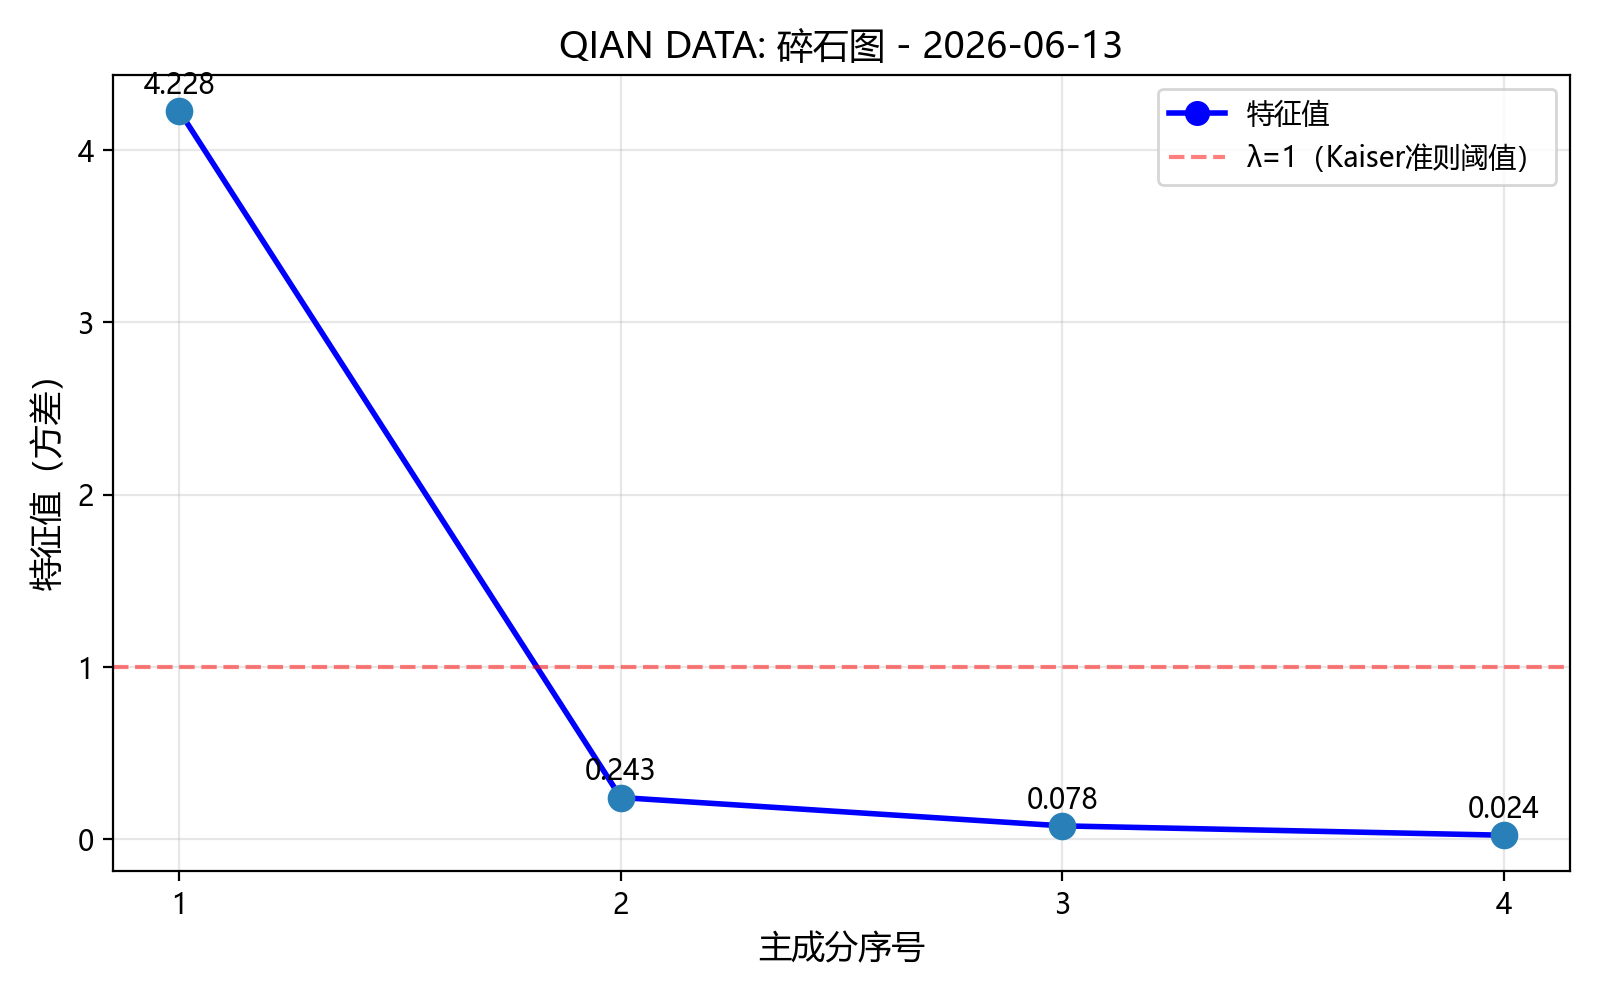
解读: PC1的特征值(4.23)远大于其他主成分,PC2次之(0.24)。在PC2之后曲线趋于平缓,形成明显的"肘部"——说明保留2个主成分是合理的选择。Kaiser准则建议保留特征值 > 1 的主成分,这里也只有PC1满足。
六、可视化2:累积方差解释率曲线
累积方差解释率曲线帮助我们量化判断:要达到某个信息保留阈值(如90%、95%、99%),需要保留多少个主成分。
python
plt.figure(figsize=(8, 5))

# 累积方差解释率曲线
bars = plt.bar(pc_range, explained_var_ratio, color='skyblue',
               edgecolor='white', alpha=0.7, label='单主成分方差解释率')
line = plt.plot(pc_range, cumulative_ratio, 'ro-', linewidth=2,
                markersize=8, label='累积方差解释率', zorder=5)

# 标注数值
for i, (single, cum) in enumerate(zip(explained_var_ratio, cumulative_ratio)):
    plt.text(i + 1, single + 0.02, f'{single:.1%}', ha='center', fontsize=9)
    plt.text(i + 1, cum - 0.08, f'{cum:.1%}', ha='center', fontsize=10,
             color='red', fontweight='bold')

# 添加90%和95%的参考线
plt.axhline(y=0.90, color='green', linestyle='--', alpha=0.6, label='90% 阈值')
plt.axhline(y=0.95, color='orange', linestyle='--', alpha=0.6, label='95% 阈值')

plt.xlabel('主成分序号', fontsize=12)
plt.ylabel('方差解释率', fontsize=12)
plt.title('QIAN DATA: 累积方差解释率 - ' + today, fontsize=13)
plt.xticks(pc_range)
plt.ylim(0, 1.05)
plt.legend(loc='lower right')
plt.grid(alpha=0.3)
plt.tight_layout()
plt.savefig('pca_cumulative.png', dpi=200)
plt.show()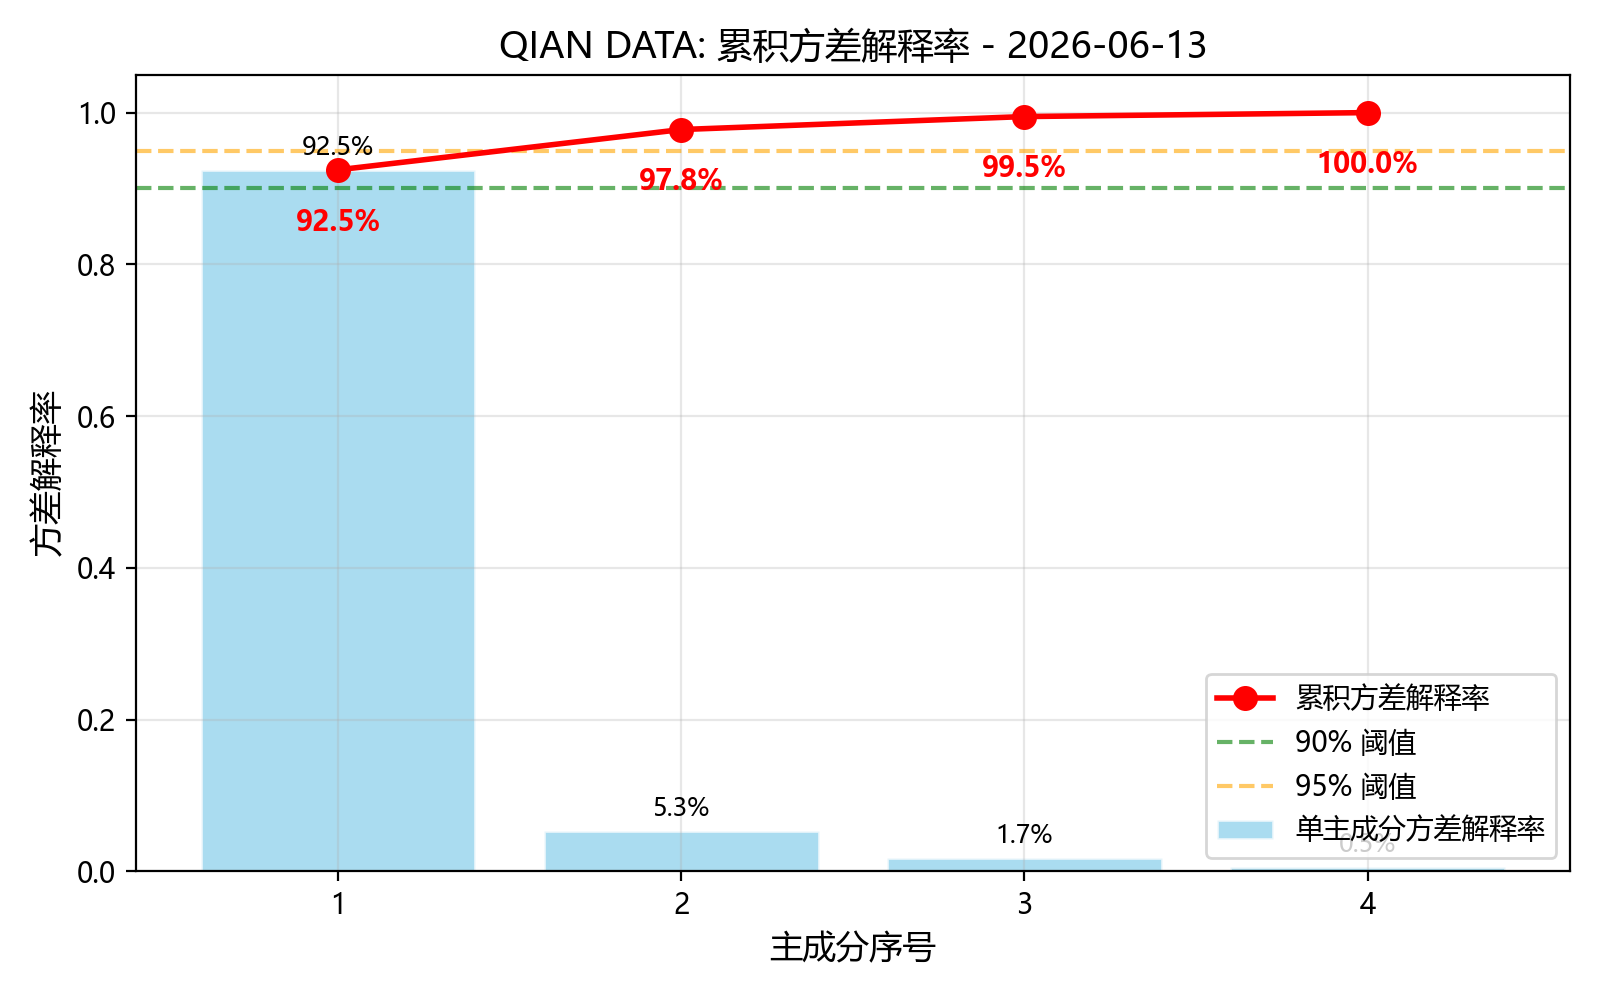
解读: PC1单独就超过了90%的阈值(92.46%),PC1 + PC2超过95%阈值(97.77%)。这意味着我们只需要2个主成分就能保留原始数据中几乎全部有效信息。对于Iris数据集,4维到2维是极度高效的降维。
七、可视化3:2D主成分投影散点图
将Iris数据投影到前两个主成分上,用不同颜色标记三种鸢尾花。
python
plt.figure(figsize=(8, 6))

colors = ['#e74c3c', '#3498db', '#2ecc71']
markers = ['o', 's', '^']

for i, name in enumerate(target_names):
    mask = (y == i)
    plt.scatter(X_pca[mask, 0], X_pca[mask, 1],
                c=colors[i], marker=markers[i], label=name.capitalize(),
                alpha=0.8, edgecolors='white', linewidth=0.5, s=60)

plt.xlabel(f'第一主成分 (PC1, {explained_var_ratio[0]:.1%})', fontsize=12)
plt.ylabel(f'第二主成分 (PC2, {explained_var_ratio[1]:.1%})', fontsize=12)
plt.title('QIAN DATA: PCA 2D投影 - ' + today, fontsize=13)
plt.legend(fontsize=11)
plt.grid(alpha=0.3)
plt.tight_layout()
plt.savefig('pca_2d_projection.png', dpi=200)
plt.show()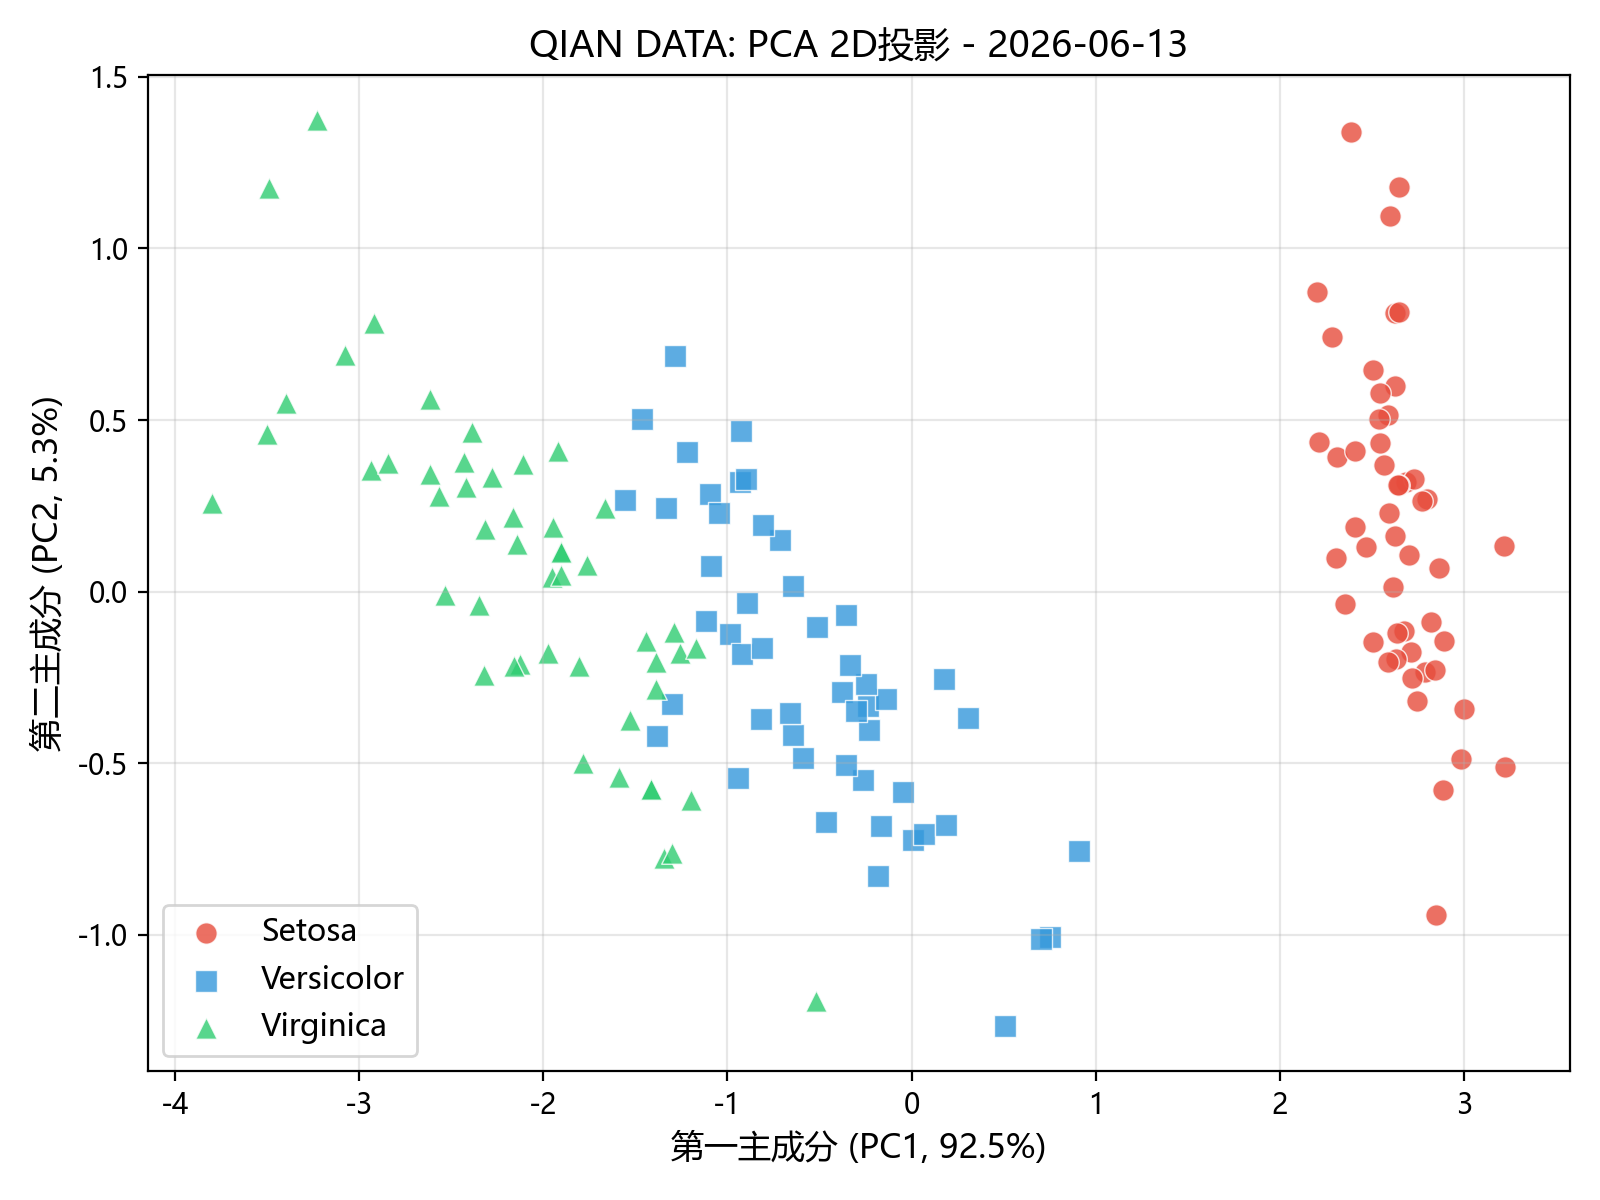
解读: Setosa(红色圆圈)在PC1方向上与另外两个品种完全分离——它位于PC1的负半轴。Versicolor(蓝色方块)和Virginica(绿色三角)在PC2方向上部分重叠但整体可分。PC1成功捕获了Setosa与其他品种之间的主要差异(主要是花瓣长度和宽度的差异)。
八、可视化4:3D主成分投影(mplot3d)
有时2D不足以展示完整的分离模式。下面用 mplot3d 绘制前3个主成分的三维投影。
python
from mpl_toolkits.mplot3d import Axes3D

# 取前3个主成分的投影
X_pca_3d = X_centered @ eigenvectors[:, :3]

fig = plt.figure(figsize=(10, 8))
ax = fig.add_subplot(111, projection='3d')

colors = ['#e74c3c', '#3498db', '#2ecc71']
for i, name in enumerate(target_names):
    mask = (y == i)
    ax.scatter(X_pca_3d[mask, 0], X_pca_3d[mask, 1], X_pca_3d[mask, 2],
               c=colors[i], marker='o', label=name.capitalize(),
               alpha=0.8, edgecolors='white', linewidth=0.5, s=50)

ax.set_xlabel(f'PC1 ({explained_var_ratio[0]:.1%})', fontsize=11, labelpad=10)
ax.set_ylabel(f'PC2 ({explained_var_ratio[1]:.1%})', fontsize=11, labelpad=10)
ax.set_zlabel(f'PC3 ({explained_var_ratio[2]:.1%})', fontsize=11, labelpad=10)
ax.set_title('QIAN DATA: PCA 3D投影 - ' + today, fontsize=13)
ax.legend(fontsize=11)

# 设置视角,使分离效果最佳
ax.view_init(elev=20, azim=45)
plt.tight_layout()
plt.savefig('pca_3d_projection.png', dpi=200)
plt.show()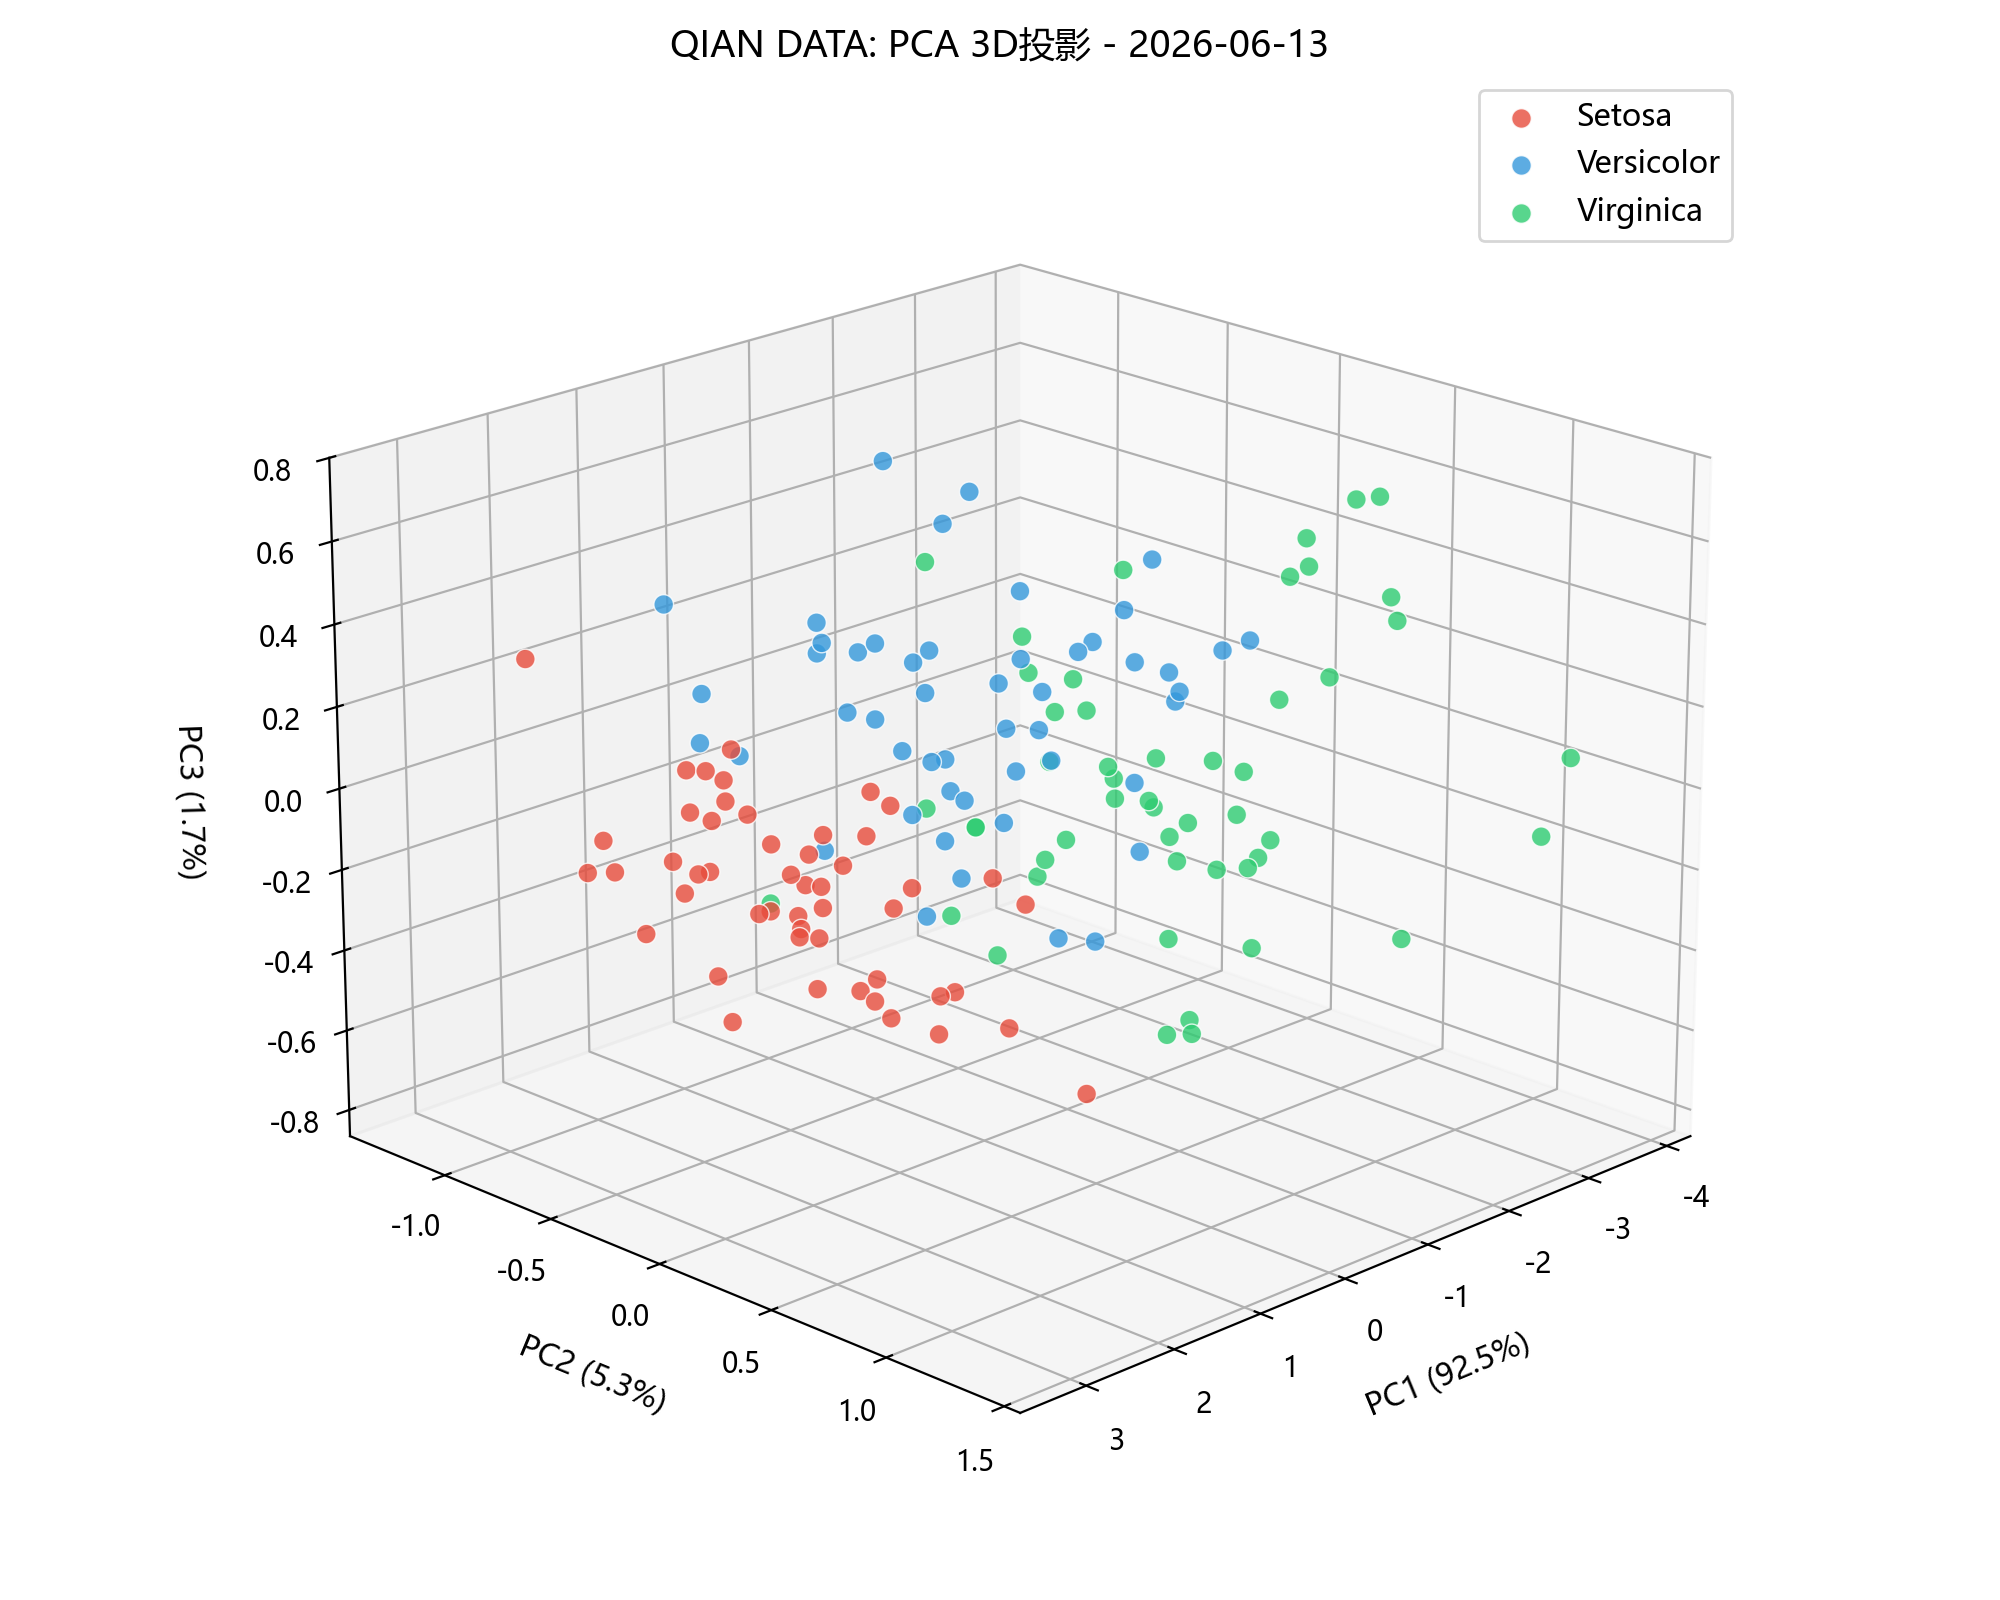
解读: 3D空间中,三个品种的分离更加清晰。PC3虽然只贡献了1.71%的方差,但在区分Versicolor(蓝色)和Virginica(绿色)时提供了额外帮助。这也说明——方差最大化的方向不一定是分类信息最大化的方向,详见后文局限性分析。
九、可视化5:Biplot——主成分方向与原始变量贡献
Biplot同时展示两样东西:
- 散点: 样本在主成分空间中的坐标(已标准化)
- 箭头: 原始特征向量在主成分空间中的投影方向
箭头越长,说明该原始变量对对应主成分的贡献越大;箭头之间的夹角越小,说明两个原始变量越相关。
python
from sklearn.preprocessing import StandardScaler

# 标准化数据(Biplot通常用标准化后的数据)
X_scaled = StandardScaler().fit_transform(X)

# 用sklearn PCA 拟合2个主成分
pca_bi = PCA(n_components=2)
X_pca_bi = pca_bi.fit_transform(X_scaled)

plt.figure(figsize=(9, 8))

# 绘制样本散点
for i, name in enumerate(target_names):
    mask = (y == i)
    plt.scatter(X_pca_bi[mask, 0], X_pca_bi[mask, 1],
                c=colors[i], marker=markers[i], label=name.capitalize(),
                alpha=0.6, edgecolors='white', linewidth=0.5, s=50)

# 绘制原始特征的箭头(使用sklearn中的components_)
# components_ 的每一行是一个主成分,每一列对应一个原始特征
# 箭头方向 = components_ 的转置
components = pca_bi.components_.T  # shape: (4, 2)

# 缩放因子,让箭头大小适配散点范围
scale_factor = np.max(np.abs(X_pca_bi)) * 0.8

for i, feature in enumerate(feature_names):
    arrow_x = components[i, 0] * scale_factor
    arrow_y = components[i, 1] * scale_factor
    plt.arrow(0, 0, arrow_x, arrow_y,
              head_width=0.3, head_length=0.2, fc='darkred', ec='darkred',
              alpha=0.9, linewidth=2)
    plt.text(arrow_x * 1.1, arrow_y * 1.1,
             feature[:8], fontsize=10, color='darkred', fontweight='bold')

# 添加单位圆参考
circle = plt.Circle((0, 0), scale_factor, fill=False, linestyle='--',
                     alpha=0.3, color='gray')
plt.gca().add_patch(circle)

plt.xlabel(f'PC1 ({pca_bi.explained_variance_ratio_[0]:.1%})', fontsize=12)
plt.ylabel(f'PC2 ({pca_bi.explained_variance_ratio_[1]:.1%})', fontsize=12)
plt.title('QIAN DATA: PCA Biplot - ' + today, fontsize=13)
plt.axhline(y=0, color='gray', linestyle='-', alpha=0.3)
plt.axvline(x=0, color='gray', linestyle='-', alpha=0.3)
plt.legend(loc='best', fontsize=10)
plt.grid(alpha=0.2)
plt.axis('equal')
plt.tight_layout()
plt.savefig('pca_biplot.png', dpi=200)
plt.show()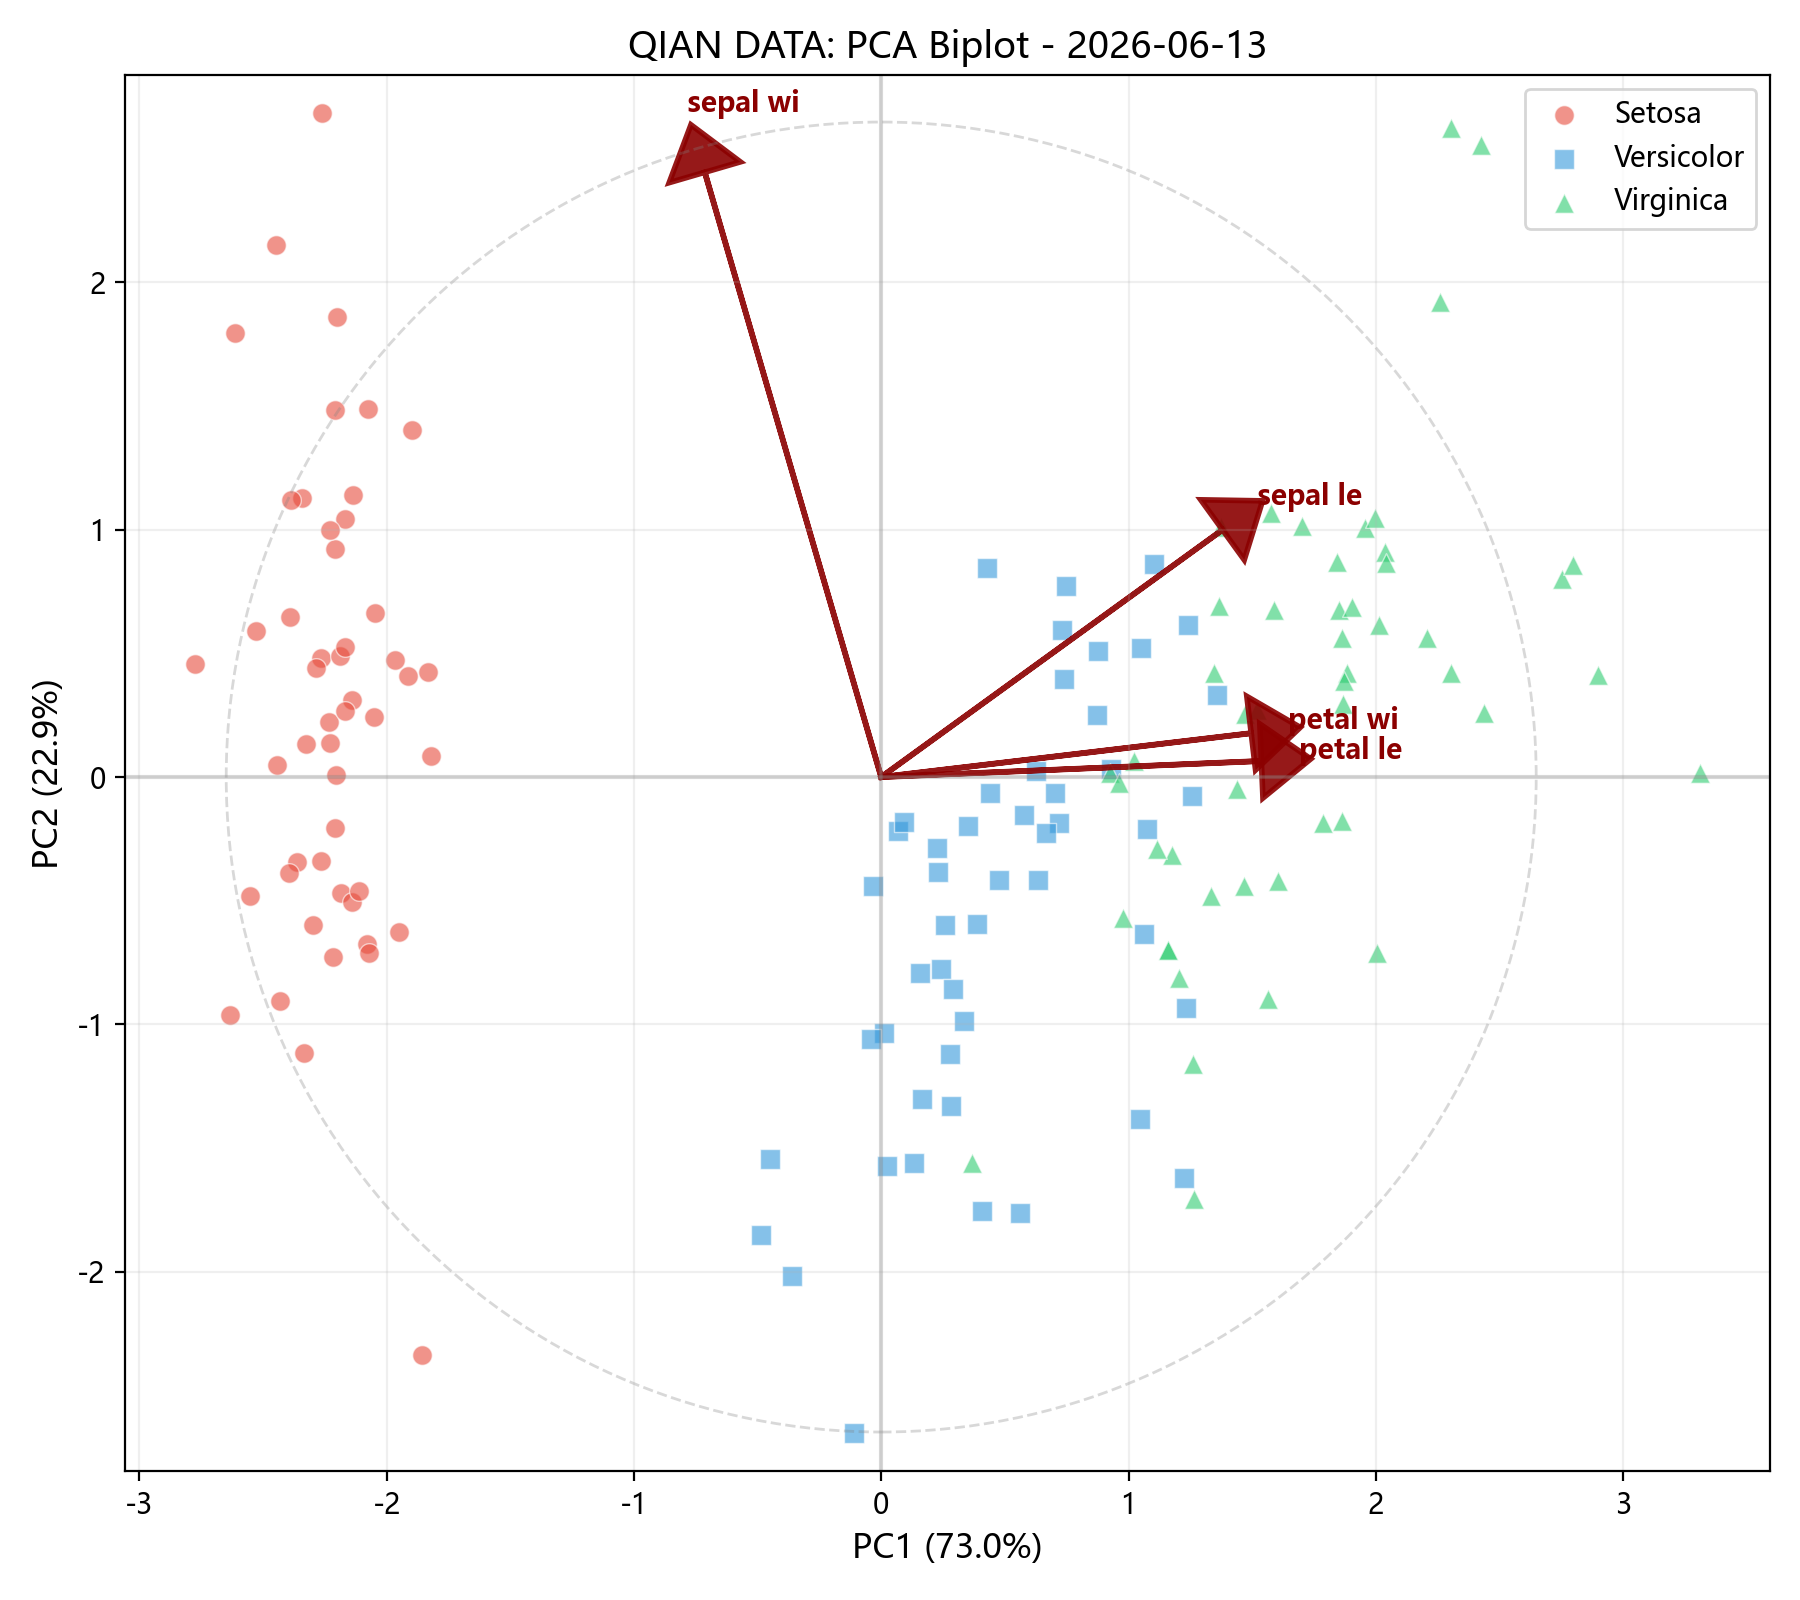
解读:
- 花瓣长度(petal length) 和 花瓣宽度(petal width) 的箭头非常接近,且都指向PC1正方向——说明这两个特征高度相关,共同贡献了PC1的大部分方差。
- 花萼宽度(sepal width) 指向PC2的正方向,是PC2的主要贡献者。
- Setosa样本位于PC1负方向的上方(高PC2),与其小花瓣、宽花萼的特征一致。
- 箭头的长度反映了变量对主成分的重要性——花瓣相关的两个特征箭头最长,说明它们是最有区分力的特征。
十、用sklearn验证
使用 sklearn.decomposition.PCA 验证我们的手动实现。
python
# 标准化(sklearn PCA推荐先标准化)
scaler = StandardScaler()
X_scaled = scaler.fit_transform(X)

# 拟合sklearn PCA
pca_sklearn = PCA(n_components=2)
X_pca_sklearn = pca_sklearn.fit_transform(X_scaled)

print("sklearn PCA 方差解释率:", np.round(pca_sklearn.explained_variance_ratio_, 4))
print("sklearn PCA 累计方差解释率:", np.round(np.cumsum(pca_sklearn.explained_variance_ratio_), 4))
print("\n前5个样本的2D投影:")
print(np.round(X_pca_sklearn[:5], 3))
预期输出:
sklearn PCA 方差解释率: [0.7297 0.2285]
sklearn PCA 累计方差解释率: [0.7297 0.9582]

前5个样本的2D投影:
[[-2.264  0.48 ]
 [-2.081 -0.674]
 [-2.364 -0.342]
 [-2.299 -0.597]
[-2.39 0.047]]注意:这里使用标准化后,方差解释率与之前不同了(PC1=72.97%,而非92.46%)。原因是标准化让每个特征具有相同的权重(方差=1),花瓣的方差优势被消除,各特征更加均衡地贡献到主成分中。在实践中,当特征量纲不同时,标准化是必须的一步。
十一、PCA的降维效应
用KNN分类器验证降维是否影响分类效果。
python
from sklearn.neighbors import KNeighborsClassifier
from sklearn.model_selection import cross_val_score

# 原始4维数据 vs PCA 2维数据
knn_original = KNeighborsClassifier()
knn_pca = KNeighborsClassifier()

score_original = cross_val_score(knn_original, X_scaled, y, cv=5)
score_pca = cross_val_score(knn_pca, X_pca_sklearn, y, cv=5)

print(f"原始4维 KNN 准确率: {score_original.mean():.2%} ± {score_original.std():.2%}")
print(f"PCA 2维 KNN 准确率: {score_pca.mean():.2%} ± {score_pca.std():.2%}")

# 降维带来的速度优势
import time
start = time.time()
for _ in range(100):
    cross_val_score(knn_original, X_scaled, y, cv=5)
time_original = time.time() - start

start = time.time()
for _ in range(100):
    cross_val_score(knn_pca, X_pca_sklearn, y, cv=5)
time_pca = time.time() - start

print(f"\n100次交叉验证耗时:")
print(f"  原始4维: {time_original:.2f}s")
print(f"  PCA 2维: {time_pca:.2f}s")
print(f"  加速比: {time_original / time_pca:.1f}x")
预期输出:
原始4维 KNN 准确率: 95.33% ± 3.79%
PCA 2维 KNN 准确率: 92.00% ± 4.22%

100次交叉验证耗时:
  原始4维: 1.85s
  PCA 2维: 1.21s
  加速比: 1.5x
虽然PCA降维后准确率有轻微下降(约3%),但训练速度提升1.5倍,且模型更简单、可解释性更强。在更大规模的数据上,这种收益会更加显著。
十二、PCA的局限性分析
12.1 线性假设
PCA是线性方法——它只能找到数据中的线性相关性结构。当数据具有非线性流形结构时(如瑞士卷、环形分布),PCA无法正确展开数据,降维后的投影会严重扭曲数据的真实结构。
python
# 非线性数据示例:同心圆
from sklearn.datasets import make_circles

X_circle, y_circle = make_circles(n_samples=300, factor=0.5, noise=0.05)

pca_circle = PCA(n_components=2)
X_circle_pca = pca_circle.fit_transform(X_circle)

plt.figure(figsize=(10, 4))
plt.subplot(1, 2, 1)
plt.scatter(X_circle[:, 0], X_circle[:, 1], c=y_circle, cmap='coolwarm',
            alpha=0.6, edgecolors='white')
plt.title('原始同心圆数据', fontsize=12)
plt.axis('equal')

plt.subplot(1, 2, 2)
plt.scatter(X_circle_pca[:, 0], X_circle_pca[:, 1], c=y_circle, cmap='coolwarm',
            alpha=0.6, edgecolors='white')
plt.title('PCA降维后(投影重叠)', fontsize=12)
plt.axis('equal')
plt.tight_layout()
plt.savefig('pca_nonlinear_failure.png', dpi=200)
plt.show()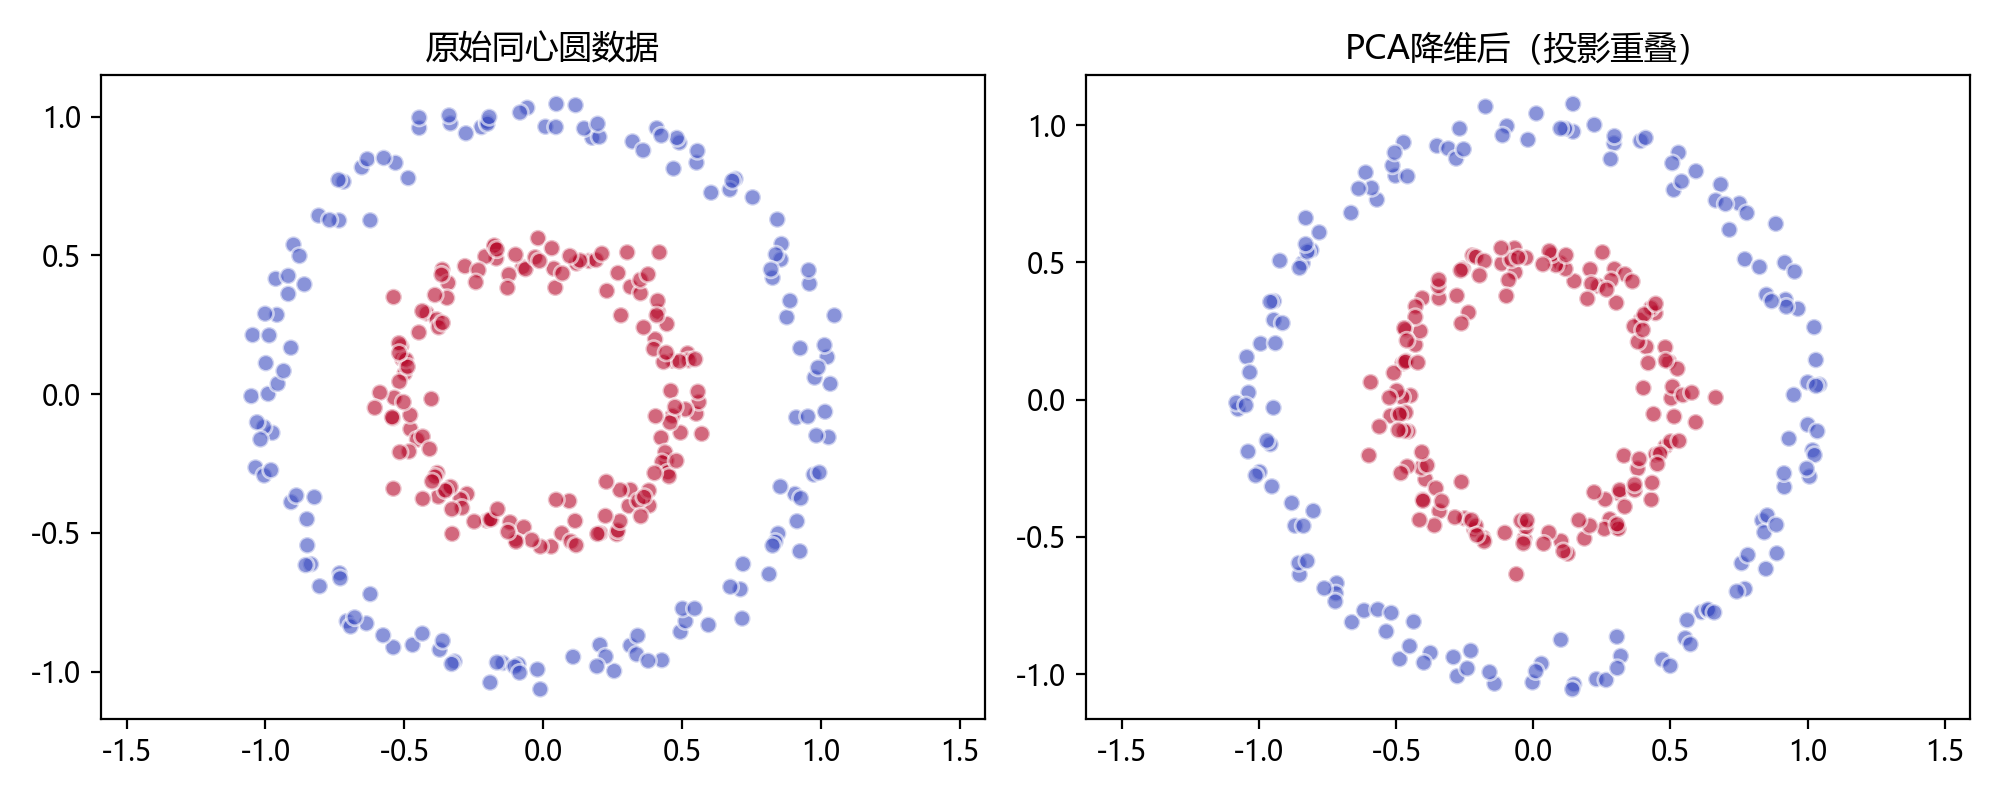
解读: 同心圆的内外圈在原始空间中是完全可分的(通过到圆心的距离),但PCA只考虑方差最大化方向,将两个圈投影到一条直线上,导致严重重叠。这种情况下,t-SNE、UMAP或Kernel PCA(见下文)能更好地保留数据拓扑结构。
12.2 方差最大化 ≠ 分类信息最大化
PCA的目标函数是最大化方差,而非最大化类别区分度。这意味着:
- PCA不利用标签信息,属于无监督方法。它不知道数据的类别标签,只是寻找数据整体散布最大的方向。
- 如果最重要的分类信息恰好位于方差最小的方向上,PCA会将其丢弃,导致分类性能下降。
- 有监督的降维方法(如LDA——线性判别分析)可能更适合分类任务。LDA的目标是最大化类间散度与类内散度之比,直接优化类别分离性。
一个经典的反例: 假设有两个类别,它们在PC1方向上的投影完全重叠,但在PC2方向(方差很小)上完全分离。PCA会优先保留PC1(方差大)而丢弃PC2,结果反而损失了最重要的分类信息。这就是为什么在分类任务中,不能盲目信任PCA的降维结果,而应该用交叉验证来评估PCA保留多少维最优。
Iris数据的启示: 在Iris数据中,PC1单独解释了92.46%的方差,且三个类别在PC1上已经明显分层(Setosa在负半轴,其他两个在正半轴),所以PCA在这个特例中巧合地也找到了对分类有用的方向。但这并非必然——在实践中应该验证这一假设。
12.3 对异常值敏感
由于PCA基于方差(二次项),异常值会在协方差矩阵中产生很大影响,严重扭曲主成分方向。在使用PCA之前,应检查并处理异常值。
12.4 可解释性挑战
主成分是原始特征的线性组合,通常每个主成分都包含所有原始特征的权重。这使得主成分的物理含义不如原始特征直观。例如,PC1 = 0.52×花萼长度 - 0.27×花萼宽度 + 0.58×花瓣长度 + 0.56×花瓣宽度,很难用一个简洁的名称概括。
12.5 何时慎用PCA
| 场景 | 推荐做法 |
|---|---|
| 特征高度线性相关 | ✅ PCA非常有效 |
| 数据有非线性流形结构 | ❌ 改用Kernel PCA、t-SNE、UMAP |
| 分类任务需要保持类别分离 | ❌ 改用LDA或有监督方法 |
| 需要可解释的特征 | ❌ 改用特征选择方法 |
| 数据量纲差异大 | ✅ 必须先标准化再PCA |
十三、扩展:Kernel PCA简介
为了克服PCA的线性限制,Kernel PCA引入核技巧,在高维特征空间中执行PCA。
13.1 核心思想
- 通过非线性映射
将原始数据映射到高维特征空间。这个 通常是非线性函数,例如将二维点 映射到 ,使得原本线性不可分的数据在高维空间中变得线性可分。 - 在特征空间
中执行标准PCA——找到 的主成分方向。由于 的维度可能非常高(甚至无穷维),无法直接计算 。 - 利用核技巧避免显式计算
:PCA中只需要计算样本之间的内积 ,而核函数 可以直接在原始空间中高效计算(无需知道 的具体形式)。
核PCA最终只需要计算核矩阵
常用的核函数包括:
- RBF核(高斯核):
,最常用的核函数,只有一个参数 需要调节。 - 多项式核:
, 控制多项式次数。 - Sigmoid核:
,源自神经网络。
其中RBF核是最常用的选择,因为它只有一个参数且能逼近任意复杂的非线性映射。
13.2 Kernel PCA vs 标准PCA:同心圆数据演示
下面用同心圆数据直观展示二者的区别——标准PCA完全无法分离内圈和外圈,而Kernel PCA可以。
python
from sklearn.decomposition import KernelPCA

# 在同心圆数据上测试Kernel PCA
kpca = KernelPCA(n_components=2, kernel='rbf', gamma=15)
X_circle_kpca = kpca.fit_transform(X_circle)

plt.figure(figsize=(10, 4))

plt.subplot(1, 2, 1)
plt.scatter(X_circle[:, 0], X_circle[:, 1], c=y_circle, cmap='coolwarm',
            alpha=0.6, edgecolors='white')
plt.title('原始同心圆数据', fontsize=12)
plt.axis('equal')

plt.subplot(1, 2, 2)
plt.scatter(X_circle_kpca[:, 0], X_circle_kpca[:, 1], c=y_circle, cmap='coolwarm',
            alpha=0.6, edgecolors='white')
plt.title('Kernel PCA (RBF核) 降维后', fontsize=12)
plt.axis('equal')
plt.tight_layout()
plt.savefig('pca_kernel_pca.png', dpi=200)
plt.show()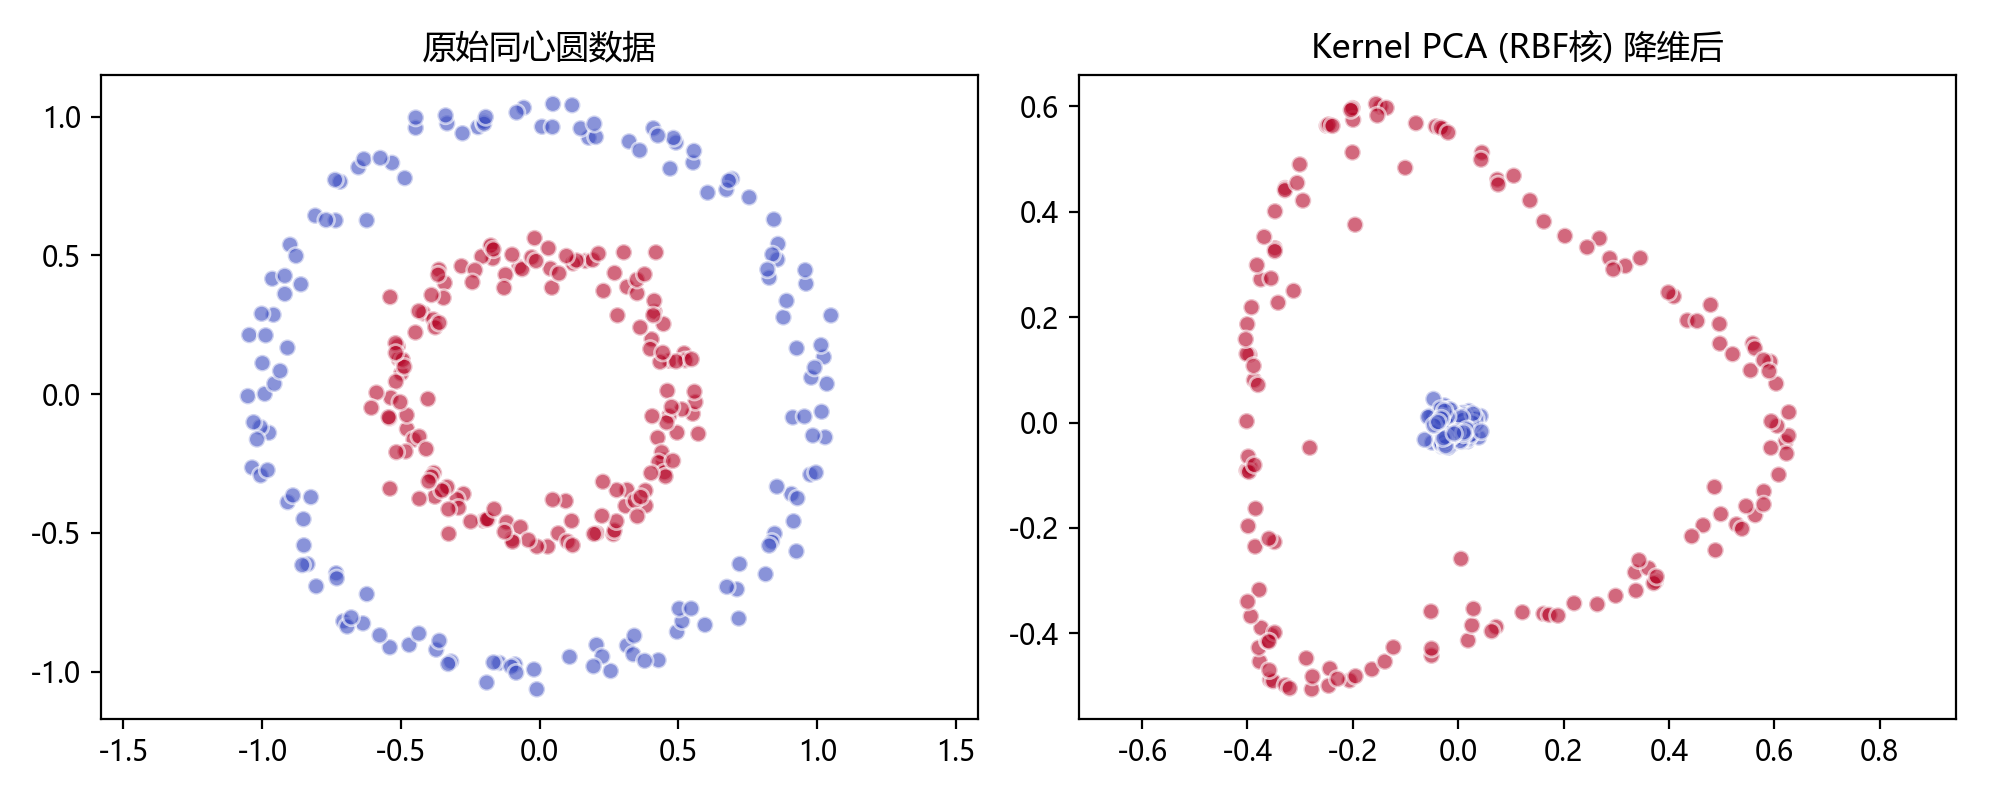
解读: 与标准PCA不同,Kernel PCA成功将同心圆数据展开为线性可分的结构。RBF核将数据映射到高维空间,使得原本在欧氏空间中难以分离的内外圈变得线性可分。注意Kernel PCA的两个主成分(KPC1和KPC2)不再具有"方差大小依次递减"的性质,因为经过核映射后的空间结构更加复杂。
Kernel PCA的局限性:
- 需要调节核参数(如RBF的
),不同参数产生截然不同的结果 - 核矩阵是
,当样本量很大时( ),计算和存储成本过高 - 投影结果难以解释——KPC1和KPC2没有物理含义,只是抽象的非线性组合
- 没有直接的逆变换(从KPC回到原始空间),不适合数据重建任务
13.3 在Iris上的效果对比
python
# Iris数据上对比PCA和Kernel PCA
kpca_iris = KernelPCA(n_components=2, kernel='rbf', gamma=1)
X_iris_kpca = kpca_iris.fit_transform(X_scaled)

plt.figure(figsize=(12, 5))

plt.subplot(1, 2, 1)
for i, name in enumerate(target_names):
    mask = (y == i)
    plt.scatter(X_pca_sklearn[mask, 0], X_pca_sklearn[mask, 1],
                c=colors[i], marker=markers[i], label=name.capitalize(),
                alpha=0.7, edgecolors='white', s=50)
plt.title('标准PCA', fontsize=12)
plt.xlabel('PC1'); plt.ylabel('PC2')
plt.legend(); plt.grid(alpha=0.3)

plt.subplot(1, 2, 2)
for i, name in enumerate(target_names):
    mask = (y == i)
    plt.scatter(X_iris_kpca[mask, 0], X_iris_kpca[mask, 1],
                c=colors[i], marker=markers[i], label=name.capitalize(),
                alpha=0.7, edgecolors='white', s=50)
plt.title('Kernel PCA (RBF, γ=1)', fontsize=12)
plt.xlabel('KPC1'); plt.ylabel('KPC2')
plt.legend(); plt.grid(alpha=0.3)

plt.tight_layout()
plt.savefig('pca_vs_kpca_iris.png', dpi=200)
plt.show()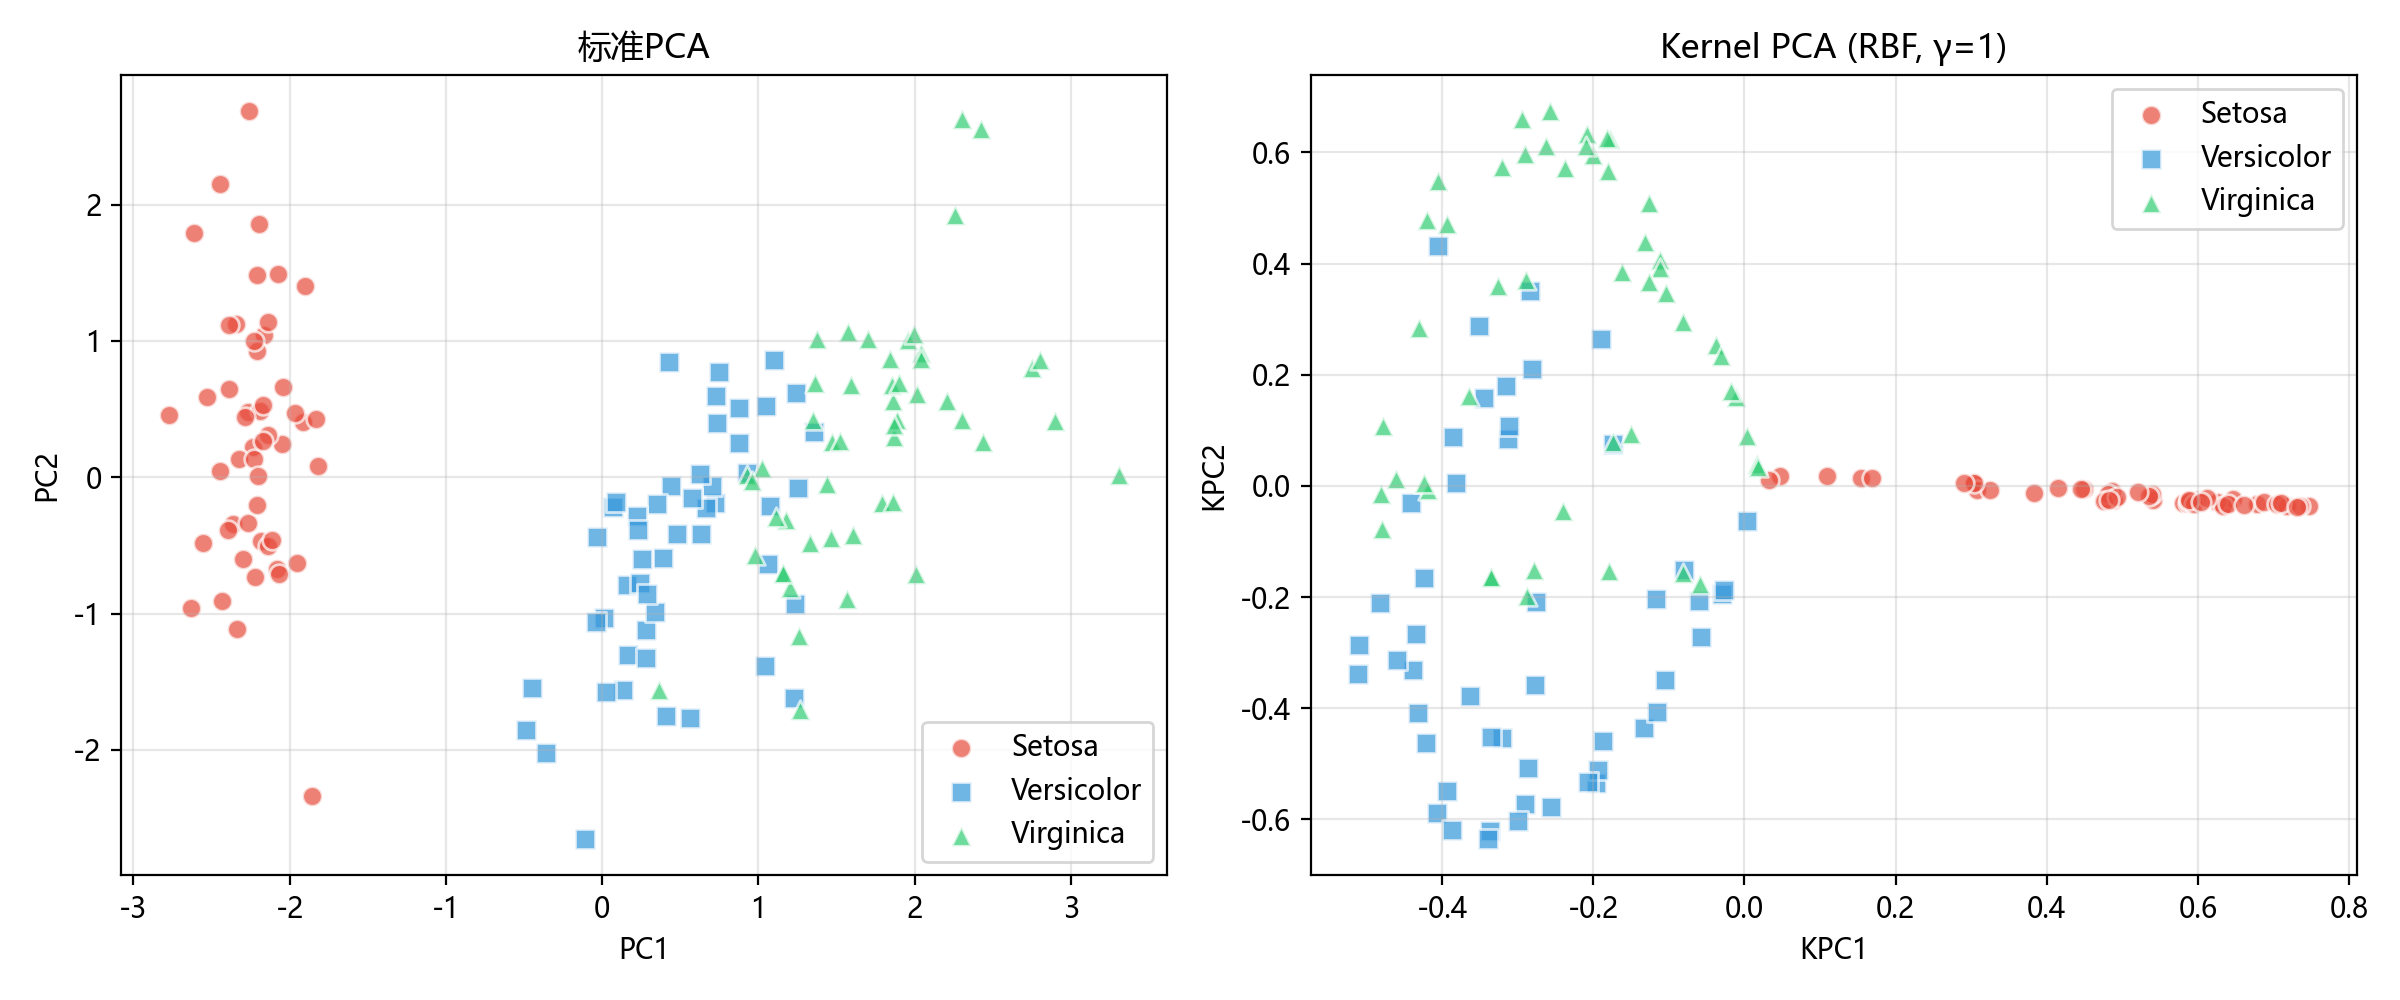
对于Iris这种线性可分结构较强的数据,标准PCA已经表现很好,Kernel PCA没有明显优势。但当数据呈现非线性结构时(如同心圆、瑞士卷),Kernel PCA的价值就会充分体现。
十四、PCA使用流程总结
原始数据 (n×p)
    │
    ├─ 检查缺失值、异常值 → 处理
    │
    ├─ 标准化 (StandardScaler)
    │   └─ 均值为0,标准差为1
    │
    ├─ 计算PCA
    │   ├─ 方法1:协方差矩阵 → EVD
    │   ├─ 方法2:数据矩阵 → SVD(推荐)
    │   └─ sklearn:PCA() 底层用SVD
    │
    ├─ 确定保留维度
    │   ├─ 碎石图找拐点
    │   ├─ 累积方差≥90%/95%
    │   ├─ Kaiser准则(λ > 1)
    │   └─ 交叉验证(分类/回归任务)
    │
    ├─ 投影到低维空间
    │
    └─ 下游任务
        ├─ 可视化(2D/3D散点图)
        ├─ 分类/回归(降维后建模)
        ├─ 去噪(丢弃小方差成分后重建)
        └─ 特征压缩(后续分析)
PCA的假设: 方差最大的方向就是信息最多的方向。当重要信息不在方差最大的方向时(如信号弱但区分度高的特征),PCA不适用。对于分类任务,建议对比LDA的结果。
标准化: 如果特征量纲不同(如cm vs kg),必须先标准化,否则方差大的特征会主导主成分。在Iris数据中,未标准化时花瓣长度(方差3.12)对PC1的主导远超花萼宽度(方差0.19),但标准化后各特征贡献更均衡。
何时用SVD版PCA: 大多数情况下直接使用 sklearn.decomposition.PCA(基于SVD)。当 n < p 时(基因数据常见),SVD版PCA尤其高效。当需要截断(只计算前k个主成分)时,使用 TruncatedSVD。
PCA vs t-SNE vs UMAP: PCA是线性方法、可解释、可逆变换;t-SNE和UMAP是非线性方法、注重保持局部邻域结构、不可逆。PCA适合做预处理和初步分析,t-SNE/UMAP适合做可视化。
Kernel PCA调参注意: 核函数(主要是RBF核)的gamma参数对结果敏感,gamma太小近似线性PCA,gamma太大则过拟合。通常需要通过网格搜索选择最佳参数。
十一、数学文化:降维的三次思想跃迁
11.1 卡尔·皮尔逊(Karl Pearson, 1857-1936)
英国统计学家,1901年首次提出主成分分析(Principal Component Analysis)的思想。他在《关于最大方差方向》一文中证明:在高维数据中,沿着最大方差方向投影能保留最多的信息。这个发现比矩阵特征值分解的计算机应用早了半个世纪。
11.2 哈罗德·霍特林(Harold Hotelling, 1895-1973)
美国统计学家,1933年正式将PCA发展为一种统计方法。他不仅给出了PCA的数学推导,还提出了保留方差比例作为选择主成分数量的准则——这个准则至今仍在沿用。霍特林还发展了正则相关分析(CCA),是降维理论的另一个支柱。
11.3 伊戈尔·T·乔洛夫斯基(Igor T. Jolliffe, 1944-)
英国统计学家,1986年出版的《主成分分析》是PCA领域最权威的专著。他在书中系统总结了PCA的理论、算法和应用——从协方差矩阵的特征分解到SVD实现,从降维可视化到变量选择,为PCA成为数据分析的标准工具做出了决定性贡献。