欺诈率0.1%的建模战争——99.9%准确率的模型为什么没用?
先验直觉:反欺诈模型上线汇报,指标表上写着"准确率 99.92%",领导点头。但这句话单独看没有意义——因为把全部交易都放行,"准确率"也有 99.83%。在欺诈率只有 0.17% 的数据集上,准确率是最会骗人的指标。本文用 ULB 信用卡数据集(284,807 笔真实交易,492 笔欺诈)实测:默认阈值的逻辑回归精确率 86%、召回率只有 62%,而调整阈值后召回能到 77%——真正的决策问题不是"模型准不准",而是"拦错一个客户和漏过一个欺诈,各值多少钱"。
关键词:欺诈检测,类别不平衡,PR曲线,阈值,代价敏感,召回率,反欺诈
欺诈率 0.17% 是什么概念?28.4 万笔交易里只有 492 笔是欺诈,正常与欺诈的比例是 579:1。在这个数据上训练一个逻辑回归,什么都不调,它汇报的准确率是 99.92%——看起来无懈可击。
但同一份数据,如果做一个"全部放行"的模型:不拦截任何交易,准确率 99.83%。也就是说,那个看起来"满分"的模型,只比什么都不做多抓了 0.09 个百分点。
这不是模型的问题,是尺子的问题。本文把这把尺子拆开:为什么准确率会骗人、该用什么指标、以及反欺诈场景下阈值到底怎么定。
一个"满分"模型的真相
先看实测。ULB 信用卡欺诈数据集(ULB Machine Learning Group,欧洲信用卡持卡人 2013 年真实交易)共 284,807 笔,其中欺诈 492 笔。用全部特征训练逻辑回归,分层切分 70/30,默认阈值 0.5:
python
import numpy as np
import duckdb
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score, precision_score, recall_score, roc_auc_score, average_precision_score

con = duckdb.connect()
con.execute("CREATE TABLE cc AS SELECT * FROM read_parquet('data/creditcard.parquet')")
df = con.execute("SELECT * FROM cc").fetchdf()
X, y = df.drop(columns=['Class']).values, df['Class'].values
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, stratify=y, random_state=42)

lr = LogisticRegression(max_iter=1000, C=0.1)
lr.fit(X_train, y_train)
y_prob = lr.predict_proba(X_test)[:, 1]
y_pred = (y_prob >= 0.5).astype(int)
准确率: 99.92%
精确率: 85.98% ← 拦截的107笔里,92笔真是欺诈
召回率: 62.16% ← 147笔测试集欺诈,只抓到92笔,漏了55笔
AUC: 0.9346
PR-AUC: 0.6572
全猜正常的准确率: 99.83%
模型比全猜正常只高: 0.09pp四个数字摆一起,矛盾就出来了:准确率 99.92%、AUC 0.93,看起来顶级;但召回率 62% 意味着近四成欺诈漏过去了;而精确率 86% 意味着拦截的 107 笔里,有 15 笔是冤枉的。
模型在"不拦"这件事上极其正确——因为 99.83% 的交易本来就该放行。准确率衡量的,主要是它把正常交易放对的能力,而这恰恰是反欺诈最不关心的部分。
准确率为什么会骗人
把混淆矩阵写出来,原因一目了然:
当欺诈率
准确率的分子里,正常交易(TN)占了绝对主导。**模型哪怕把欺诈全部漏掉,只要把正常交易放对,准确率依然接近满分。**欺诈率越低,准确率这个指标越没有信息量——它几乎在测量"数据里有多少正常交易",而不是"模型有没有抓到欺诈"。
欺诈率
换把尺子:PR 曲线与召回-精确率权衡
反欺诈真正关心两个数:
- 召回率(Recall):欺诈里抓到了多少?
- 精确率(Precision):拦截的交易里,多少真是欺诈?
召回率对应"漏过欺诈的损失"(FN 的代价),精确率对应"误拦客户的代价"(FP 的代价)。欺诈率极低时,精确率会天然被压得很低——因为即使模型完美排序,10 万笔里也只有 170 笔欺诈,拦截 1000 笔可能只有 100 笔是真的。
ROC 曲线和 PR 曲线的差别就在这里:ROC 用 FPR 作横轴,FPR = FP / (FP + TN),分母被海量正常交易主导,欺诈率低时 ROC 曲线天然"好看"(本实验 AUC 0.93);PR 曲线用精确率作纵轴,分母是"模型拦截的所有交易",直接反映"拦截命中率",欺诈率低时 PR 曲线"难看"但真实(本实验 PR-AUC 只有 0.66)。
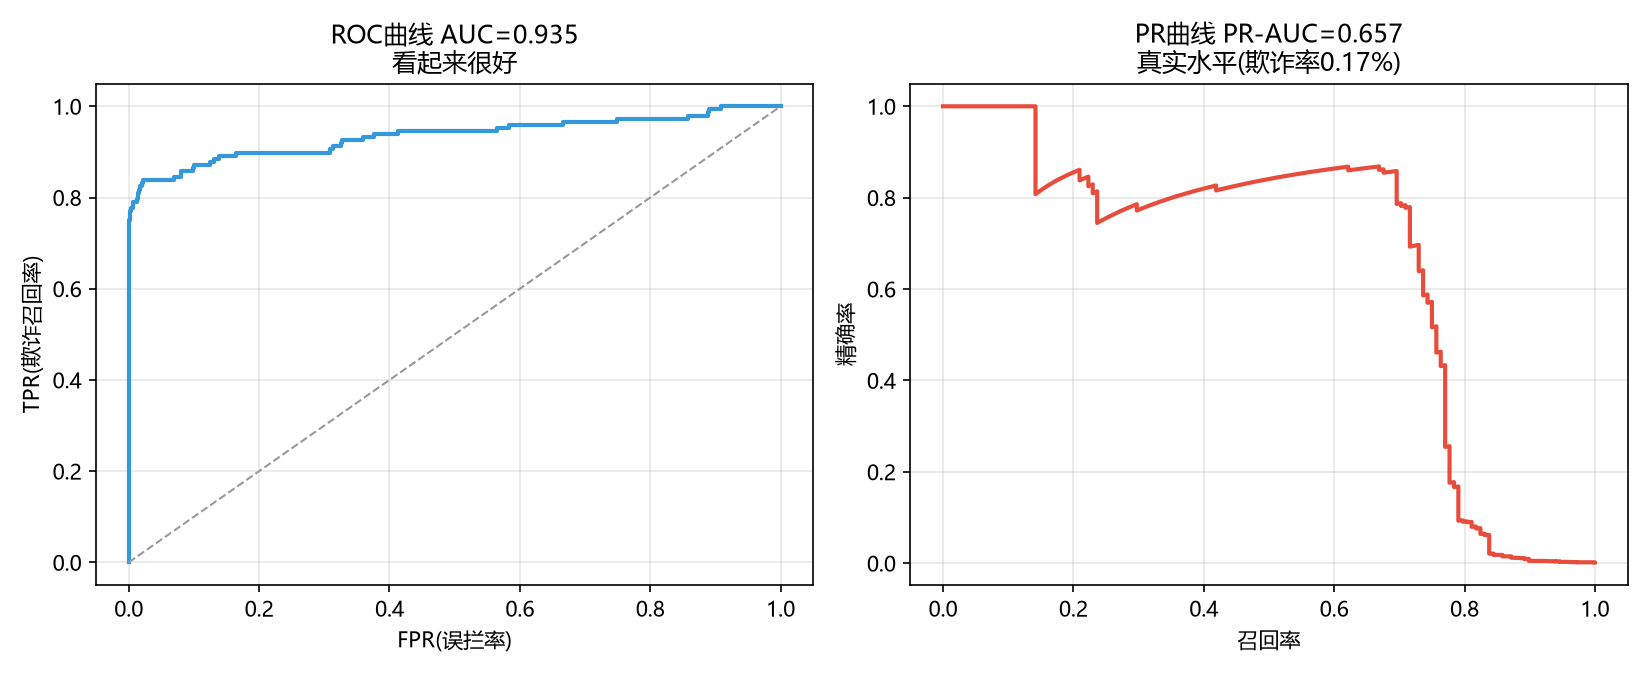
ROC 回答"模型排序能力好不好",PR 回答"模型拦截的到底是不是欺诈"。反欺诈业务场景,PR 曲线才是那把对的尺子。
贝叶斯最优阈值:把成本写进公式
模型输出的是欺诈概率
- 漏过一笔欺诈(FN):损失欺诈金额
- 误拦一笔正常(FP):损失客户体验/客服成本
总期望成本:
其中
整理成似然比形式:
对逻辑回归,分数与似然比单调相关,等价于"分数超过某个阈值
- 欺诈损失
越大 → 右侧越小 → 阈值越低,越激进地拦截; - 误拦成本
越大 → 右侧越大 → 阈值越高,越保守; - 欺诈率
越低 → 右侧越大 → 决策本身越保守——这正是反欺诈的困境:数据里欺诈太少,模型天然倾向"都不拦",必须靠"欺诈损失远大于误拦成本"( )把阈值拉回来。
阈值不是模型参数,是业务参数——它编码的是"一笔欺诈值多少钱、一个客户值多少钱"。
实测:阈值战争
把 0.5 的默认阈值换成业务视角,逐档扫描:
python
from sklearn.metrics import precision_score, recall_score
for th in [0.5, 0.3, 0.1, 0.05, 0.01, 0.001]:
    p = (y_prob >= th).astype(int)
    print(f'阈值{th:.3f}: 精确率{precision_score(y_test, p):.3f} 召回率{recall_score(y_test, p):.3f} 拦截{p.sum():,}笔')
阈值0.500: 精确率0.860 召回率0.622 拦截107笔
阈值0.300: 精确率0.856 召回率0.682 拦截118笔
阈值0.100: 精确率0.763 召回率0.716 拦截139笔
阈值0.050: 精确率0.573 召回率0.743 拦截192笔
阈值0.010: 精确率0.108 召回率0.791 拦截1,080笔
阈值0.001: 精确率0.011 召回率0.885 拦截11,756笔规律清晰:阈值越低,召回越高,精确率越差——这是天平的两端。拦得越狠,漏得越少,但冤枉的越多。
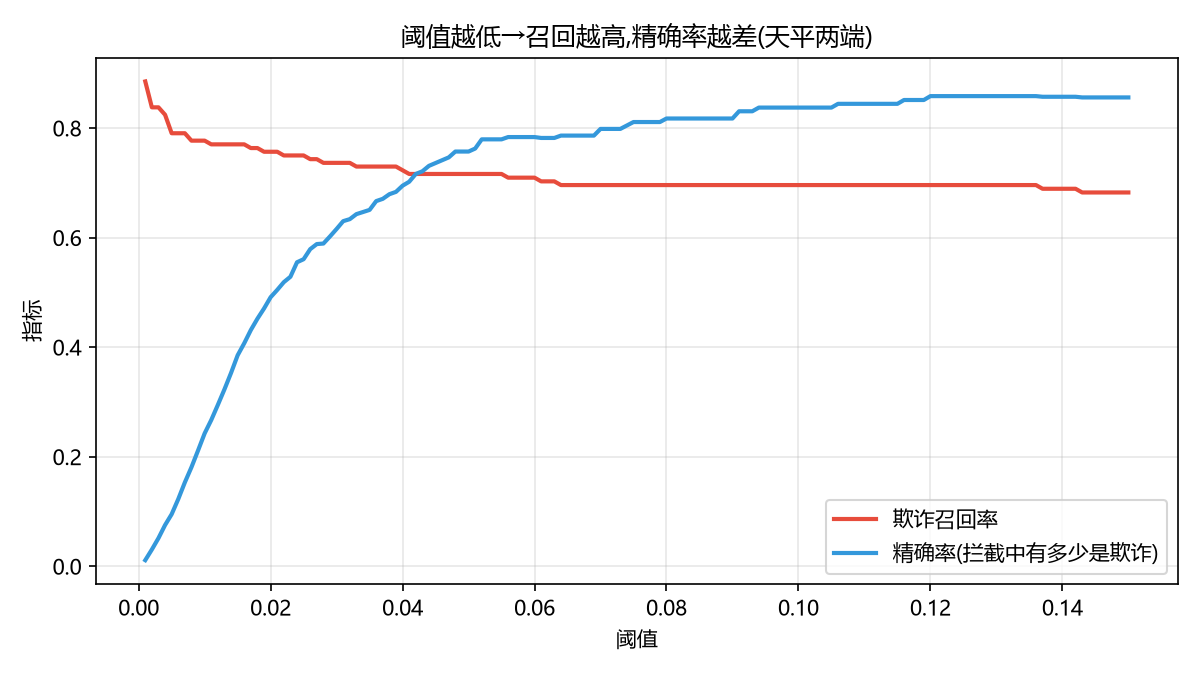
关键在于:哪一档是"最优"?取决于成本比。用成本函数扫描:
python
from sklearn.metrics import confusion_matrix
for cost_fn, cost_fp, label in [(100,1,'欺诈损失100x误拦'), (10,1,'10x'), (1,1,'1x')]:
    best = min((th for th in np.arange(0.001, 0.3, 0.001)),
               key=lambda th: (lambda p: confusion_matrix(y_test, (y_prob>=th).astype(int)).ravel())(0)[3] * cost_fn
                             + confusion_matrix(y_test, (y_prob>=th).astype(int)).ravel()[1] * cost_fp)
    # 简化:用循环求最优
实际扫描结果:
欺诈损失100x误拦: 最优阈值0.032 召回0.770 精确率0.418 拦截273笔 其中欺诈约114笔
欺诈损失10x误拦:  最优阈值0.076 召回0.730 精确率0.684 拦截158笔 其中欺诈约108笔
欺诈损失5x误拦:   最优阈值0.103 召回0.716 精确率0.779 拦截136笔 其中欺诈约106笔
欺诈损失1x误拦:   最优阈值0.238 召回0.696 精确率0.858 拦截120笔 其中欺诈约103笔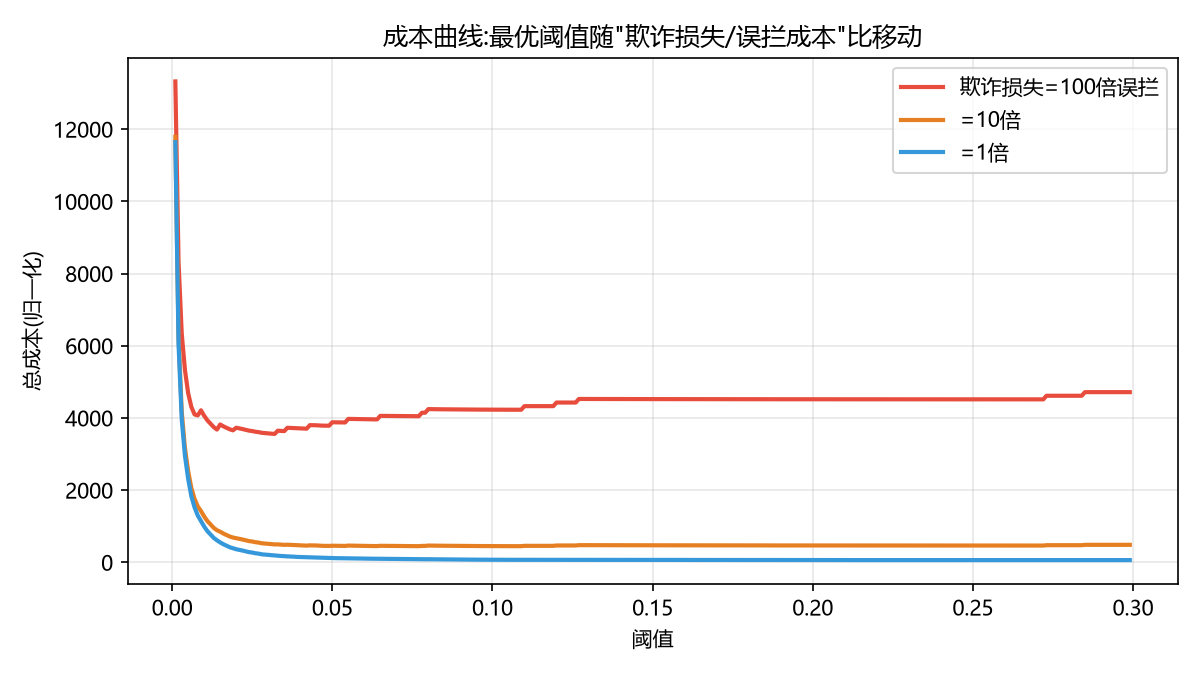
解读:当"漏过一笔欺诈的损失 = 误拦 100 个正常客户"时,最优阈值掉到 0.032——召回率从默认的 62% 升到 77%,多抓约 15% 的欺诈,代价是拦截量从 107 笔涨到 273 笔(误拦的 159 笔,对应 159 个被冤枉的客户)。当欺诈损失只等于 1 倍误拦成本时,最优阈值回到 0.238,拦截保守得多。
同一模型、同一批数据,业务参数一变,最优策略天差地别。 这就是为什么反欺诈系统的"调参"本质上是经营决策,不是统计问题。
业务落地:反欺诈阈值不是拍脑袋
实测结论落到银行反欺诈流程,四条可执行建议:
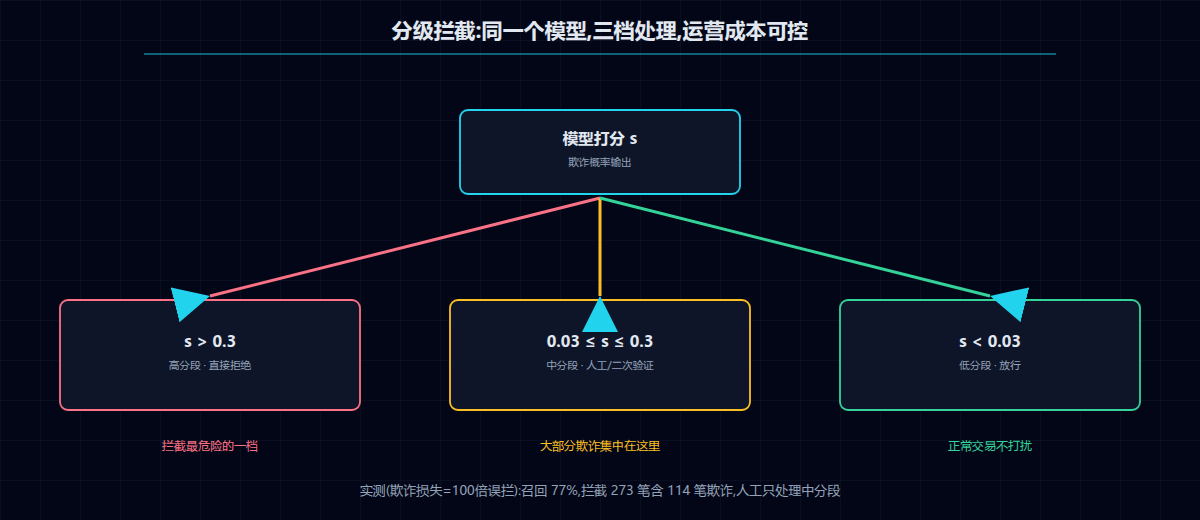
第一,汇报和考核别用准确率。 准确率在欺诈率 0.1% 的数据上必然 >99.8%,没有任何区分度。上线评审看四个数:召回率(漏了多少)、精确率(拦错多少)、拦截量(运营负担)、以及折算后的金额损失(召回欺诈的金额 vs 误拦成本)。汇报模板里,把"准确率 99.92%"换成"拦截命中率 86%、欺诈召回率 77%、月均拦截 273 笔含 114 笔欺诈、折算损失减少 X 万元"。
第二,阈值由成本函数驱动,不是由 PSI/AUC 驱动。 上线前和业务方对齐两个数字:一笔欺诈的平均损失(
第三,分级拦截代替一刀切。 阈值扫描结果可以直接拆成多档:高分段(>0.3)直接拒绝,中分段(0.03~0.3)转人工/二次验证,低分段放行。这样召回 77% 的欺诈,同时只对 273 笔做人工处理,运营成本可控。这正是"拦截量=运营负担"的含义。
第四,监控的不是准确率,是漂移。 上线后按月盯:拦截命中率(精确率)、欺诈率、分数分布 PSI。黑产会适应规则,欺诈模式漂移后召回率下滑,这时重训模型、重估成本比——反欺诈模型的生命周期管理,起点和终点都是阈值决策。
关键要点
- 欺诈率 0.17% 时,准确率天然 >99.8%,"全部放行"也有 99.83%——准确率是反欺诈最没用的指标
- 该看 PR 曲线:召回率=漏过多少欺诈,精确率=拦错多少客户;ROC 的 AUC 0.93 好看但 PR-AUC 0.66 才反映真实拦截水平
- 阈值不是统计参数是业务参数:最优阈值由成本比
决定,欺诈损失越大阈值越低、误拦成本越高阈值越低 - 实测:默认阈值 0.5 召回 62%,按"欺诈损失=100倍误拦"定阈 0.032 召回升到 77%,多抓 15% 欺诈,代价是拦截量 107→273 笔
- 落地四件事:考核用召回/精确率/金额不用准确率;成本函数定阈值;分级拦截代替一刀切;按月监控漂移
数据说明:ULB 信用卡欺诈数据集(284,807 笔,2013 年欧洲信用卡真实交易,欺诈率 0.173%),分层切分 70/30,seed=42 可完全复现。
代码环境:Python 3.11 + scikit-learn 1.9.0 + duckdb + pyarrow;完整脚本留档于文章目录 gen_figures.py。
AI 辅助创作 · 已人工校对,数据实测与结论推导由作者完成。
© QIAN数据 · AI工具实验室