KS下降了,真的是模型出了问题吗——一个反事实诊断框架
核心结论:KS下降并不等于模型退化。基于反事实诊断框架,KS下降可被逐步归因为抽样波动、组合构成变化、协变量偏移和真实模型漂移四种成因,其中前三者均为"假警报"。该框架通过四个顺序网关(gateway condition)逐层过滤,将"模型治理审查"这一高成本行动仅保留给最后一种情形,避免模型团队把资源浪费在"虚惊一场"上。关键词:KS统计量,模型监控,反事实诊断,协变量偏移,PS加权
01 问题:当KS下降时,你在慌什么?
在信贷风控模型的生命周期监控中,KS(Kolmogorov-Smirnov)统计量是最核心的"仪表盘指标"。模型上线后,监控团队每周、每天盯着KS曲线:一旦KS从0.42掉到0.31,监控立刻升级为治理流程——重审、回退、甚至重新开发。
但这里有一个隐藏的代价:绝大部分KS下降并不是模型的问题。
比如这样:你的评分卡模型在2024年1月KS为0.40,3月降至0.33,模型团队紧急开会、审查变量、调参重训,花费两周后发现——KS回升到0.39只是因为样本批次变了。这两周的"虚惊一场"消耗了原本应该投入真实模型迭代的资源。
传统监控方式的问题在于:把KS变化直接当成模型质量变化,忽略了KS本身是一个受多重因素影响的统计量。
那么,当我们观察到KS下降时,真正需要回答的问题不是"模型坏了吗",而是——"KS下降的原因是什么?"
02 相关概念:KS统计量是什么?
2.1 定义
KS统计量衡量的是两类样本(好客户 vs 坏客户)在模型评分分布上的最大分离程度。对于信贷风控模型,设好客户评分累计分布为
KS值越高,说明模型对好坏客户的区分能力越强。
2.2 监控中的常规做法
在模型监控中,我们比较的是同一模型在两个时间窗口上的表现差异:
设
当
2.3 一个被忽视的关键问题
上述流程隐含了一个强假设:两个时间窗口的样本来自同一分布。但现实中的信贷业务中,这个假设几乎从不成立——客群构成在变,宏观经济在变,审批策略在变,所有这些变化都会反映在KS值上,与模型本身的质量无关。
03 方法论:反事实诊断框架的四段归因
本文的核心框架来自风控模型验证领域的一篇论文 [1],其思想是:不直接比较观测到的KS,而是构造一系列"反事实"场景,逐步剥离各因素的影响。
3.1 框架总览
反事实诊断框架将KS下降的归因分解为四个层次,每个层次对应一个网关条件(Gateway Condition):
Layer 1:抽样波动?          → 是 → 假警报 ✅
         否 ↓
Layer 2:组合构成变化?      → 是 → 假警报 ✅
         否 ↓
Layer 3:协变量偏移?        → 是 → 假警报 ✅
         否 ↓
Layer 4:模型真实漂移?      → 是 → 真实退化 ⚠️
只有通过前三层过滤仍未解释的KS下降,才归因为模型退化。
需要先说明一个统计事实:本文使用的两样本KS统计量(见2.1节定义)比较的是好坏两组各自的评分分布,与两组样本数量的比例无关——好坏比例变化本身不改变KS,它只能通过改变评分分布间接起作用,而这种间接影响在统计上与"客群特征分布变化"难以区分。因此本文在演示中把 Layer 2 的效果并入 Layer 3 的协变量偏移层统一处理(论文按子客群分段做了更细的分解,口径不冲突)。
3.2 Layer 1:抽样波动(Sampling Variability)
问题:监控期的样本量是否足够大?小样本下KS的方差很大,观测到的下降可能只是随机波动。
反事实构造:在基准期样本中做Bootstrap重采样,构建KS的置信区间。
设基准期样本
Gateway条件:
3.3 Layer 2:组合构成变化(Portfolio Composition Change)
问题:客群的结构是否变了——不同渠道、产品、区域的子客群占比是否发生变化?
业务上,组合构成变化确实会改变模型的整体表现:高风险产品线放量、新渠道引入低质量客群,整体坏账率会上升。但落到KS这个统计量上要小心:两样本KS只取决于好坏两组各自的评分分布,好坏样本的比例并不直接进入KS的计算。组合构成变化只有通过"改变评分分布"才能传导到KS——新渠道客群的特征分布不同,评分分布随之改变。
处理方式:这种传导在统计上表现为特征分布的变化,归入 Layer 3 的协变量偏移层统一处理。论文 [1] 对组合构成做了更细的子客群分段分解(current-only universe effect、mix effect 等),样本量允许分段时值得实践;本文的模拟演示以 Layer 3 为主,与代码口径一致。
3.4 Layer 3:协变量偏移(Covariate Shift)
问题:客群的特征分布是否发生了系统性偏移?即使模型权重不变,特征分布的变化也会导致评分分布改变,从而拉低KS。
反事实构造:把基准期样本按"属于监控期的倾向得分"重加权,让基准期的特征分布对齐到监控期,再计算加权后的基准期KS——记为
对好、坏客户分别拟合时期分类器,得到各自的倾向得分
加权后的好、坏客户累计分布为:
Gateway条件:对齐后基准期KS与监控期KS接近,说明KS下降可以由客群特征变化解释:
3.5 Layer 4:模型退化(Model Drift)
如果前三层都无法解释KS下降,剩余的部分即为模型真实退化:
04 数学文化:从Fisher到Kolmogorov,一个统计量的百年传承
KS统计量的故事,始于两位统计学家和一个看似简单的问题。
4.1 Fisher与经验分布
1920年代,Ronald Fisher在Rothamsted实验站研究农作物产量时,面临一个基础问题:我们如何知道两个样本是否来自同一分布?他提出了方差分析(ANOVA)框架,但ANOVA假设数据服从正态分布——这个假设在现实数据中常常不成立。
4.2 Kolmogorov的洞见
1933年,苏联数学家Andrey Kolmogorov发表了一篇里程碑式的论文《Sulla determinazione empirica di una legge di distribuzione》(关于分布律的经验确定)。他提出了**经验分布函数(ECDF)**的概念:
并证明了一个惊人的结果:当样本量足够大时,经验分布与真实分布的最大偏差服从一个与分布形式无关的分布——Kolmogorov分布。
这个"无关性"(distribution-free)性质,使Kolmogorov统计量成为非参数统计的第一个普适工具。
4.3 Smirnov的推广
1939年,Kolmogorov的学生Nikolai Smirnov将这一思想推广到两样本比较的场景:如何判断两个样本是否来自同一分布?他提出了两样本KS统计量:
并推导了其渐近分布。这就是我们今天在风控模型中使用的KS统计量的直接来源。
4.4 从数理统计到金融风控
KS统计量进入金融风控领域的原因很朴素:从Basel II(2004)开始,监管框架就要求银行对信用评分模型做严格的区分能力验证,2011年美联储SR 11-7又把模型验证固化为治理要求。AUC和Gini系数虽然是业界标准,但它们对模型的整体区分能力给出综合评价——而KS关注的是"最大区分点",这恰好对应着评分卡中cut-off决策点的判别能力。
在信贷风控中,评分卡通常在某个阈值(如评分600分)附近做决策。KS统计量恰好衡量了该最优cut-off点的区分能力,因此天然适合用于评估评分卡模型。
4.5 为什么"反事实"思维是必要的
传统统计推断关注的是"观察到的差异是否显著"。反事实诊断框架引入了因果推断的核心思想:我们真正想知道的不是"KS是否下降",而是"如果其他条件不变,KS是否下降"。
做法就是在数据层面构造"保持其他条件不变"的场景,把相关关系与因果关系分离开——Layer 1到Layer 3的每一层,都在回答同一个问题:"如果只允许这个因素变化,KS还会降吗?"
05 代码示例:模拟KS下降的诊断流程
以下精简代码演示了反事实诊断的核心四层流程(完整绘图脚本见同目录 gen_figures.py,这里给出独立可运行的核心逻辑):
python
"""反事实诊断框架 — 核心流程(独立可运行)
场景A: KS下降可由抽样波动解释               -> 假警报
场景B: KS下降超出抽样波动且协变量偏移无法解释 -> 真实退化
场景C: KS下降可由协变量偏移解释             -> 假警报
"""
import numpy as np
from scipy import stats
from sklearn.linear_model import LogisticRegression
import warnings
warnings.filterwarnings('ignore')

def ks_stat(g, b):
    return stats.ks_2samp(g, b).statistic

def gen_data(seed, n_good, n_bad, bad_shift=0.0):
    rng = np.random.default_rng(seed)
    good = np.clip(rng.normal(65, 10, n_good), 0, 100)
    bad = np.clip(rng.normal(45 + bad_shift, 10, n_bad), 0, 100)
    Xg = rng.multivariate_normal([0.5, 0.3], [[0.1, 0.02], [0.02, 0.1]], n_good)
    Xb = rng.multivariate_normal([0.4, 0.2], [[0.1, 0.02], [0.02, 0.1]], n_bad)
    return good, bad, Xg, Xb

def bootstrap_ci(g, b, n=1000, seed=1):
    """Layer 1: 抽样波动 — 基准期KS的Bootstrap置信区间"""
    rng = np.random.default_rng(seed)
    boot = [ks_stat(rng.choice(g, len(g), True), rng.choice(b, len(b), True)) for _ in range(n)]
    return np.percentile(boot, [2.5, 97.5])

def ps_weighted_ks(X_ref, X_mon, scores_ref, labels_ref):
    """Layer 3: 协变量偏移 — 分层PS加权(好/坏客户分别对齐特征分布),
    返回加权后的基准期KS, 即反事实KS: 若监控期客群特征与基准期相同,
    基准期模型本应表现出的区分能力 KS_ref->cur"""
    g_idx, b_idx = labels_ref == 0, labels_ref == 1
    def layer_weights(X_ref_k, X_mon_k):
        X_all = np.vstack([X_ref_k, X_mon_k])
        t = np.array([0]*len(X_ref_k) + [1]*len(X_mon_k))
        ps = LogisticRegression(max_iter=1000).fit(X_all, t).predict_proba(X_all)[:, 1]
        return np.clip(ps[:len(X_ref_k)] / (1 - ps[:len(X_ref_k)] + 1e-8), 0.01, 100.0)
    wg = layer_weights(X_ref[g_idx], X_mon[g_idx])
    wb = layer_weights(X_ref[b_idx], X_mon[b_idx])
    s = np.sort(scores_ref)
    sg, sb = scores_ref[g_idx], scores_ref[b_idx]
    ecdf_g = np.array([np.sum(wg[sg <= v]) / np.sum(wg) for v in s])
    ecdf_b = np.array([np.sum(wb[sb <= v]) / np.sum(wb) for v in s])
    return np.max(np.abs(ecdf_g - ecdf_b))

# ---- 场景A: 假警报 — KS下降可由抽样波动解释 ----
good_ref, bad_ref, Xr_g, Xr_b = gen_data(1, 300, 50)
good_mon, bad_mon, Xm_g, Xm_b = gen_data(1001, 300, 50)
ks_ref, ks_mon = ks_stat(good_ref, bad_ref), ks_stat(good_mon, bad_mon)
ci = bootstrap_ci(good_ref, bad_ref)
print(f"基准KS = {ks_ref:.4f} -> 监控KS = {ks_mon:.4f}  (dKS = {ks_mon-ks_ref:.4f})")
print(f"L1 抽样波动: Bootstrap 95%CI = [{ci[0]:.4f}, {ci[1]:.4f}]")
print(f"   监控KS在CI内 = {ci[0]<=ks_mon<=ci[1]} -> 假警报 OK")

# ---- 场景B: 真实退化 — 抽样波动与协变量偏移均无法解释 ----
good_ref2, bad_ref2, Xr2_g, Xr2_b = gen_data(2, 3000, 500)
good_mon2, bad_mon2, Xm2_g, Xm2_b = gen_data(2002, 3000, 500, bad_shift=8.0)
ks_ref2, ks_mon2 = ks_stat(good_ref2, bad_ref2), ks_stat(good_mon2, bad_mon2)
ci2 = bootstrap_ci(good_ref2, bad_ref2)
print(f"\n基准KS = {ks_ref2:.4f} -> 监控KS = {ks_mon2:.4f}  (dKS = {ks_mon2-ks_ref2:.4f})")
print(f"L1 抽样波动: Bootstrap 95%CI = [{ci2[0]:.4f}, {ci2[1]:.4f}] 监控KS在CI内 = {ci2[0]<=ks_mon2<=ci2[1]}")
X_ref2 = np.vstack([Xr2_g, Xr2_b]); X_mon2 = np.vstack([Xm2_g, Xm2_b])
scores_ref2 = np.concatenate([good_ref2, bad_ref2])
labels_ref2 = np.array([0]*len(good_ref2) + [1]*len(bad_ref2))
ks_cf2 = ps_weighted_ks(X_ref2, X_mon2, scores_ref2, labels_ref2)
print(f"L3 协变量偏移: 对齐后基准期KS = {ks_cf2:.4f} (特征分布没变, 加权无效果, 仍接近基准)")
print(f"L4 剩余漂移 = {ks_cf2-ks_mon2:.4f} -> 真实退化 WARN: 触发治理审查")

# ---- 场景C: 假警报 — KS下降可由协变量偏移解释 ----
rng_x, rng_s = np.random.default_rng(3003), np.random.default_rng(3004)
n_g, n_b = 3000, 600
Xg_ref3 = rng_x.normal(1.0, 0.25, n_g); Xb_ref3 = rng_x.normal(0.5, 0.25, n_b)
Xg_mon3 = rng_x.normal(0.7, 0.25, n_g); Xb_mon3 = rng_x.normal(0.45, 0.25, n_b)
score = lambda x: 50 + 40*x + rng_s.normal(0, 4, len(x))
g_ref3, b_ref3 = score(Xg_ref3), score(Xb_ref3)
g_mon3, b_mon3 = score(Xg_mon3), score(Xb_mon3)
ks_ref3, ks_mon3 = ks_stat(g_ref3, b_ref3), ks_stat(g_mon3, b_mon3)
ci3 = bootstrap_ci(g_ref3, b_ref3)
print(f"\n基准KS = {ks_ref3:.4f} -> 监控KS = {ks_mon3:.4f}  (dKS = {ks_mon3-ks_ref3:.4f})")
print(f"L1 抽样波动: Bootstrap 95%CI = [{ci3[0]:.4f}, {ci3[1]:.4f}] 监控KS在CI内 = {ci3[0]<=ks_mon3<=ci3[1]}")
XC_ref3 = np.concatenate([Xg_ref3, Xb_ref3]).reshape(-1, 1)
XC_mon3 = np.concatenate([Xg_mon3, Xb_mon3]).reshape(-1, 1)
scores_ref3 = np.concatenate([g_ref3, b_ref3])
labels_ref3 = np.array([0]*len(g_ref3) + [1]*len(b_ref3))
ks_cf3 = ps_weighted_ks(XC_ref3, XC_mon3, scores_ref3, labels_ref3)
print(f"L3 协变量偏移: 对齐后基准期KS = {ks_cf3:.4f} (接近监控期KS, 客群特征变化解释了下降)")
print(f"L4 剩余漂移 = {ks_cf3-ks_mon3:.4f} -> 近似为0, 假警报 OK")
实际运行输出:
text
基准KS = 0.7600 -> 监控KS = 0.7033  (dKS = -0.0567)
L1 抽样波动: Bootstrap 95%CI = [0.6799, 0.8600]
   监控KS在CI内 = True -> 假警报 OK

基准KS = 0.6530 -> 监控KS = 0.4523  (dKS = -0.2007)
L1 抽样波动: Bootstrap 95%CI = [0.6273, 0.6937] 监控KS在CI内 = False
L3 协变量偏移: 对齐后基准期KS = 0.6541 (特征分布没变, 加权无效果, 仍接近基准)
L4 剩余漂移 = 0.2018 -> 真实退化 WARN: 触发治理审查

基准KS = 0.6803 -> 监控KS = 0.3740  (dKS = -0.3063)
L1 抽样波动: Bootstrap 95%CI = [0.6547, 0.7153] 监控KS在CI内 = False
L3 协变量偏移: 对齐后基准期KS = 0.3768 (接近监控期KS, 客群特征变化解释了下降)
L4 剩余漂移 = 0.0028 -> 近似为0, 假警报 OK
关键输出解读:
- 场景A:基准期只有 300+50 个样本,Bootstrap 置信区间很宽([0.68, 0.86])。监控期 KS 从 0.7600 降到 0.7033,但完全落在置信区间内——这个"下降"只是抽样波动,不需要惊动模型团队。
- 场景B:基准期 3000+500 个大样本,置信区间窄([0.63, 0.69])。监控期 KS 跌到 0.4523,远超区间下界;把基准期特征对齐到监控期后 KS 仍是 0.6541(特征分布没变,加权不起作用),协变量偏移解释不了这 0.20 的下降——剩余漂移只能归因于模型真实退化。
- 场景C:好客户特征均值从 1.0 降到 0.7,坏客户从 0.5 降到 0.45,评分函数两个时期完全相同(模型没坏)。KS 从 0.6803 跌到 0.3740;把基准期对齐到监控期后 KS 是 0.3768,与监控期几乎一样——客群特征变化完全解释了下降,是假警报。
注意:Layer 2(组合构成)在代码里没有单独演示,因为两样本 KS 统计量本身不受好坏样本比例影响;组合构成变化是通过改变评分分布间接影响 KS 的,这种影响在统计上归入协变量偏移层处理(见3.1节说明)。
完整绘图脚本 gen_figures.py 会生成四张诊断图,下图分别是场景A的Bootstrap诊断、场景B的Bootstrap诊断、场景B的KS曲线对比和归因瀑布:
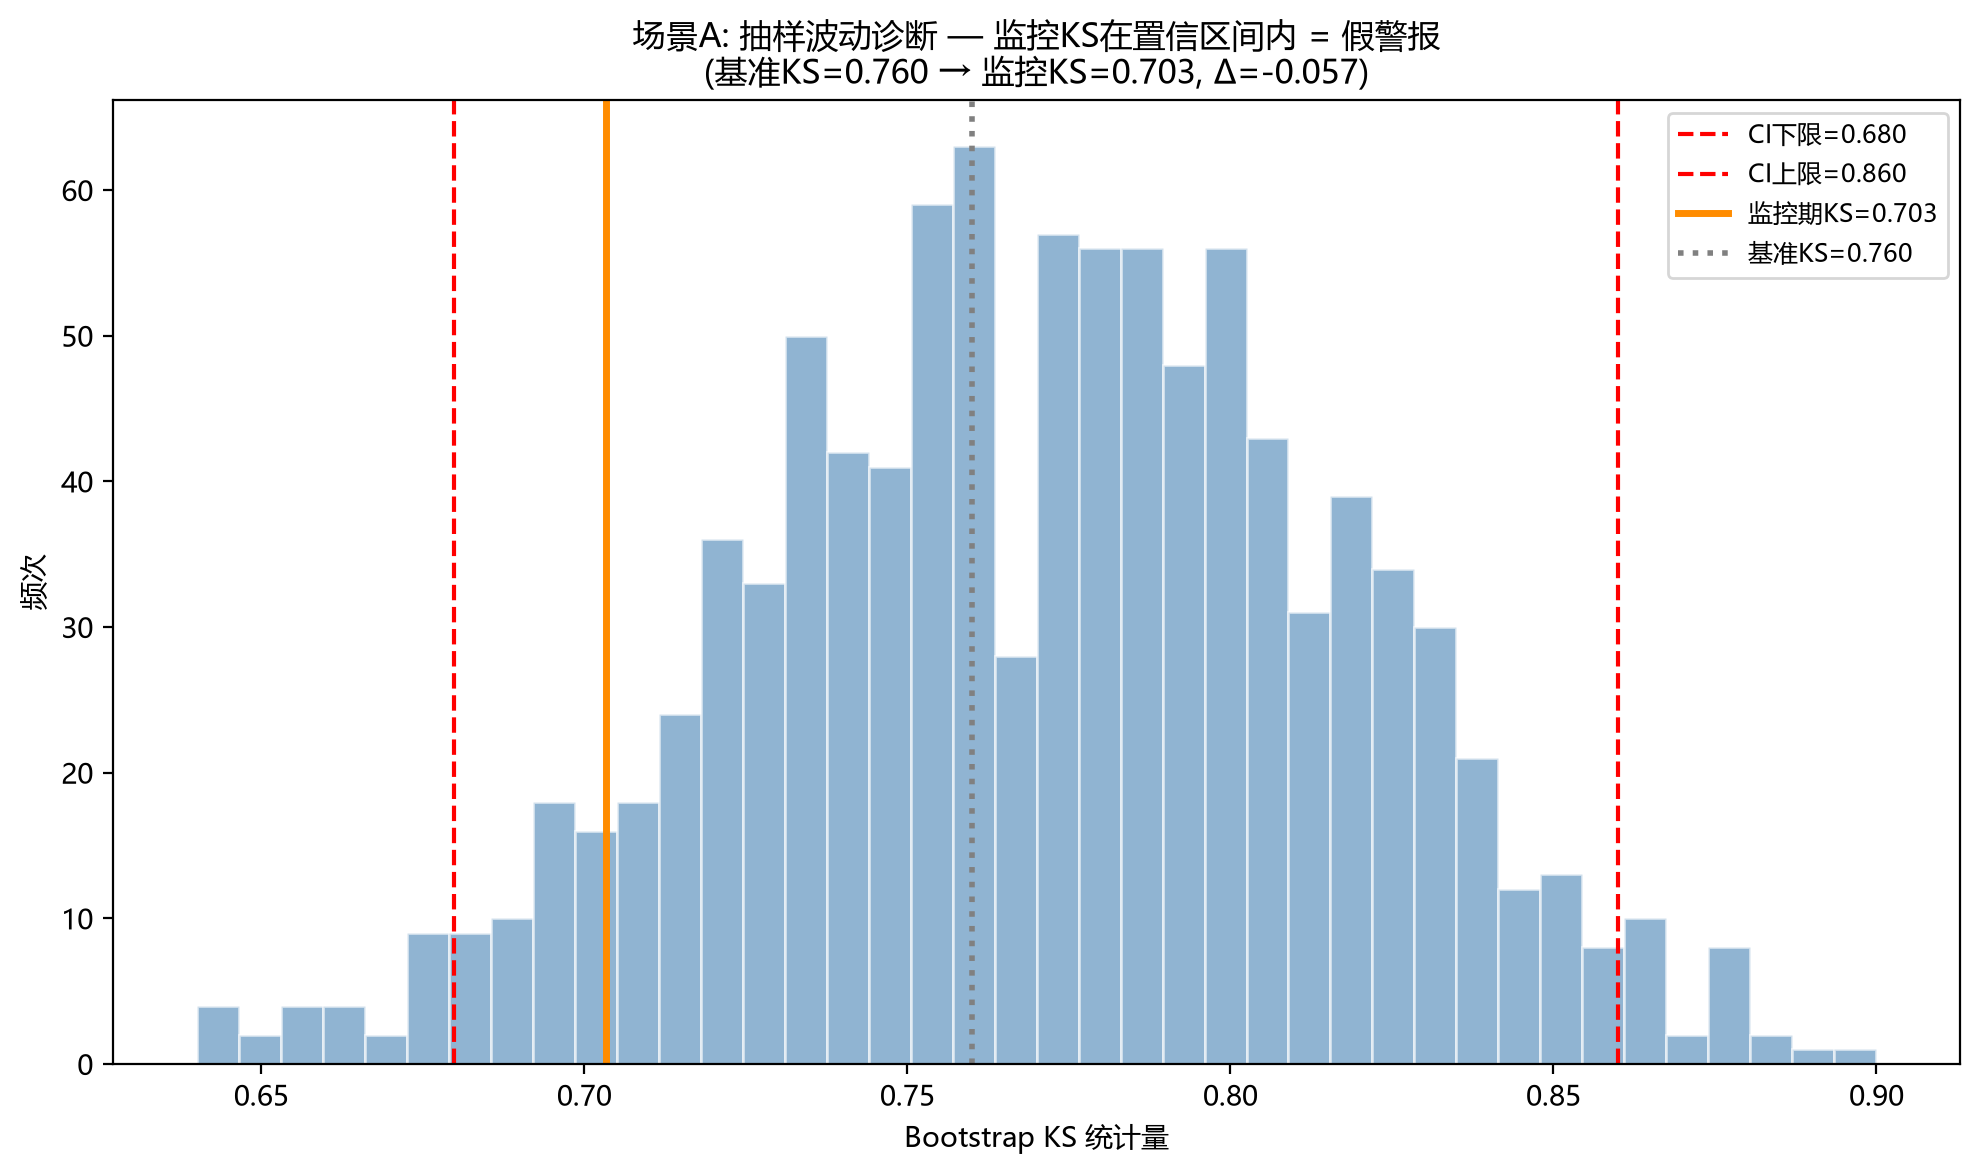
场景A:监控期KS(橙色线)落在基准期Bootstrap置信区间(红色虚线)内——下降只是抽样波动。
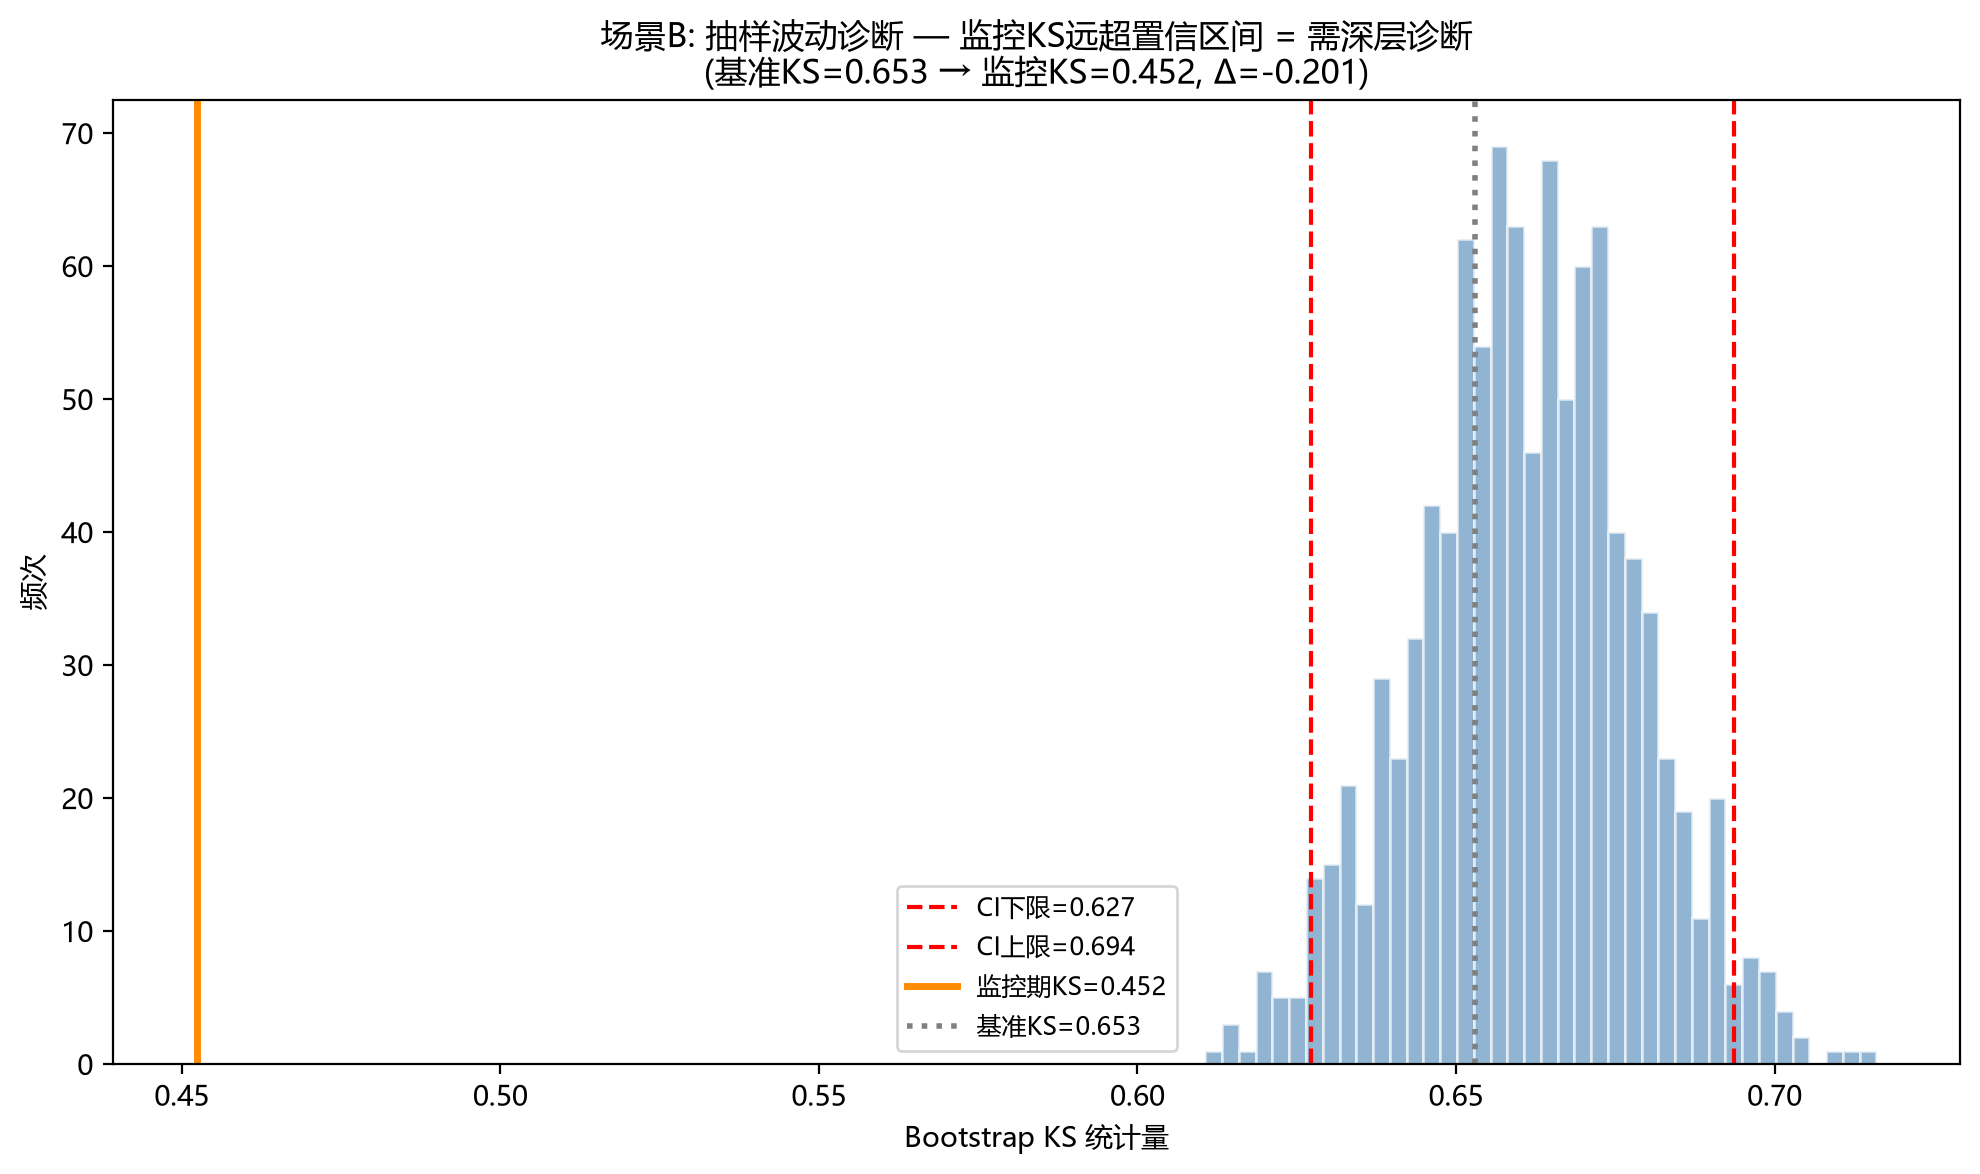
场景B:监控期KS(橙色线)远超置信区间下界——需要继续深层诊断。
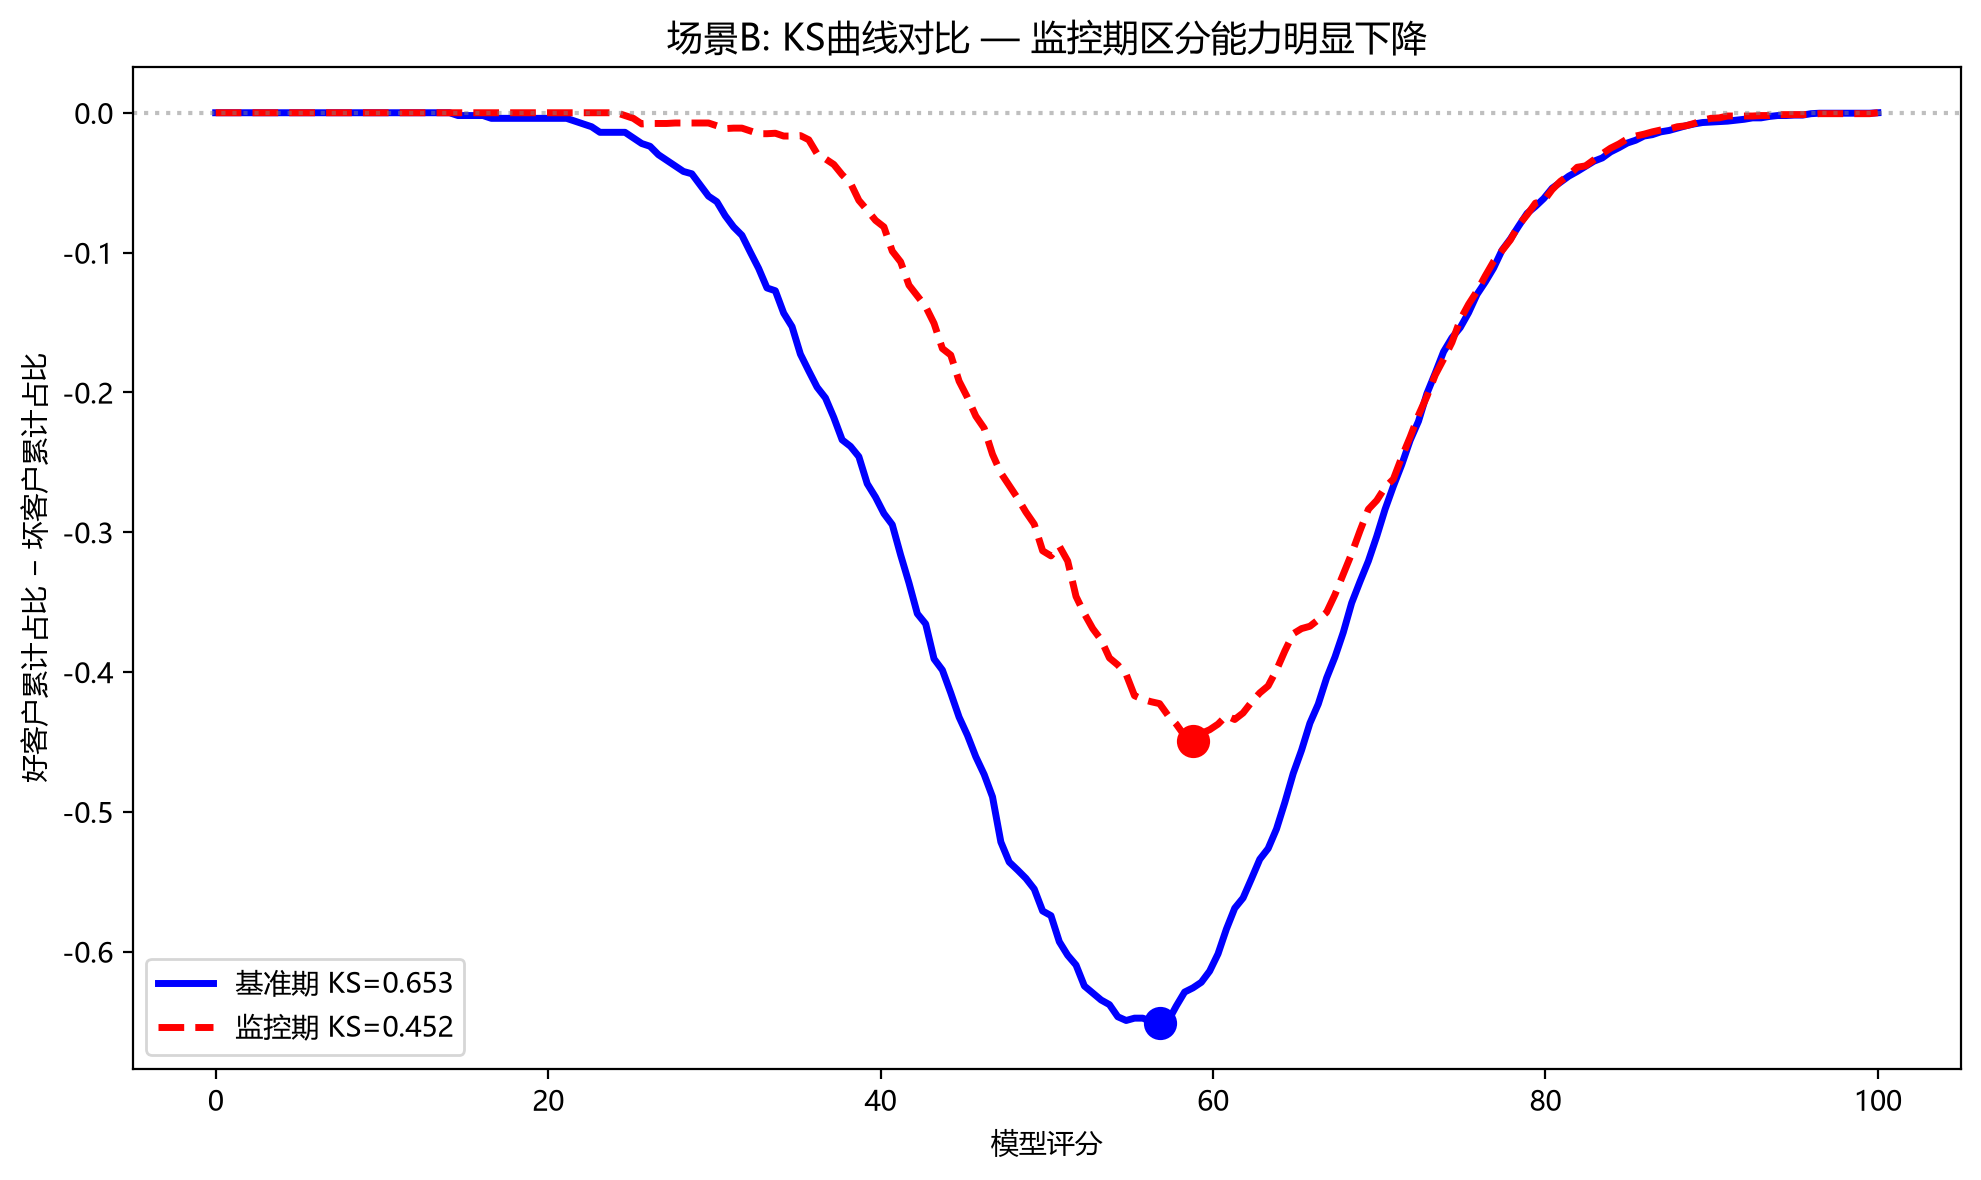
场景B的KS曲线:监控期好坏客户累计占比之差的最大值从0.65骤降到0.45,区分能力明显下降。
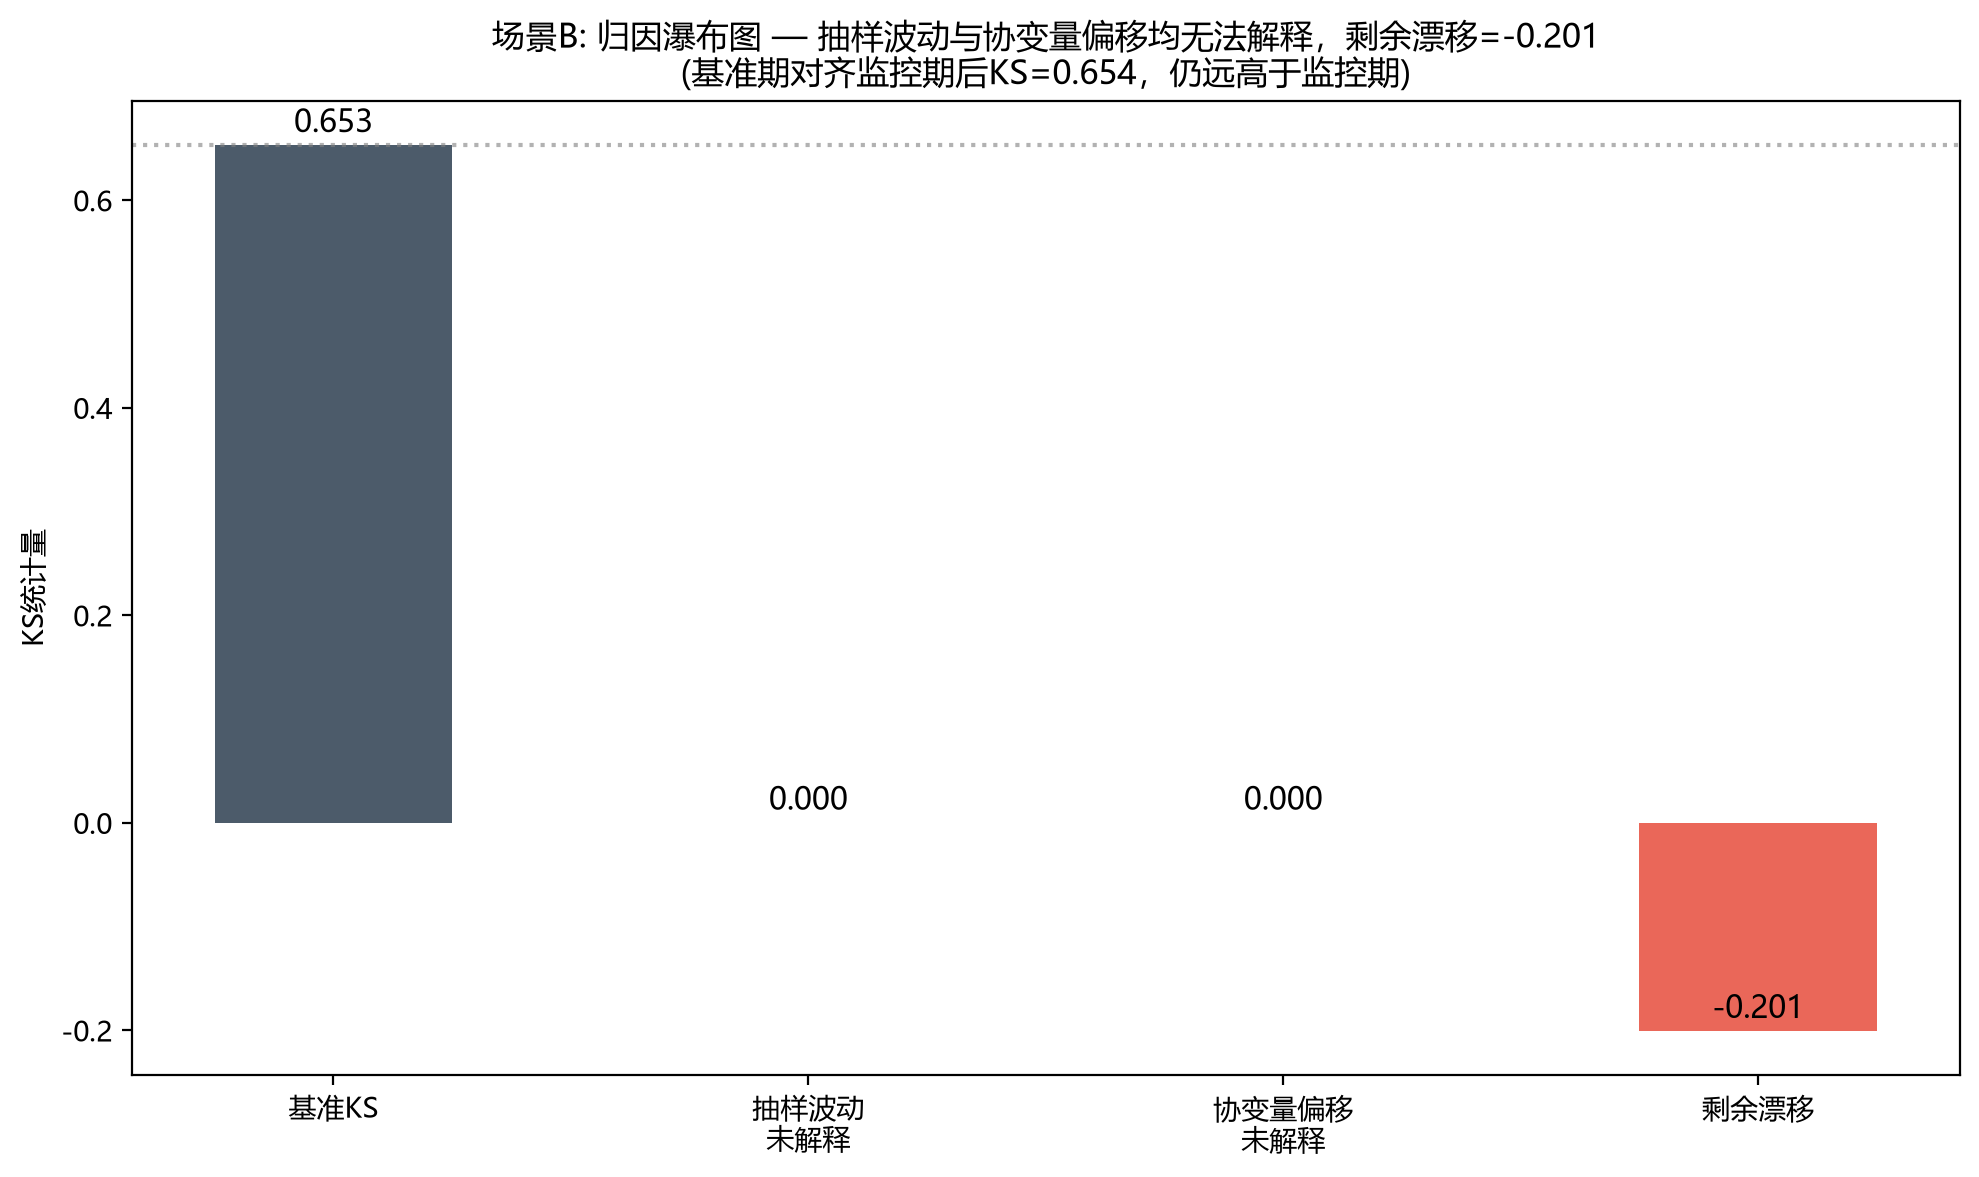
归因瀑布:抽样波动与协变量偏移都无法解释的剩余漂移0.20,只能归因于模型真实退化。
06 常见问题
Q1:KS 下降多少才需要触发审查?剩余漂移多大算"真实退化"?
传统做法是固定阈值(如 ΔKS < -0.05),但样本量小时 KS 的随机波动本身就可能超过 0.05。反事实框架先看监控期 KS 是否落在基准期 Bootstrap 置信区间内——在区间内就是抽样波动,不需要任何审查动作。通过前三层后,剩余漂移(对齐后基准期 KS 与监控期 KS 之差)超过 0.02-0.05 且无法解释,才触发治理审查。阈值本身不是重点,重点是先把"可解释的假警报"和"不可解释的下降"分开。
Q2:为什么说"组合构成变化"是假警报?模型监控时坏账率明明在变?
两样本 KS 统计量只比较好坏两组评分分布的分离程度,与两组样本数量的比例无关。坏账率变化确实会改变业务结果,但除非它改变了评分分布本身,否则不会体现在 KS 上——真正让 KS 变化的是客群特征分布的改变,这属于协变量偏移层。
Q3:PS 加权为什么能"还原"KS?
PS 加权回答的问题是:"如果监控期的客群特征和基准期一样,基准期模型本该有多少区分能力?"做法是把基准期样本按"属于监控期的倾向得分"重加权,让基准期特征分布对齐到监控期,再算加权后的基准期KS。如果对齐后 KS 与监控期接近,说明下降主要由可观测的客群变化导致(假警报);如果对齐后 KS 仍然明显高于监控期,说明是模型打分能力本身出了问题。
07 总结与展望
7.1 核心贡献
反事实诊断框架的核心洞见是:KS统计量的下降是一个多因现象,将其直接等同于模型退化是一种归因谬误。通过构造反事实场景逐步排除假警报,监控就从"看见KS降就开会"变成了"先问KS为什么降"。
7.2 实践建议
| 场景 | 传统做法 | 反事实框架的做法 |
|---|---|---|
| KS下降5% | 触发审查,模型团队介入 | Layer 1→2→3逐层诊断 |
| 好客户变多了 | 不管,直接看KS | 先看是否改变评分分布,是则并入Layer 3协变量偏移处理 |
| 客群特征漂移 | 只监控PSI,不关联KS | Layer 3用PS加权去偏 |
| 最终确认退化 | 同上,没有区分 | Layer 4剩余漂移才是真退化 |
7.3 局限与扩展
该框架也有其局限性:PS模型本身的准确性依赖于协变量是否被正确观测;当多个因素同时且交互变化时,线性加性的归因假设可能不够精确。未来可扩展到:
- 时序依赖建模:使用时间序列结构剥离趋势性变化
- 非线性归因:引入SHAP等可解释AI方法进行非线性的因素分解
- 多指标联合诊断:将KS与PSI、特征稳定性等指标联合建模
参考文献
- Liao et al. A Counterfactual Diagnostic Framework for Explaining KS Deterioration in Credit Risk Model Validation. arXiv:2604.11561, 2026.
- Kolmogorov, A. (1933). Sulla determinazione empirica di una legge di distribuzione.
- Smirnov, N. (1939). On the estimation of the discrepancy between empirical curves of distribution.
- Rosenbaum, P. & Rubin, D. (1983). The central role of the propensity score in observational studies for causal effects.
- Basel Committee on Banking Supervision (2005). Studies on the Validation of Internal Rating Systems.
- © QianStat_data · QIAN数据 · 用数学拆穿市场的噪声