策略规则里的死分支——阈值设得再严,客户根本不存在
关键词:死分支,濒死规则,区间代数,阈值脱节,规则治理
01 现象:你以为的"严格规则",可能从来没拦到过人
先问一个反常识的问题:你的策略规则引擎里,有多少条规则实际上从来没触发过?
大多数策略团队的答案都是"不可能吧"。每条规则上线时都经过评审、都对着历史数据验证过命中率,怎么会不触发?
但真实情况是:规则引擎越老,死分支越多。业务变了几轮——产品额度上限调整过、客群准入标准下探过、数据字段口径更换过——当年合理的阈值,今天可能已经落到了数据域之外。
这篇用 LendingClub 2007-2018 年公开贷款数据(226万笔,剔除缺失后样本 2,257,151 笔)模拟一个策略团队的规则引擎,看死分支长什么样、怎么检测、代价有多大。
02 死分支是什么:两类,成因完全不同
死分支(dead branch)指规则引擎里永远或几乎不会触发的分支。分两类:
第一类:数学死分支(数学可证,任何数据都不触发)
规则的数值条件对应一个区间,数据字段有实际取值范围。如果规则区间和数据域没有交集,这条规则在数学上就不可能命中:
例如规则"贷款金额 > 5 万",但产品额度上限是 4 万——金额字段的数据域是
第二类:统计濒死分支(数据极薄,必须实测)
区间有交集,数学上"可能"命中,但真实数据里几乎没人落在这个区间——命中率低到可以忽略。例如规则"逾期次数 >= 20",数据域确实有 0-58,但逾期 20 次以上的客户全库只有 57 人,再叠加其他条件就只剩个位数。
区分这两类很重要,因为检测方法完全不同:
- 数学死分支:区间代数精确判定(SymPy
Interval.intersect),与数据无关 - 统计濒死分支:只能靠数据命中率判定,换数据要重跑
这和 #105/#105b 的"逻辑冗余 vs 统计冗余"是同一个二分:能证明的 vs 必须实测的。
03 方法:区间代数 + 命中率双通道检测
3.1 区间代数:数学死分支的精确判定
把每条规则的数值条件翻译成区间,和数据域求交集。用 SymPy:
python
import sympy as sp

# 数据域: 贷款金额实际范围 [500, 40000]
amnt_domain = sp.Interval(500, 40000)
# 规则R7: 贷款金额 > 50000
r7_interval = sp.Interval.open(50000, sp.oo)
print(r7_interval.intersect(amnt_domain))
# EmptySet → 交集为空, 数学死分支区间交集为空,这条规则在数学上就是死的——不需要跑数据。
3.2 命中率通道:统计濒死分支的量化判定
数学死分支罕见,业务上更常见的是"命中率低到没存在意义"的濒死分支。定义两个指标:
命中率:规则命中客户数 / 总样本
阈值分位:规则阈值在字段分布中的位置。阈值落在分布极薄处(如信用分 < 600,但客群最低分 610),说明规则与数据域脱节:
检测流程:先跑区间代数筛数学死分支,再对剩余规则算命中率。但濒死的判据不是拍脑袋的命中率线,而是"命中数不足以支撑决策":一条规则命中
3.3 Wilson 区间:怎么判断一个比例估得靠不靠谱
3.2 反复提到的"置信区间"就是 Wilson 区间(Wilson score interval,1927 年提出)。这里把它的数学讲透,因为它正是濒死判据的底层逻辑。
问题:一条规则拦了
朴素做法(Wald 区间):正态近似
问题出在极端情形:
Wilson 区间:Edwin Wilson 的改进是在点估计里加一个"先验收缩"项,把区间向 0.5 拉:
其中
代入本文三条规则(坏账率用 3.2 的实测数):
| 规则 | 命中 K | 坏账 x | 点估计 | Wilson 95% CI | 区间半宽 |
|---|---|---|---|---|---|
| R9 | 9 | 0 | 0% | [0%, 29.9%] | ±15.0pp |
| R10 | 190 | 13 | 6.8% | [4.0%, 11.4%] | ±3.7pp |
| R1 | 6,175 | 1,079 | 17.5% | [16.5%, 18.4%] | ±0.95pp |
| R4 | 115,604 | 24,978 | 21.6% | [21.4%, 21.8%] | ±0.24pp |
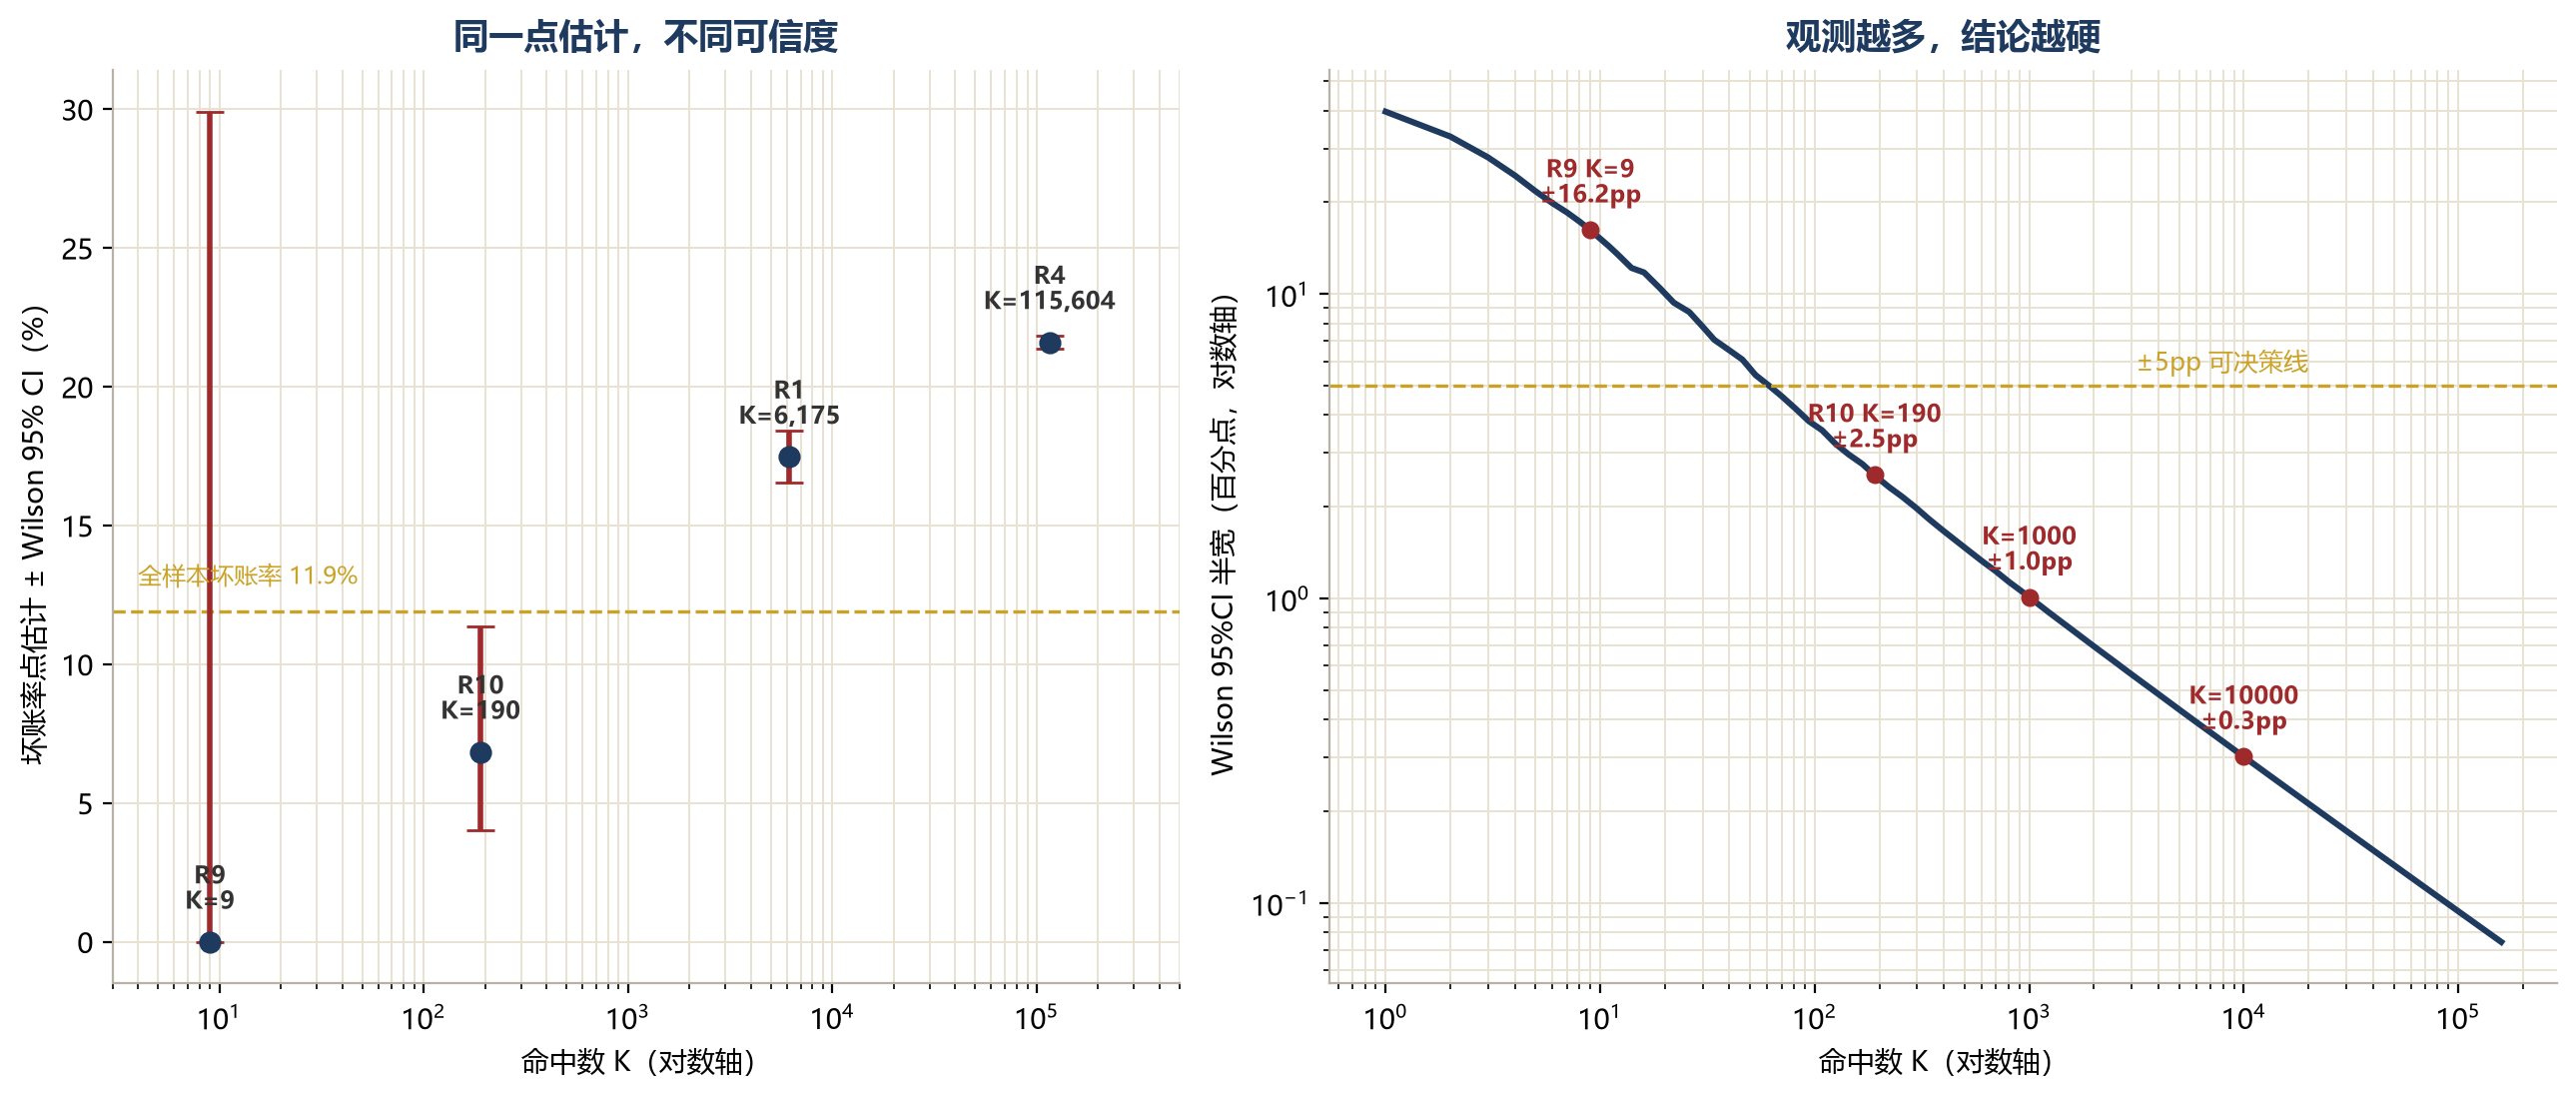
读这张表:R9 拦了 9 个人全没坏账,但 95% 置信区间是 [0%, 29.9%]——真实坏账率最高可能到三成,你根本无法判断这条规则拦的是好人还是坏人。R10 命中 190 人,区间收窄到 ±3.7pp,勉强能说"它拦的人坏账率约 7%、低于全样本";R1/R4 命中上万,区间只有 ±1pp 以内,结论才真正可靠。
这就是"统计濒死"的数学含义:规则或许有价值,但数据薄到无法判断它有没有价值。命中数 K 决定区间半宽,半宽决定决策质量——图右半边的曲线就是半宽随 K 的变化:要拿到 ±5pp 的决策精度,至少需要约 150 个命中样本;±2pp 需要约 1,000 个。命中 9 人的规则,神仙来了也算不出它的坏账率。
04 拆解:一个策略引擎的 9 条规则,4 条是死/濒死
模拟一个消费金融策略引擎,9 条复合拒绝规则(3-4 个条件 AND 组合),其中 5 条活跃、2 条数学死、2 条统计濒死:
| # | 规则(条件组合) | 命中 | 命中率 | 判定 | 成因 |
|---|---|---|---|---|---|
| R1 | 金额>3万 ∧ dti>25 ∧ 逾期>=1 | 6,175 | 0.274% | ✅ 活跃 | — |
| R2 | 收入<5万 ∧ dti>35 | 43,836 | 1.942% | ✅ 活跃 | — |
| R3 | 账户>15 ∧ 循环利用>85% | 20,161 | 0.893% | ✅ 活跃 | — |
| R4 | 信用分<680 ∧ 近6月查询>=2 | 115,604 | 5.122% | ✅ 活跃 | — |
| R5 | 金额>3万 ∧ 收入<6万 ∧ 账户>15 | 1,935 | 0.086% | ✅ 活跃 | — |
| R7 | 金额>5万 ∧ dti>25 | 0 | 0.000% | ★ 数学死 | 额度上限调整遗留(上限4万) |
| R8 | 信用分<600 ∧ 金额>1万 | 0 | 0.000% | ★ 数学死 | 客群下探前(最低分610) |
| R9 | 逾期>=20 ∧ dti>30 | 9 | 0.0004% | ◐ 濒死 | 旧风控标准(现在仅9人) |
| R10 | 收入<1万 ∧ 金额>3万 | 190 | 0.008% | ◐ 濒死 | 审批互斥假设(实际190人) |
4.1 全景:命中率断层明显
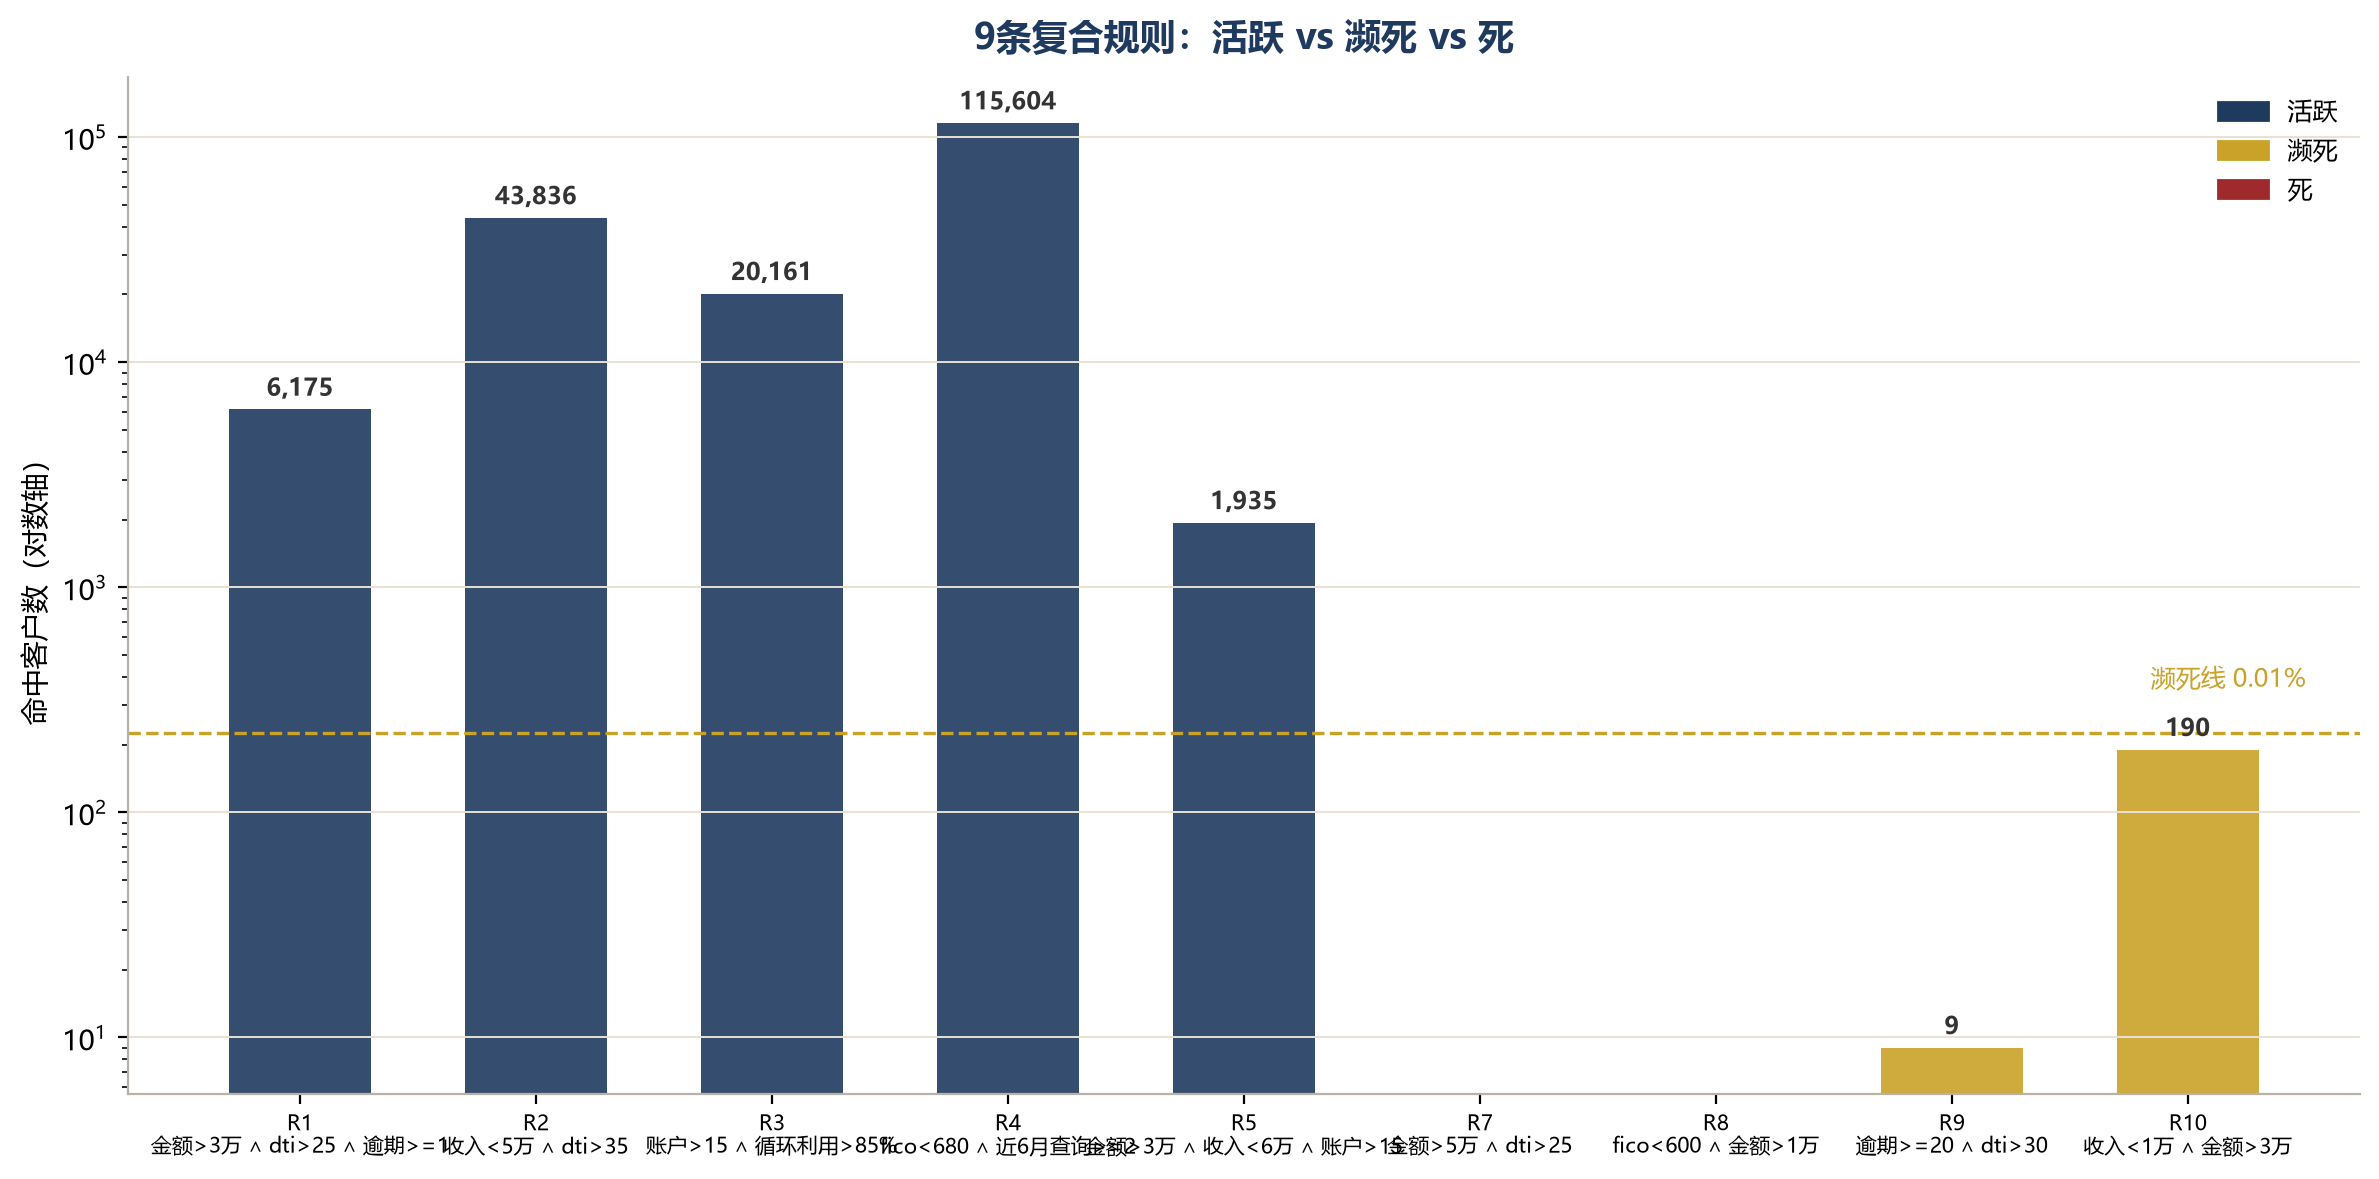
5 条活跃规则命中率从 0.086% 到 5.122%,2 条数学死规则命中 0,2 条濒死规则命中 9 和 190——断层清晰。濒死判据(命中数不足以支撑决策,见 3.2)能干净地把活跃和濒死分开。
4.2 数学死分支:R7 的阈值在数据域之外
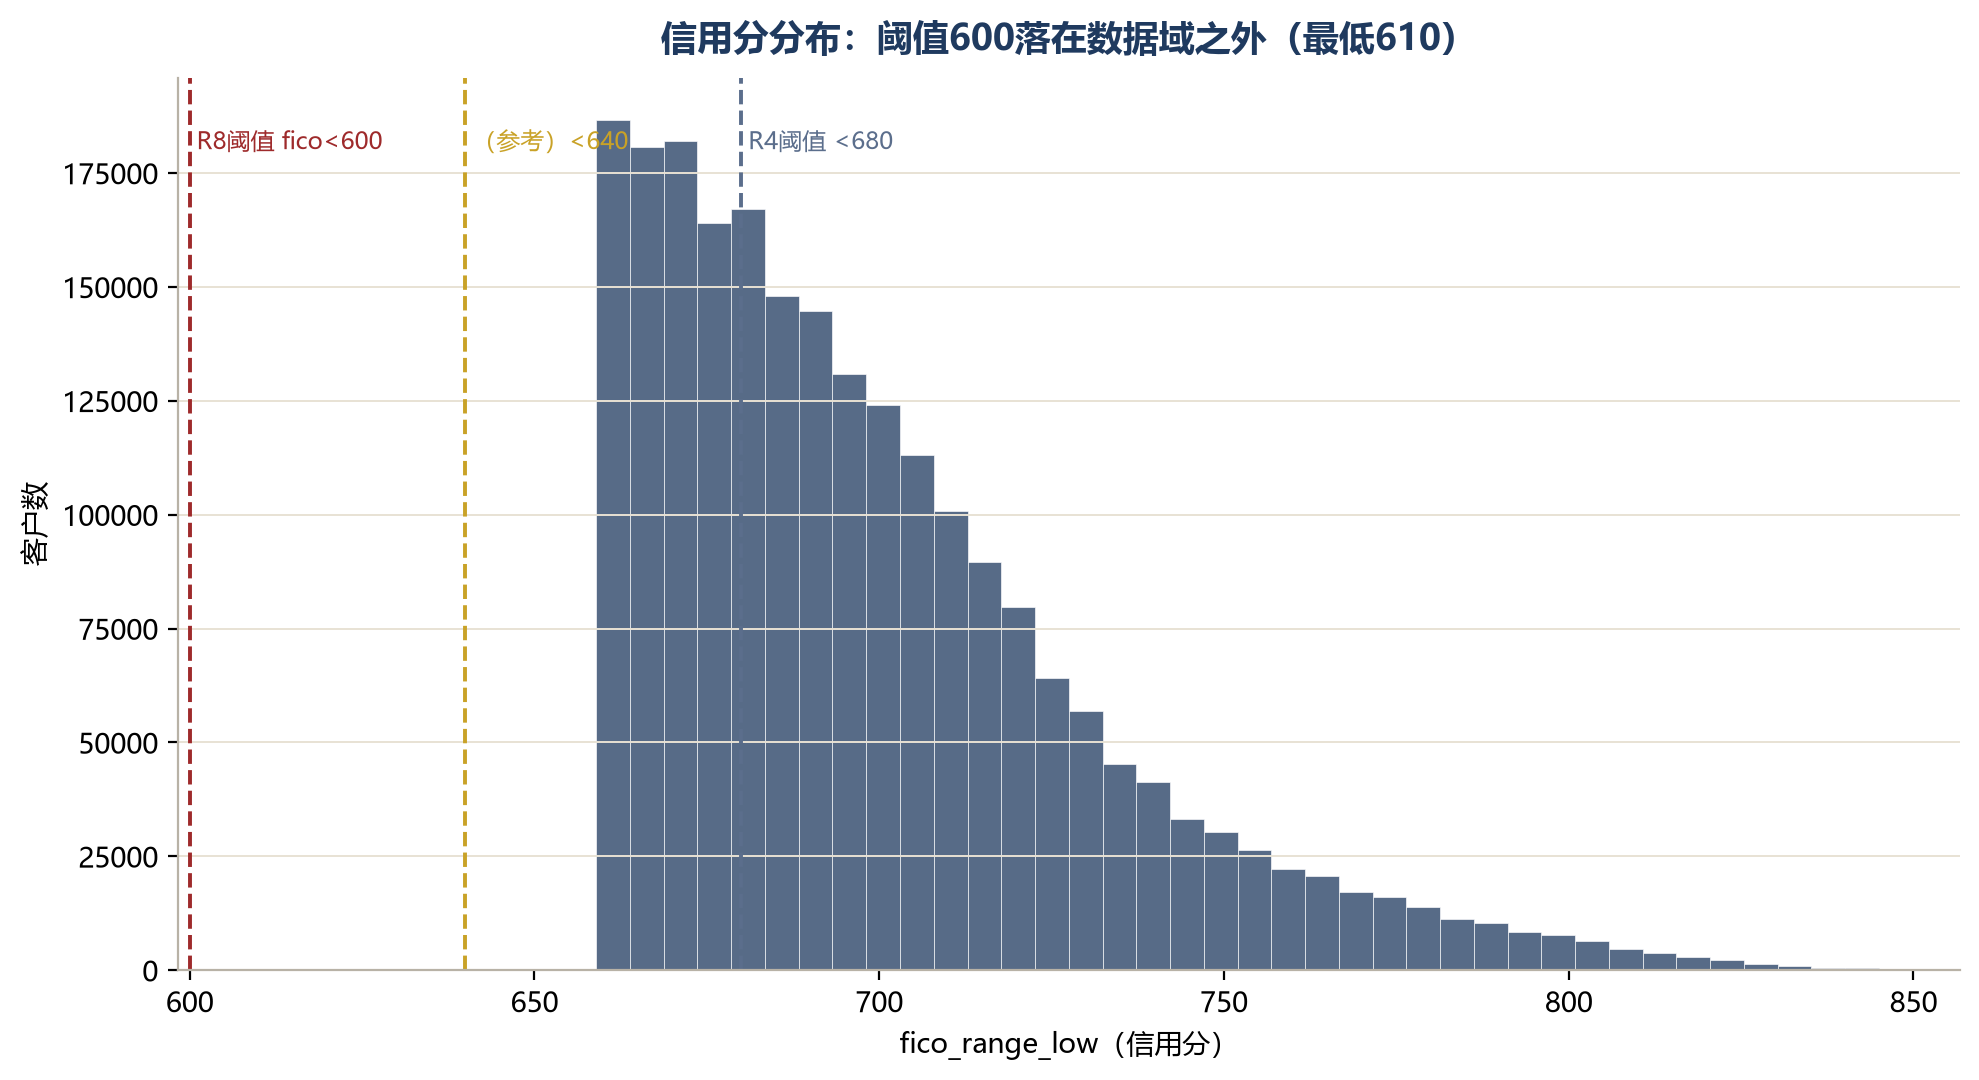
R8(信用分 < 600)是数学死分支最直观的例子:LendingClub 客群信用分最低 610,分布从 610 才开始,阈值 600 落在分布左侧空白区——规则区间
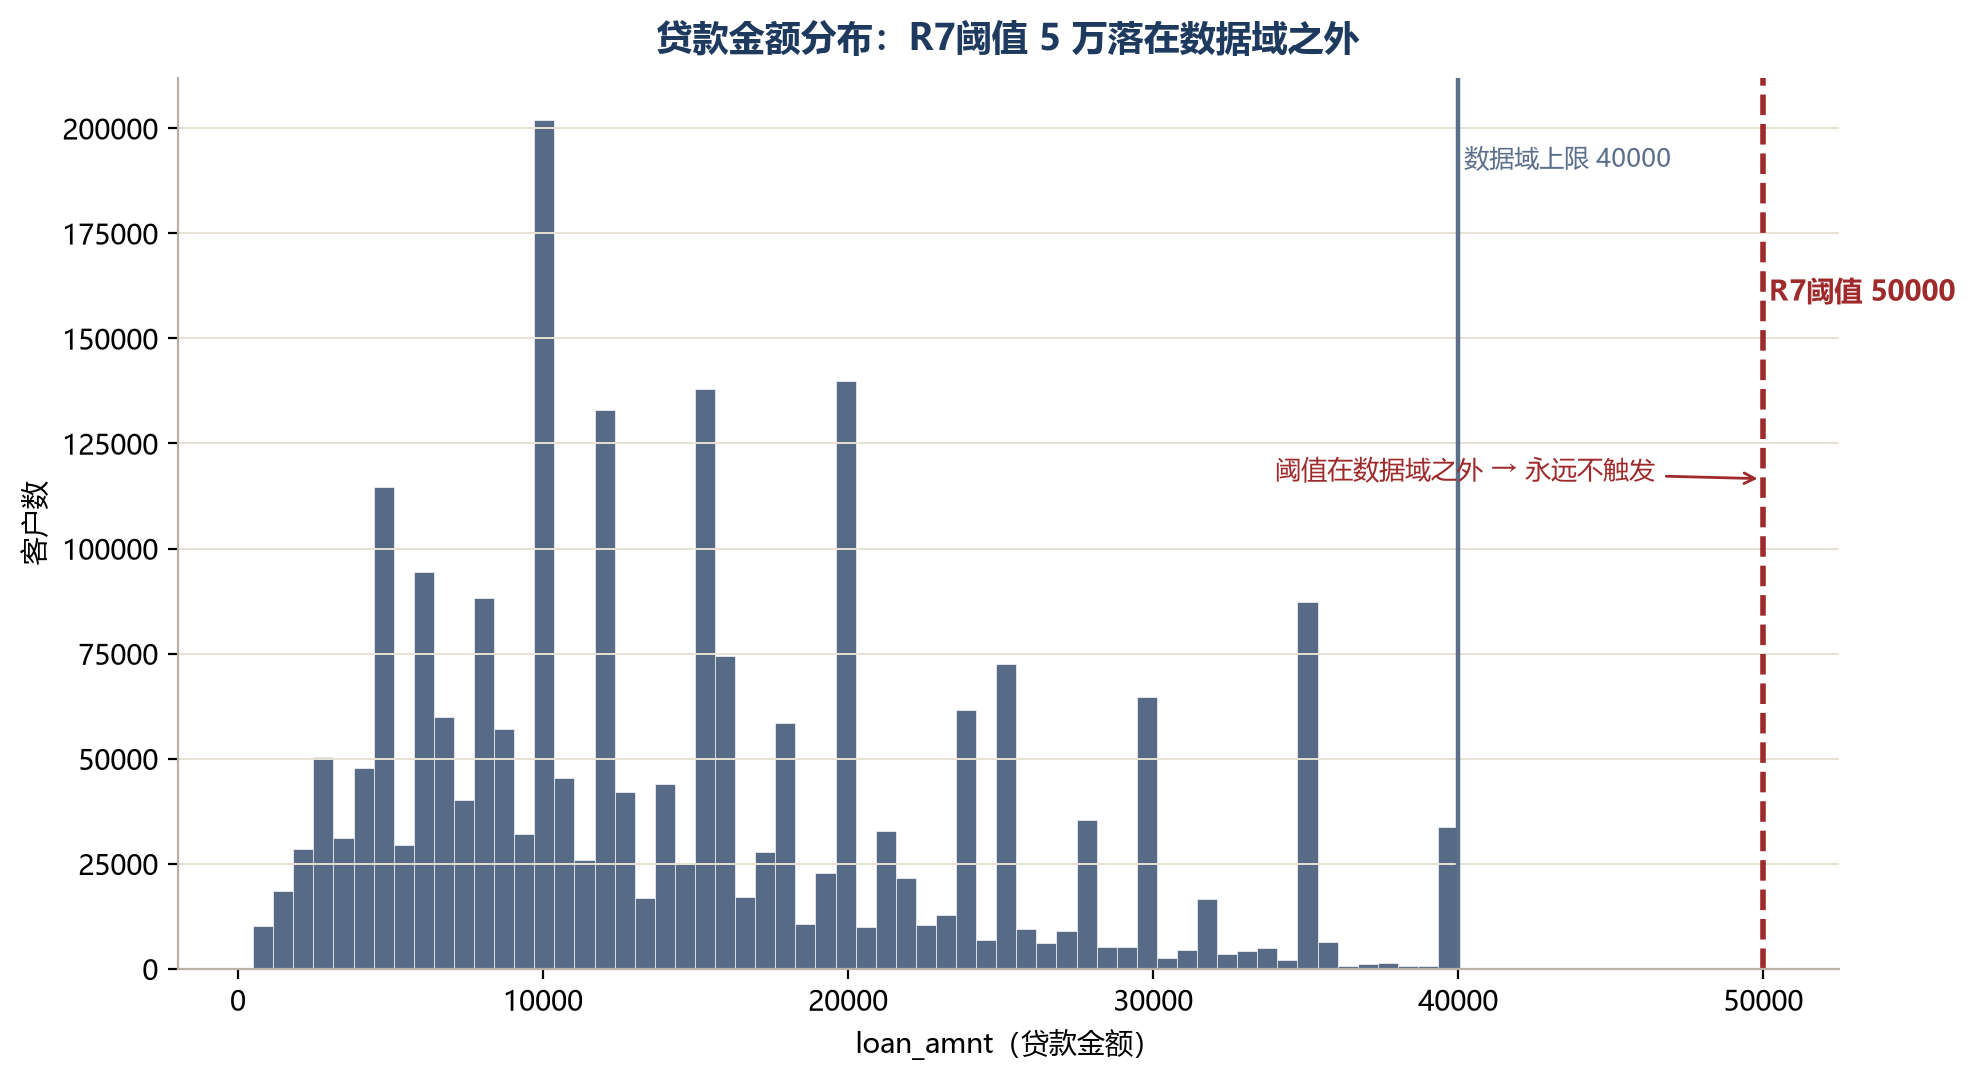
R7(金额 > 5 万)同理:金额分布上限就是 40000,阈值 5 万在数据域之外。这两条规则永远不可能触发——不是很少,是零——产品额度上限调整后忘了删。
SymPy 区间分析给出精确证明:
R7金额: Interval.open(50000, oo) ∩ Interval(500, 40000) = EmptySet
R8信用分: Interval.open(-oo, 600) ∩ Interval(610, 845) = EmptySet
R9逾期: Interval(20, oo) ∩ Interval(0, 58) = Interval(20, 58)  ← 非空, 需数据判定
R10收入: Interval.open(-oo, 10000) ∩ Interval(1000, 110000000) = Interval(1000, 10000)  ← 非空
R7/R8 交集为空,数学死分支,删了绝对安全;R9/R10 区间非空,数学上"可能"命中,但命中率只有 0.0004% / 0.008%——必须靠数据判定。
4.3 濒死分支:R10 是最有意思的一条
R10(收入<1万 ∧ 金额>3万)的成因写的是"审批互斥假设"——策略团队当年认为"收入不到 1 万的人不可能贷到 3 万以上",加这条规则是为了兜底。但 LendingClub 实测:
- 收入<1万 的客户:3,055 人(单条件,占样本 0.14%)
- 收入<1万 ∧ 金额>3万:190 人
假设被数据打脸:P2P 平台审核宽松,确实存在低收入高额度的借款人。这条规则不是死的,但它拦截的 190 人(0.008%)命中率极低——每 11,879 个客户才拦 1 个,维护成本和它的实际贡献不成比例。更要命的是,190 人的坏账率只有 6.8%,低于全样本的 11.9%——它拦的甚至不是坏人(见 4.5)。
4.4 死分支的代价:每笔申请都白算
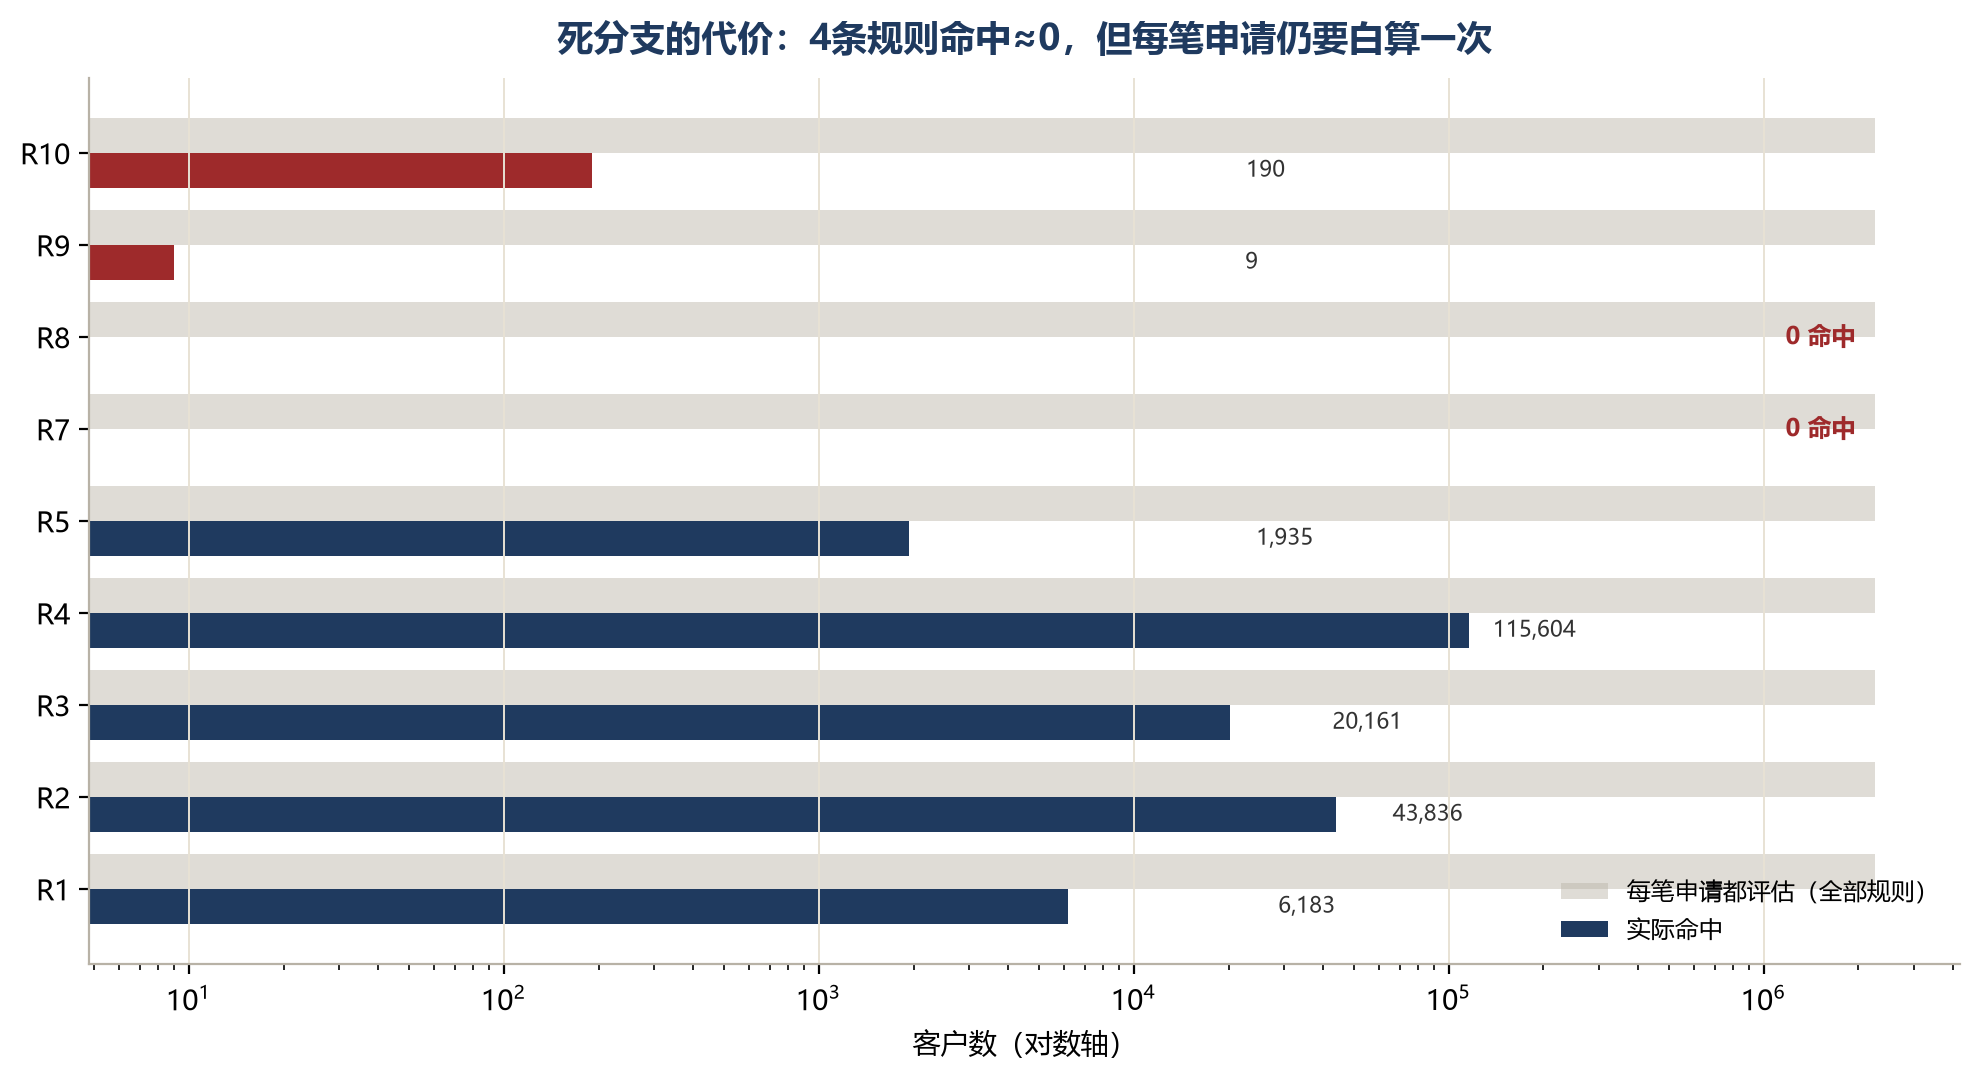
关键事实:规则引擎对每笔申请会跑全部规则。9 条规则里 4 条死/濒死,意味着每笔申请有 4 次评估是"命中约等于 0 的白算":
- 总申请 2,257,151 笔 × 4 条死/濒死规则 = 9,028,604 次无意义评估
- 4 条死/濒死规则占规则总数的 44%,合计只命中 199 人
这不是计算性能问题(规则引擎很快),而是规则治理问题:44% 的规则在系统里"占着位置不干活",每次规则评审都要review它们、每次监控都要看它们、每个新人理解策略都要先跳过它们——这些隐性成本远超那几毫秒的计算时间。
4.5 精度视角:命中率低 ≠ 没价值,要看拦的是谁
只谈命中率会漏掉一个更关键的问题:规则拦截的人群,质量到底怎么样? 把 9 条规则拦截人群的坏账率(Charged Off/Default 占比)拉出来对照:
| # | 命中 | 命中率 | 坏账率 | 对照全样本 11.9% | 判定 |
|---|---|---|---|---|---|
| R1 | 6,175 | 0.274% | 17.5% | 高于整体 → 拦截高风险 | ✅ 活跃且值钱 |
| R2 | 43,836 | 1.942% | 12.9% | 略高于整体 | ✅ 活跃 |
| R3 | 20,161 | 0.893% | 15.8% | 高于整体 | ✅ 活跃 |
| R4 | 115,604 | 5.122% | 21.6% | 最高 → 最值钱 | ✅ 活跃且值钱 |
| R5 | 1,935 | 0.086% | 5.6% | 低于整体 | ⚠️ 活跃但拦偏了 |
| R9 | 9 | 0.0004% | 0.0% | 全样本最低 | ★ 濒死 + 拦好人 |
| R10 | 190 | 0.008% | 6.8% | 低于整体 | ★ 濒死 + 拦好人 |
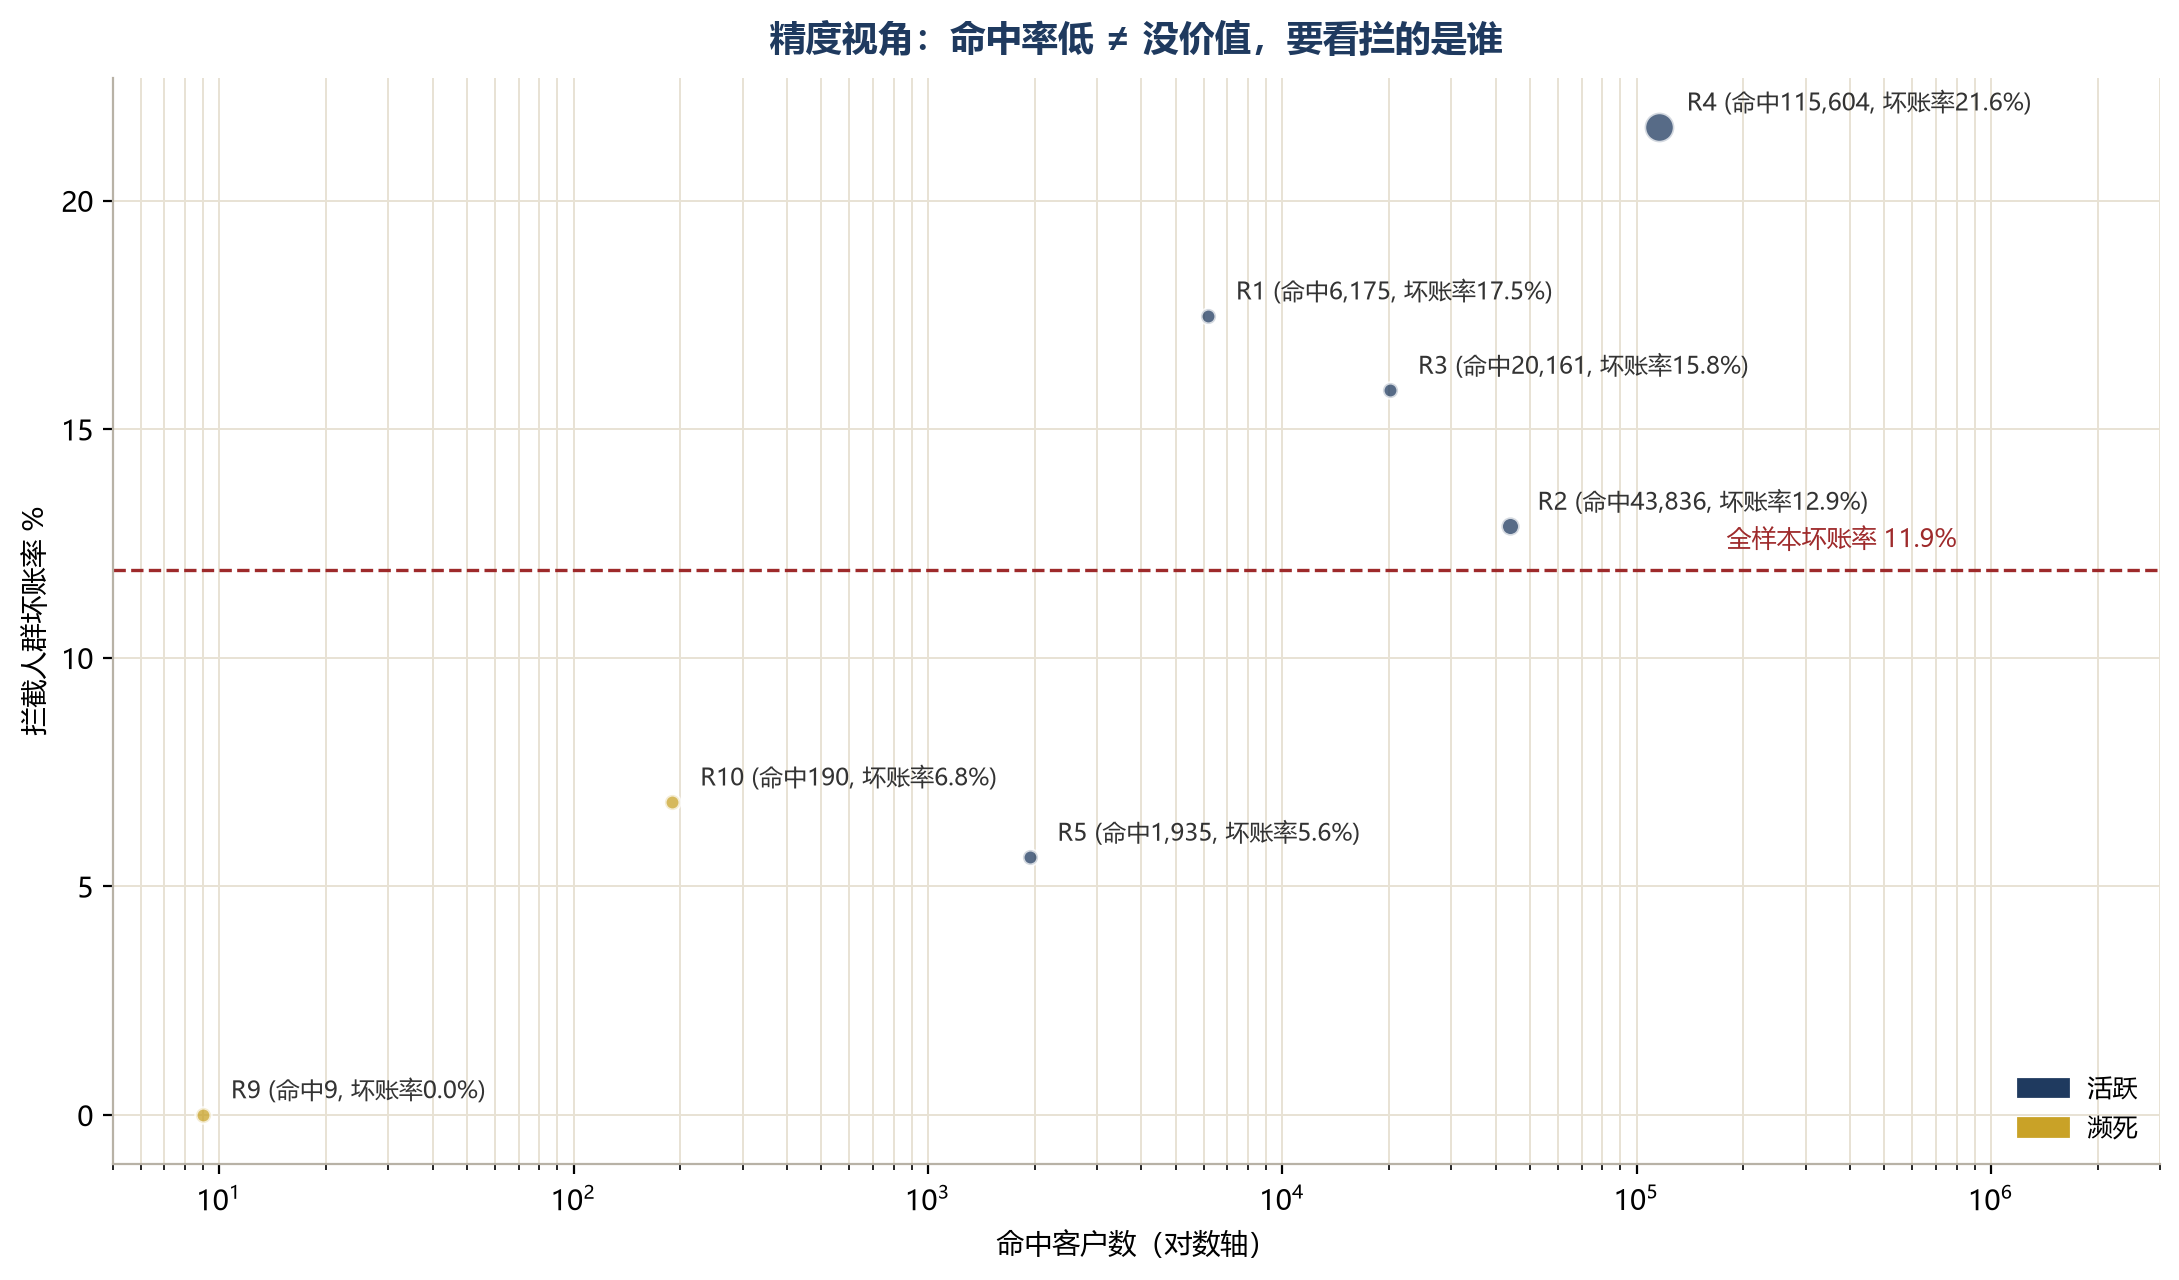
这张图讲清楚了"命中率低 ≠ 没价值":R9 命中 9 人坏账率为 0,R10 命中 190 人坏账率 6.8%——两条濒死规则的拦截人群坏账率都低于全样本。换句话说,它们拦的几乎全是"好人":R9 拦截的 9 个逾期 20 次以上的客户,最终没有一笔坏账(逾期次数多≠高风险,这些人可能只是还款记录难看但实际都还上了);R10 拦截的低收入高额度人群,违约率只有整体的一半。
对比之下,R4 命中 11.5 万人、坏账率 21.6%,是全场最"值钱"的规则;R5 命中率低且坏账率只有 5.6%——活跃规则里也有拦偏了的。所以死分支治理必须看两个维度:会不会触发(命中率)× 拦的是谁(精度)。命中率低但精度高(拦的全是坏人)的规则叫"狙击手",删之前要三思;命中率低且精度低(拦的全是好人)的规则叫"空枪",删掉没损失。
4.6 删除安全性验证:删了到底会放走什么
光说"濒死"还不够,业务上要回答的问题是:删掉这些规则,会放走哪些客户? 做交叉验证——把 R9/R10 命中的人逐一比对是否被其他 5 条活跃规则覆盖:
- R10:命中 190 人,其中 178 人被 R2(收入<5万 ∧ dti>35)覆盖、24 人被 R1 覆盖——190 人里有 178 人即使删掉 R10 也会被其他规则拦住,R10 真正独有拦截的只有 12 人
- R9:命中 9 人,没有任何活跃规则覆盖——删掉 R9 会放行全部 9 人
那放行的 21 人质量如何?——坏账 0:
| 删除 | 真正放行 | 坏账 | 释放额度 |
|---|---|---|---|
| R9 | 9 笔 | 0 | $132,000 |
| R10 | 12 笔 | 0 | $427,225 |
| 合计 | 21 笔 | 0 | $559,225 |
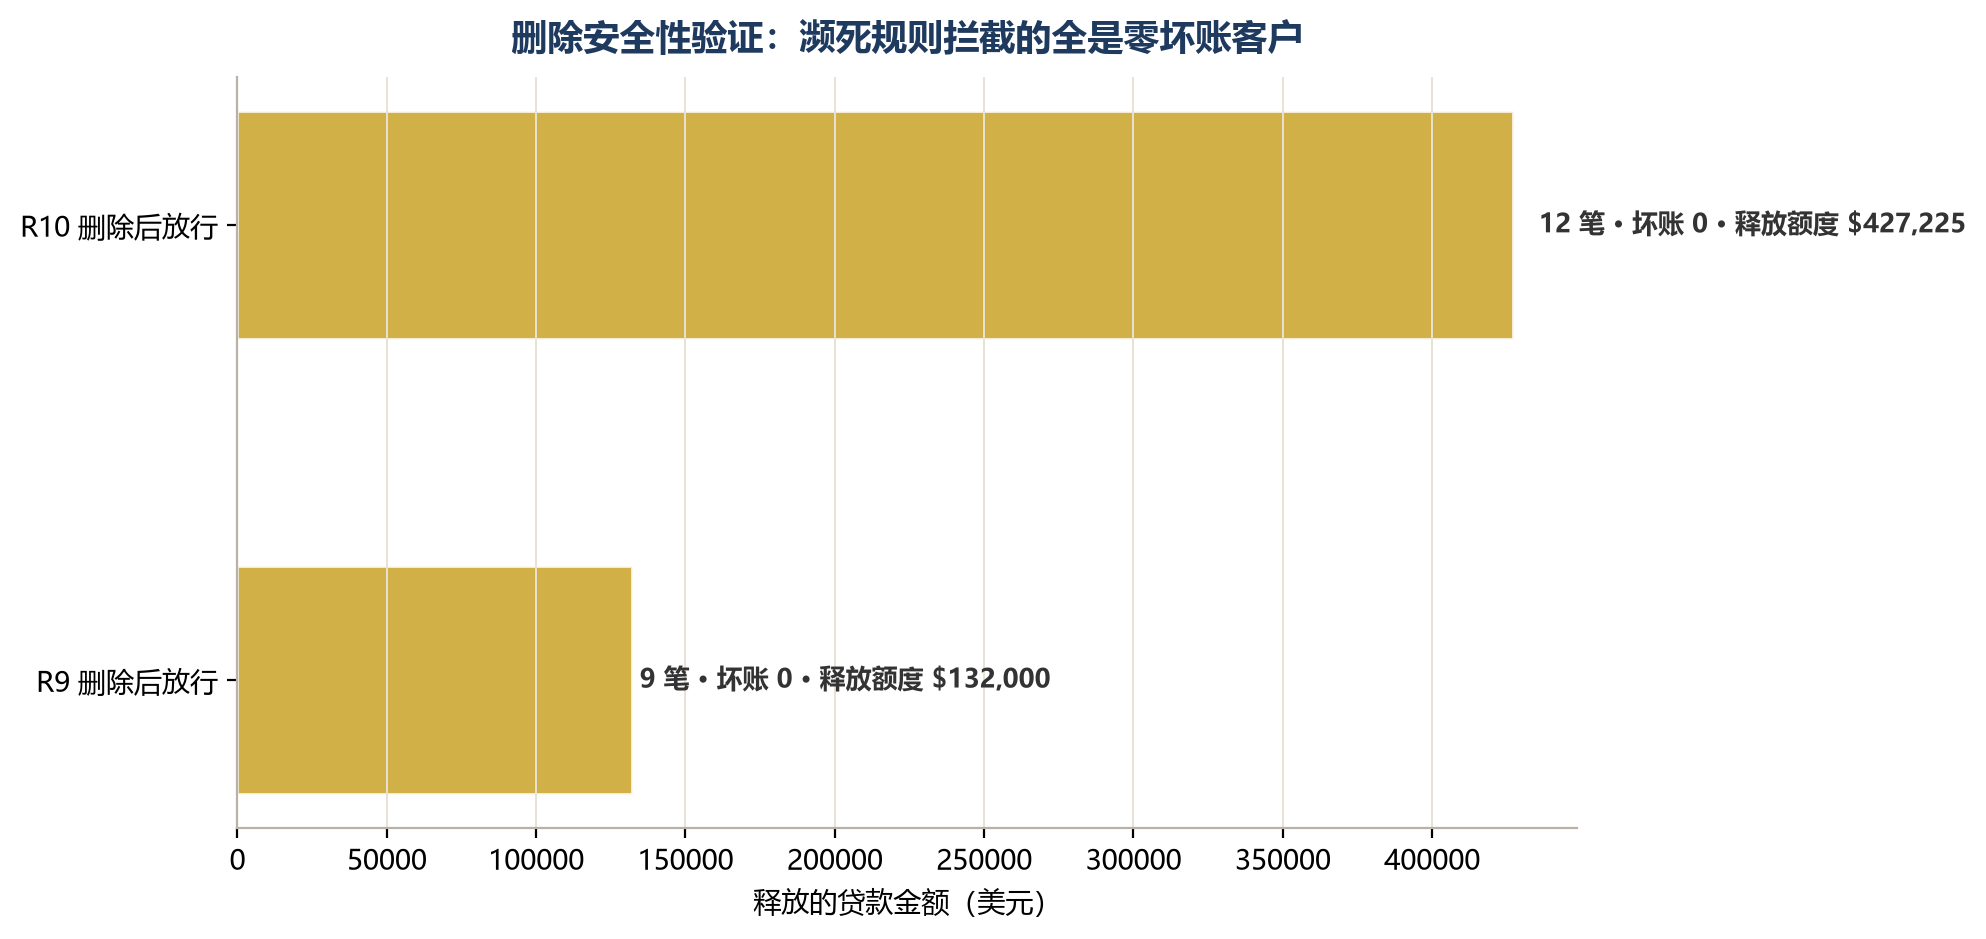
两条濒死规则拦截的 21 个客户,没有一个是坏账。删除它们:零坏账损失,同时释放 55.9 万美元的安全额度(按 LendingClub 平均 12% 年利率,一年潜在利息收入约 6.7 万美元)。这才是"濒死规则"的完整代价——最贵的是被错误拒绝的好客户和放不出去的额度。而 R10 还暴露了另一个问题:它的拦截作用 94% 被 R2 重复覆盖(178/190),这是 #105b 讨论过的代理变量冗余——R10 同时犯两种病:统计濒死 + 与 R2 高重叠。一条规则占着位置,既没拦到坏人,也没拦住别人没拦的人。
05 关键要点:怎么给规则引擎"扫墓"
死分支检测不该是一次性的,应该成为规则治理的常规动作。四步流程:
第一步:区间代数扫描(数学层)。 用 SymPy 把每条规则的数值条件与字段数据域求交集,交集为空直接标记数学死分支——不需要看数据,可以自动化。建议每次字段口径变更、产品参数调整后跑一遍。
第二步:命中率体检(数据层)。 对区间非空的规则算命中率,低于 0.01% 标记濒死。注意:这个结论只对当前数据成立,客群变了要重跑。
第三步:成因溯源。 每条死/濒死规则问一句"当年为什么加":
- 额度上限/准入标准调整后忘了删 → 确认后直接删
- 审批互斥假设被数据打脸(R10)→ 评估是否放宽阈值
- 旧风控标准跟不上客群变化(R9)→ 看业务是否需要更新
第四步:数据质量前置检查。 检测死分支前先排数据坑。本文发现 dti 字段有 -1 哨兵值和 999 异常值,单独跑"dti>80"居然有 4,093 人命中——全是脏数据。如果先不清理数据,你会把"数据质量问题"误判成"规则问题",越修越乱。
第五步:精度体检 + 删除安全性验证。 对濒死规则补两刀:先看它拦截人群的坏账率(拦的是好人还是坏人),再做交叉覆盖——命中的人里有多少会被其他规则拦住。删掉一条规则真正放行的、坏账为 0 的那部分,就是它造成的隐性损失。
关键区分(延续 #105/#105b 的框架):
- 数学死分支(R7/R8):区间交集为空,数学可证,与数据无关——删了绝对安全
- 统计濒死分支(R9/R10):区间非空但数据极薄,只能当前数据验证——删不删要看精度和覆盖
死分支治理的完整三问,对应本文的三个检测通道:
- 会不会触发?——区间代数扫数学死分支(与数据无关,可证明)
- 触发多少次?——命中率体检扫统计濒死(当前数据有效,要重跑)
- 拦的是谁?——坏账率精度体检 + 交叉覆盖(决定删不删、删了放走什么)
最强结论:本文 9 条规则里,2 条数学死 + 2 条统计濒死;而两条濒死规则拦截的 21 个客户坏账率为 0——删除它们零损失,还能释放 55.9 万美元安全额度。也就是说,"濒死规则"最贵的,是它一直拦着的好客户。
"死分支"的结论必须限定边界:在 LendingClub 这 2,257,151 笔样本上,9 条复合规则里 2 条数学死、2 条统计濒死,且濒死规则拦的都是零坏账客户。真实业务数据上,这个结论不一定成立——但方法成立:区间代数扫数学死,命中率体检扫统计濒死,精度体检问拦的是谁,数据质量检查在前,交叉覆盖验证在后。这套流程跑一遍,你的规则引擎里有多少"占着位置不干活"甚至"拦着好人"的分支,一目了然。
数据说明: LendingClub 2007-2018年公开贷款数据(226万笔),本地parquet读取,剔除缺失值及年收入<=0后样本2,257,151笔。9条复合规则按贷款金额(loan_amnt)、负债率(dti)、逾期次数(delinq_2yrs)、账户数(open_acc)、年收入(annual_inc)、信用分(fico_range_low)、循环利用率(revol_util)、近6月查询(inq_last_6mths)组合定义,仅作方法论演示,不代表任何真实机构的策略。命中率=规则命中/总样本,阈值分位=字段分布中小于阈值占比。坏账=贷款状态为Charged Off或Default,全样本坏账率11.9%。区间分析用 SymPy Interval.intersect,命中统计与坏账率用 DuckDB 实际查询,交叉覆盖=濒死规则命中人群与其他活跃规则命中集合的并集比对。
代码环境: Python 3.11,DuckDB,SymPy,pandas,numpy,matplotlib;随机种子seed=42(本实验无随机性依赖)。
© QianStat_data